NeRF入门介绍视频
NeRF系列公开课01 | 基于NeRF的三维内容生成_哔哩哔哩_bilibili
1. NeRF相比于三维重建的区别
- 一些场景的内容特别复杂, 使用三维重建效果较差, 但是NeRF渲染三维场景可以达到类似于相机拍摄的效果
- 没有像传统常见方式一样使用hard shape的表征方式, 而是使用soft shape.
- hard shape需要object segmentation mask(抠图, 把物体的背景都去掉)
- hard shape有boundary discontinuity(边界不连续)的问题需要解决
- 只使用相机和物体表面之间的ray上的很多samples做计算, 性能消耗少很多
- NeRF缺点是, 目前没有很好的工具去编辑物体的颜色形状等
2. NeRF的工作原理
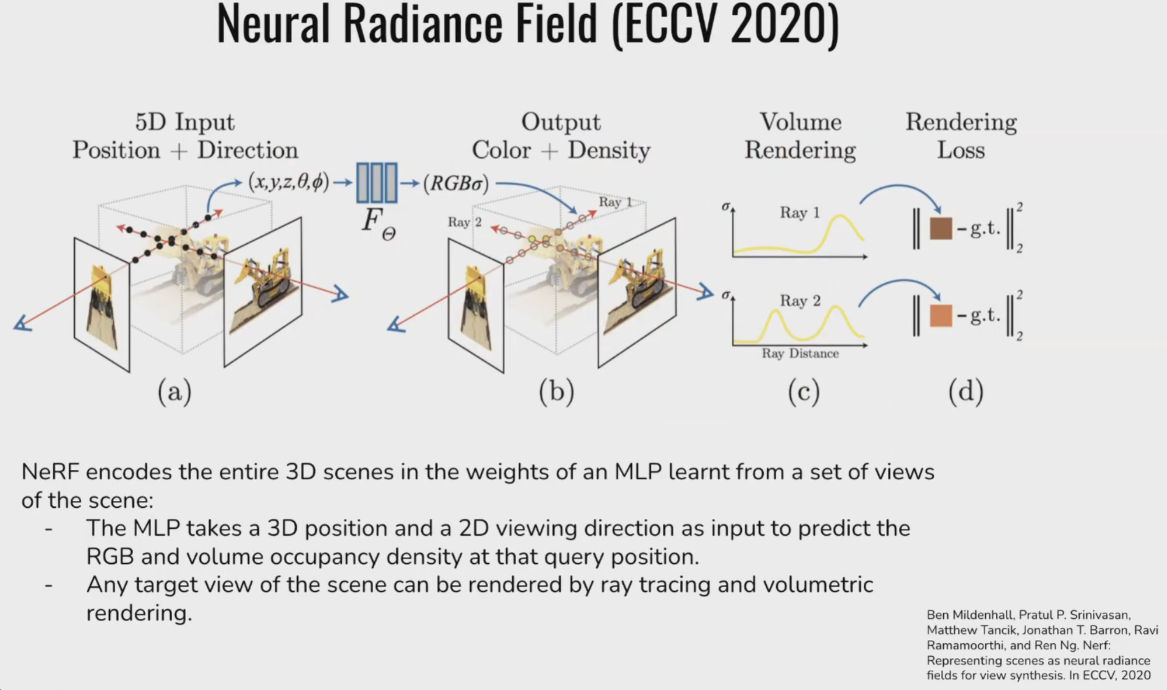
NeRF的工作原理简单介绍:
-
体素表示: NeRF将三维空间分割成许多小的体素(小立方体). 每个体素内都采样辐射度值来表示该体素内部的颜色和透明度. 这些体素构成了场景的三维表示.
-
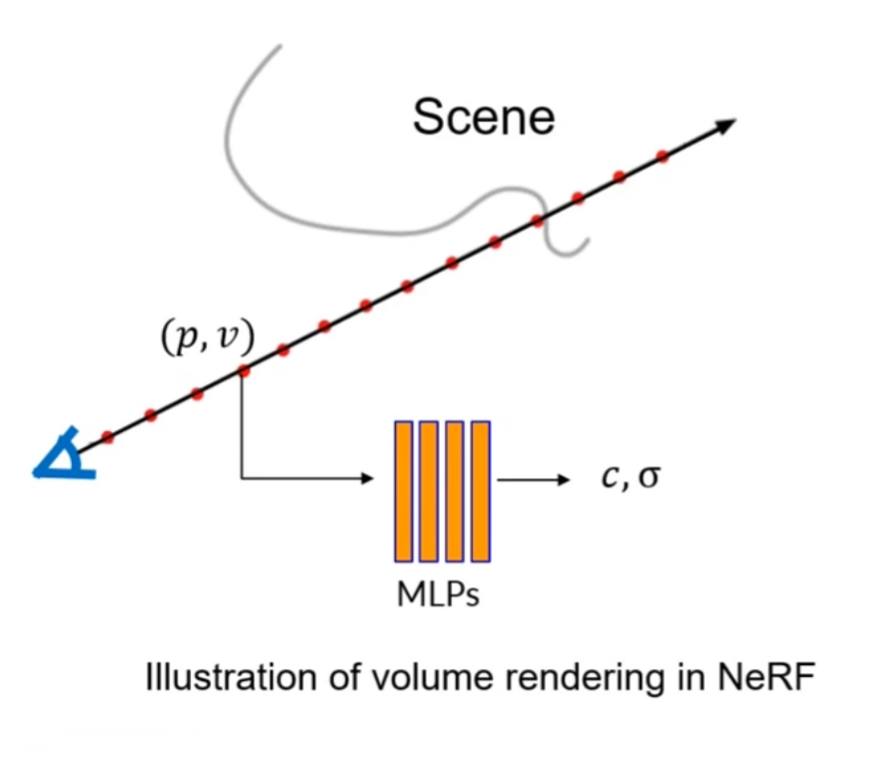
光线采样: 为了生成图像, NeRF会从相机位置沿着每个像素位置的光线进行采样, 以便在这些位置上估计辐射度.
-
辐射度估计:对于每个光线上的采样点,NeRF使用神经场模型MLP来估计该点的辐射度。它将光线上的坐标和摄像机参数作为输入,并输出辐射度值,表示了在该点的颜色和透明度。
- 输入的是5维, 一个点在空间中的位置$(x,y,z)$和相机的观测方向$(\theta,\varphi)$←这是弧度单位(radians)中的极角(polar angle)和方位角(azimuthal angle), 由于相机的观测方向是一个单位向量, 向量大小$r=1$被省略了.
- 经过MLP网络, 输出是4维, 该点的RGB值和体积密度(volume occupancy density)(或者说是透明度) ← 就是辐照度(randiance).
- 通过将一条光线上所有采样点的辐照度(4维向量)做累加, 获得这条光线在输出图像上的像素值.
-
图像生成:一旦辐射度值被估计出来,NeRF可以使用这些值来合成图像。这是通过在光线上的各个采样点上插值和组合辐射度值来完成的。最终的图像是由这些采样点生成的。
训练过程通过最小化实际观察到的图像和由NeRF预测生成的图像之间的差异来进行. 这通常使用像素级的损失函数来完成.
2.1. NeRF和体渲染的关系
-
神经辐射场是将2D的输入表征成3D场景的过程
-
体渲染是将真实3D场景中的很多点位投射到2D画面的过程
-
NeRF使用了体渲染的方式进行训练
-
光线的向量公式:
$$ r(t)=o+td $$o表示光线的起点, t表示光线到点的距离, d表示光线的方向.
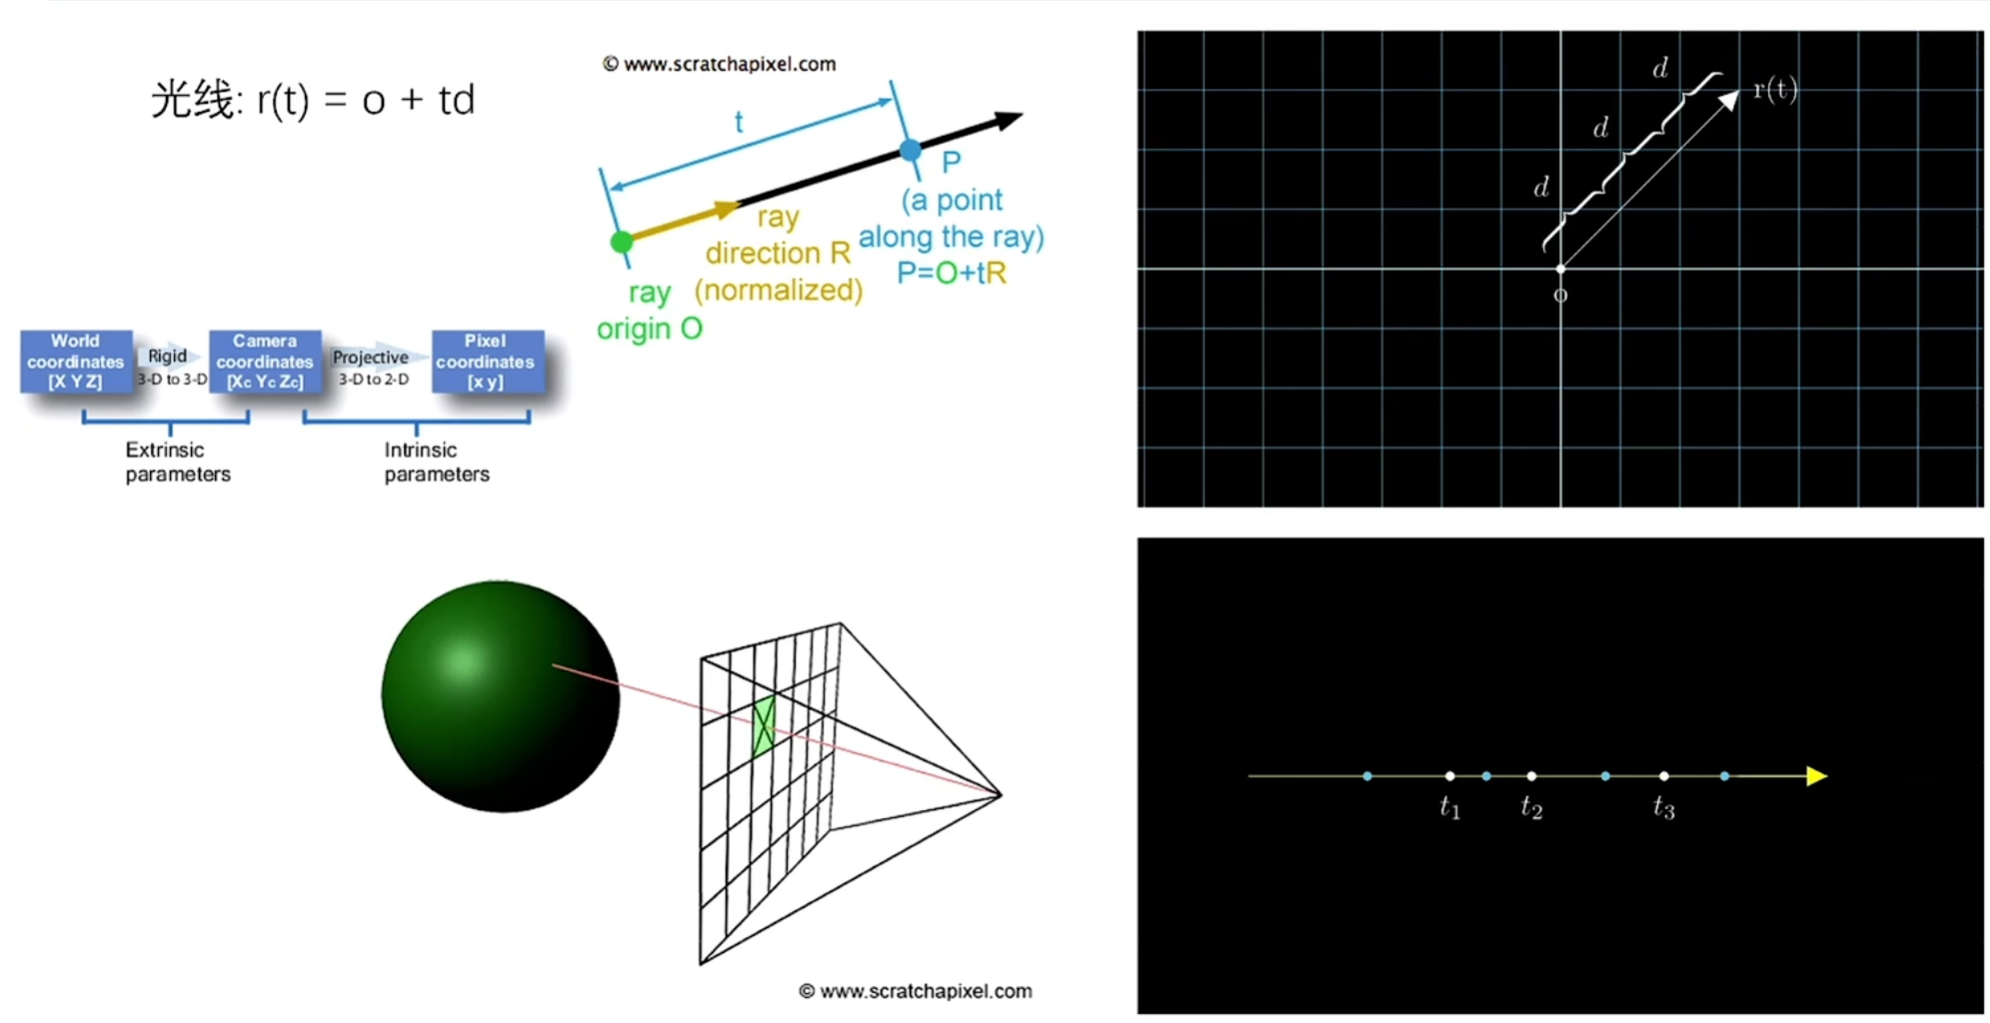
- 光线上取的点, 位置不是均匀分布的. 原因查看光线颜色值公式的离散采样部分.
- 坐标系间需要互相转换
- 世界坐标系(场景中物体的位置)和相机位姿(相机位置)属于外参
- 像素坐标系, 是投影到相机画面上的坐标
2.2. 光线的颜色
光线的颜色值公式
$$ C(\mathbf{r})=\int_{t_n}^{t_f} T(t) \sigma(\mathbf{r}(t)) \mathbf{c}(\mathbf{r}(t), \mathbf{d}) d t, \text { where } T(t)=\exp \left(-\int_{t_n}^t \sigma(\mathbf{r}(s)) d s\right) $$-
下面的文章解释了这个公式.
Optical models for direct volume rendering(1995)这篇论文提出了体渲染的三种光线模型:
下面的公式只保留了重要的过程, 详细推导过程看下面的文章.
【论文精读】NeRF中的数学公式推导_nerf数学推导_YuhsiHu的博客-CSDN博客
光线吸收模型
物体的粒子本身不发光, 也不反光(简单来说就是吸收它们拦截的所有光, 却不散射或发射任何光). 假设粒子是相同的球体,半径为 $\mathrm{r}$ ,投影面积 $\mathrm{A}=\pi \mathrm{r}^2$ , 设 $\rho$ 为每单位体积的粒子数. 这个模型的传递方程是
$$ \frac{\mathrm{dI}}{\mathrm{ds}}=-\rho(\mathrm{s}) \mathrm{AI}(\mathrm{s})=-\tau(\mathrm{s}) \mathrm{I}(\mathrm{s}) $$- $\mathrm{s}$ 是沿光流方向的光线的长度, $\mathrm{I}(\mathrm{s})$是距离 $\mathrm{s}$ 处的光强度, $\rho$ 是光点密度.
- $\tau(\mathrm{s})=\rho(\mathrm{s}) \mathrm{A}$ 称为消光系数(在NeRF公式中表示为$\sigma$), 反映了光被遮挡的速率.
整理并且等式两边同时积分, 最终获得这个微分方程的解(光消减的公式)
$$ \mathrm{I}(\mathrm{s})=\mathrm{I}_0 \exp \left(-\int_0^{\mathrm{s}} \tau(\mathrm{t}) \mathrm{dt}\right) $$- $\mathrm{I}_0$ 是在 $\mathrm{s}=0$ 处的光强度, 而 $\mathrm{T}(\mathrm{s})=\exp \left(-\int_0^{\mathrm{s}} \tau(\mathrm{t}) \mathrm{dt}\right)$是介于 0 和 $\mathrm{s}$ 之间的介质的透明度($\tau(\mathrm{t})$ 在NeRF公式中表示为$\sigma$). 在体渲染中, 消光系数 $\tau$ 通常称为不透明度.
光线发射模型
物体的粒子本身会发出光, 并且不吸收光(介质还可以通过外部照明的发射或反射来增加光线). 如果粒子是透明的, 但以每单位投影面积的强度 $\mathrm{C}$ 发光. 其中的$\tau(\mathrm{s})$ 在NeRF公式中表示为$\sigma$ 这个 $\mathrm{I}(\mathrm{s})$ 的微分方程:
$$ \frac{\mathrm{dI}}{\mathrm{ds}}=\mathrm{C}(\mathrm{s}) \rho(\mathrm{s}) \mathrm{A}=\mathrm{C}(\mathrm{s}) \tau(\mathrm{s})=\mathrm{g}(\mathrm{s}) $$这个方程的解如下 (光发射的公式)
$$ \mathrm{I}(\mathrm{s})=\mathrm{I}_0+\int_0^{\mathrm{s}} \mathrm{g}(\mathrm{t}) \mathrm{dt} $$- $\mathrm{I}_0$ 是 $\mathrm{s}=0$ 处的光强度.
吸收发射模型
实际上, 空间中的粒子会遮挡入射光, 并添加自己的光. 因此, 一个现实的微分方程应该包括源项 $\mathrm{g}(\mathrm{s})$ 和衰减项 $\mathrm{I}(\mathrm{s})$ . 我们只需要将前两种模型进行简单的数值加和, 就可以得到这个模型的传递方程:
$$ \frac{\mathrm{dI}}{\mathrm{ds}}=\mathrm{g}(\mathrm{s})-\tau(\mathrm{s}) \mathrm{I}(\mathrm{s}) $$从volume边缘的 $s=0$ 积分到眼睛的 $\mathrm{s}=\mathrm{D}$ :
$$ \mathrm{I}(\mathrm{D}) \exp \left(\int_0^{\mathrm{D}} \tau(\mathrm{t}) \mathrm{dt}\right)-\mathrm{I}_0=\int_0^{\mathrm{D}}\left(\mathrm{g}(\mathrm{s}) \exp \left(\int_0^{\mathrm{s}} \tau(\mathrm{t}) \mathrm{dt}\right)\right) \mathrm{ds} $$整理得到:
$$ \mathrm{I}(\mathrm{D})=\mathrm{I}_0 \exp \left(-\int_0^{\mathrm{D}} \tau(\mathrm{t}) \mathrm{dt}\right)+\int_0^{\mathrm{D}}\left(\mathrm{g}(\mathrm{s}) \exp \left(-\int_{\mathrm{s}}^{\mathrm{D}} \tau(\mathrm{t}) \mathrm{dt}\right)\right) \mathrm{ds} $$第一项表示来自背景的光, 乘以空间的透明度. 第二项是源项 $\mathrm{g}(\mathrm{s})$ 在每个位置 $\mathrm{s}$ 贡献的积分, 乘以位置 $\mathrm{s}$ 到眼睛的透明度 $\mathrm{T}^{\prime}(\mathrm{s})=\exp \left(-\int_{\mathrm{s}}^{\mathrm{D}}\tau(\mathrm{x})\mathrm{dx}\right)$ , 那么:
$$ \mathrm{I}(\mathrm{D})=\mathrm{I}_0 \mathrm{~T}(\mathrm{D})+\int_0^{\mathrm{D}} \mathrm{g}(\mathrm{s}) \mathrm{T}^{\prime}(\mathrm{s}) \mathrm{ds} $$等式右侧第一项代表着从坐标 0 点出发经过 0 到 $\mathrm{D}$ 的介质入射到相机的光强, 称之为背景光, 在NeRF中, 这一项考虑为 0 . 所以在NeRF 中, 这个式子化简为:
$$ \mathrm{I}(\mathrm{D})=\int_0^{\mathrm{D}} \mathrm{g}(\mathrm{s}) \mathrm{T}^{\prime}(\mathrm{s}) \mathrm{ds}=\int_0^{\mathrm{D}} \mathrm{T}^{\prime}(\mathrm{t}) \tau(\mathrm{t}) \mathrm{c}(\mathrm{t}) \mathrm{dt} $$其中 $\mathrm{T}^{\prime}(\mathrm{t})=\exp \left(-\int_{\mathrm{t}}^{\mathrm{D}} \tau(\mathrm{x}) \mathrm{dx}\right)$.
转变为NeRF中的公式
光线的吸收发射模型和NeRF公式的坐标不同, Max的文章中相机坐标为D, 无穷远点为0, 而NeRF公式中相反. 并且, 0到无穷之间的距离中, 不是所有位置上都有介质. 所以, 可以定义近平面$t_n$和远平面$t_f$
$$ \mathrm{I}(0)=\int_{\mathrm{t}_{\mathrm{n}}}^{\mathrm{t}_{\mathrm{f}}} \mathrm{T}^{\prime}\left(\mathrm{t}_{\mathrm{n}}, \mathrm{t}\right) \tau(\mathrm{t}) \mathrm{c}(\mathrm{t}) \mathrm{dt} $$NeRF中把消光系数(也就是不透明度) $\tau(\mathrm{t})$ 叫做体积密度 $\sigma(\mathrm{t})$ , 那么上式可以整理为:
$$ I(0)=\int_{t_n}^{t_f} T^{\prime}\left(t_n, t\right) \sigma(t) c(t) d t $$如果记 $\mathrm{T}(\mathrm{t})=\exp \left(\int_{\mathrm{t}{\mathrm{n}}}^{\mathrm{t}}-\sigma(\mathrm{t}) \mathrm{dt}\right)$ , 那么上式可以变成:
$$ \mathrm{I}(0)=\int_{\mathrm{t_n}}^{\mathrm{t_f}} \mathrm{T}(\mathrm{t}) \sigma(\mathrm{t}) \mathrm{c}(\mathrm{t}) \mathrm{dt} $$而这一切讨论都是在固定射线的情况下, 如果这个射线是动态的, 我们还需要用 $r(t)=0+t d$ 来表示的话, 那么 $\tau(r(t))$ 其实可以表示 在 $\mathrm{r}$ 这条射线上, $\mathrm{t}$ 位置的体积密度, $\mathrm{c}(\mathrm{r}(\mathrm{t}), \mathrm{d})$ 就可以表示在 $\mathrm{r}$ 这条射线上, $\mathrm{t}$ 位置对 $\mathrm{d}$ 方向的光强. 那么上式可以进一步变为:
$$ \mathrm{I}(0)=\int_{\mathrm{t_n}}^{\mathrm{t_f}} \mathrm{T}(\mathrm{t}) \sigma(\mathrm{r}(\mathrm{t})) \mathrm{c}(\mathrm{r}(\mathrm{t}), \mathrm{d}) \mathrm{dt}, \text { where } \mathrm{T}(\mathrm{t})=\exp \left(-\int_{\mathrm{t}{\mathrm{n}}}^{\mathrm{t}} \sigma(\mathrm{r}(\mathrm{s})) \mathrm{ds}\right) $$因为我们研究的是 $\mathrm{r}$ 这条射线上的光, 眼睛位置固定不变, 所以可以隐去相机位置 0 , 而添加参数 $\mathrm{r}$ 来强调射线也是个变量, 再用 $\mathrm{C}$ 替换掉光强 $\mathrm{I}$ , 所以最终式子变为:
$$ \mathrm{C}(\mathrm{r})=\int_{\mathrm{t_n}}^{\mathrm{t_f}} \mathrm{T}(\mathrm{t}) \sigma(\mathrm{r}(\mathrm{t})) \mathrm{c}(\mathrm{r}(\mathrm{t}), \mathrm{d}) \mathrm{dt}, \text { where } \mathrm{T}(\mathrm{t})=\exp \left(-\int_{\mathrm{t_n}}^{\mathrm{t}} \sigma(\mathrm{r}(\mathrm{s})) \mathrm{ds}\right) $$这就是NeRF中的光线颜色值公式, 将MLP的预测值$(\sigma,c)$带入公式. $T(t)$是光线累积量(到t点之前, 光线都没被阻碍的概率), $\sigma(r(t))$是体素密度(光线被阻碍的概率)), $c(r(t),d)$表示在t点处粒子发出的颜色.
而在实际训练中, 只有数百张图片, 所以连续积分需要变为离散采样. 将近远平面区间等分为 $\mathrm{N}$ 份, 在每个小区间内取样. 把积分符号变为求和, $T(t)$ 变为 $T_i$ , $c(r(t), d)$ 变为 $c_i$ , $\sigma(r(t)) d t$ 变为 $\sigma_i \delta_i$ ($\delta_i$ 是相邻样本之间的距离), 则得到最终的离散化公式:
$$ \begin{aligned}&\hat{C}(\mathbf{r})=\sum_{i=1}^N T_i\left(1-\exp \left(-\sigma_i \delta_i\right)\right) \mathbf{c}_i, \text { where } T_i=\exp \left(-\sum_{j=1}^{i-1} \sigma_j \delta_j\right)\\&t_i \sim \mathcal{U}\left[t_n+\frac{i-1}{N}\left(t_f-t_n\right), t_n+\frac{i}{N}\left(t_f-t_n\right)\right]\end{aligned} $$- $t_i$ 这里是在进行分层采样(将$t_n$到$t_f$之间的距离等分为$\mathrm{N}$块, 每一块里面随机选取一个采样点), $\mathrm{N}$ 为采样值(设定为64或128…).
- 注意这里的公式是由上面的积分公式转变而来, 使用的是求积规则 (We use these samples to estimate $C(r)$ with the quadrature rule discussed in the volume rendering review by Max [Optical Models for Direct Volume Rendering])
下面的文章公式推导更详细
3. 优化神经辐射场的方法
3.1. 高频位置编码 Positional encoding
如果直接将 $(x,y,z,θ,φ)$ 5维信息输入网络 $F_θ$ 会导致渲染在表示颜色和几何形状的高频变化方面表现不佳(细节缺失). (神经网络有个特点就是倾向于学习低频函数, 如果网络中缺少高频信息, 那么这个现象会更加明显)
-
举例来说, 左图是低频函数, 右图是高频函数. 左边x轴靠得近的点, y的值也相近; 但是相同的x轴距离, 可能在高频函数上, y的值差得很远.
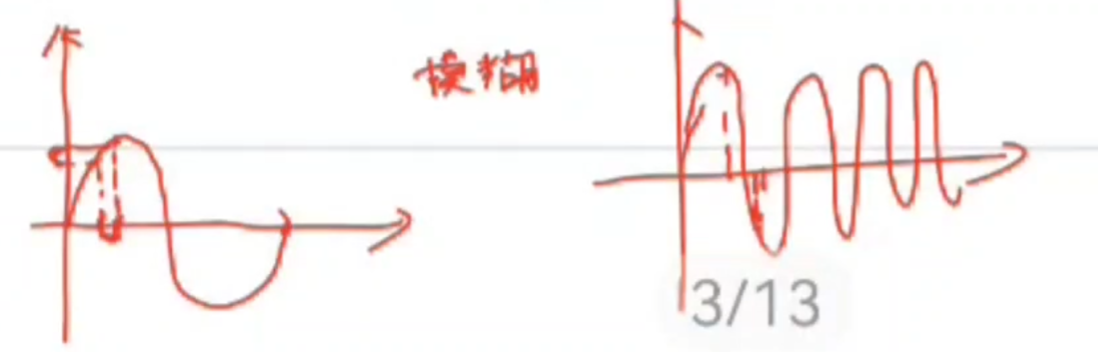
解决方法:
- 在5维信息输入网络之前, 使用高频函数将输入映射到高频空间, 可以帮助网络更好的拟合含有高频变化的数据.
具体做法:
-
将5维数据的每一项都转换为含有高频信号的向量.
-
对于每个点的$(x,y,z)$各自被映射为10个$sin$和$cos$的组合, 也就是从3个分量变成了60个分量(维度).
$$ \left(x, y, z, \ldots,\sin \left(2^{n-1} x\right), \sin \left(2^{n-1} y\right), \sin \left(2^{n-1} z\right), \cos \left(2^{n-1} x\right), \cos \left(2^{n-1} y\right), \cos \left(2^{n-1} z\right) )\right. $$- 注意, 代码中作者在前面加上了 $(z,y,z)$ 的原值, n 取值从 1 到 10. 最终变为 63 个分量.
-
对于每个点上相机的观测方向 $(\theta,\varphi)$ (单位向量, 默认r=1)可以转变为向量 $(x,y,z)$, 并各自被映射为 4 个$sin$和$cos$的组合, 也就是从 3 个分量变成了 24 个分量. 同样的, 代码中作者加上了相机观测方向的原值, 最终变为27个分量.
3.2. 分层采样 Hierarchical sampling
分层采样在这里说过了.
分层采样的问题:
- 直接使用公式中的体渲染积分, 需要控制采样起始点. 如果直接对全局采样, 所需要的计算消耗过大, 且采样区间的点较为稀疏. 假设使用均匀分布采样, 则直接采样效率低. 选择恰当的起始, 终止点在这里是非常重要的.
解决方法:
-
NeRF使用两个网络同时进行训练 (后称 coarse 和 fine 网络 (eg: 粗网络取64个点和精细网络取128+64个点)), coarse 网络输入的点是通过对光线均匀采样得到的, 根据 coarse 网络预测的体密度值, 对光线的分布进行估计, 然后根据估计出的分布进行第二次重要性采样, 然后再把所有的采样点一起输入到 fine 网络进行预测. 具体过程请见下图.
$$ \hat{C}_{c}(\mathbf{r})=\sum_{i=1}^{N_{c}} w_{i} c_{i} \\ w_{i}=T_{i}\left(1-\exp \left(-\sigma_{i} \delta_{i}\right)\right) \\ \hat{w}_{i}=w_{i} / \sum_{j=1}^{N_{c}} w_{j} $$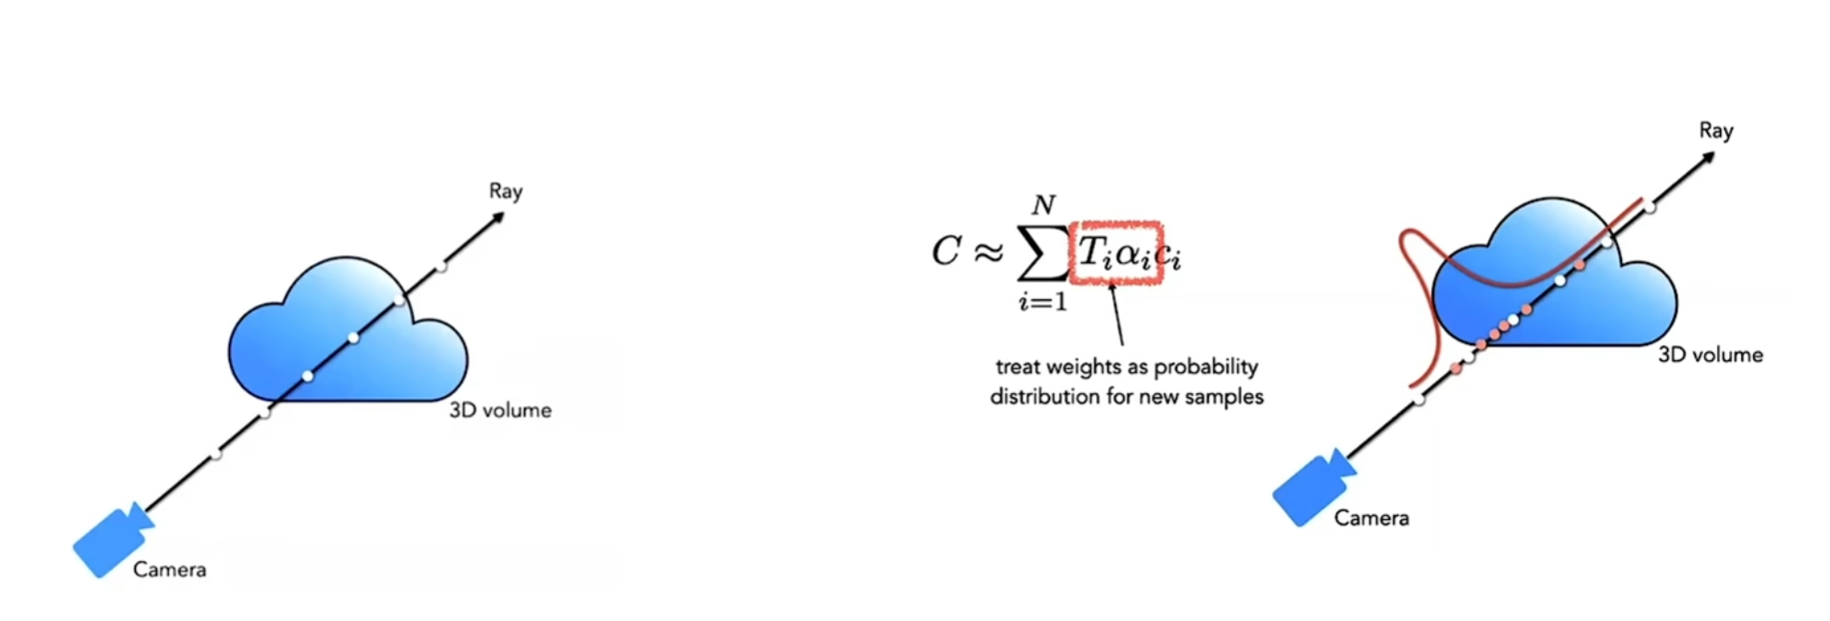
- $\hat{w}_{i}$权重可以看成沿着射线的分段常数概率密度函数(Piecewise-constant PDF)
3.3. Loss
NeRF使用MSE(均方误差)作为loss. 对图片上的每一个像素的颜色都进行loss计算.
$$ \mathcal{L}=\sum_{\mathbf{r} \in \mathcal{R}}\left[\left\|\hat{C}_{c}(\mathbf{r})-C(\mathbf{r})\right\|_{2}^{2}+\left\|\hat{C}_{f}(\mathbf{r})-C(\mathbf{r})\right\|_{2}^{2}\right] $$- $\hat{C}_{c}$是粗网络的颜色, $\hat{C}_{f}$是精细网络的颜色.
4. 网络结构
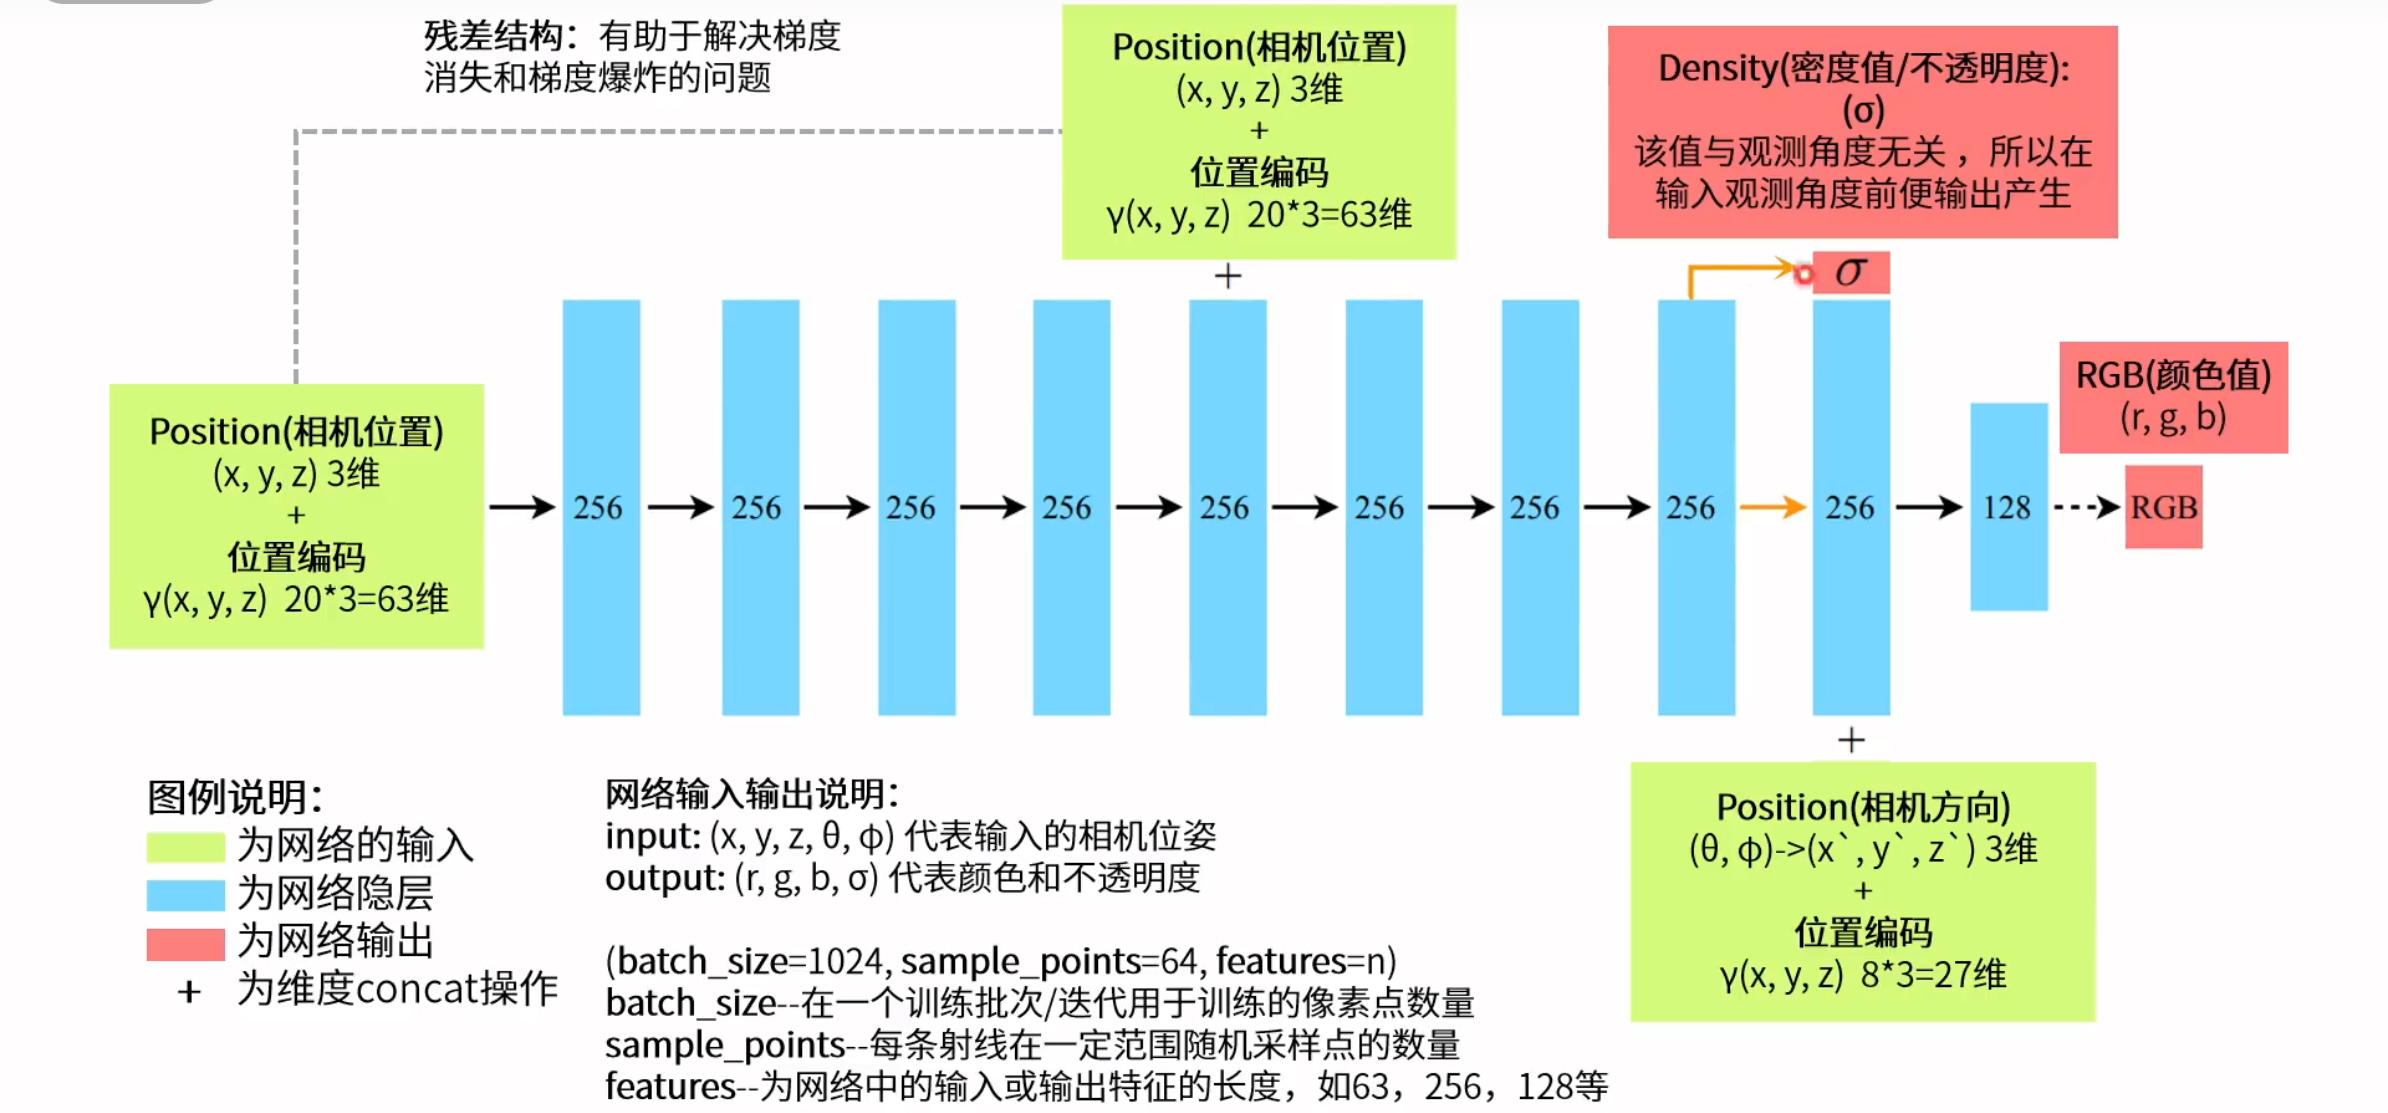
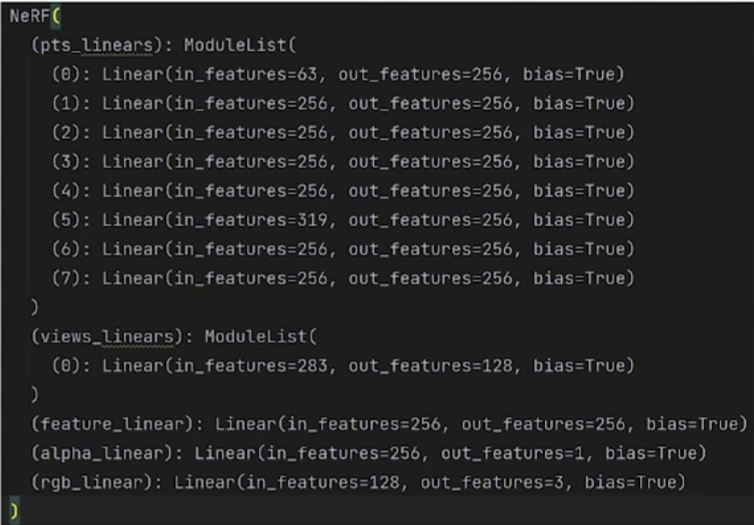
5. 评价指标
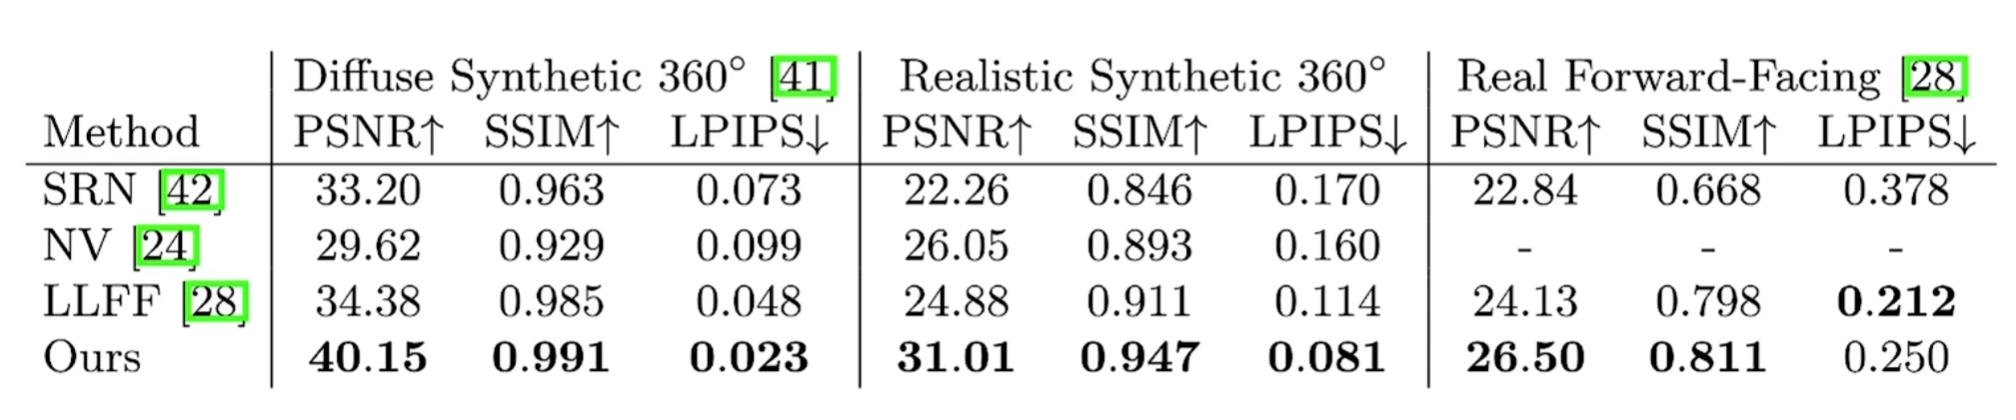
-
PSNR: Peak Signal to Noise Ratio 峰值信噪比
$$ \mathrm{PSNR}=10 \times \lg \left(\frac{\text { MaxValue }^{2}}{\mathrm{MSE}}\right) $$- MSE: 渲染图和原图每个像素的每个通道都做均方误差.
- 值越大越好, MaxValue 为像素值的最大取值, 为255.
-
SSIM: structural similarity 图片结构相似性算法.
$$ \begin{array}{l}\operatorname{SSIM}(\mathbf{x}, \mathbf{y})=[l(\mathbf{x}, \mathbf{y})]^{\alpha} \cdot[c(\mathbf{x}, \mathbf{y})]^{\beta} \cdot[s(\mathbf{x}, \mathbf{y})]^{\gamma} \\\\l(\mathbf{x}, \mathbf{y})=\frac{2 \mu_{x} \mu_{y}+C_{1}}{\mu_{x}^{2}+\mu_{y}^{2}+C_{1}} \longrightarrow \text { 亮度 } \\\\c(\mathbf{x}, \mathbf{y})=\frac{2 \sigma_{x} \sigma_{y}+C_{2}}{\sigma_{x}^{2}+\sigma_{y}^{2}+C_{2}} \longrightarrow \text { 对比度 } \\\\s(\mathbf{x}, \mathbf{y})=\frac{\sigma_{x y}+C_{3}}{\sigma_{x} \sigma_{y}+C_{3}} \longrightarrow \text { 结构 } \\\\\operatorname{SSIM}(\mathbf{x}, \mathbf{y})=\frac{\left(2 \mu_{x} \mu_{y}+C_{1}\right)\left(2 \sigma_{x y}+C_{2}\right)}{\left(\mu_{x}^{2}+\mu_{y}^{2}+C_{1}\right)\left(\sigma_{x}^{2}+\sigma_{y}^{2}+C_{2}\right)}\end{array} $$- 值越大越好, NeRF中$\alpha \beta \gamma$系数都为1; $\mu_x$为图片的均值; $\sigma_x$为图片的方差; $\sigma_{xy}$为两张图片的协方差; C1、C2、C3为常数, 避免分母接近于0时造成的不稳定性.
- 在实际应用中, 可以利用滑动窗口将图像分块, 考虑到窗口形状对分块的影响, 可以采用高斯 加权计算每一窗口的均值、方差以及协方差, 然后计算对应块的结构相似度SSIM, 最后将平均值作为两图像的结构相似性度量, 即平均结构相似性SSIM.
-
LPIPS
$$ d\left(x, x_{0}\right)=\sum_{l} \frac{1}{H_{l} W_{l}} \sum_{h, w}\left\|w_{l} \odot\left(\hat{y}_{h w}^{l}-\hat{y}_{0 h w}^{l}\right)\right\|_{2}^{2} $$- 学习感知图像相似度, 数值越小表示图像的相似性越高.