1. CRNN算法介绍
CRNN 全称为 Convolutional Recurrent Neural Network
- 主要用于端到端地对不定长的文本序列进行识别, 不用先对单个文字进行切割, 而是将文本识别转化为时序依赖的序列学习问题, 就是基于图像的序列识别.
- 对于无字典和有字典的场景都有较好的表现. (不过无字典精度差有字典10%以上)
- 模型结构简单, 性能比Transformer等模型更好.
2. 传统的文字识别模型
- 有些模型基于DCNN
- 缺点:
- 这些模型需要一个很强的词语检测模型. 需要将图片中的词语准确检测出来.
- 需要做一个大范围的分类(英文单词有90K个, 中文1百万)
- 缺点:
3. 模型结构
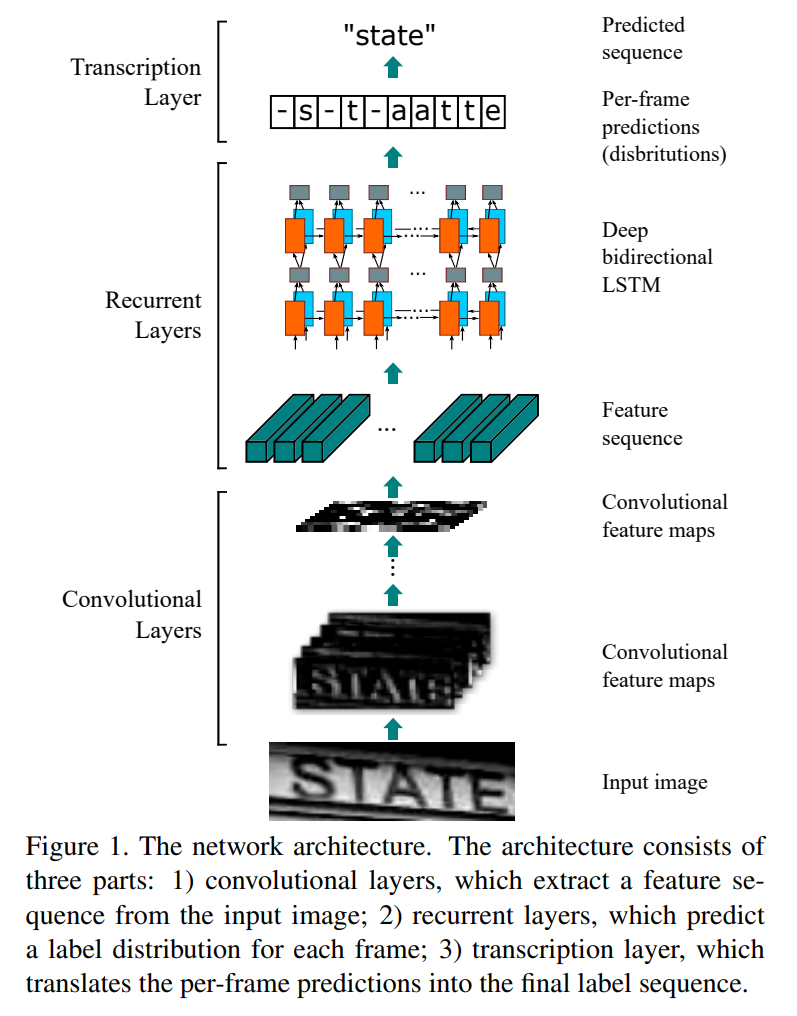
CRNN网络包括3个部分:
- CNN(卷积层), 使用深度CNN, 对输入图像提取特征, 得到特征图;
- RNN(循环层), 使用双向RNN(Bi-LSTM)对特征序列进行预测, 对序列中的每个特征向量进行学习, 并输出预测标签(真实值)分布;
- CTC loss(转录层), 使用 CTC 损失, 把从循环层获取的一系列标签分布转换成最终的标签序列.
3.1. CNN
-
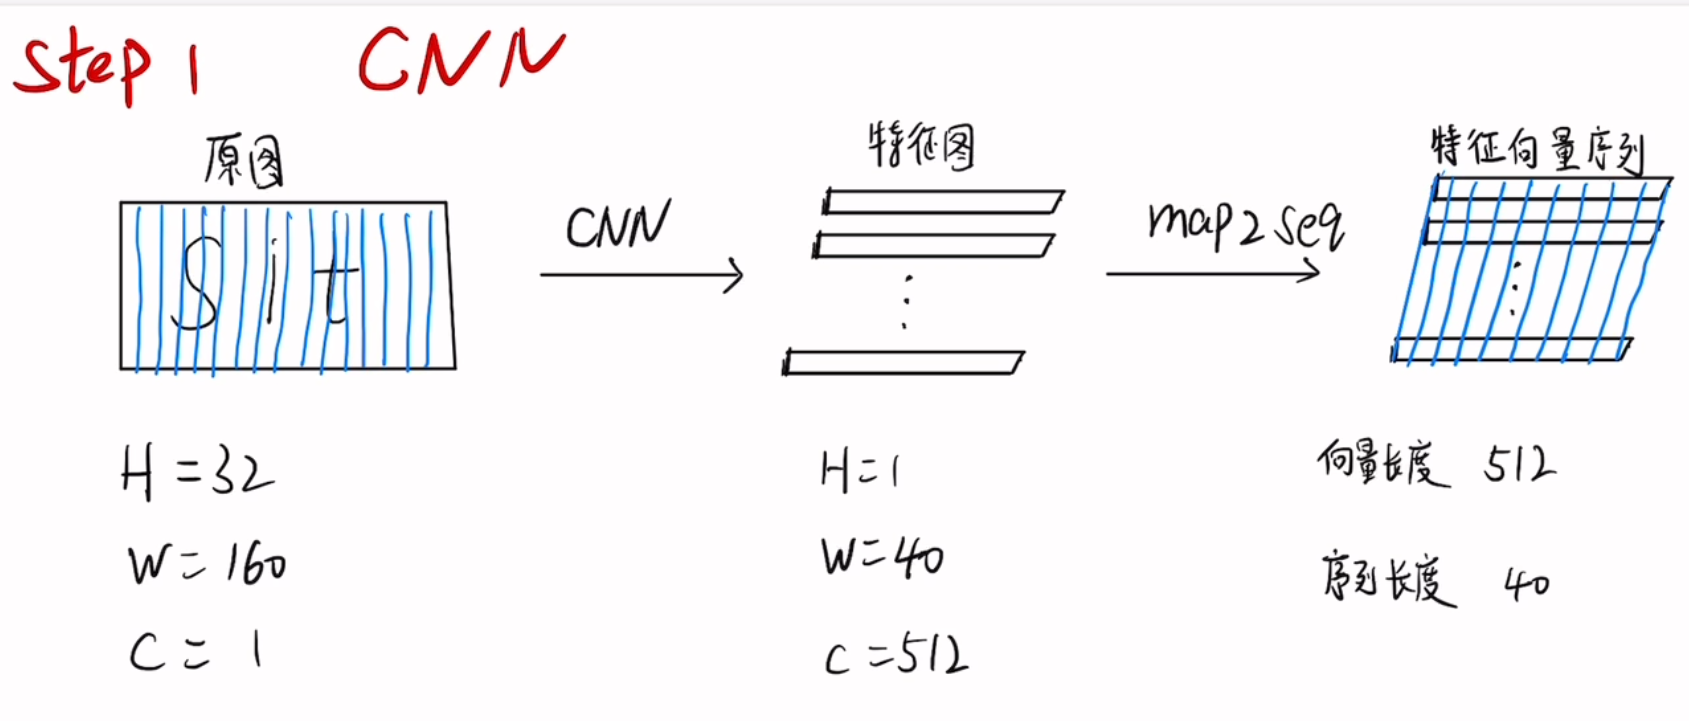
每个特征向量对应于原图中的一个矩形区域 (感受野), 矩形区域从左到右和特征向量的顺序是一一对应的.
- 由于卷积, 池化, 激活层都在局部区域运行, 所以通过卷积块之后特征图的每一列还是对应原始图像的那个矩形区域.
- 由于是要转换为序列, 所以原图的宽度可以不固定(短于设定的宽度大小即可), 但是原图的高度必须固定. 转换为序列的时候, 对应的特征向量序列被切割为宽度固定的单个像素.
3.2. RNN (Bi-LSTM)
- 通过RNN来使特征向量序列转为概率序列.
- 传统RNN层有梯度消失的问题, 所以使用LSTM来解决这个问题. Bi-LSTM可以双向遍历序列并存储上下文信息.
3.3. Transcription 转录
RNN对每个特征向量所做的预测转录为标签序列, 即根据RNN做出的每帧预测找到最高概率组合的标签序列.
3.3.1. CTC (Connectionist Temporal Classification) 训练阶段
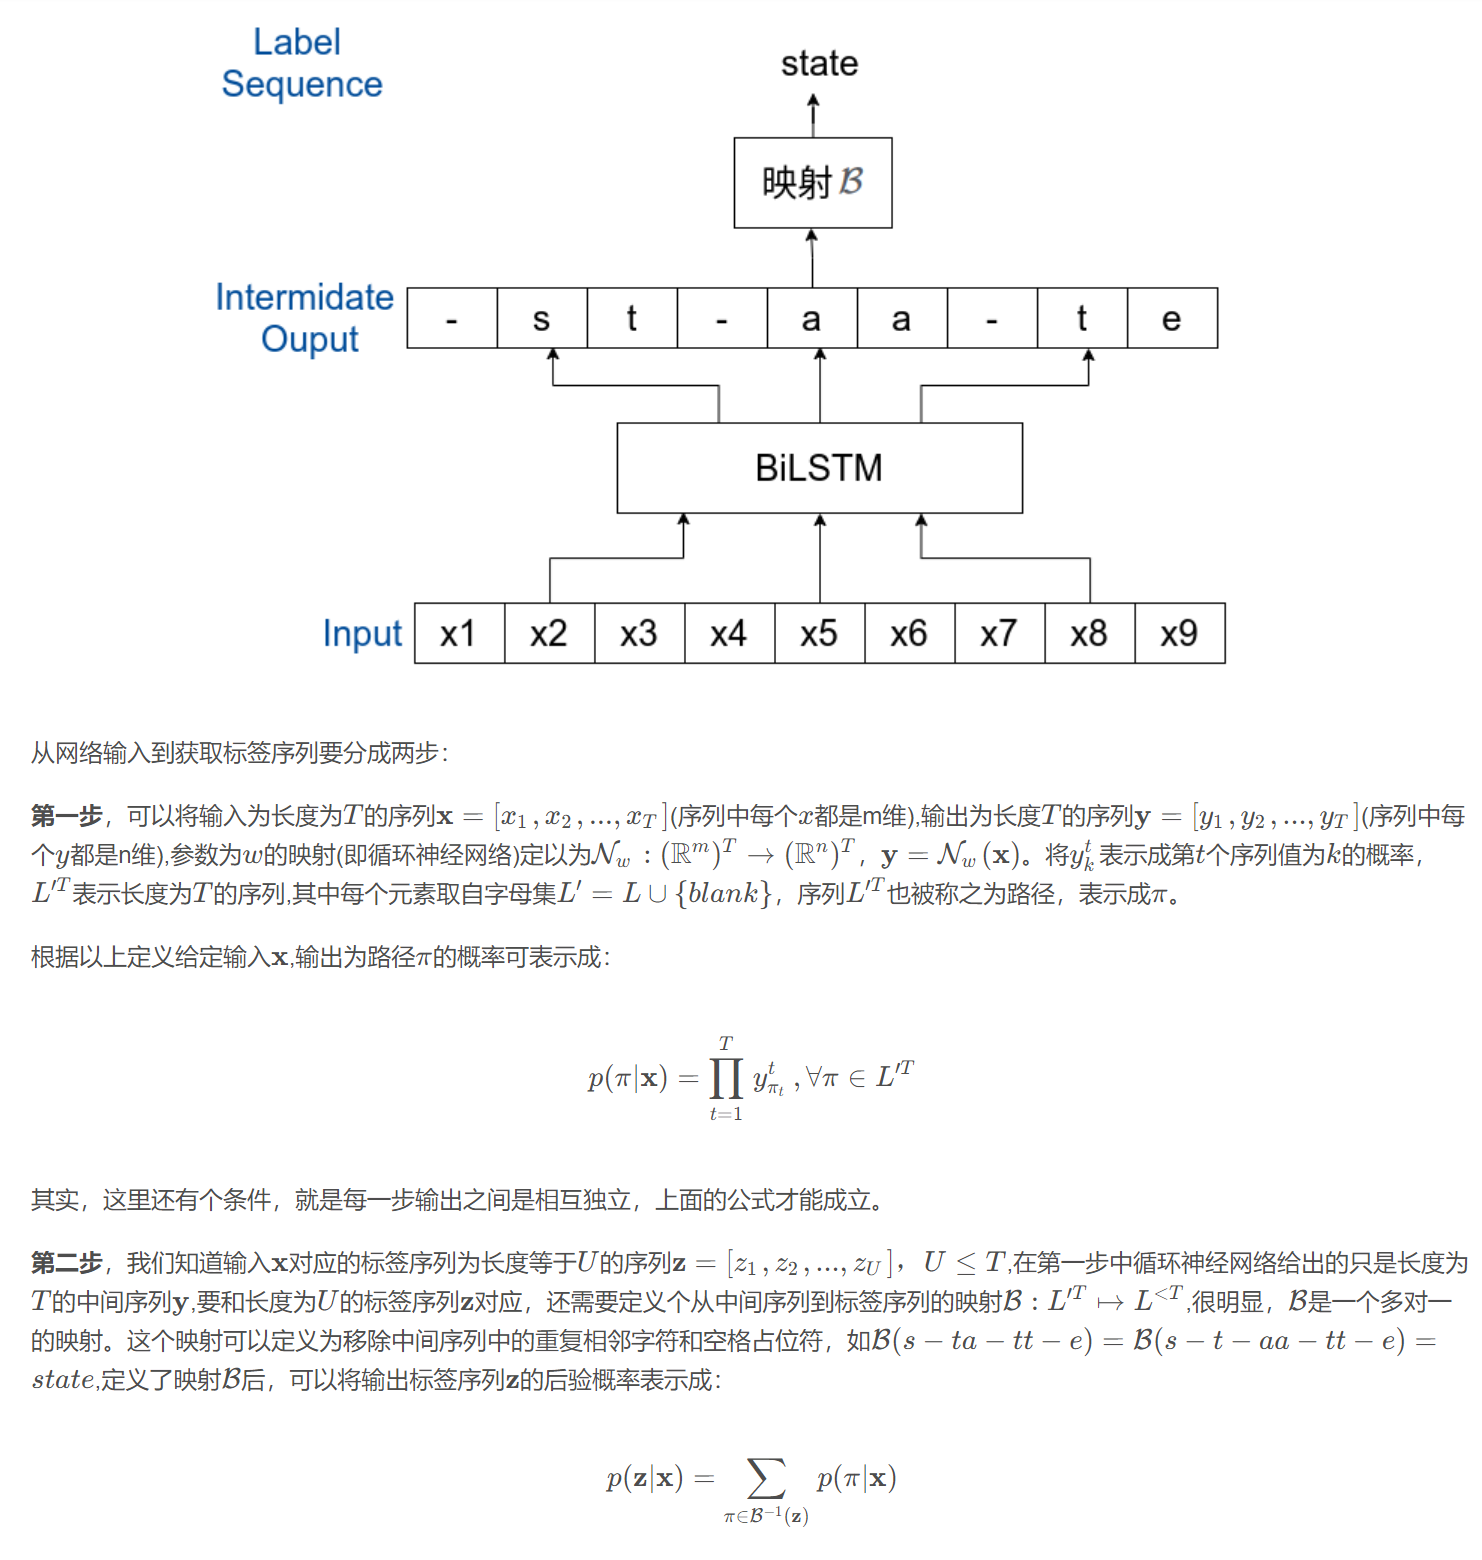
CTC 用于对齐预测的字母, 也就是多对一将字母对齐. 对齐后, 一个字母对应一个置信度, 用于后面的转录.
-
英文字母有26个, 空白部分用减号表示, 所以最终要识别的字符合集是27个字符
-
生成 $\beta$ maps
-
预测的过程中可能有很多种情况(因为同一列中识别出来的结果对应的字母概率不同), 这里的 $\pi_i$ 是任意序列.
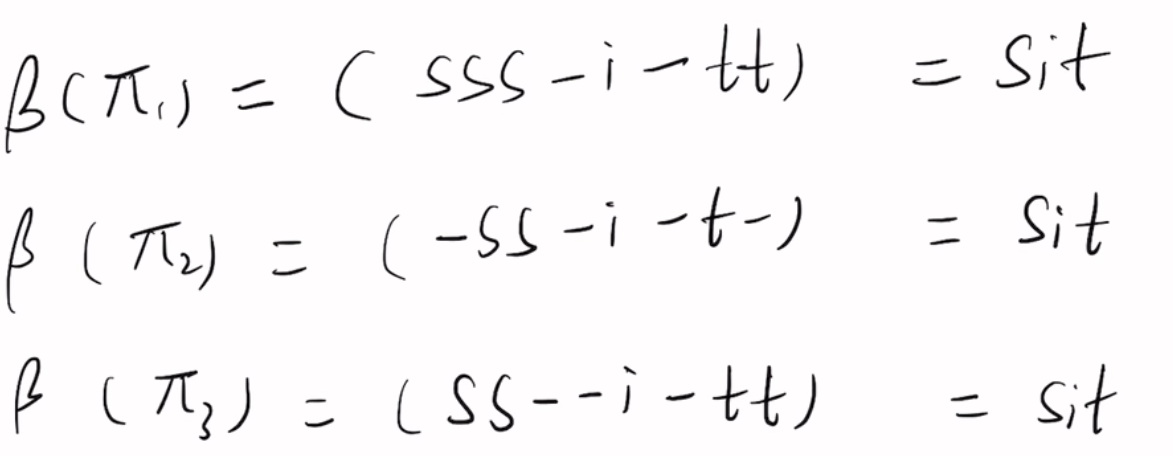
-
-
对于多种情况使用 $\beta$ maps 进行多对一映射.
从RNN网络获取标签序列步骤如下:
-
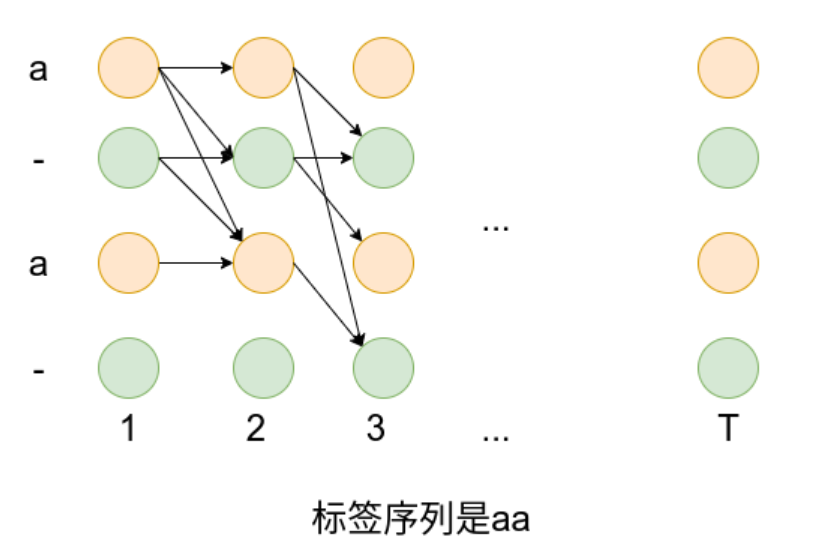
如果第二步的公式计算标签序列的概率的话, 就是暴力计算每一条路径, 时间复杂度为 $O(n^T)$. 需要使用向前-向后算法 (forward-backward algorithm) 来降低时间复杂度.
-
向前向后算法是动态规划算法, 时间复杂度为 $O(nT)$.
-
在实际源码中, 前向后向算法被应用在Pytorch.nn.CTCLoss()函数中, CTCLoss作为训练模型的损失函数.
-
具体过程看以下链接中的 2.3 前向-后向算法
4.OCR文本识别Connectionist Temporal Classification(CTC)算法-CSDN博客
-
具体可以看源码解析
-
前向-后向算法解析视频
机器学习-白板推导系列(十四)-隐马尔可夫模型HMM(Hidden Markov Model)_哔哩哔哩_bilibili
-
3.3.2. 无字典转录 (Lexicon-free transcription) 推理阶段
假设时间步为 $T$, 字符总数为 $N$.
-
贪心搜索 (Greedy search) ← 本篇论文使用
-
时间复杂度为 $O(N*T)$
-
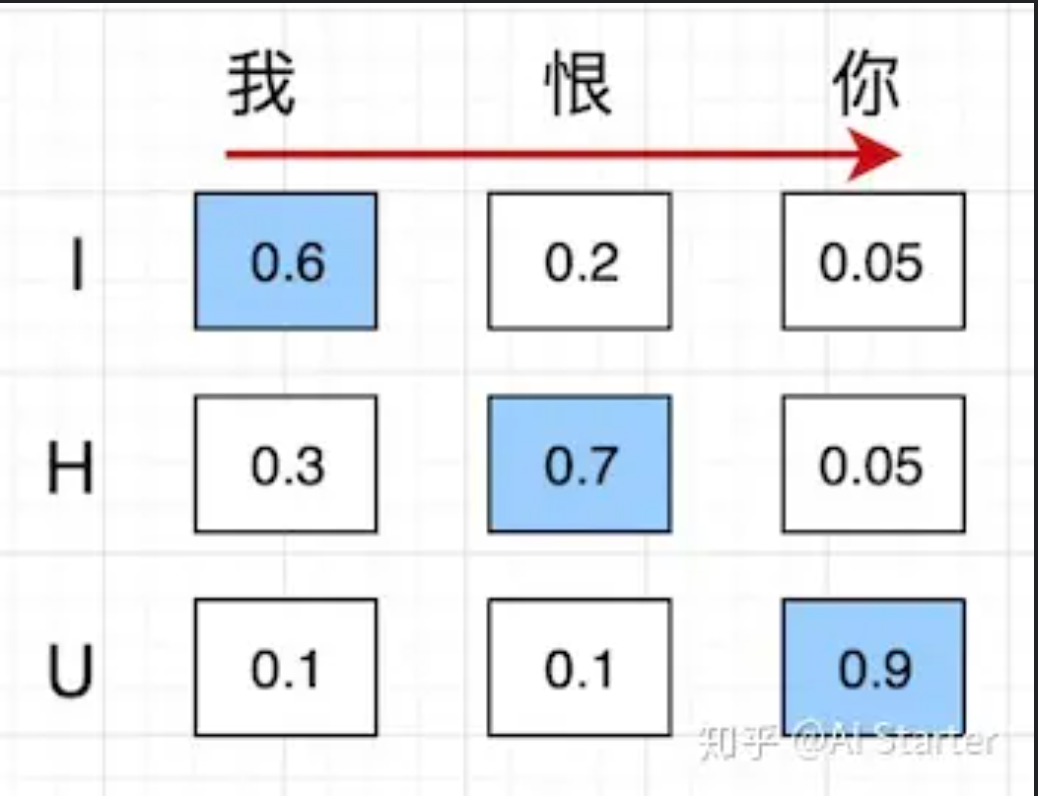
方法
每次都直接在序列中找预测结果概率最大的字母. 拿翻译问题的图举例(把汉字”我恨你”换成时间步”1,2,3”即可):
-
-
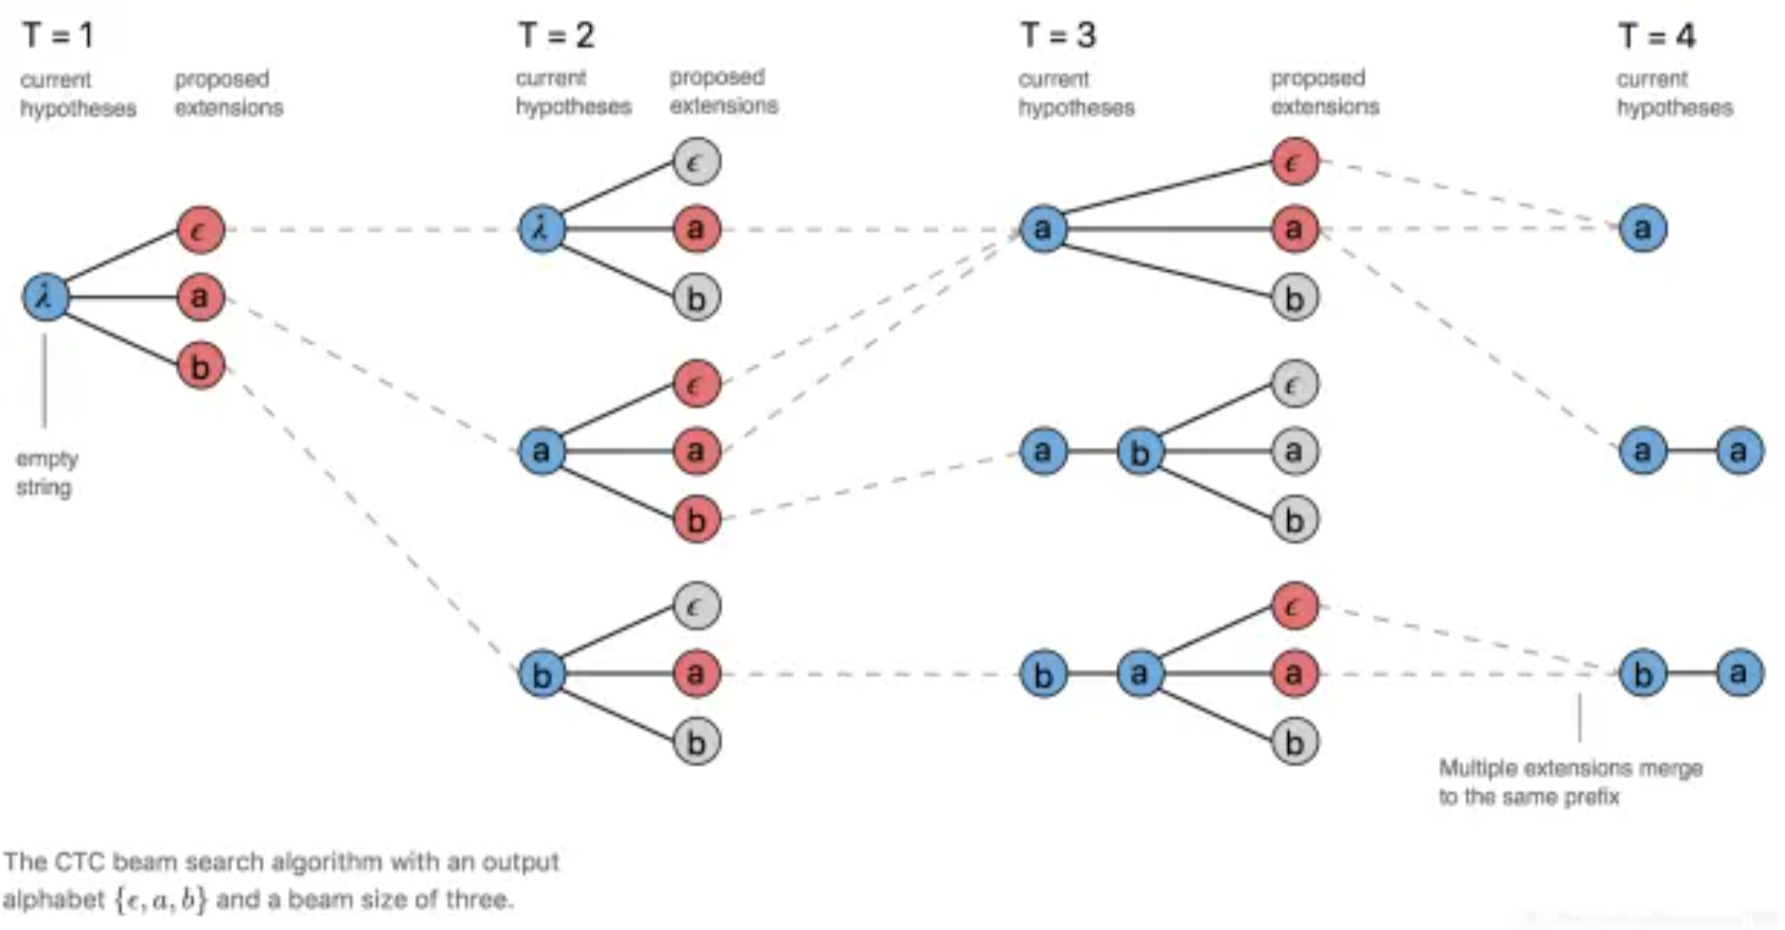
束搜索 (Beam-search) ← 可以不使用CTC就进行转录, 但是时间复杂度高, 本篇论文没有使用
-
Beam-search 算法是以较少的代价在相对受限的搜索空间中找出近似最优解.
-
它的搜索空间比贪心搜索更大, 但速度更慢.
-
需要先设定一个超参数 $k$: 束宽 (beam size).
-
时间复杂度为 $O(N*T*k)$.
-
方法
时间步1: 选择 $k$ 个概率最高的字符.
时间步2: 从前面的 $k$ 个字符中分别会分裂出27个候选字符, 只抽取条件概率 (就是时间步1中选出的字符出现并且时间步2候选字符出现的概率(概率相乘)) 最高的 $k$ 个字符作为候选.
以此类推, 下图假设预测分类中只有3个字符(2个字母和1个空白符).
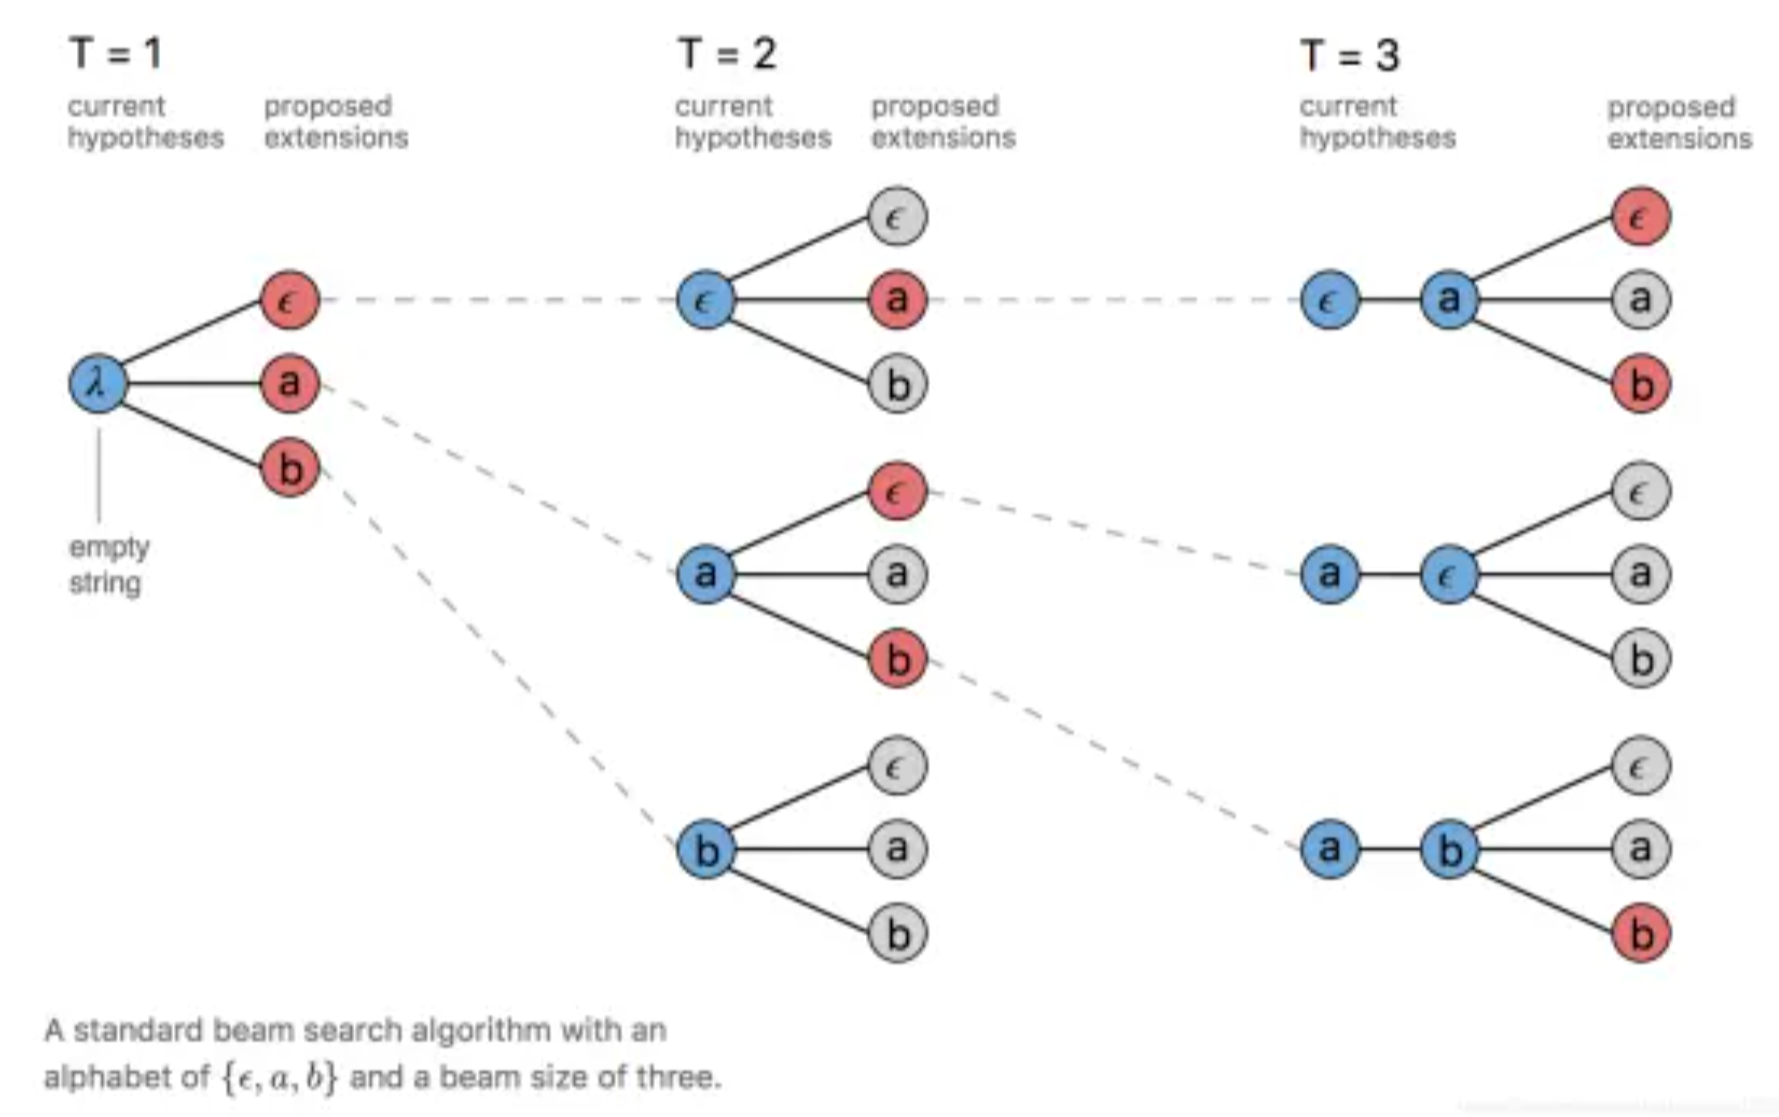
但是, 由于需要结合多个对齐能够映射到同一输出字符的这种情况, 需要把重复字符和空格符也考虑进来.
最后一个时间步, 找到最大的候选序列条件概率就行了.
-
3.3.3. 基于字典转录 (Lexicon-based transcription) 推理阶段
-
BK树: 被设计于快速查找近似字符串匹配 ← 本篇论文使用
BK树查找的时间复杂度: $O(logn)$
- $n$ 是字典中的单词数量
Python代码可以参考:
快速匹配字符串算法BK树 原理及python实现_bk树 python代码-CSDN博客
-
建立一个字典, 保存所有单词 (比如所有英语单词)
-
使用 Levenshtein 距离 (编辑距离) 计算任意一个根单词与字典中所有单词的距离, 建立BK树
Levenshtein 距离表示通过对一个字符串只进行插入, 删除, 替换这3个操作, 从而使其与另一个字符串相等所需的最小编辑操作次数.
- 例如, 从FAME到GATE需要两步 (两次替换), 从GAME到ACM则需要三步 (删除G和E再添加C)
- 编辑距离计算是一个动态规划问题.
-
建立BK树
-
建树逻辑
BK树中的每个节点都只有一个具有相同编辑距离的子节点. 如果我们在插入时遇到编辑距离的某些冲突, 我们将向冲突的叶子节点传播插入过程, 直到找到字符串节点的适当父节点.
-
-
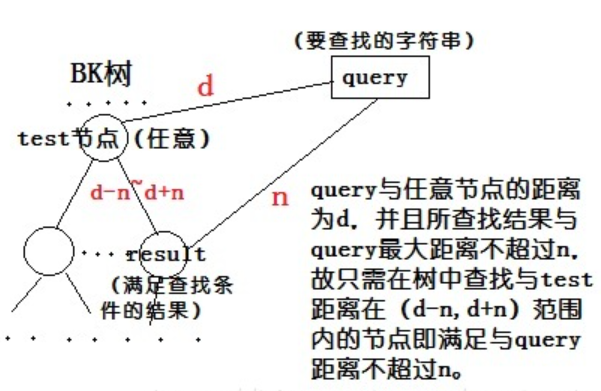
定理 $\alpha$: d(x,y) + d(y,z) >= d(x,z). 三角不等式 (Triangle Inequality). 三角不等式表明 x 到 z 的路径不可能长于另一个中间点的任何路径 (从 x 到 y 再到 z). 看下三角形, 你不可能从一点到另外一点的两侧再画出一条比它更短的边来.
- d(query, root): 要查找的词和根节点的编辑距离
- d(query, fit_word): 要查找的词和BK树上的所有词, 但是 n 是自己设定的, 编辑距离需要小于n.
- d(root, fit_word): 根据定理 $\alpha$, 根节点与字典词的编辑距离一定是 d-n 到 d+n 之间. 记录这个距离为子节点编号.
-
查询步骤:
- 计算待查词与根节点的编辑距离 d.
- 递归查找每个子节点编号为 d-n 到 d+n 的边.
- 如果找到编号符合的子节点, 就返回该节点, 并继续查找.
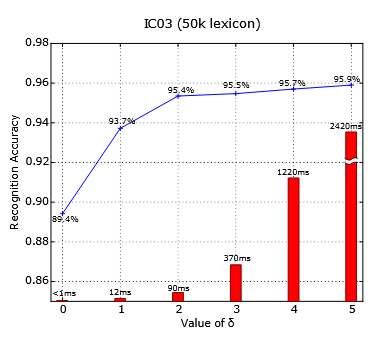
PS: BK树是多路查找树, 并且是不规则的 (但通常是平衡的). 试验表明, 一个查询的搜索距离不会超过树的 5-8%, 两个错误查询的搜索距离不会超过树的 17-25%, 这样可以大幅增加查找性能. 如果要进行精确查找, 也可以非常有效地通过简单地将 n 设置为 0 进行.
图片出处:
-
本论文测试了不同的BK树参数n对查找性能和精度的影响.
3.4. 优化器
本论文源码有 3 个选项, Adam, Adadelta, RMSprop.
4. 实现
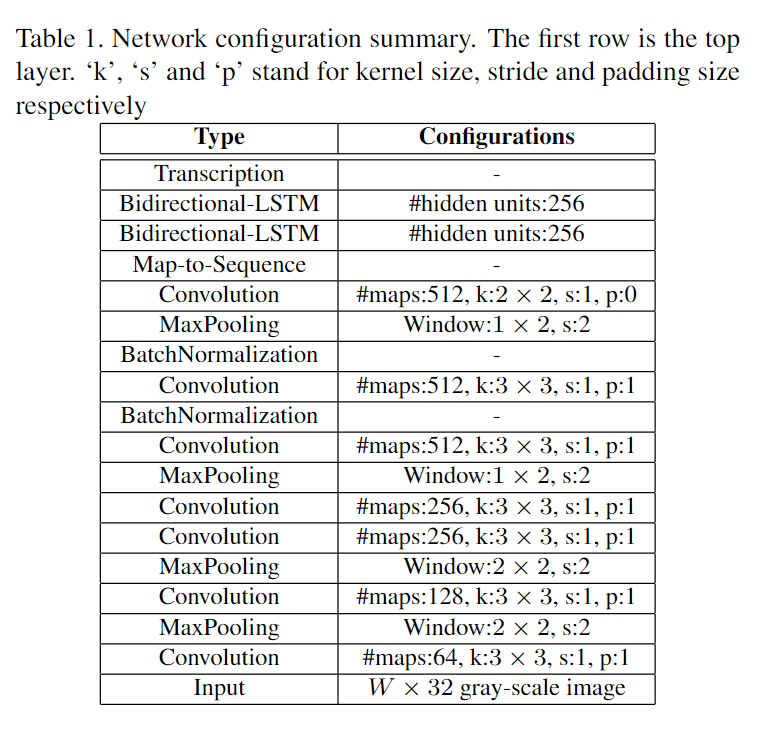
网络配置已在具体结构总结图中给出。卷积层的架构是基于VGG-VeryDeep的,但是为了使其适用于识别英文文本,进行了调整,在第3、4个最大池化层中,采用1*2大小的矩形池化窗口,而不是传统的正方形,这样能够产生宽度较大的特征图,而拥有更长的特征序列。同时,矩形池化窗口产生的矩形感受野也有助于识别一些具有狭长形状的字母,例如‘i’和‘l’。(实际上论文作者给出的代码并不是这样实现的,而是k=(2,2),s=(2,1),p=(1,0),作者的解释是” It’s a typo in the paper :) Should be “1 x 2 stride sizes”.”crnn issue #6)
在第5、6个卷积层之后插入两个批归一化层,能够加快训练的速度。
网络使用ADADELTA训练,参数ρ�设置为0.9。训练期间,所有图像都被缩放为100*32,以加快训练过程,需要大约50小时才能达到收敛。测试图像的高度缩放为32,宽度与高度成比例缩放,但至少为100像素。
5. ABINet
简单介绍一个带Transformer模块的模型.
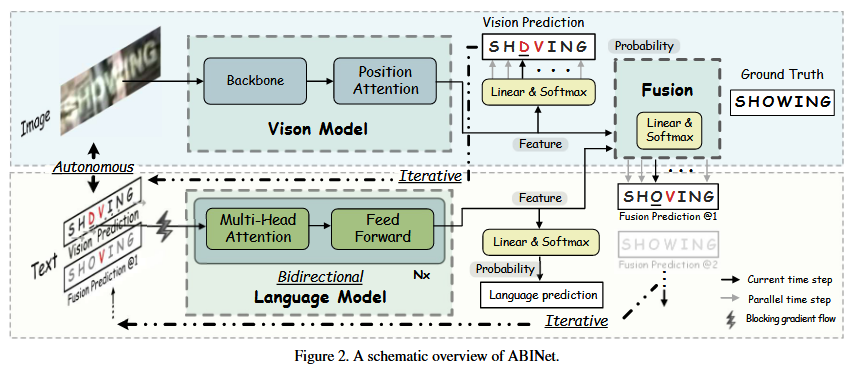
ABINet是一个基于自治的, 双向的, 迭代语言模型的文本识别模型.
5.1. 传统文本识别模型的缺点
- implicitly language modeling: 模型表达的含义很难被利用到
- unidirectional feature representation: 如何表达上下文特征
- language model with noise input: 真实世界中的文本可能存在缺失(如反光, 磨损导致看不到单词中的部分字母)
5.2. 模型
-
图片模型部分: 图3是详细的Vison Model结构, backbone是ResNet+Transformer提取特征,
-
Position Attention 关注的是切割后图的位置编码, 预测的是提取的特征应该融入第几个字母. (因为纵向切割可能将一个字母切成多份图, 构成序列)
-
Vision Prediction: 每个字母都是单条特征融合后和矩阵. (例如: 图片高度20, 第一个字母被纵向切割成10份, 那么融合后的矩阵应该是 20x10 的矩阵), 由字母平成一个单词.
-
图片模型部分结构图
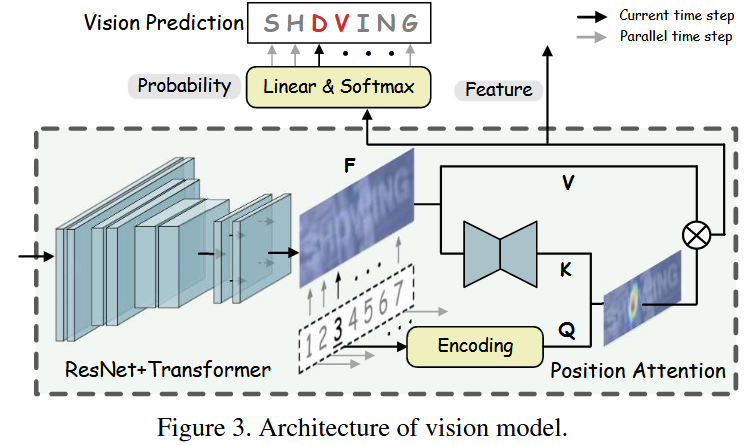
-
-
语言模型部分: 使用 Multi-head Attention 模块计算注意力机制对单词中字母的权重重新分配
-
如果单词权重出现变化, 重复 Text 模块. 反复矫正, 从而使单词更加正确.
-
语言模型部分结构图
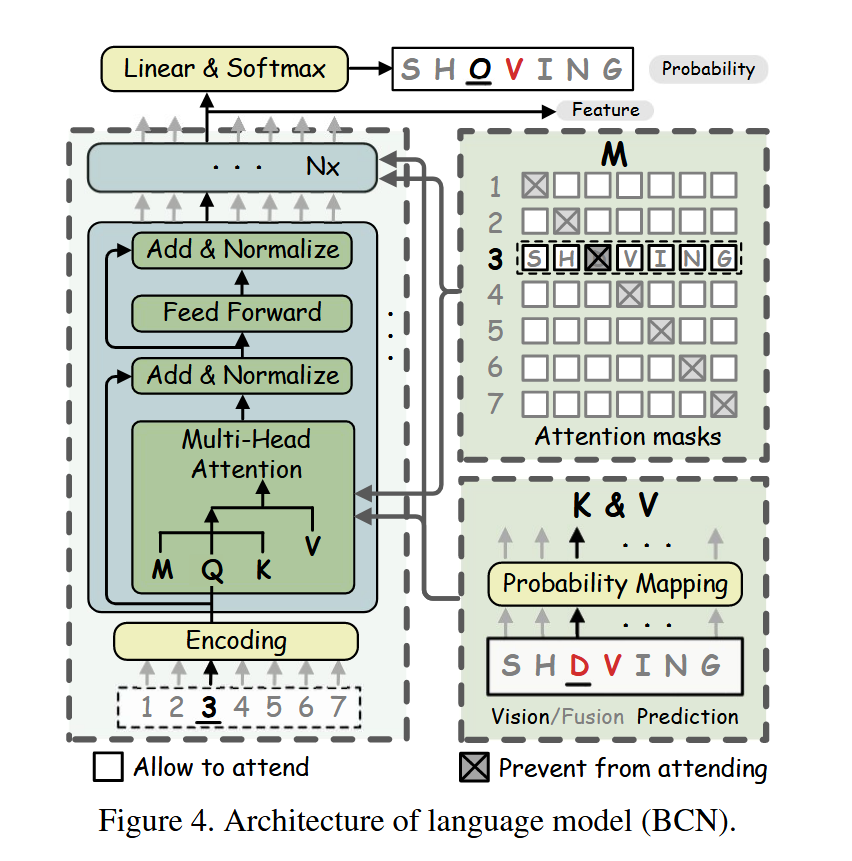
- Attention masks: 在对角线上加上mask, 对单词做完形填空. 意图就是用两边的字母(上下文)来预测中间的字母. 这个预测来对抗图片中的噪音.
-
-
融合模型部分:
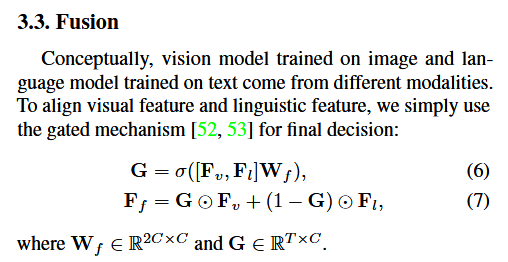
- G 是一个可学习的权重值, 在 $F_f$ 中做加权用.
- 图片模块和文字模块输出的矩阵相加.