1. 原始CNN
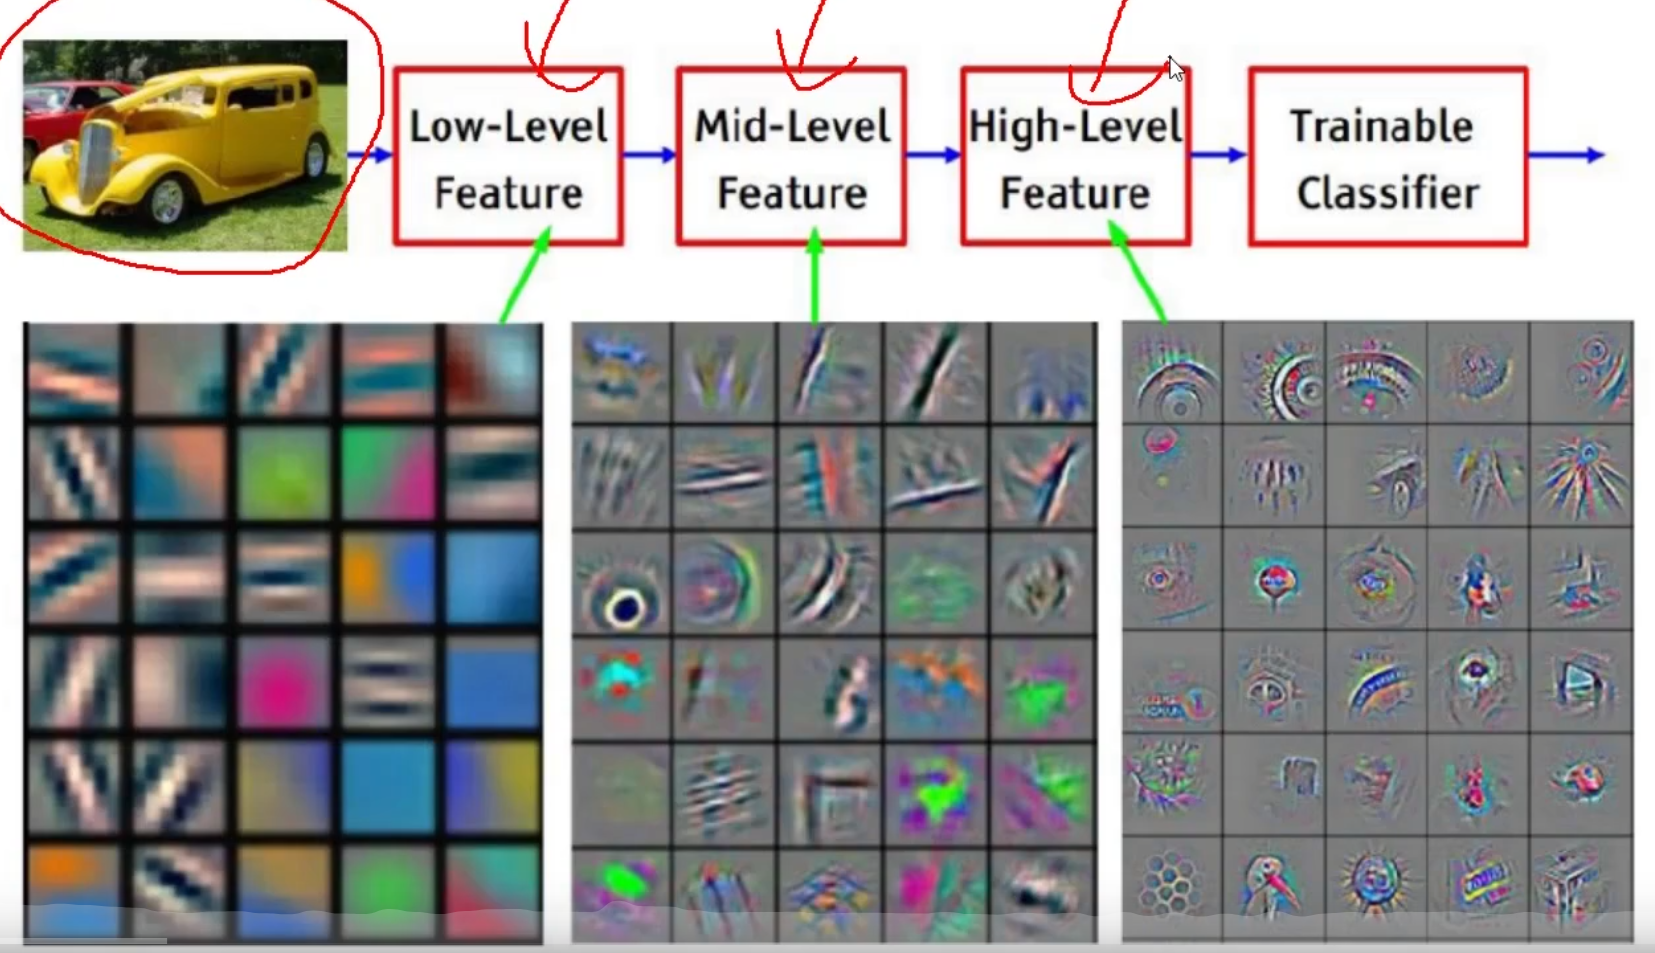
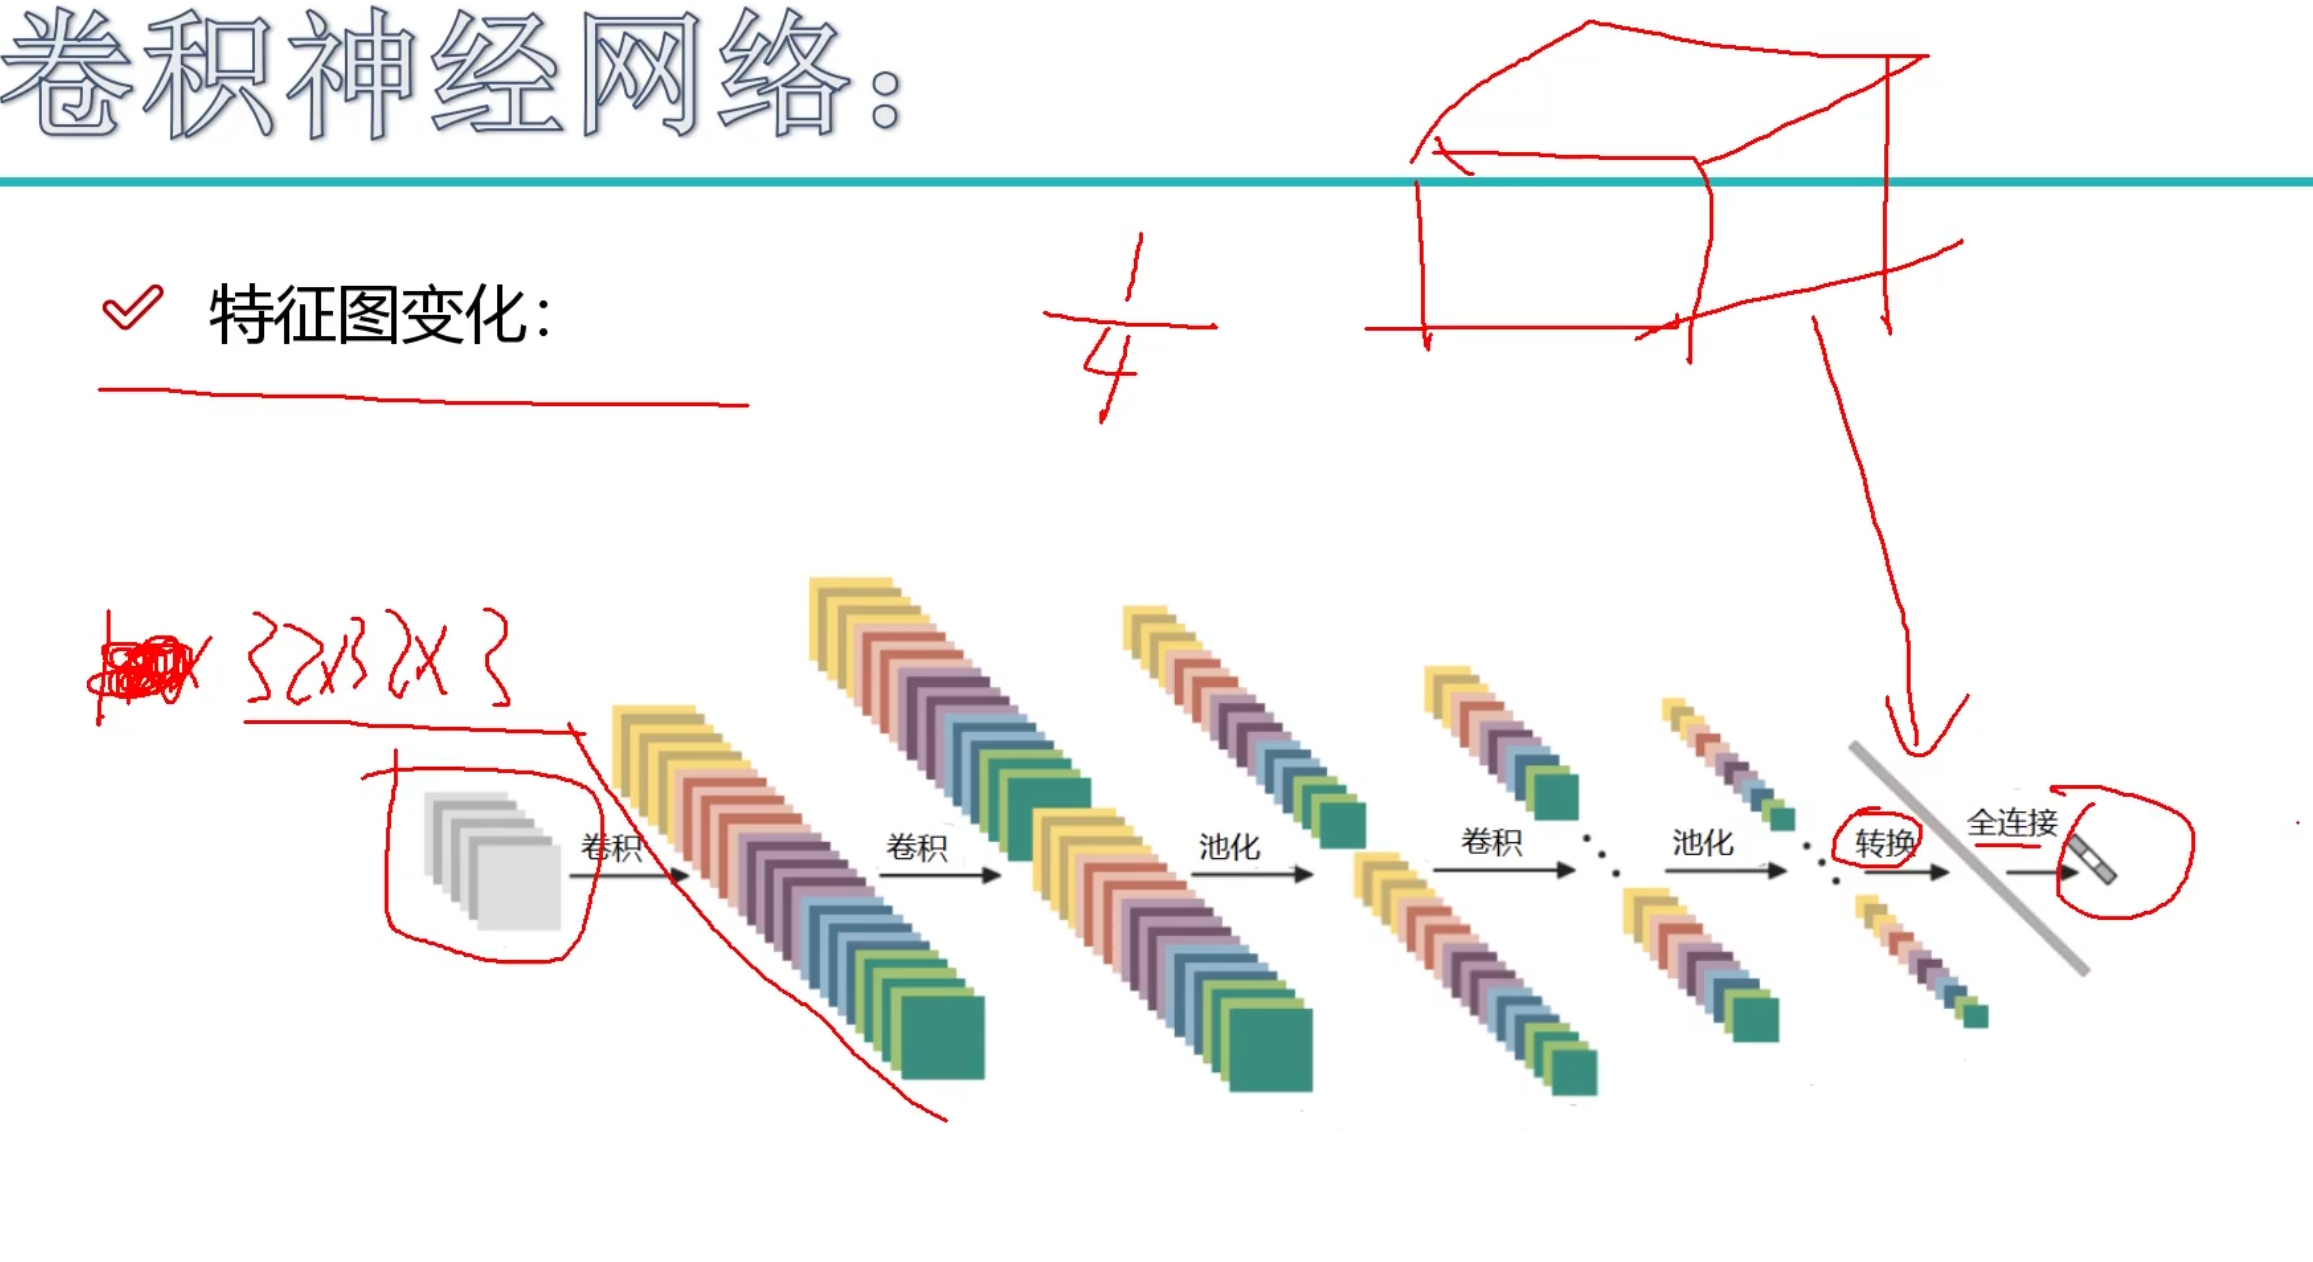
卷积结构的网络大致由 3 各网络层组成: 卷积层, 池化层和全连接层.
1.1. 卷积层 Convolution layer
-
使用不同的卷积核依次进行卷积提取特征
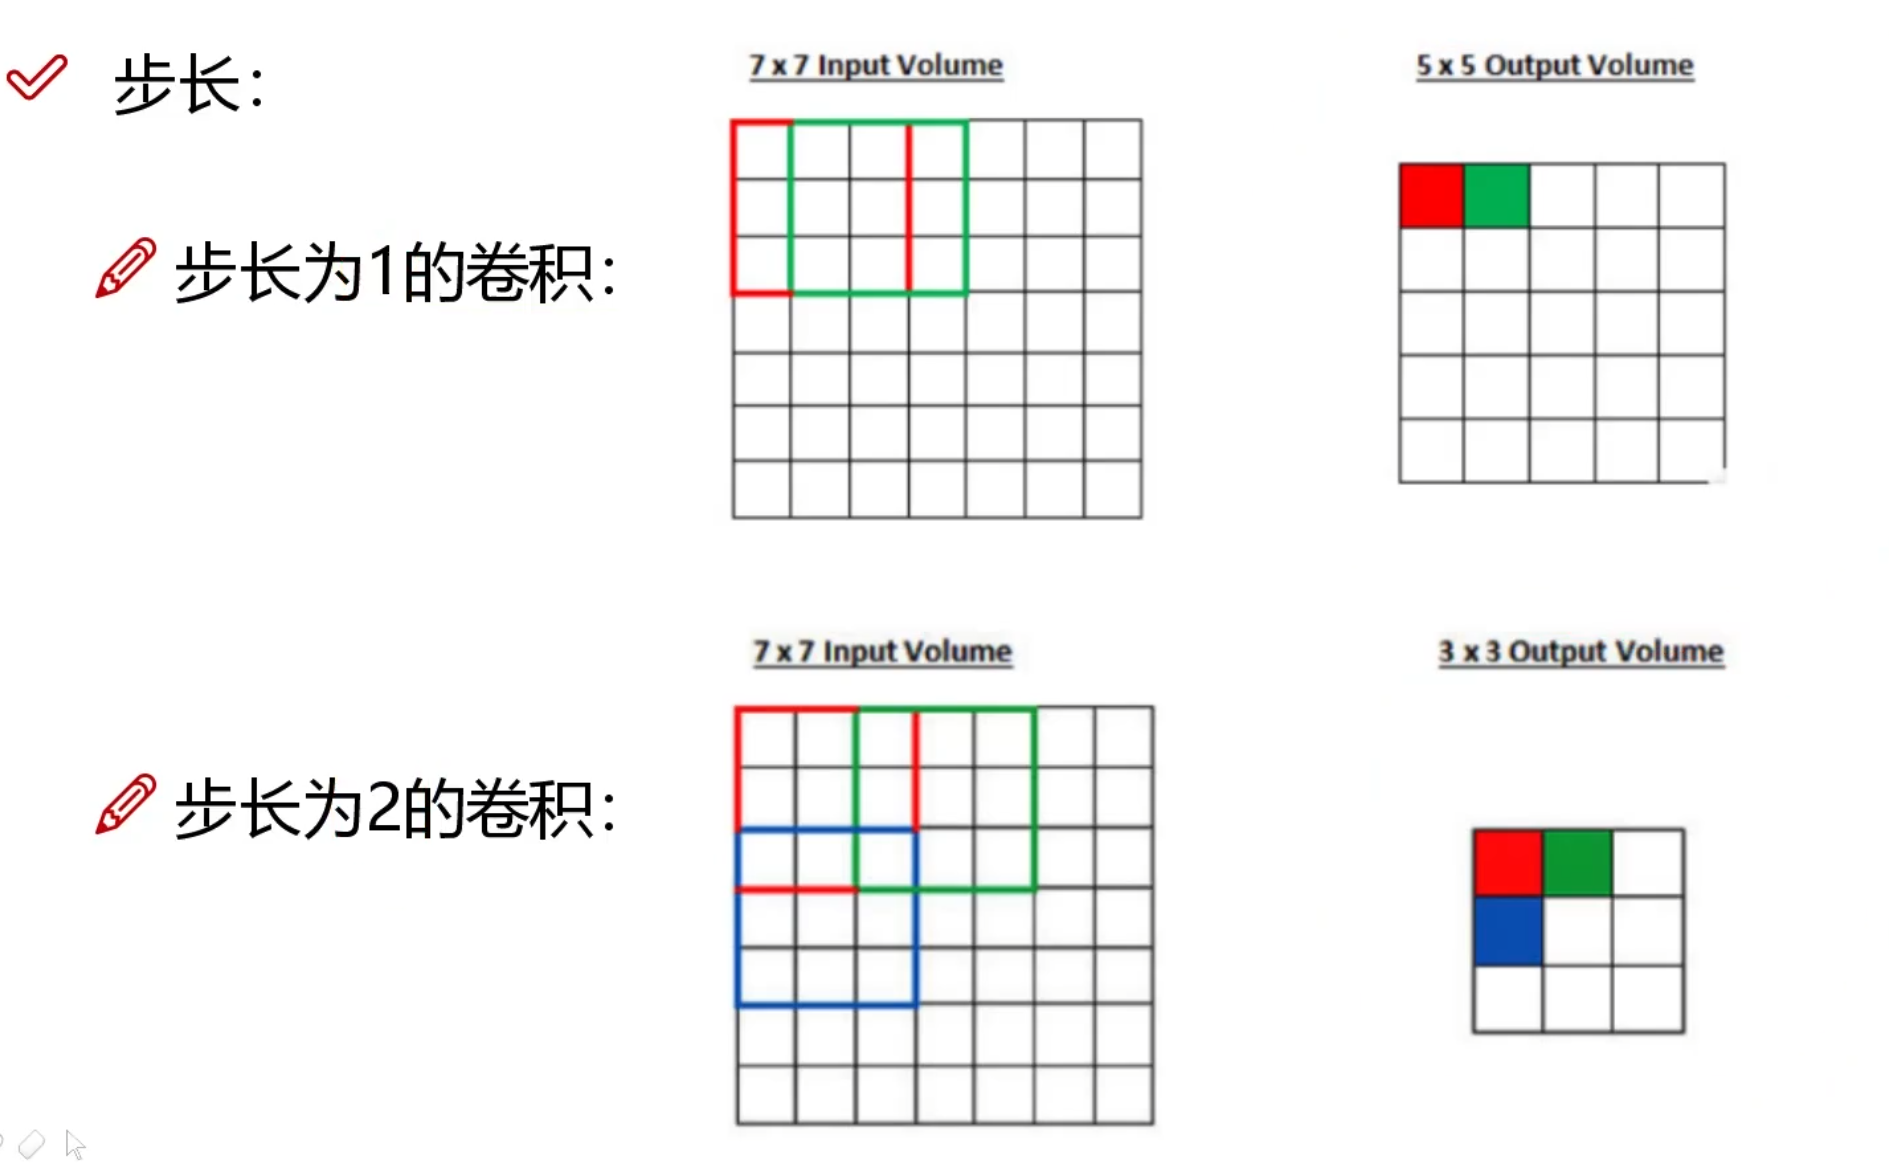
卷积操作涉及的参数如下:
-
滑动窗口步长: 步长不同会导致特征图尺寸不同
- 步长越小, 计算效率越低
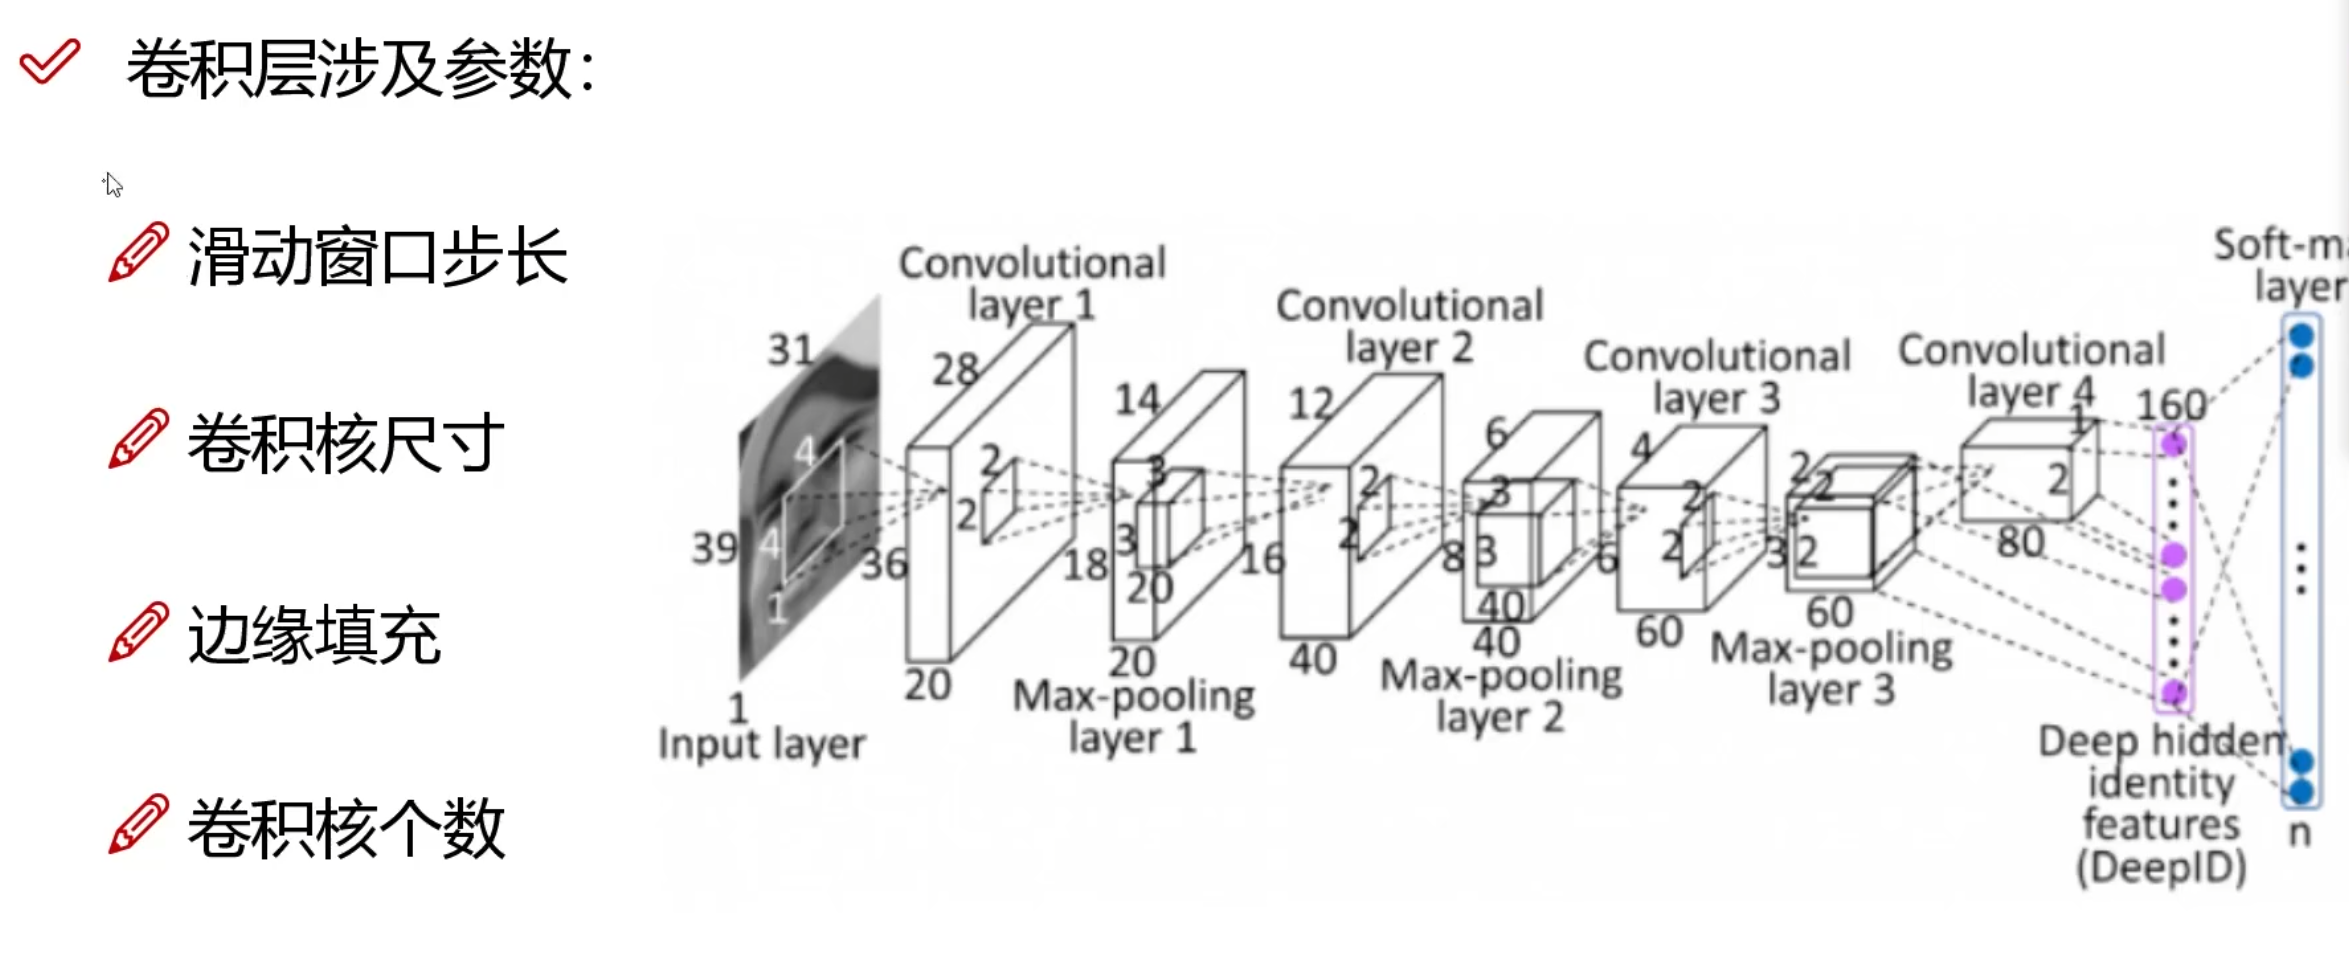
-
卷积核尺寸
-
边缘填充
- 有些卷积核按照特定步长会导致漏掉一些原图的像素, 所以需要再边界补 $0$.
- $0$ 不会对卷积计算产生影响.
-
卷积核个数
- 卷积核的个数决定了特征图的厚度 (第三个维度)
-
-
卷积的尺寸计算, 卷积有两种方式: VALID 和 SAME. VALID 不进行补 $0$, 会漏掉一些原图的参数, SAME 补 $0$, 多加一圈 $0$ 来补齐. 下面的公式是 SAME, 去掉 $2P$ 就是 VALID.
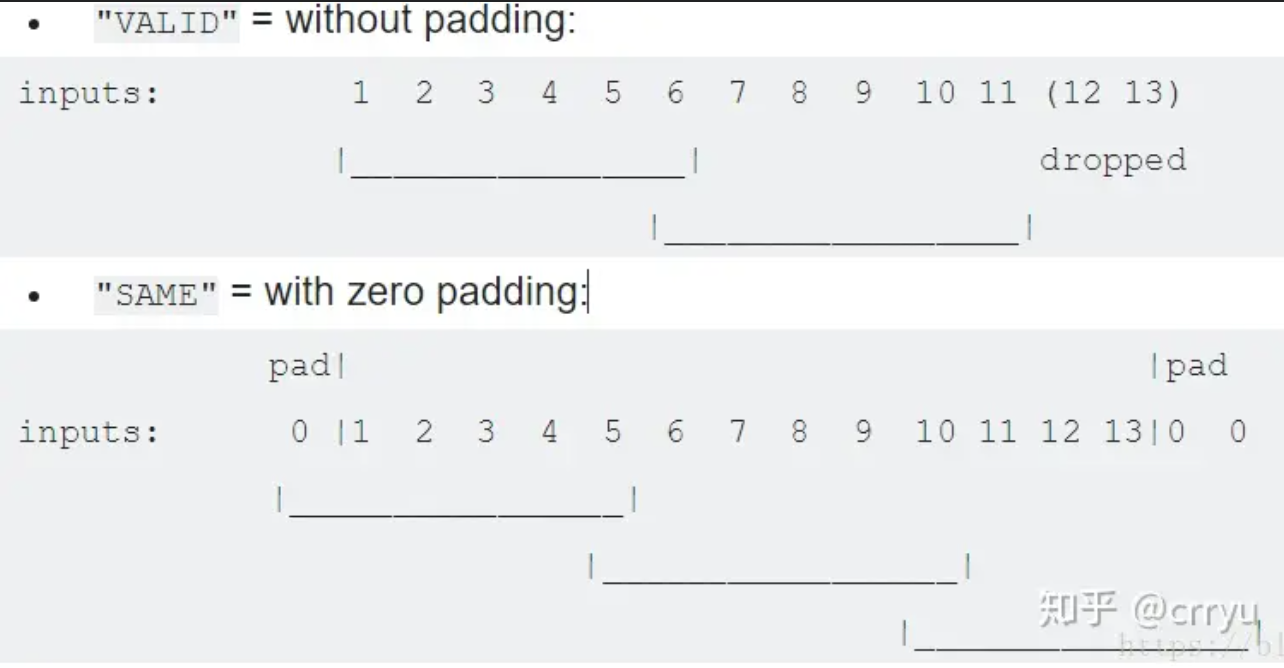
-
长度:
$$ H_2=\frac{H_1-F_H+2 P}{S}+1 $$ -
宽度:
$$ W_2=\frac{W_1-F_W+2 P}{S}+1 $$ -
$W_1,H_1$ 表示 input 的宽度和长度
-
$W_2,H_2$ 表示输入特征图的宽度和长度
-
$F$ 表示卷积核长和宽的大小
-
$S$ 表示滑动窗口的步长
-
$P$ 表示边界填充 (padding) 厚度
-
-
卷积参数共享:
- 如果图像是 $32*32*3$ 的图像, 卷积核有 $10$ 个, 尺寸都为 $5*5*3$ (就是对 RGB 三通道都做卷积). 这样的话, 每个卷积核需要 $5*5*3=75$ 个参数, 加上每个卷积核都有一个对应的偏置参数 $b$, 总共需要 $(75+1)*10$ 个参数.
- 所以卷积网络参数远少于全连接神经网络参数.
-
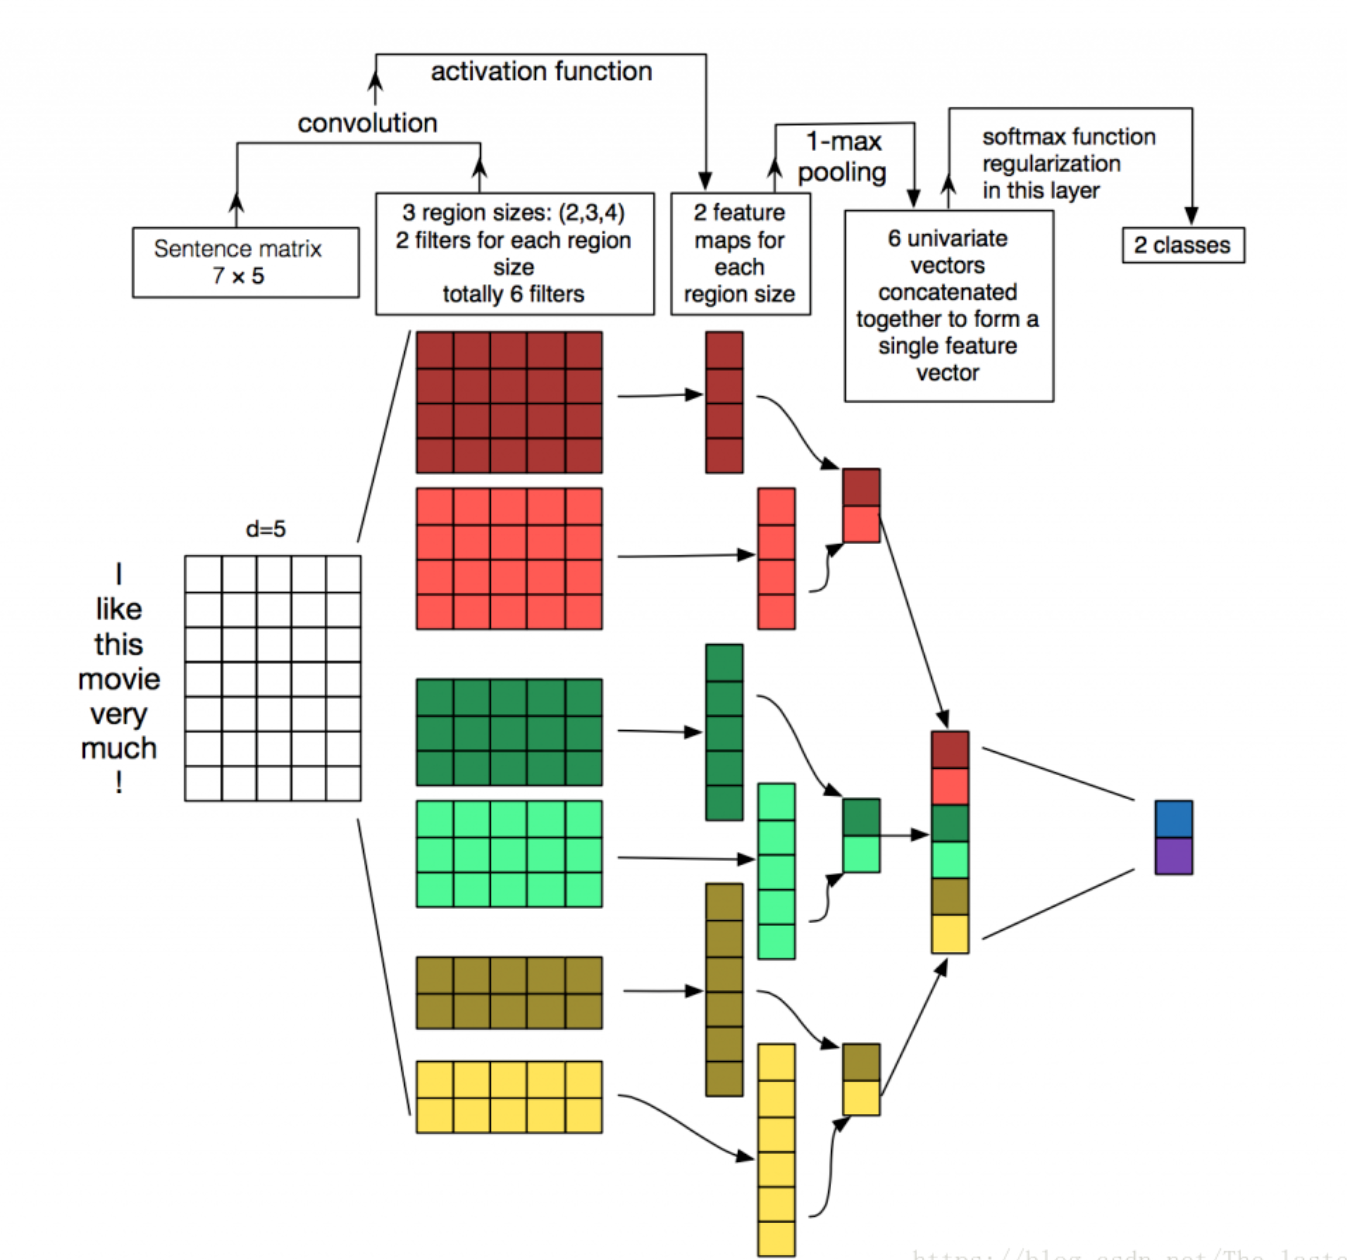
使用多个不同尺寸的卷积核之后全连接如何处理? (NLP 处理句子或 CV 处理图片时被使用到)
1.2. 池化层 Pooling layer
-
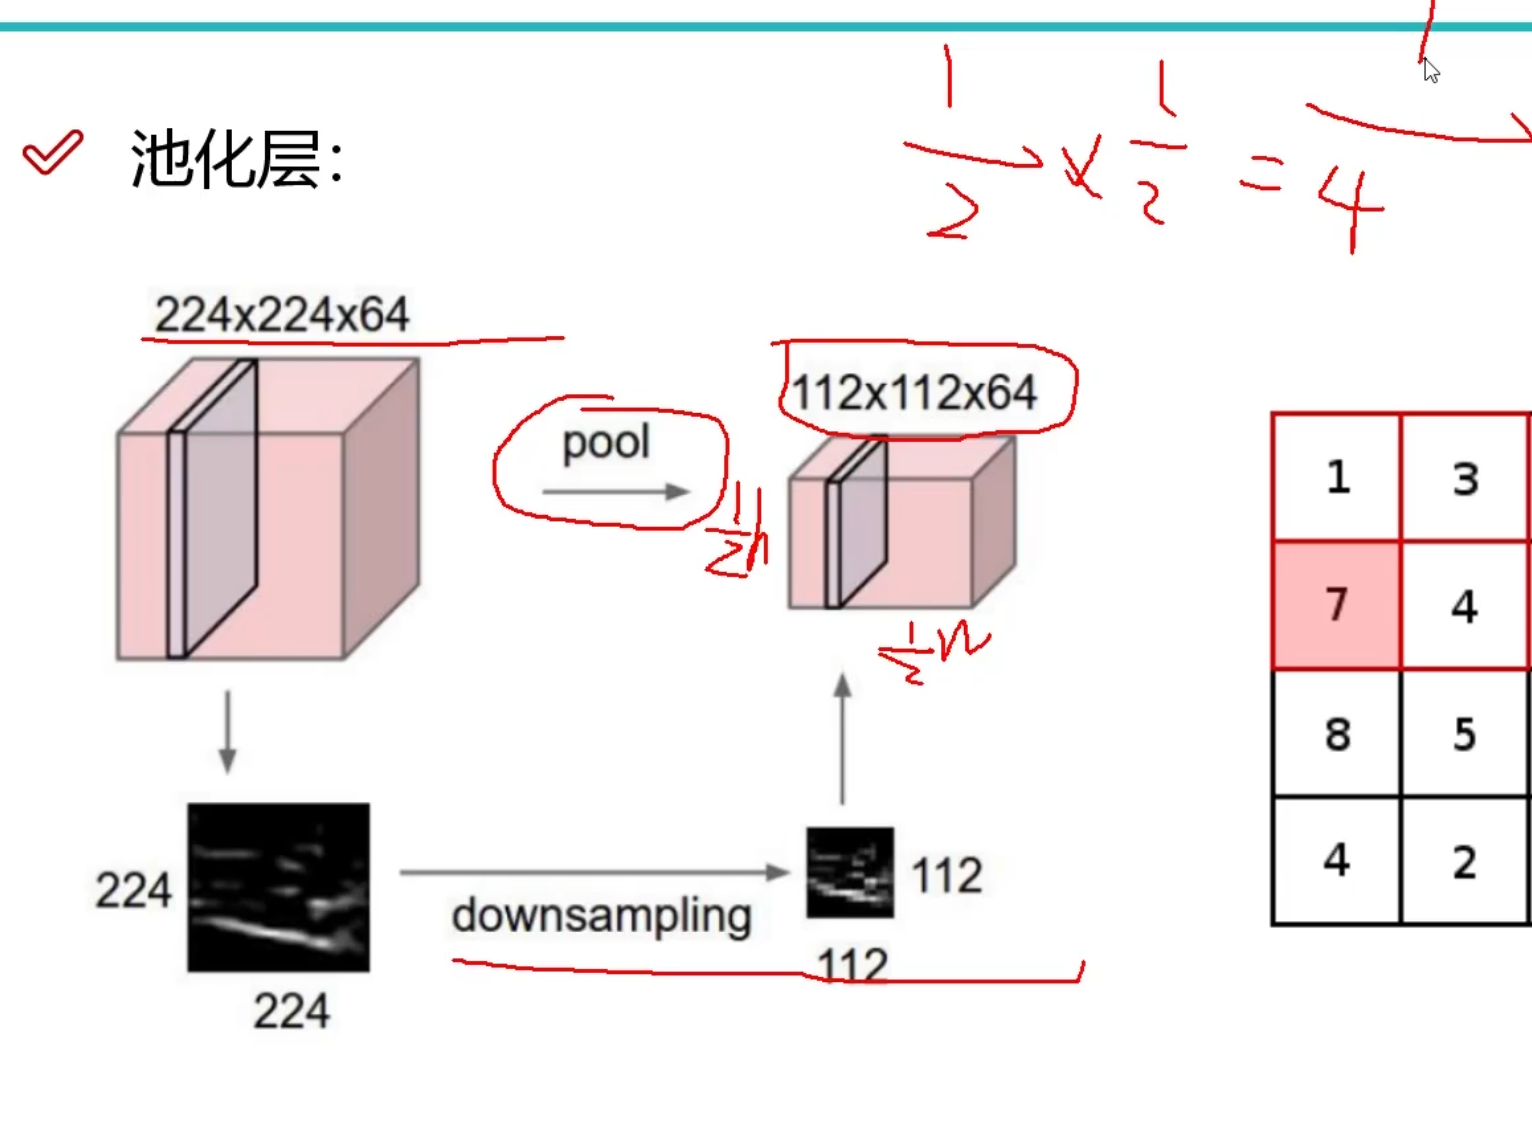
池化层的作用: 用于压缩 (下采样 Down sampling), 因为图片中并不是所有信息都有用.
-
池化层没有用到矩阵的运算, 单纯的是一个筛选.
-
Max pooling
设置一个过滤器 (如 2*2), 取这个过滤器覆盖的数中最大的数
-
为什么使用 Max pooling?
因为神经网络中, 大的值往往更重要, 所以只提取大的值就是只采样重要的值.
-
-
Average pooling
取过滤器中所有数的平均值
- 但是在实际使用中, 基本上 Max pooling 的表现都优于 Average pooling.
-
池化计算
- 如果池化层的卷积核设置为 $n$, 则输入的长宽都除以 $2$.
1.3. 全连接层 Fully Connected Layer
收尾的全连接层是无法对 $3$ 维特征作分类, 所以需要将结果展开成 $1$ 维.
1.4. 一些多层网络上的知识
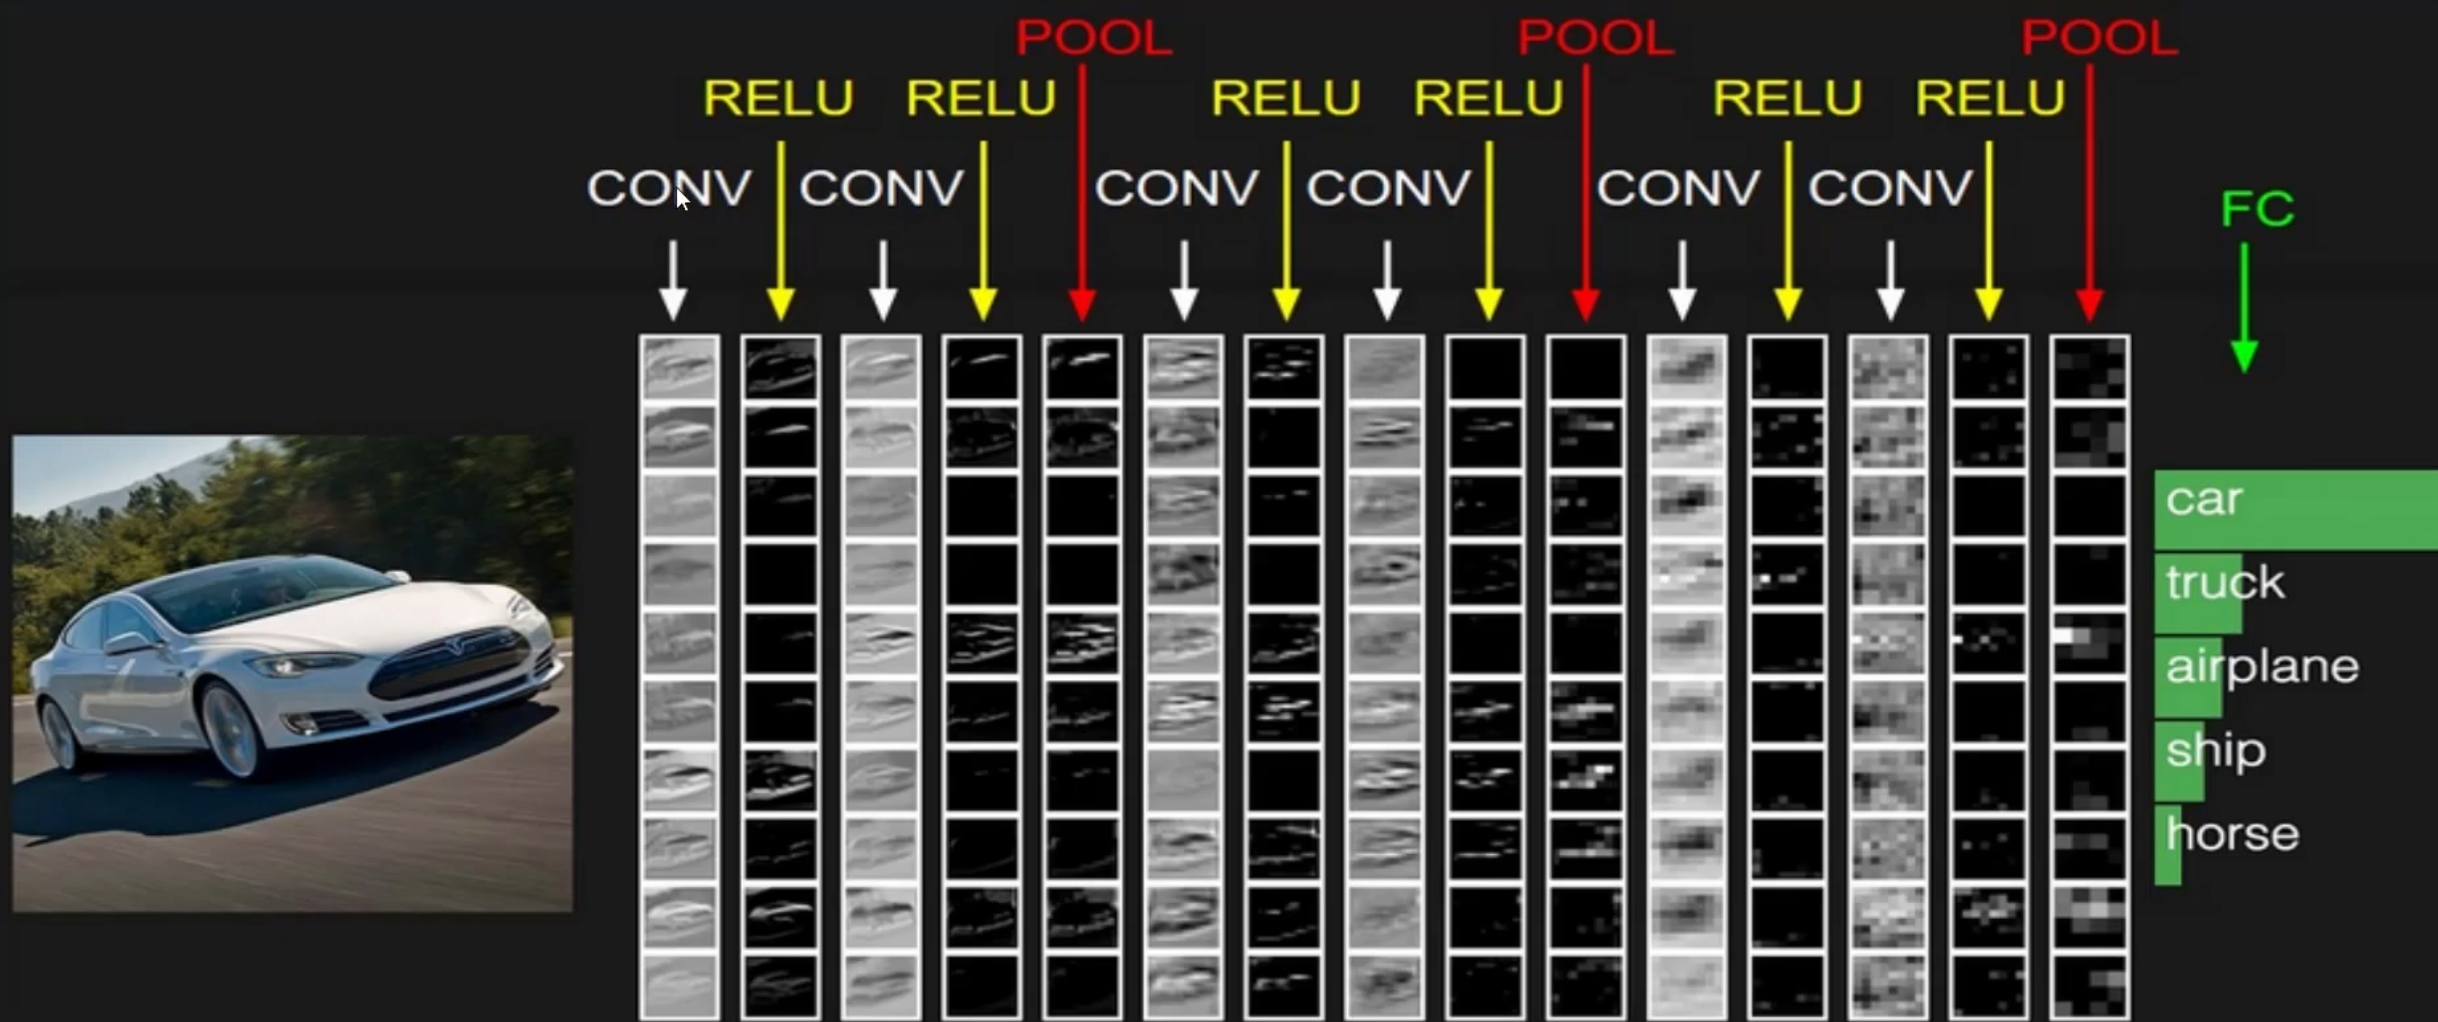
注意! 带参数计算的网络层才能被称为一层. 由于 RELU (激活函数) 和 POOL 层都没有数学计算, 所以不被计算在层数中. 所以上面的多层网络中, 只有 CONV 和 FC 层被计算层数. 这是一个七层网络.
1.5. 一些经典的卷积网络
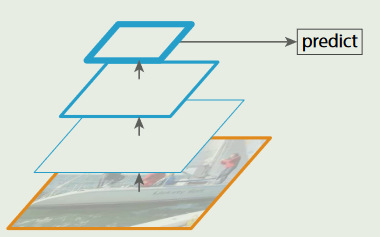
传统卷积网络结构大多为下图所示, 不断增加卷积提取更高层的特征.
-
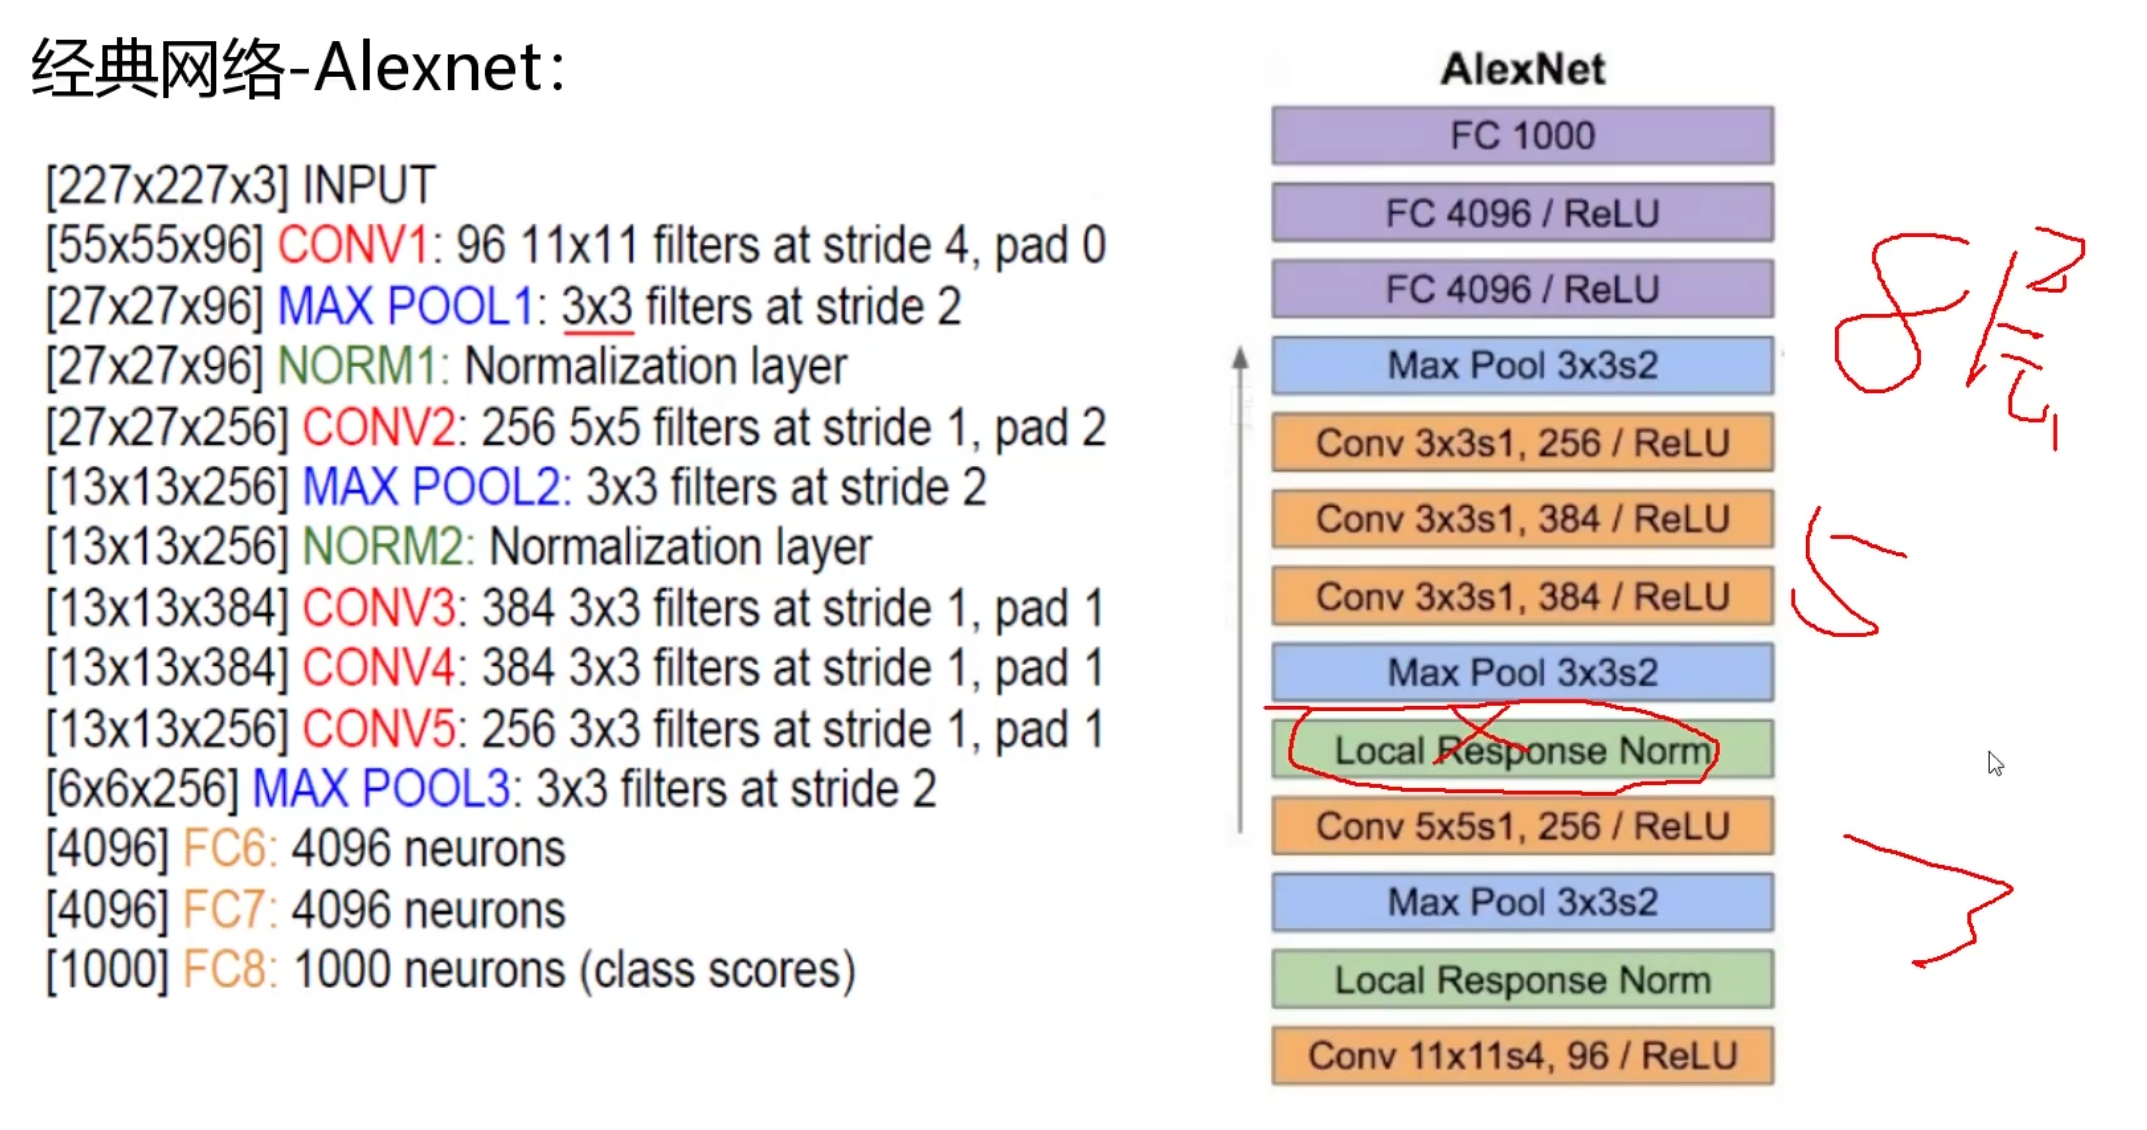
AlexNet (2012) 8层
- 存在很大的问题
- 开始使用 $11*11$ 的卷积核, 但尺寸太大影响性能
- 引入了局部标准化层, 但是作用不明显
- 存在很大的问题
-
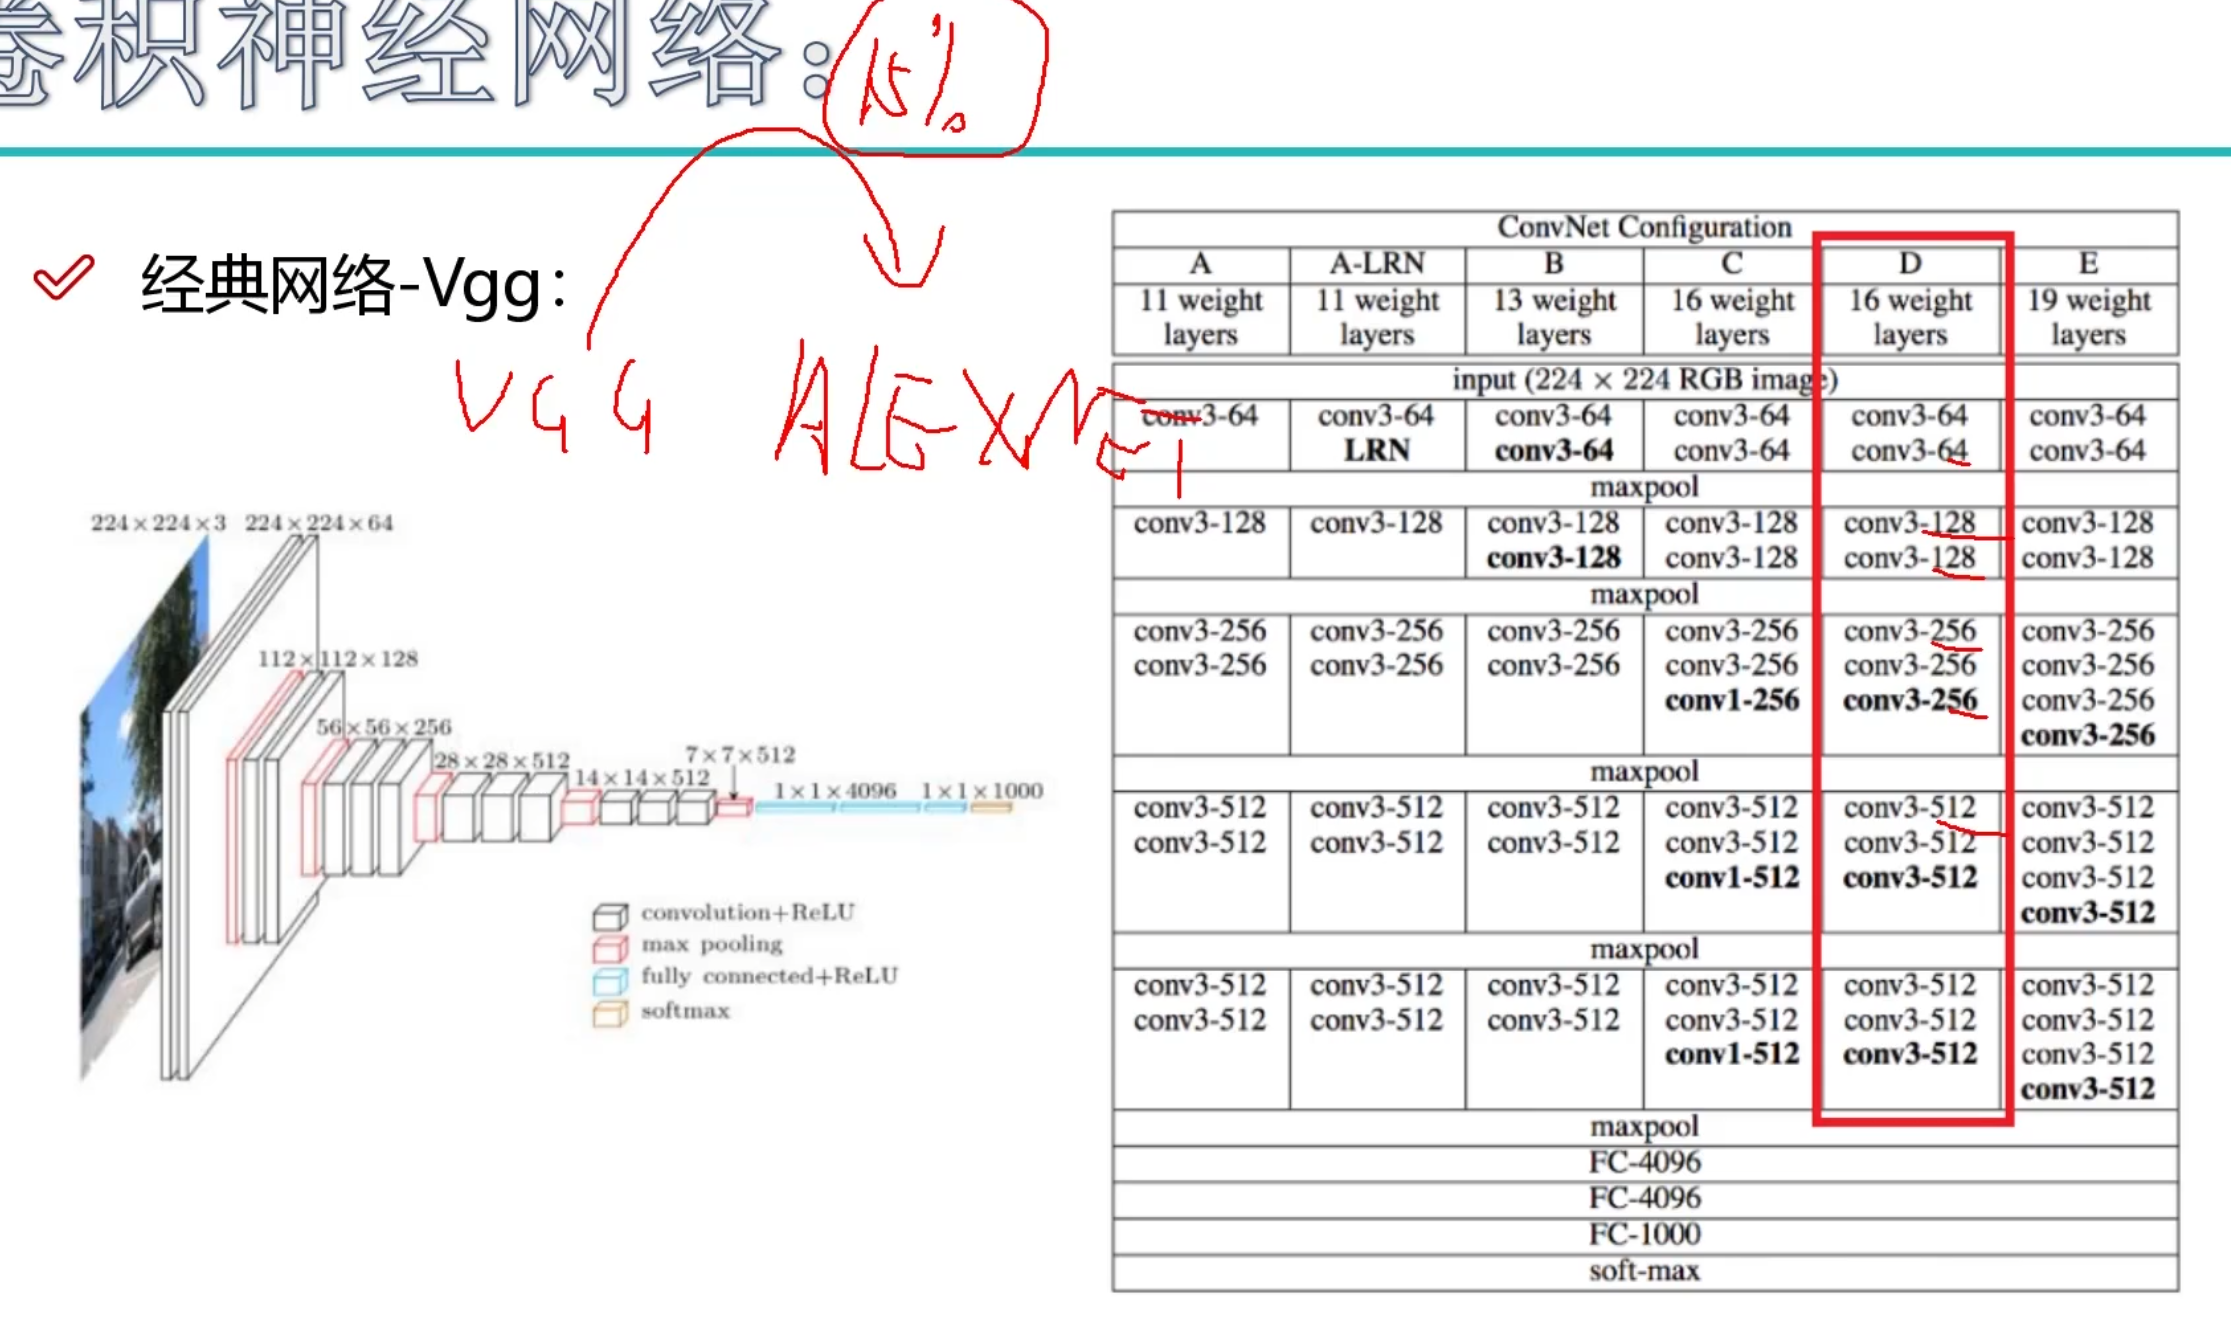
Vgg (2014) 16层
- 所有卷积尺寸全部使用 $3*3$
- 随着深度的加深, 增加卷积核获得更多的特征值个数, 来弥补损失的信息
- 但是由于网络参数变多, 性能变得更差
- 并且在网络深度超过 20 层后, 效果无法变得更好.
-
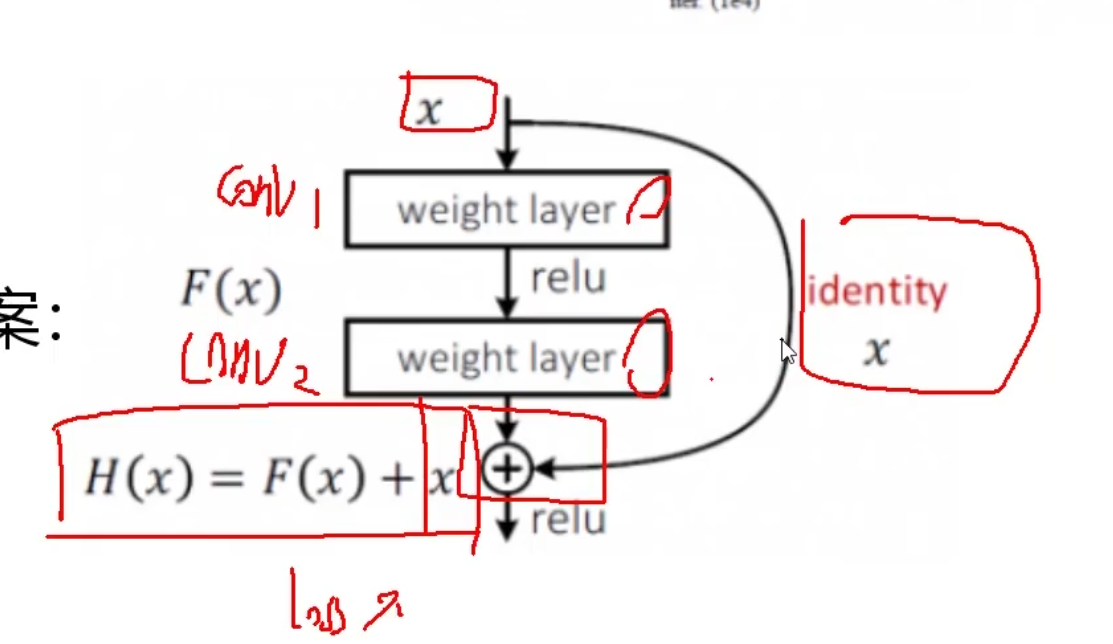
ResNet(2015) 常见层数: 18, 50, 101
- resnet 起到了一个类似于跳接的功能
- 如果 x 输入并经过卷积层之后, 将输出和输入结果相加. 如果发现 loss 上升, 就设置输出结果为 0, 这样就等于 x 直接通过.
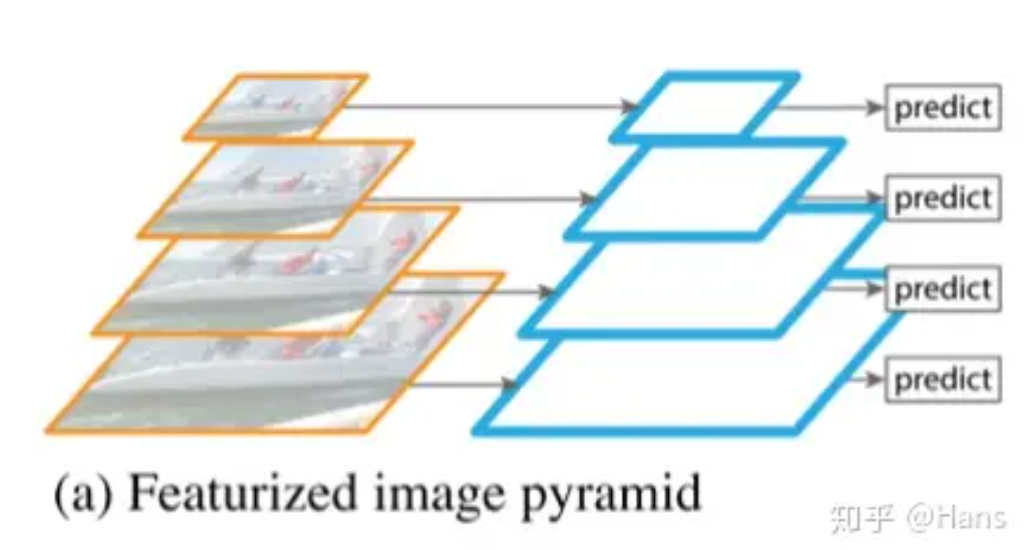
2. Featurized image pyramid 从图像金字塔提取特征
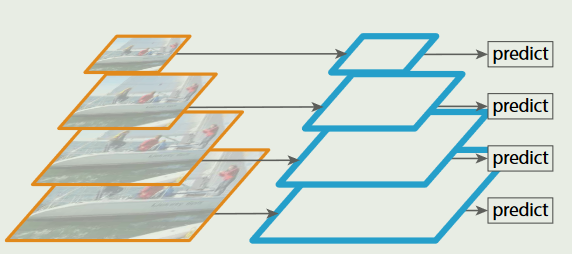
- 将图片 resize 成不同尺寸
- 对每个图片提取不同尺度的特征
- 对每个不同尺度的特征都进行单独预测
- 优点: 能够获得不同尺度下特征的语义信息
- 缺点: 性能消耗很大
3. Pyramid feature hierarchy 特征金字塔
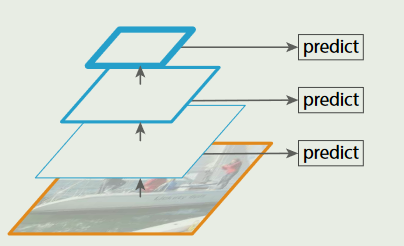
3.1. SSD (Single Shot MultiBox Detector) 算法 2015
解读SSD中的Default box(Prior Box) - stardsd - 博客园
-
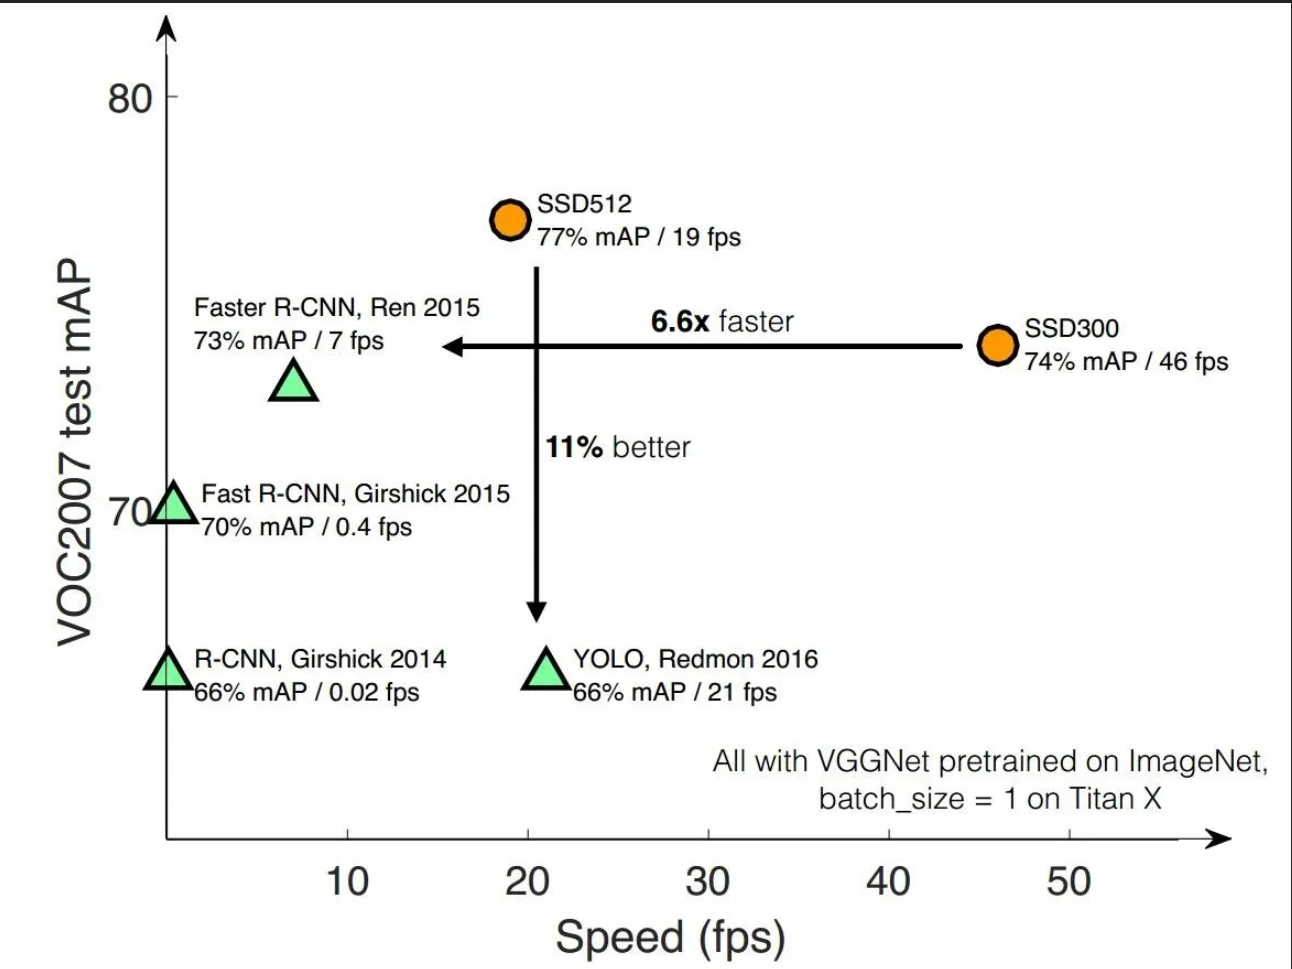
SSD (ECCD 2016) 性能远超 Faster RCNN (相同 mAP 下, 性能 7 倍)
-
AP是什么?
【精选】深度学习中的AP和mAP总结_balabalayou的博客-CSDN博客
-
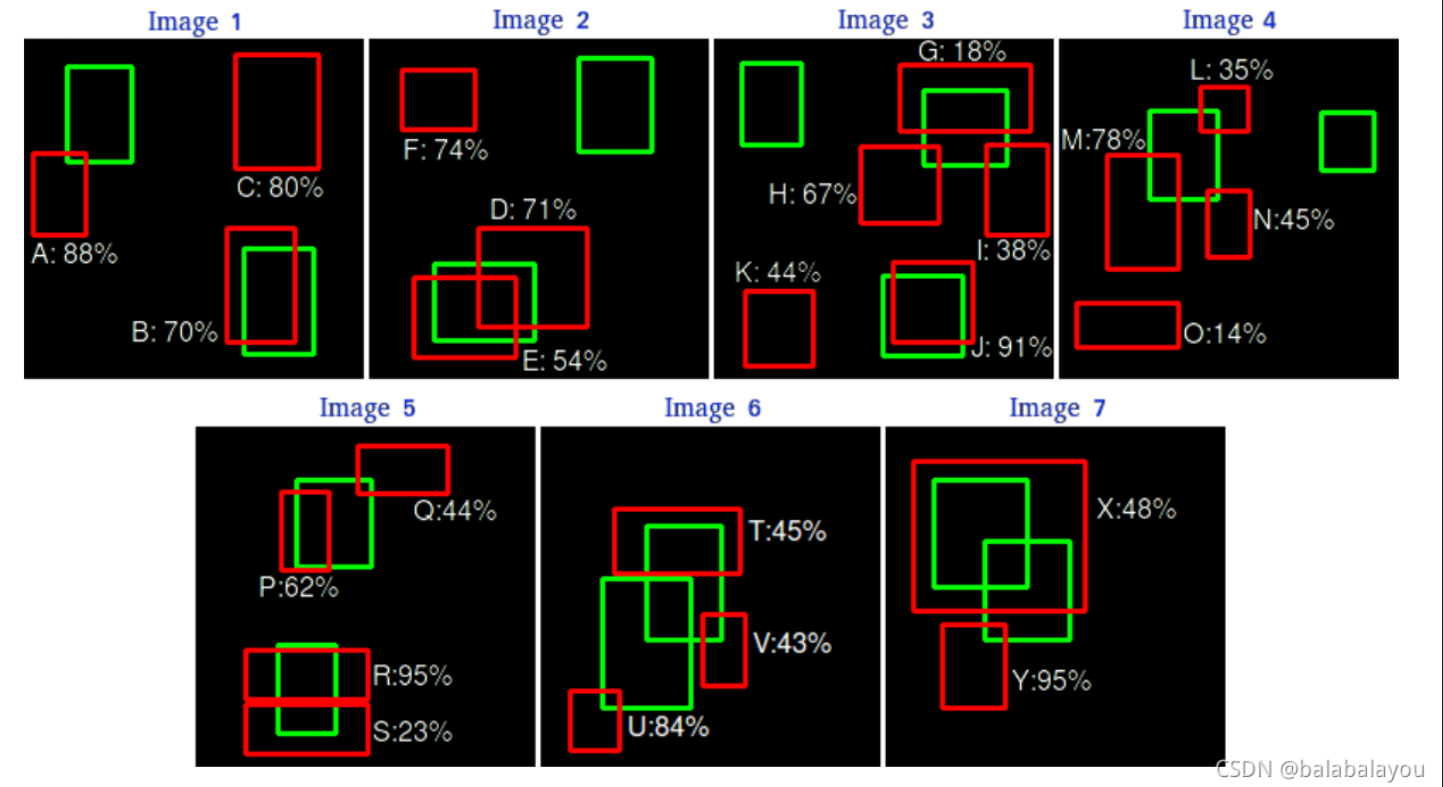
必要概念: IoU, 精度 (预测为 1 判断正确 / 所有预测为 1 (Positive) 的数量) 和召回 (预测为 1 判断正确 / 所有判断正确 (True) 的数量)
预测 GT 判断 TP 1 1 正确 FP 1 0 错误 FN 0 1 错误 TN 0 0 正确 -
根据模型推理可得检测框和置信度, 计算它们和标注框的IoU
-
使用 IoU 和事先设置的阈值对比, 获得检测框是预测正确还是预测错误 (TP or FP).
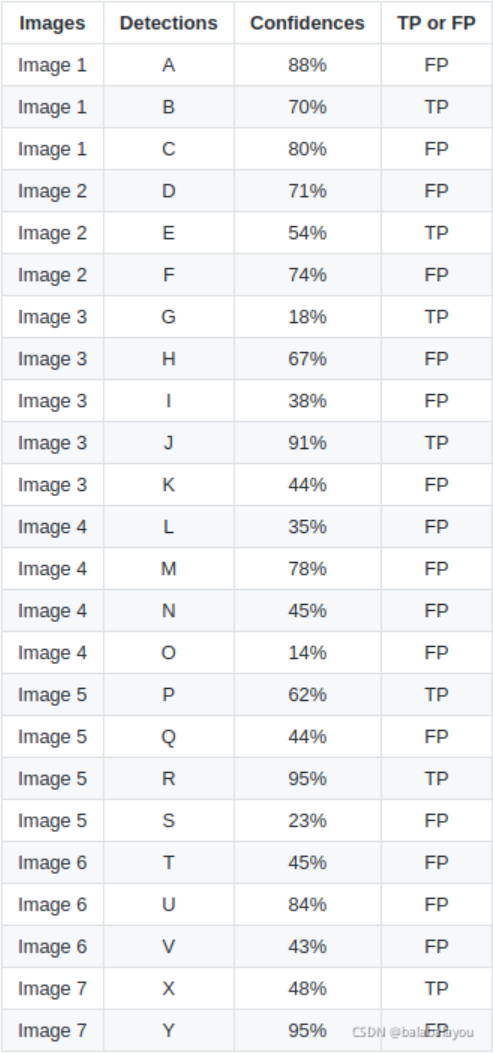
-
按照检测框的置信度从大到小排列, 从第一行开始计算 Precision (累积 TP / 累积预测框数) 和 Recall (累积 TP / 总 GT 框数).
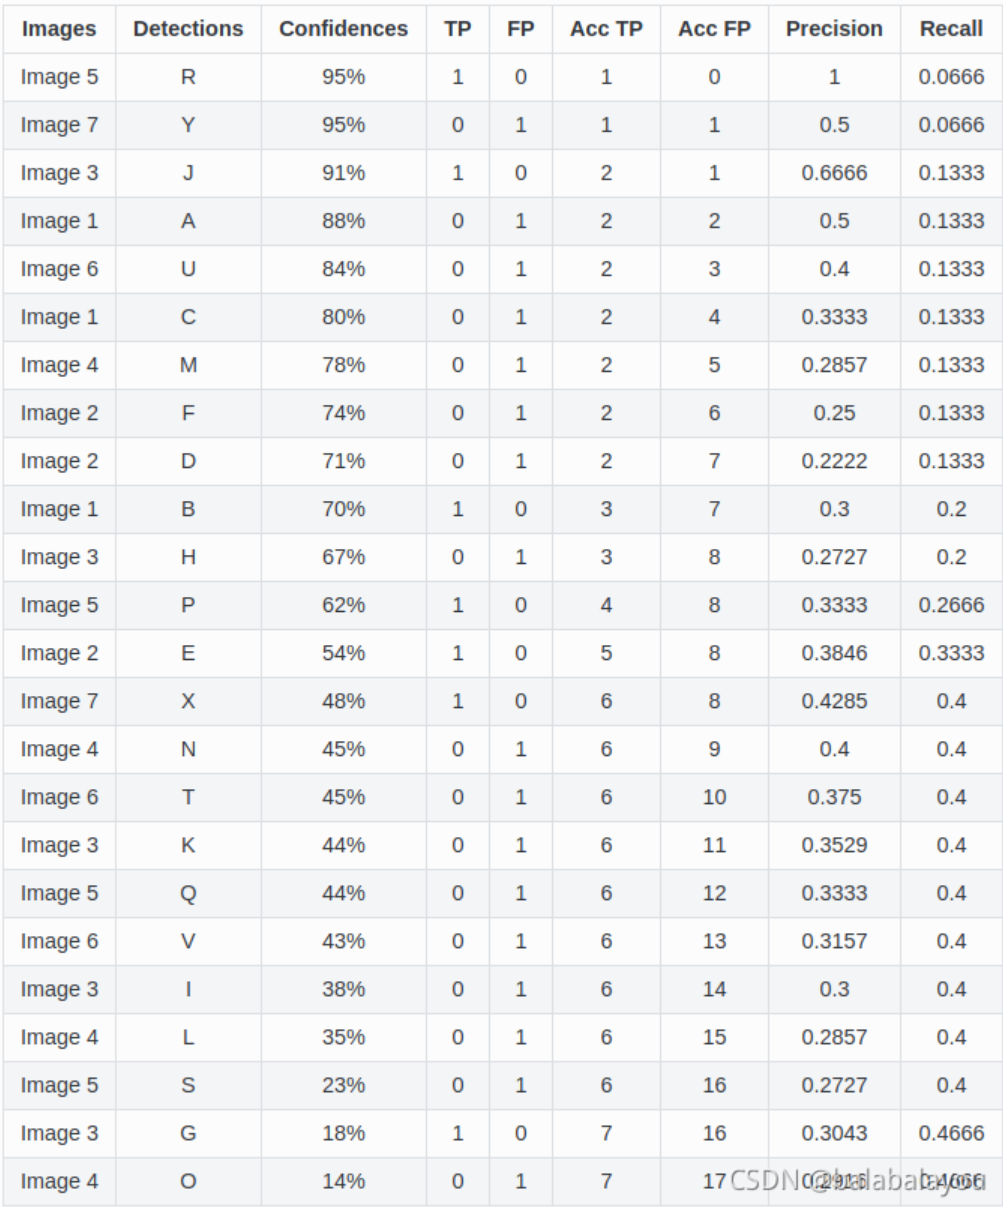
-
画出 PR 图
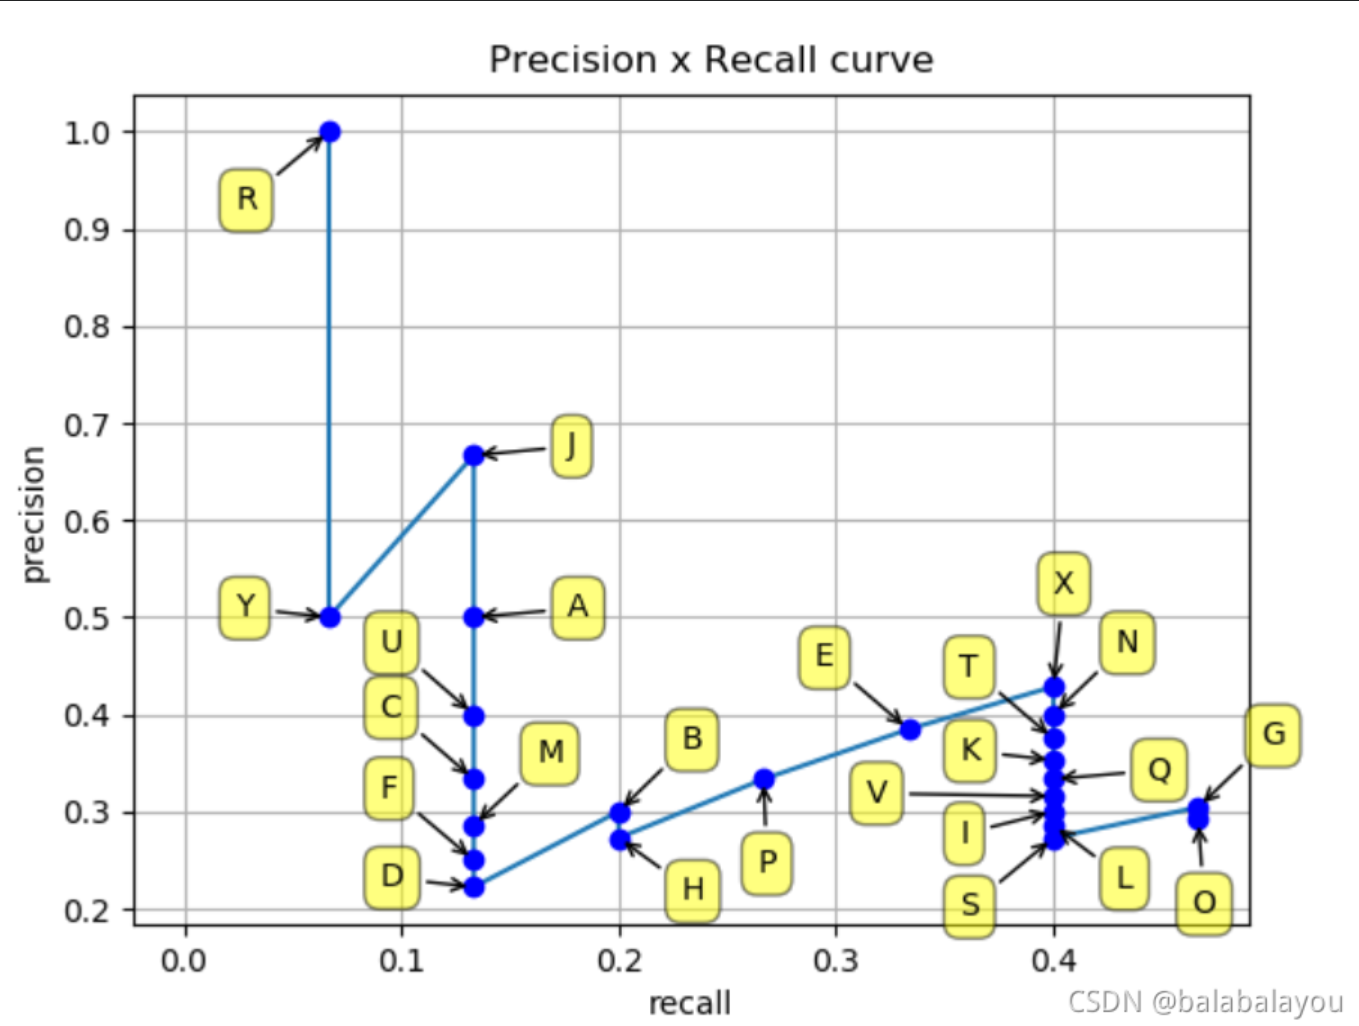
-
所有点插值法 (interpolation performed in all points), 从右向左画平行线获得多个长方体, 计算面积和就是 AP
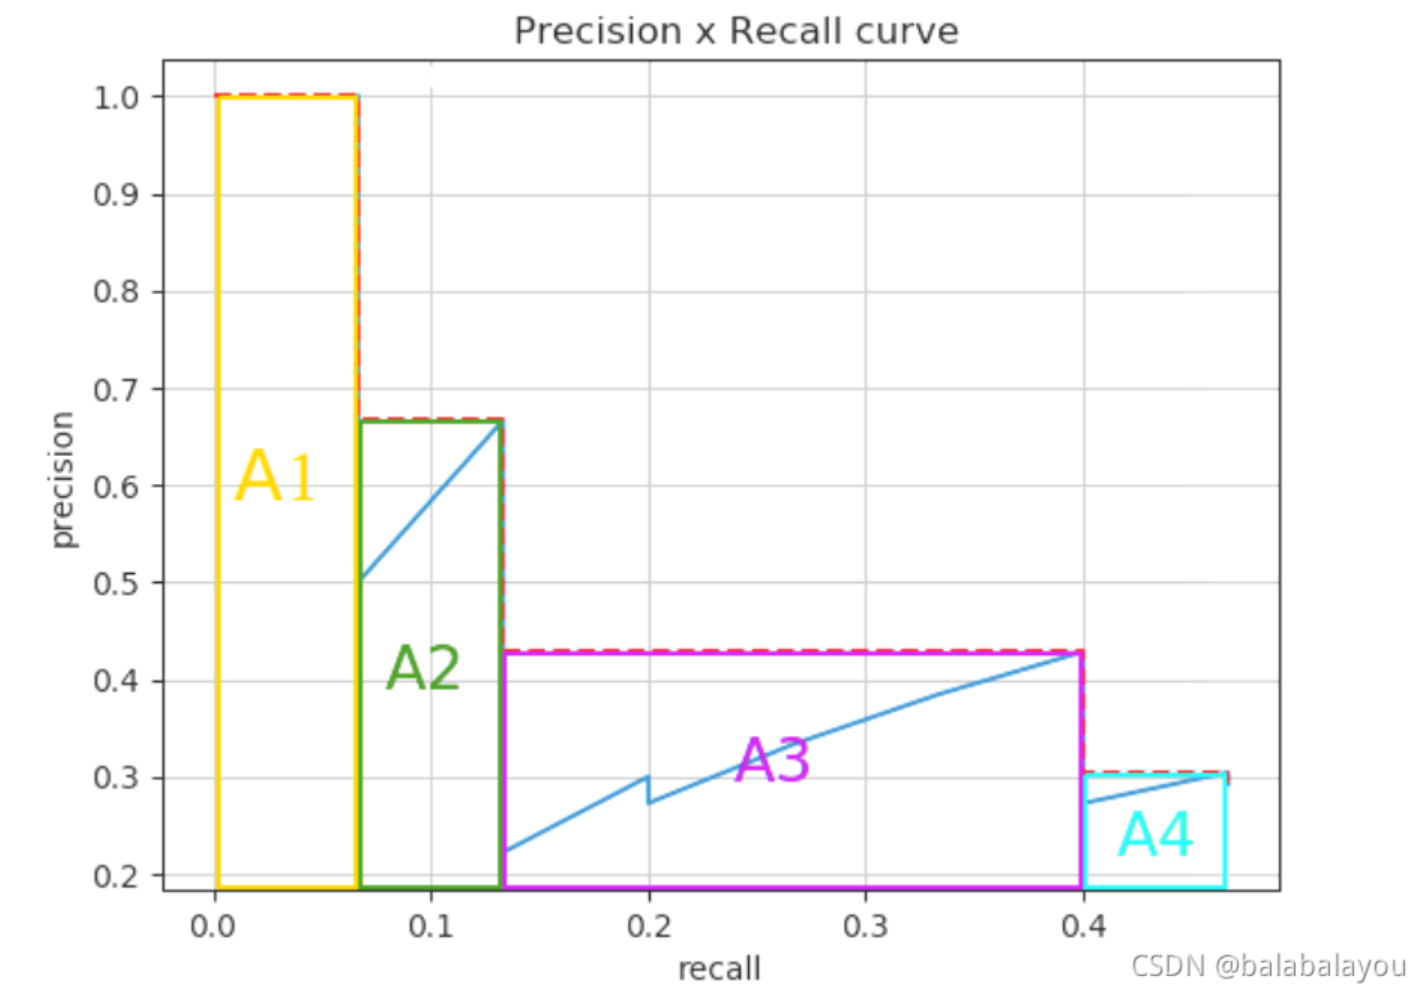
-
其实就是召回对精度的积分
$$ \mathrm{AP}=\int_0^1 p(r) d r $$
-
- 实际代码中的计算可以先从上向下, 从左向右找峰值点 (最高的点), 到最后一个点停止. 之后计算 每个峰值点到前一个峰值点的距离 ($\Delta R$) * 峰值点的高度 ($P$), 最后求和就是 $AP$.
-
-
mAP是什么?
AP的平均值(mAP, mean average presicion): 在信息检索中, AP指的是不同召回率上的正确率的平均值, 而现在的有些检索系统为了能够快速返回结果, 在计算AP时就不再考虑召回率. 假设数据库中有5条信息与查询信息相关, 并分别出现在查询结果中的第1, 3, 6, 9, 10位, 那么这次查询的AP就是: $AP=(1/1+2/3+3/6+4/9+5/10)/5=0.62$, 得到多条查询的AP值, 对其进行平均, 就得到了mAP.
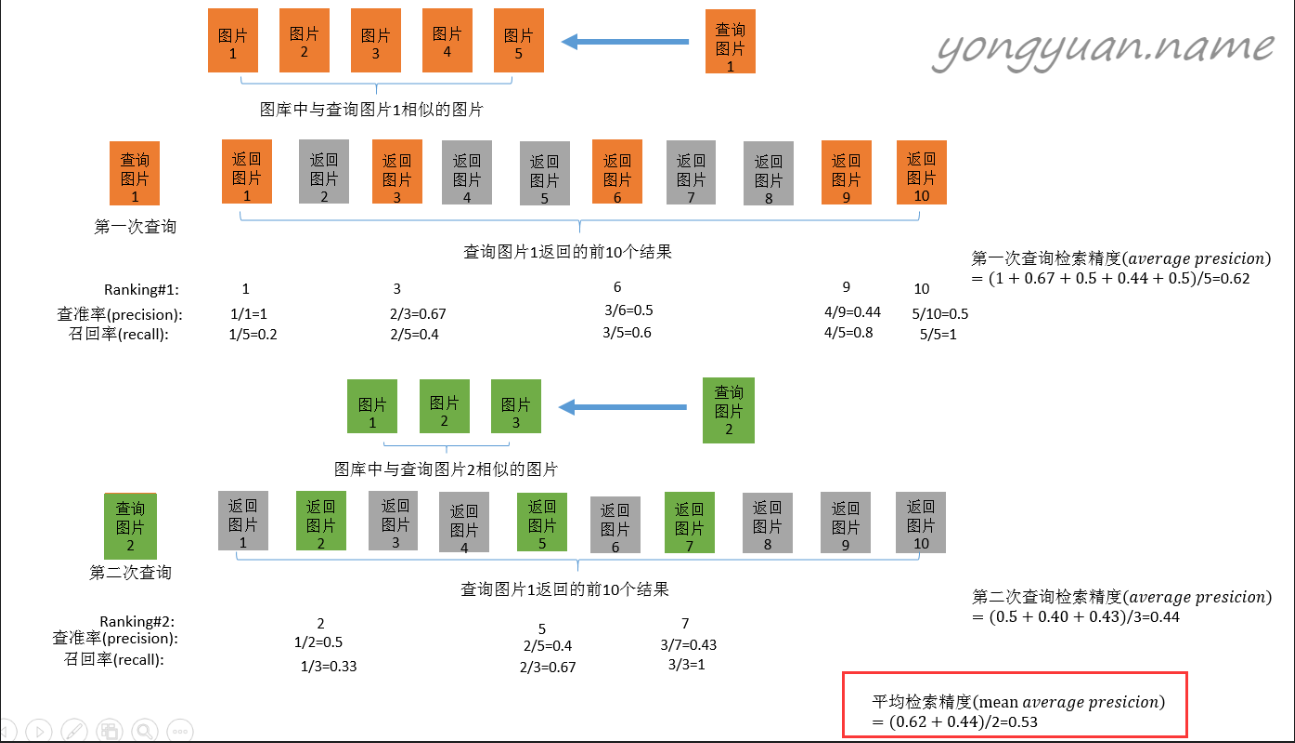
- 图像检测任务中, 简单来说就是获得每个类别的AP后求平均.
-
-
特点
- 从 YOLO 中继承了将 Detection 转化为 Regression 的思路, 一次完成目标定位与分类.
- 基于 Faster RCNN 中的 Anchor, 提出了与之相似的 Prior box.
-
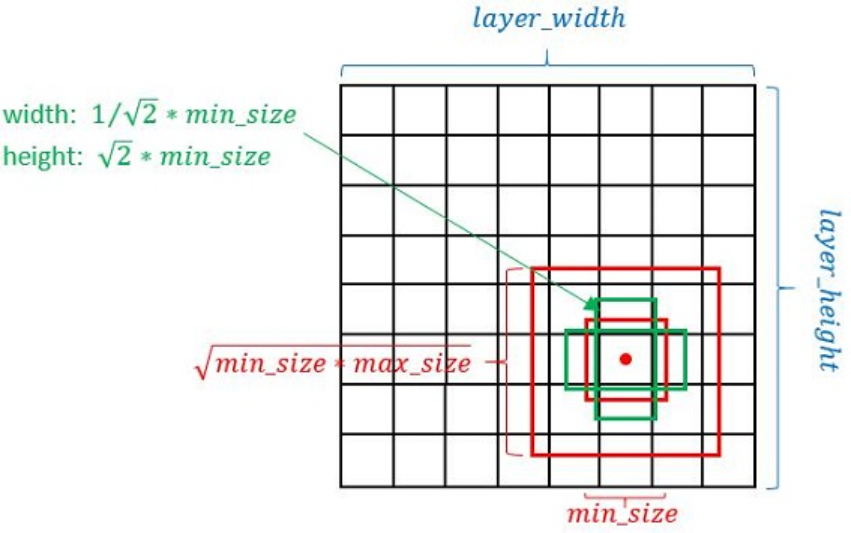
SSD 按照如下规则生成 Prior box
- 以特征图上每个点的中点为中心, 生成一些列同心的 Prior box
- 正方形 Prior box 的最小边长为: $\text{min size}$, 最大边长为: $\sqrt{\text{min size}*\text{max size}}$
- 设置不同的纵横比 (aspect ratio) 可以分别生成 2 个长方形框: 长宽分别为: $\text{min size}*\sqrt{\text{aspect ratio}}$ 和 $\frac{\text{min size}}{\sqrt{\text{aspect ratio}}}$
-
每个特征图对应的 Prior box 的 min size 和 max size 由以下公式决定, m 是使用特征图的数量 (eg: SSD 300 中的 m 为 6)
$$ s_k=s_{\min }+\frac{s_{\max }-s_{\min }}{m-1}(k-1), \quad k \in[1, m] $$
-
SSD 加入基于特征金字塔的检测方式,即在不同感受野 (即尺度, 尺寸) 的 Feature map 上预测目标. 具体来讲, SSD 的突出贡献是: 使用低层 Feature map 检测小目标,使用高层 Feature map 检测大目标.
-
训练时的样本标记, 正负样本比例为 1:3 (经验值)
- 正样本: 与 GT 重合度高的 boxes, 其输出对应分类设为对应物体; 物体 GT 框与 Anchor 的 IOU 大于 0.5
- 负样本: 其他所有样本
-
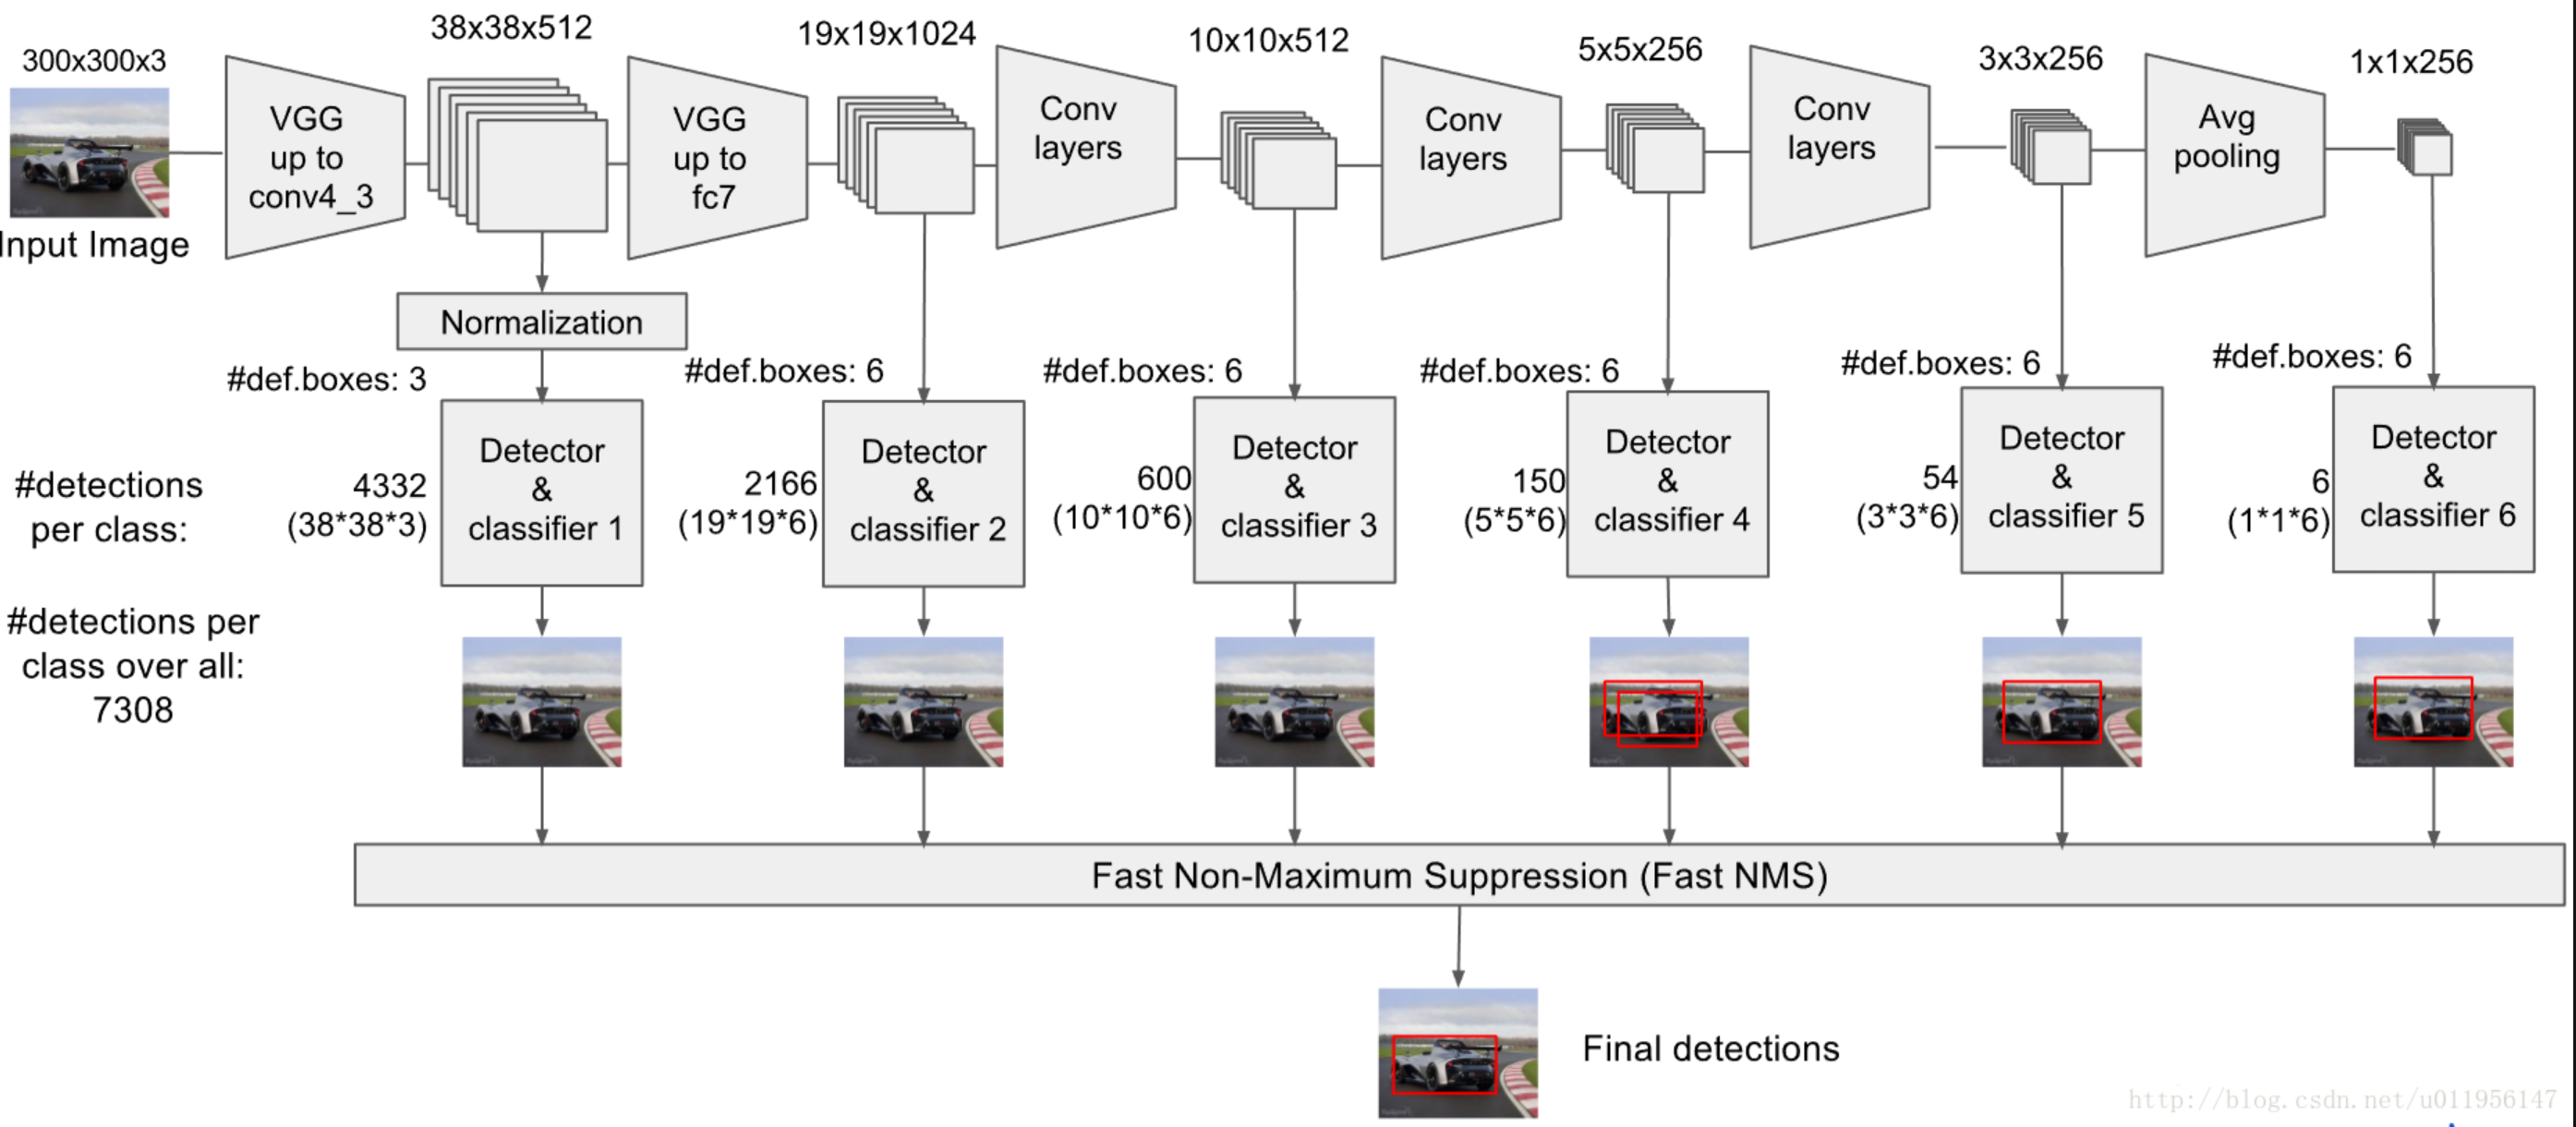
SSD 模型图和精度效率图
-
SSD 输入尺寸 $300*300$
-
SSD 输出的矩阵结构是 4 个偏移 (shape offsets) + 21 个类别置信度 (20 个类别+ 1 个背景类别)
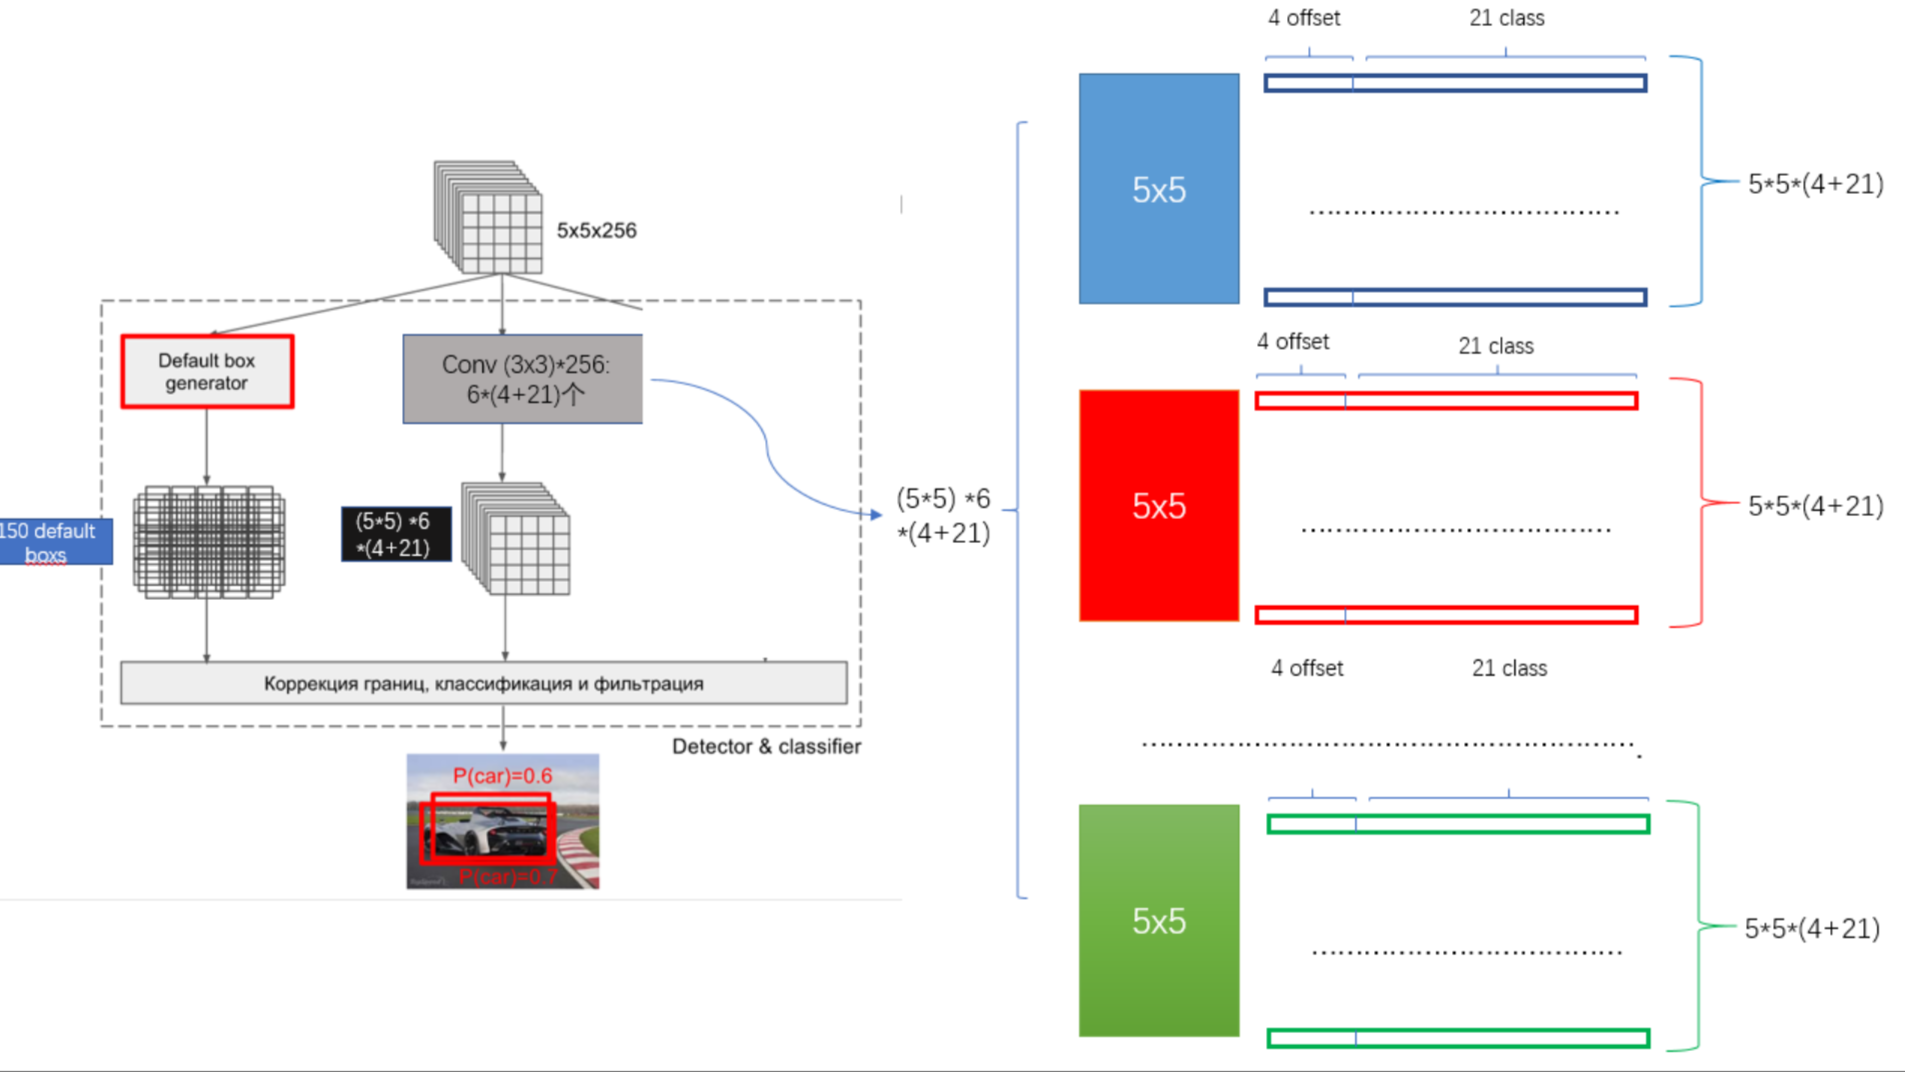
-
SSD 的损失函数
- 位置回归 default box: Softmax Loss (Faster R-CNN 是 log loss)
- 目标类别分类 score 置信度: Smooth L1 loss (同 Faster R-CNN)
-
优点
- 性能媲美 YOLO
- 检测精度媲美 Faster RCNN
-
缺点
- 需要手动设置 prior box 的 min_size, max_size 和 aspect_ratio 值. 网络中 prior box 的基础大小和形状不能直接通过学习获得, 而是需要手工设置. 而网络中每一层 feature 使用的 prior box 大小和形状恰好都不一样, 导致调试过程非常依赖经验
- 虽然采用了特征金字塔 (Pyramdial feature hierarchy) 的思路, 但是对小目标的 Recall 依然一般, 并没有达到碾压 Faster RCNN 的级别. 作者认为, 这是由于 SSD 使用 conv4_3 低级 feature 去检测小目标, 而低级特征卷积层数少, 存在特征提取不充分的问题
3.2. 特征金字塔网络 Feature Pyramid Network (FPN) 2017
【目标检测】FPN(Feature Pyramid Network)
-
FPN 增强的是语义的特征. 之后 YOLOv4 的 PAN 结构更近一步, 在 FPN 后加了金字塔结构, 即增强语义特征又增强位置特征.
-
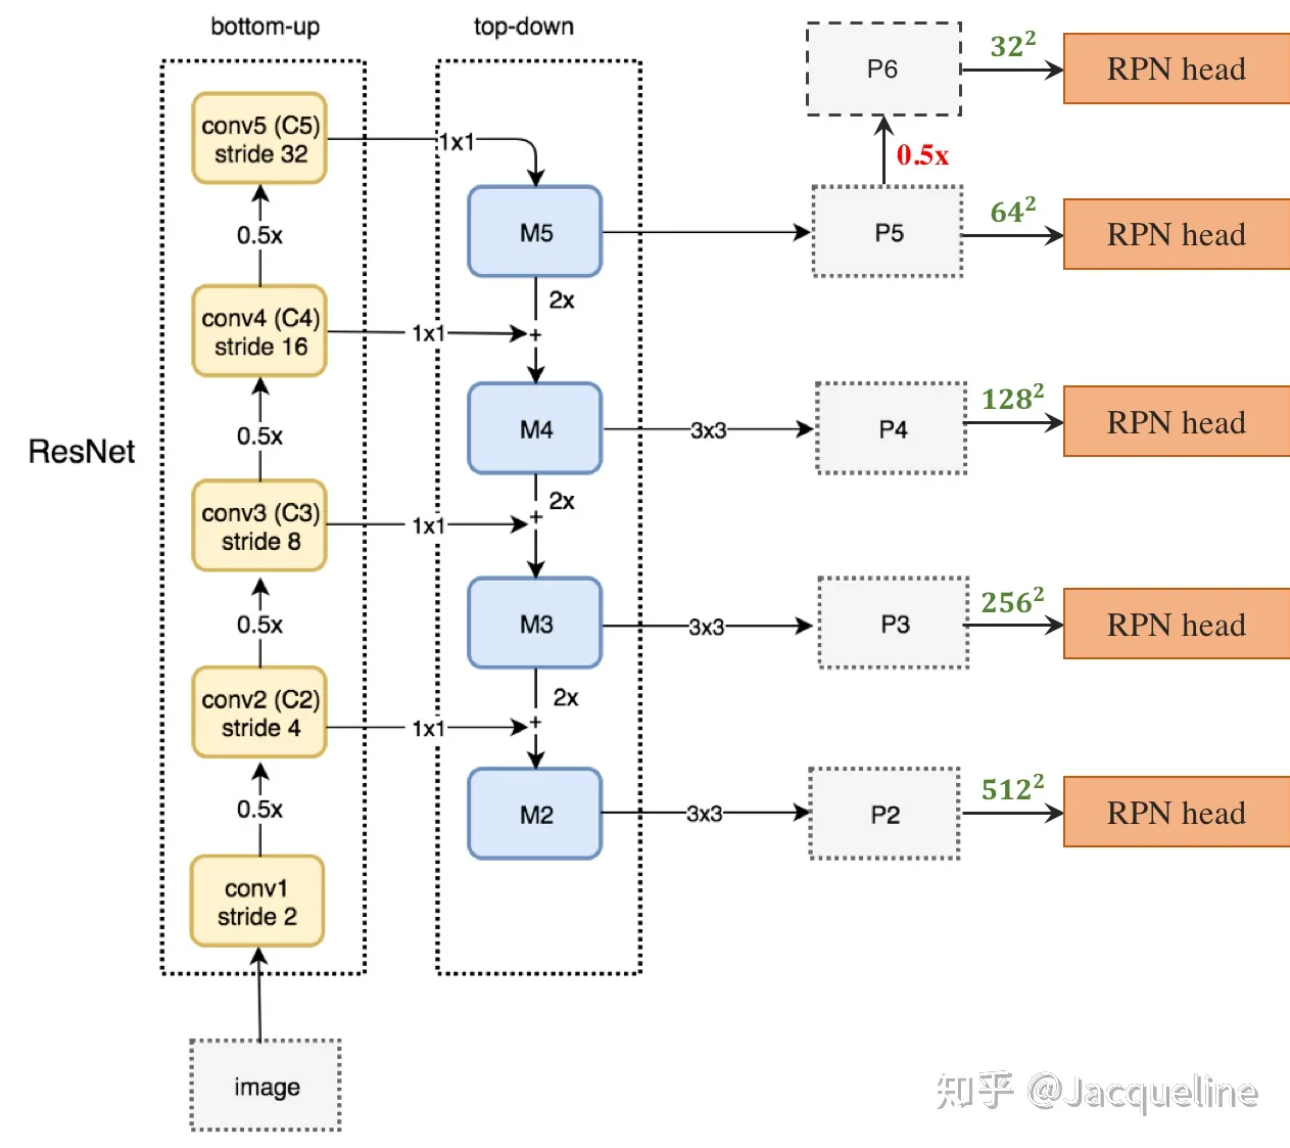
FPN 是一种自顶向下路径和横向连接将低分辨率, 语义强的特性与高分辨率, 语义弱的特性结合起来的体系结构.
- FPN 借鉴了 ResNet 的跳接操作, 用于结合底层特征和高层特征.
- 借鉴了 SSD 的检测策略, 在不同分辨率的特征图上分别作预测.
-
FPN可以分三部分:
- 自底向上
- 每向上一级用 step=2 做降采样 (Down sampling) (输出 size 相同的网络部分被称为一级)
- FPN 用 2 到 5 级参与预测 ( 1 级语义信息太低被抛弃)
- 自顶向下
-
每向下一级做上采样 (Up sampling)
-
上采样的方法简单的有最近邻插值, 也可以使用其他的线性插值方法
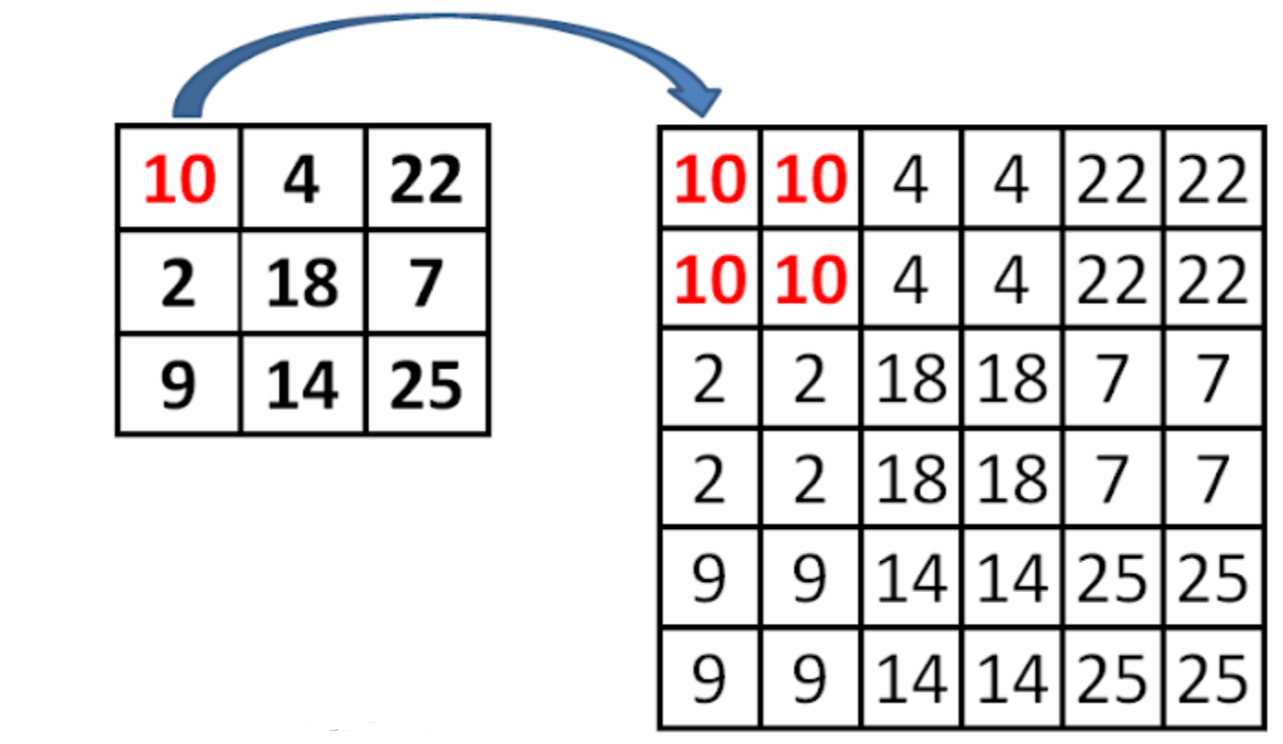
-
-
加上自底向上的低分辨率高语义特征跳接用于预测
-
- 连接两部分的跳接
- 自底向上
-
跳接时前后维度不一致的问题?
- 使用 1*1 的卷积层进行升降维
-
通过跳接融合之后, 还要通过一个 3*3 的卷积层.
- 用于减轻最近邻插值带来的影响. (因为周围的数字都比较接近, 会出现重叠效应 (Aliasing effect), 灰度不连续, 在灰度变化的地方可能出现明显的锯齿)
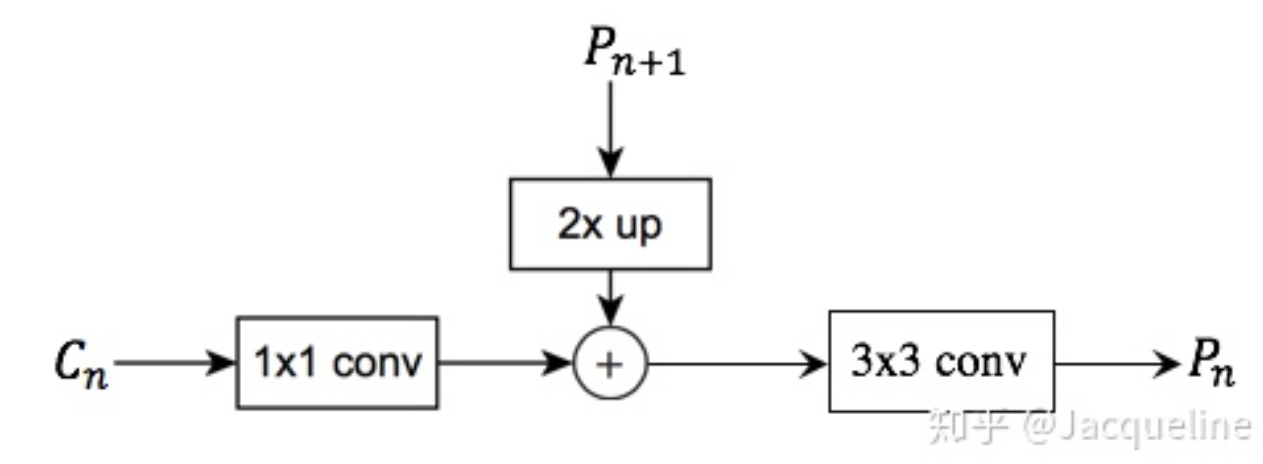
-
简单理解: 漏斗, 底部 → 高分辨率 (特征信息少, 但是能精准定位物体); 顶部 → 低分辨率 (特征信息多, 但是不能定位物体).
- 如下图, 上面的图是其他的跳接特征融合, 下面是 FPN.
- FPN 结合了图像金字塔结构 + SSD 的优点, 能够检测到多尺度的物体.
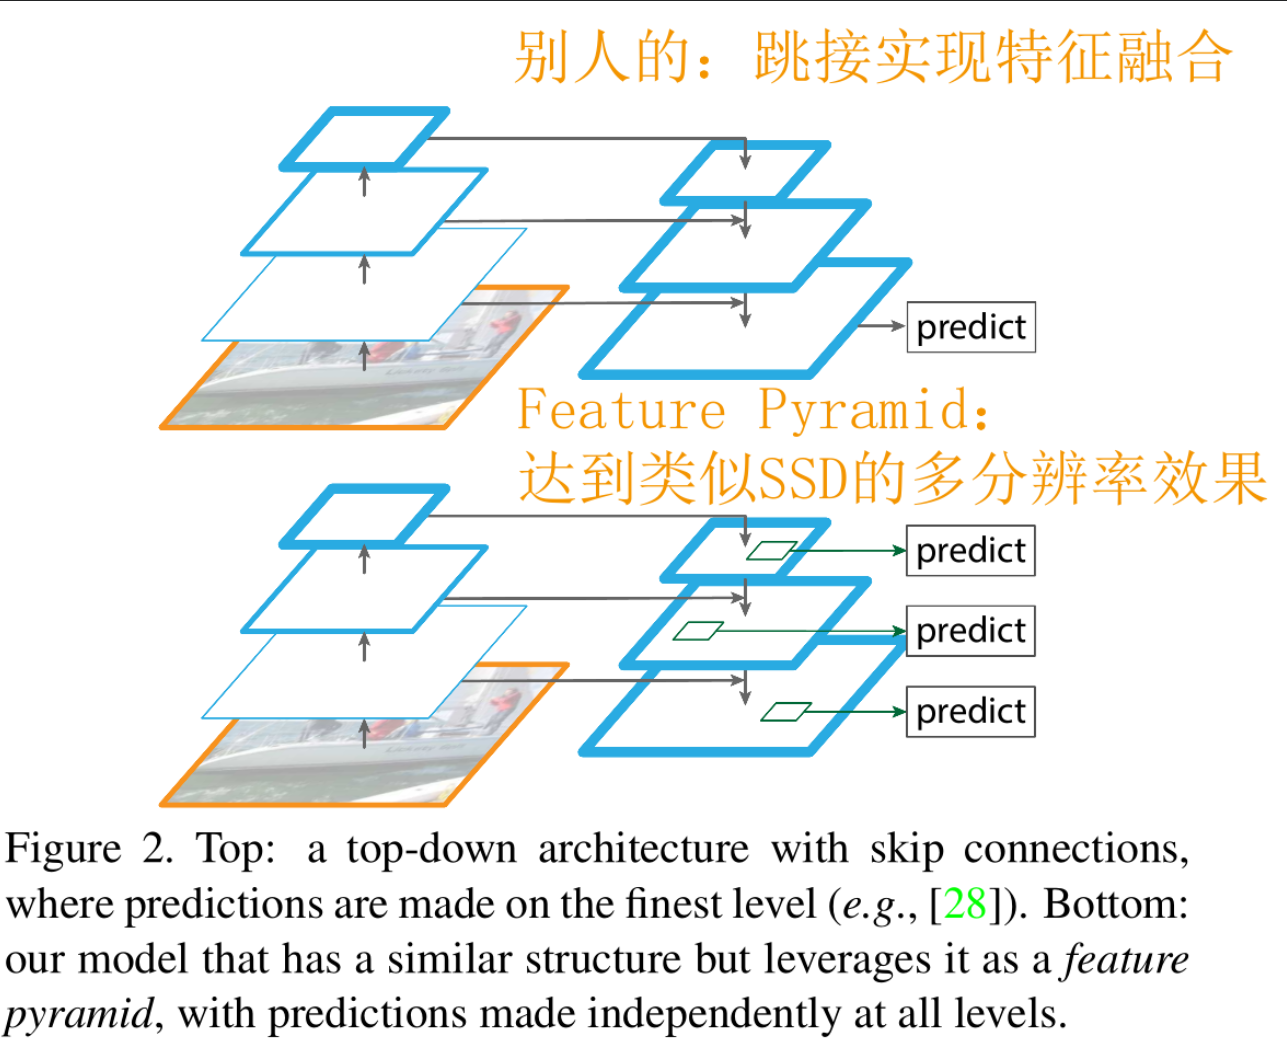
-
FPN 跳接融合低语义信息高分辨率特征图和高语义信息低分辨率特征图, 最后融合全部特征去预测结果.
这部分的几级被称为 $\left\{P_2, P_3, P_4, P_5, P_6\right\}$. 其中 $2 \sim 5$ 分别对应 $C$ 的 $2 \sim 5$, $P_6$ 是 $P_5$ 降采样得到的. 这用于检测的五个特征图的分辨率分别为: $\left\{32^2, 64^2, 128^2, 256^2, 512^2\right\}$.
-
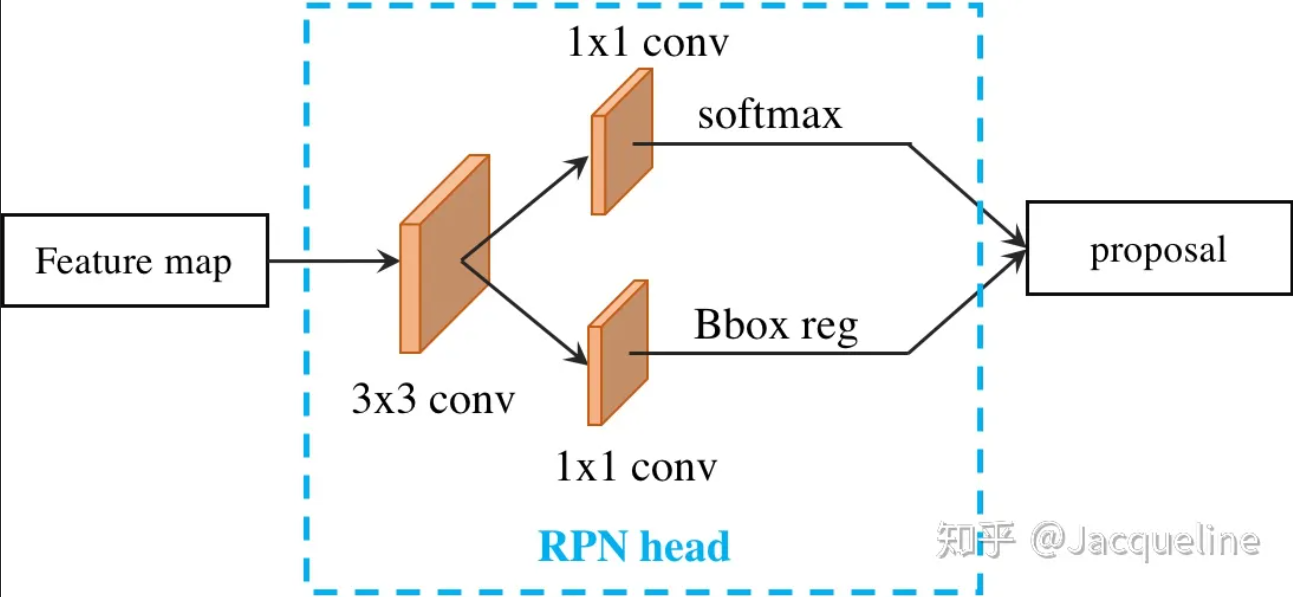
下面的图是 Faster R-CNN 中的 RPN 网络结构, 特征融合结构可以放在前面, 用于更好的输出 Feature map.
-
-
图像金字塔结构能够预测各尺度特征图, 能获得不同尺度的信息, 但性能消耗大.
-
SSD 结构是传统 CNN 结构, 但是各尺度特征图都进行了预测. 但是由于 SSD 没有做高低分辨率特征图跳接, 所以没有使用底层特征做预测, 所以小目标检测困难.
-
MASK R-CNN 使用了 FPN 结构.
4. 感受野 (Receptive field)
-
定义: 感受野就是输入图像对这一层输出的神经元的影响有多大. 反过来说就是特征图上的某点能看到原始图像多大的区域.
-
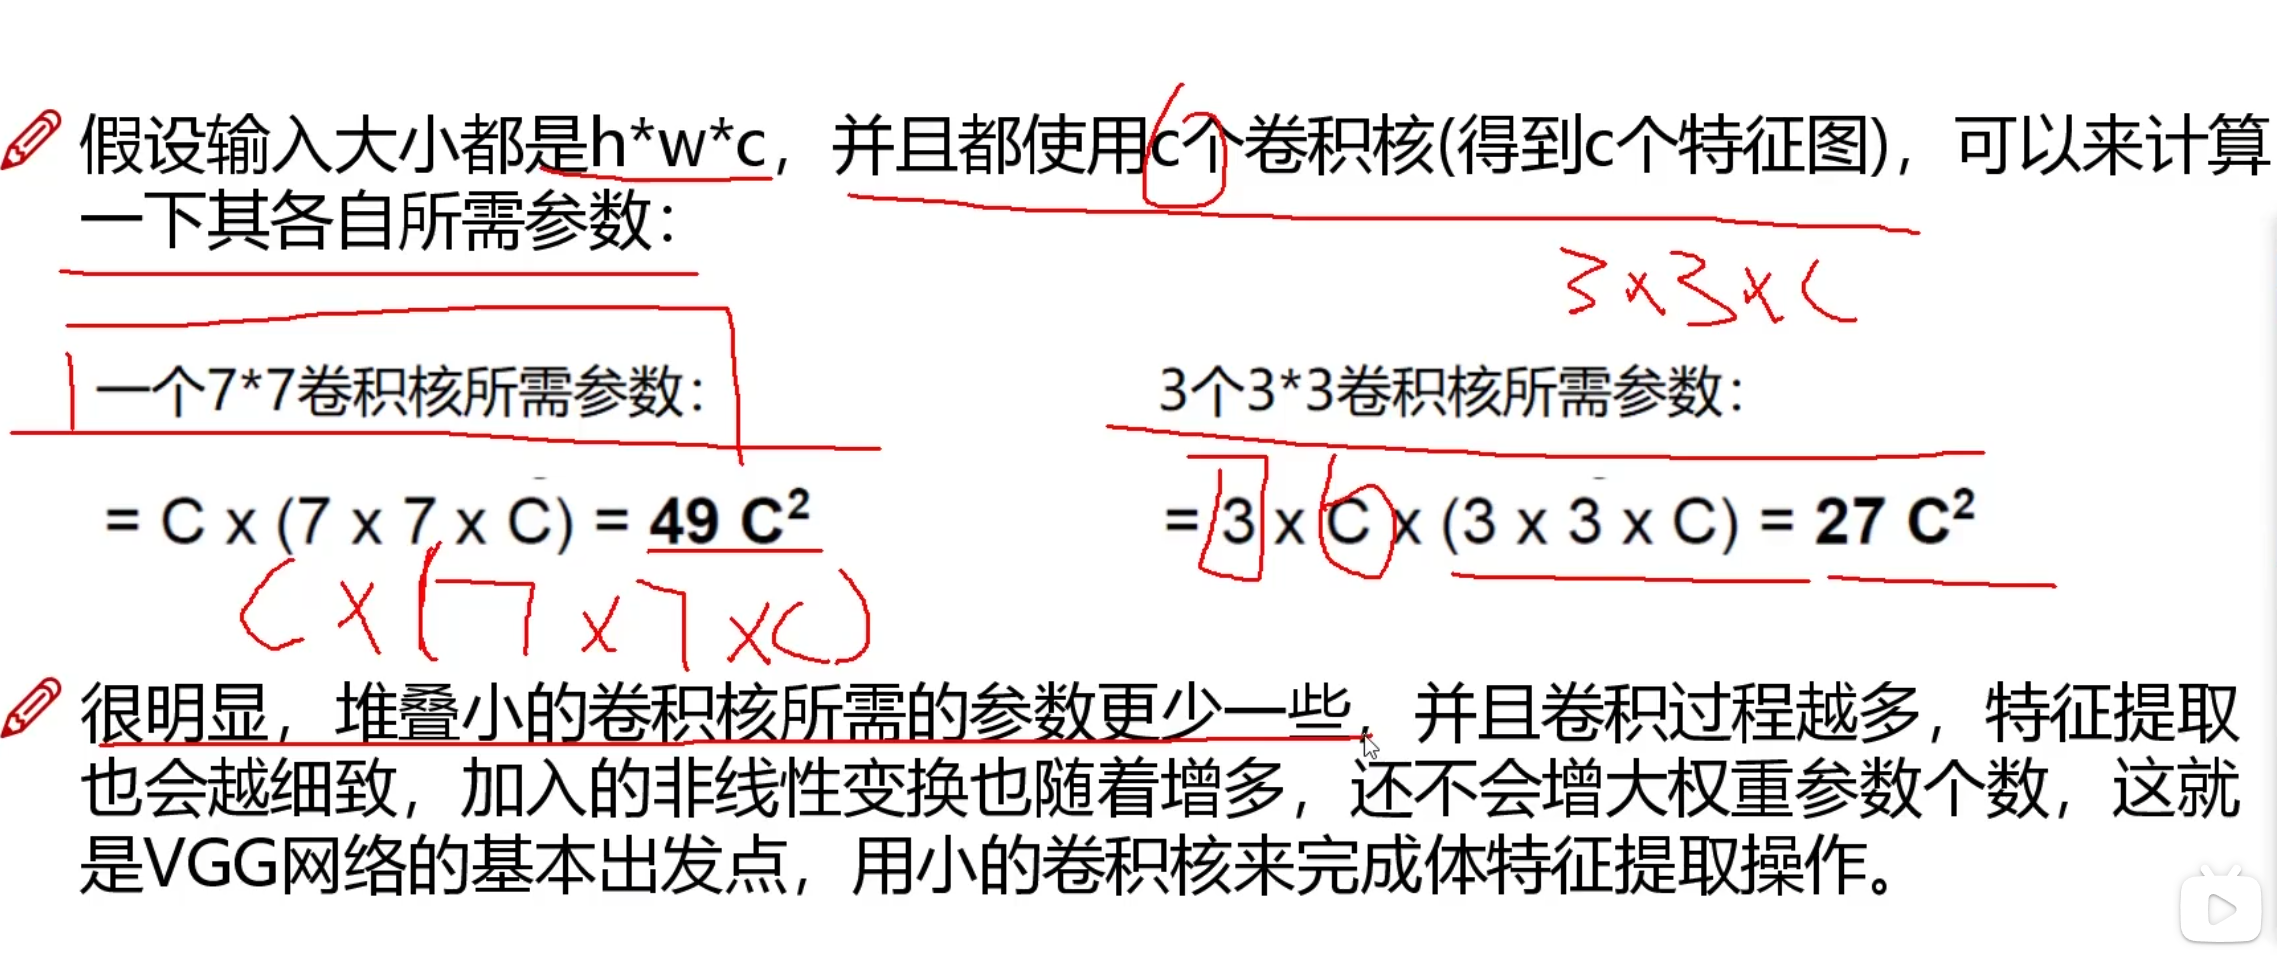
如果堆叠 3 个 33 的卷积核, 步长为1. 那么它的感受野就是 77. 这和 7*7 卷积核的结果是一样的, 那么为什么要堆叠 3 个小卷积呢?
- 为了增加性能. 3 个小卷积核的参数量更小.
- 卷积过程越多, 特征提取更细致, 能加入的非线性变换 (如 RELU) 和 归一化层 (Batch normalization) 也越多.
这就是为什么 VGG 网络都是用了小的卷积核.
5. 常见的目标检测算法
基于深度学的目标检测方法一之基本思想概念_hh_2018的博客-CSDN博客
基于深度学的目标检测方法二之基于候选框的方法_hh_2018的博客-CSDN博客
基于深度学的目标检测方法三之基于回归的方法_基于回归的目标检测_hh_2018的博客-CSDN博客
一口气学完所有【目标检测算法RCNN/SSD/YOLO/SPPNet…】是什么体验?浙大计算机博士手把手带你学!—人工智能/计算机视觉/深度学习_哔哩哔哩_bilibili
MXNet/Gluon 深度学习笔记 (六) —— 物体检测总结
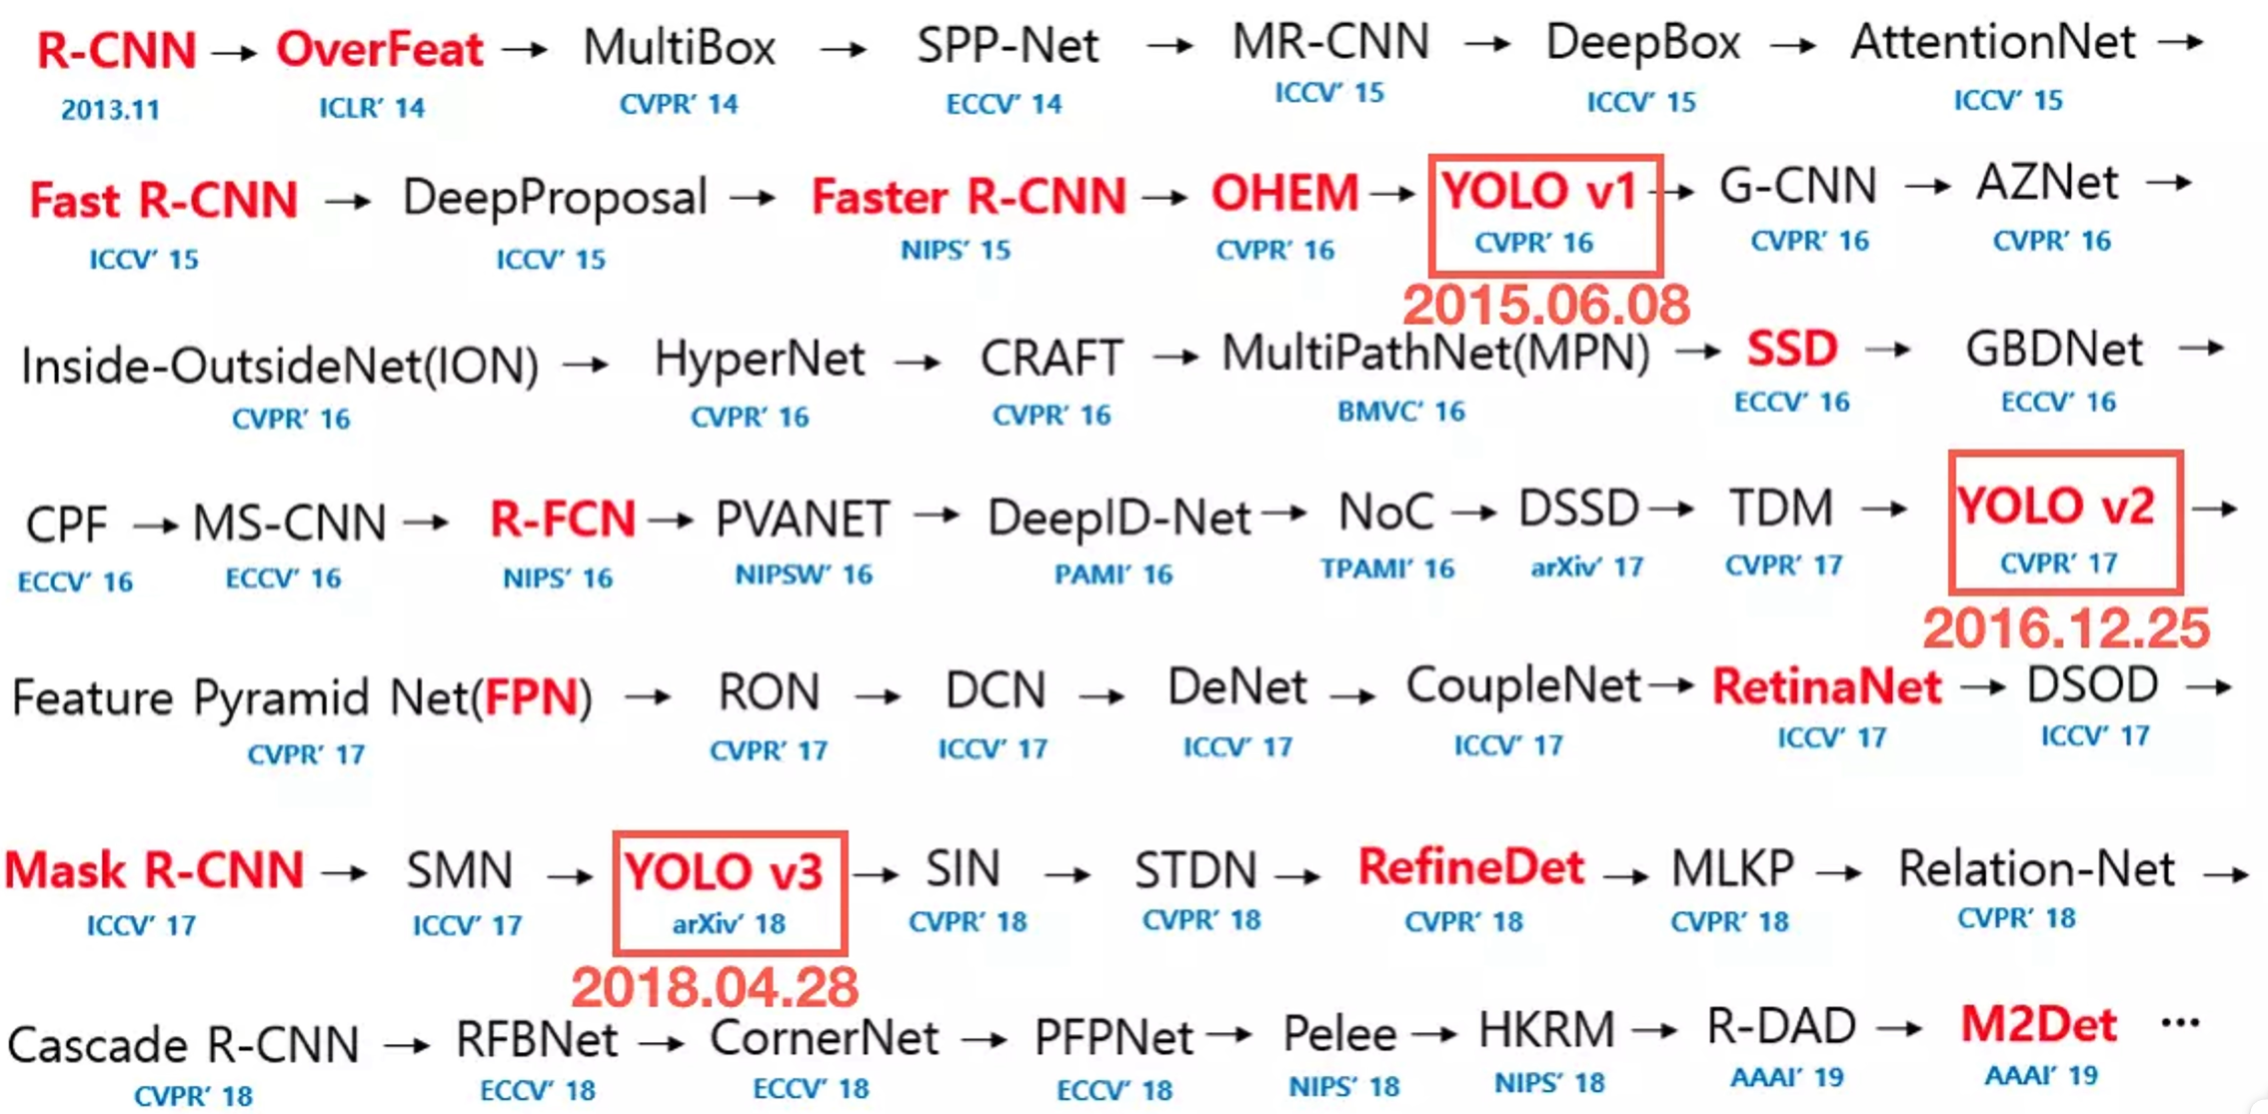
5.1. R-CNN
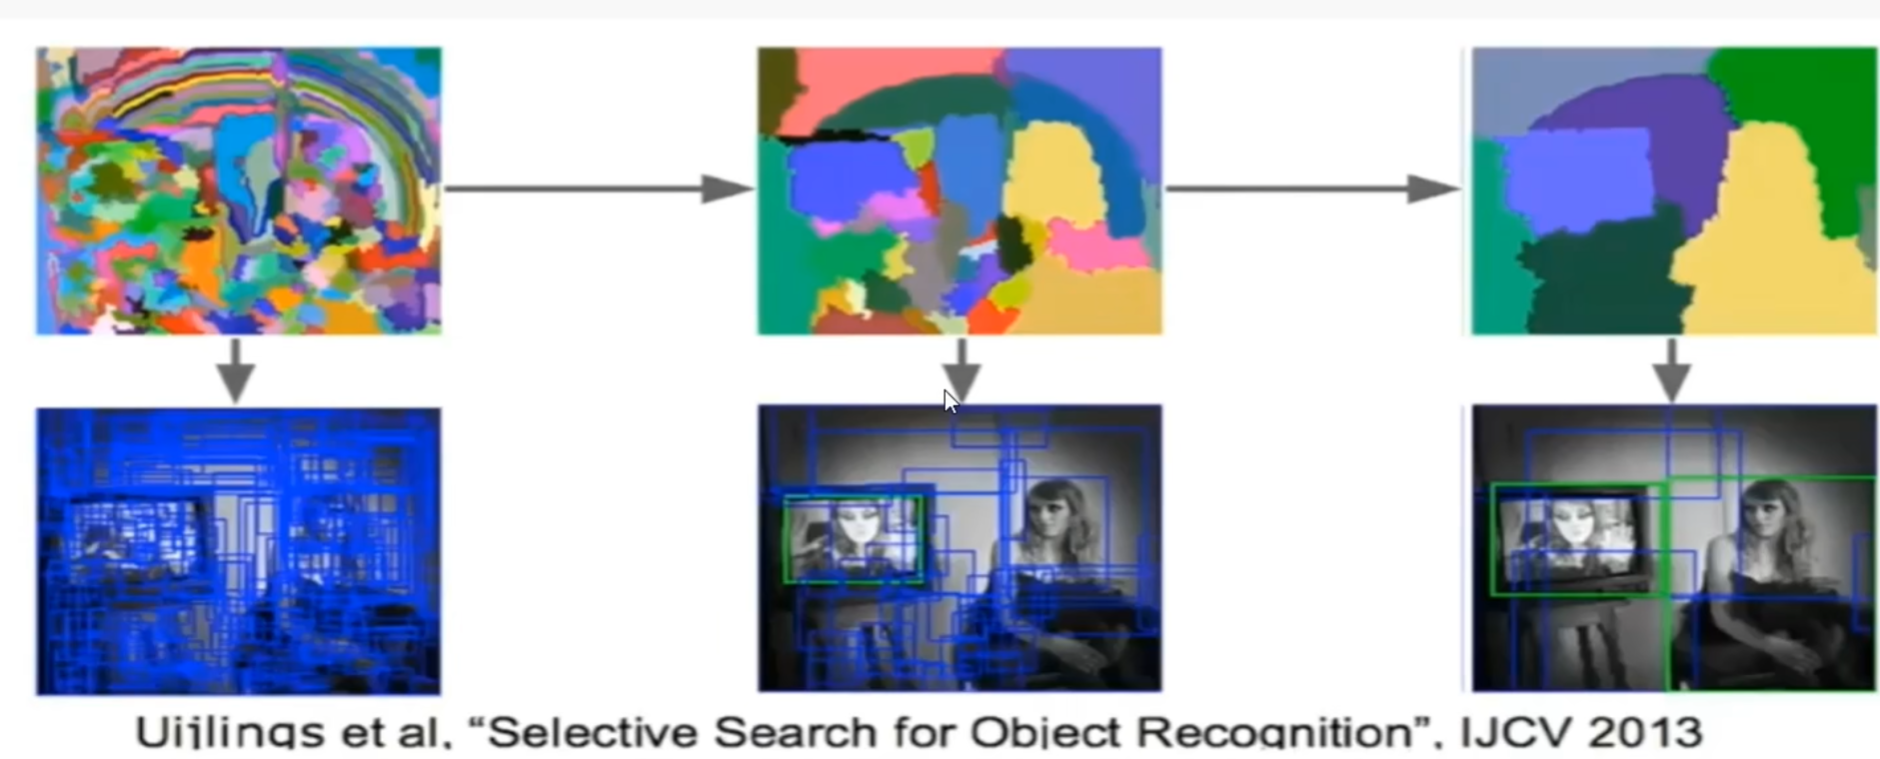
首次使用深度学习进行目标检测. 使用 selective search 的方法, 找到候选框.
-
原理
-
对每张输入图片使用一个基于规则的选择性搜索 (Selective search), 生成 2000 个候选区域 (Region proposals)
- 使用过分割手段, 将图像分割成许多小区域
- 查看现有的小区域, 合并 可能性最高 的两个区域, 重复直到整张图像合并成一个区域位置
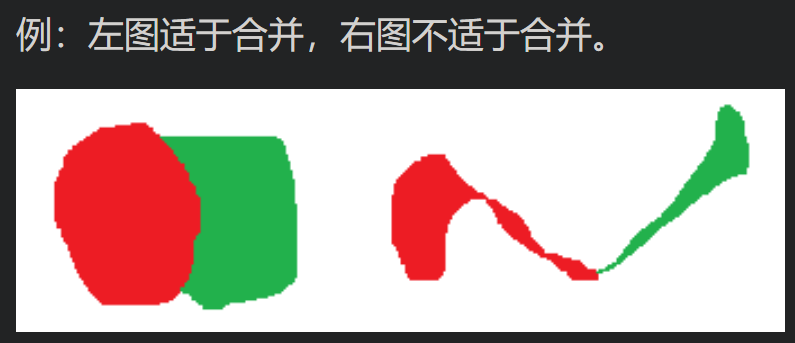
- 合并规则:
-
合并颜色 (颜色直方图), 纹理 (梯度直方图)相似的区域
-
合并后总面积减小 (为了防止一个大区域覆盖多个小区域)
-
合并后目标总面积在边界框 (Bounding box) 中占比大 (为了保证合并后形状规则)
-
- 合并规则:
-
对每个候选区域使用CNN进行特征提取
-
将网络提取的特征送入每一类的 SVM 分类器 进行判别
-
分类并获得置信度之后, 对所有框进行 非极大值抑制
-
使用 回归器 (Regressor) 精细修正候选框位置
-
使用线性脊回归器在损失函数上添加一个 $l_2$ 范数作为惩罚项, 这个参数造成了预测框额外的缩放和平移. 使结果更接近于 GT.
-
回归器的损失函数有几种? 区别是什么呢?
回归损失函数1:L1 loss, L2 loss以及Smooth L1 Loss的对比 - Brook_icv - 博客园
-
均方误差 (MSE, $l_2$ loss):
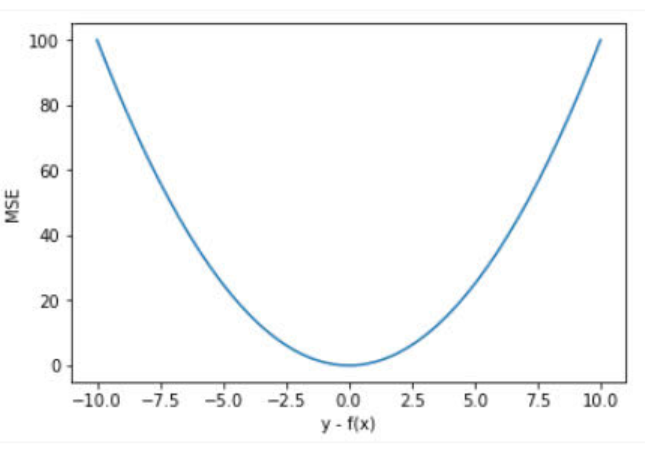
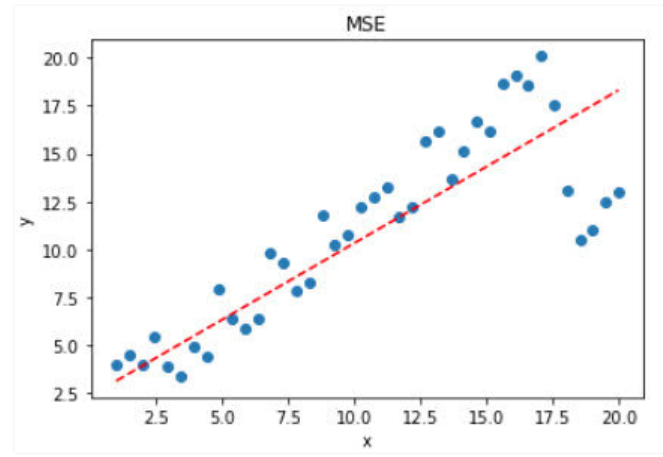
优点: 光滑连续方便收敛.
缺点: 受到离群点影响较大.
-
平均绝对误差 (MAE, $l_1$ loss):
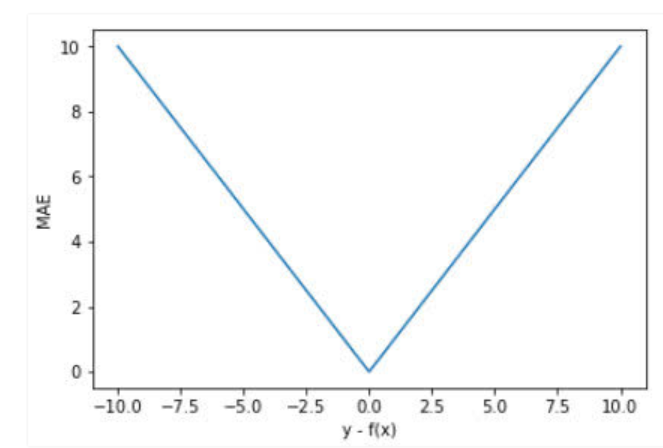
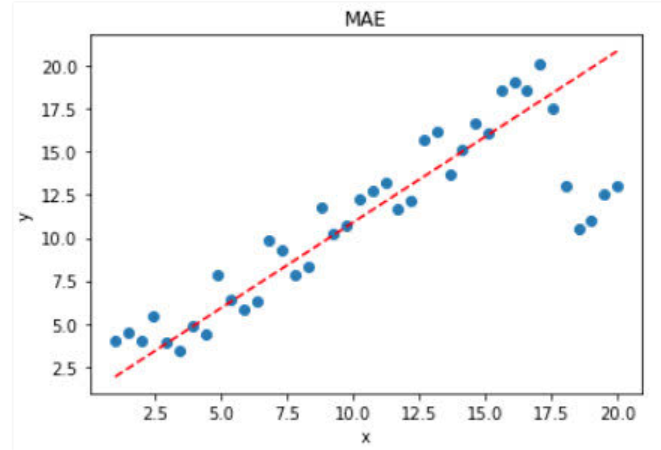
优点: 不容易梯度爆炸, 受离群点影响不大.
缺点: 不光滑, 大部分情况梯度相等, 不利于收敛.
-
Smooth L1
$$ \text { Smooth } L_1(x)=\left\{\begin{array}{cc}0.5 x^2 & \text { if }|x|<1 \\|x|-0.5 & \text { otherwise }\end{array}\right. $$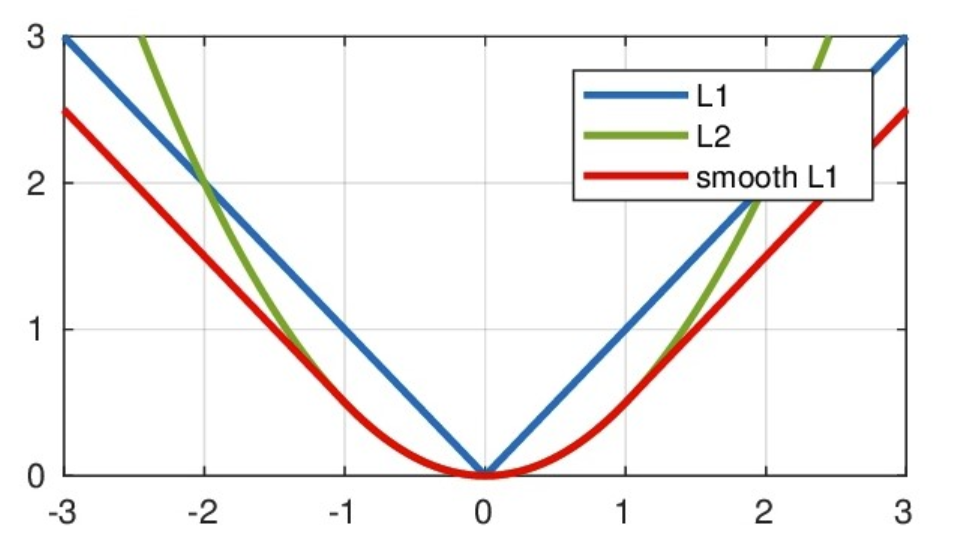
介于 L1 和 L2 之间, 解决了 L1 不光滑的问题, 同时减少了受离群点的影响.
-
-
-
-
缺点
- Selective search 需要在 CPU 上进行操作, 并且 2000 个候选框都要做特征提取, 所以速度较慢.
- 使用支持向量机 (SVM) 在 CPU 上进行分类.
- 特征提取使用 CNN, 所以输入网络的候选框全都要 resize 到 227x227 的尺寸.
- 算法结构分散 (非端到端).
-
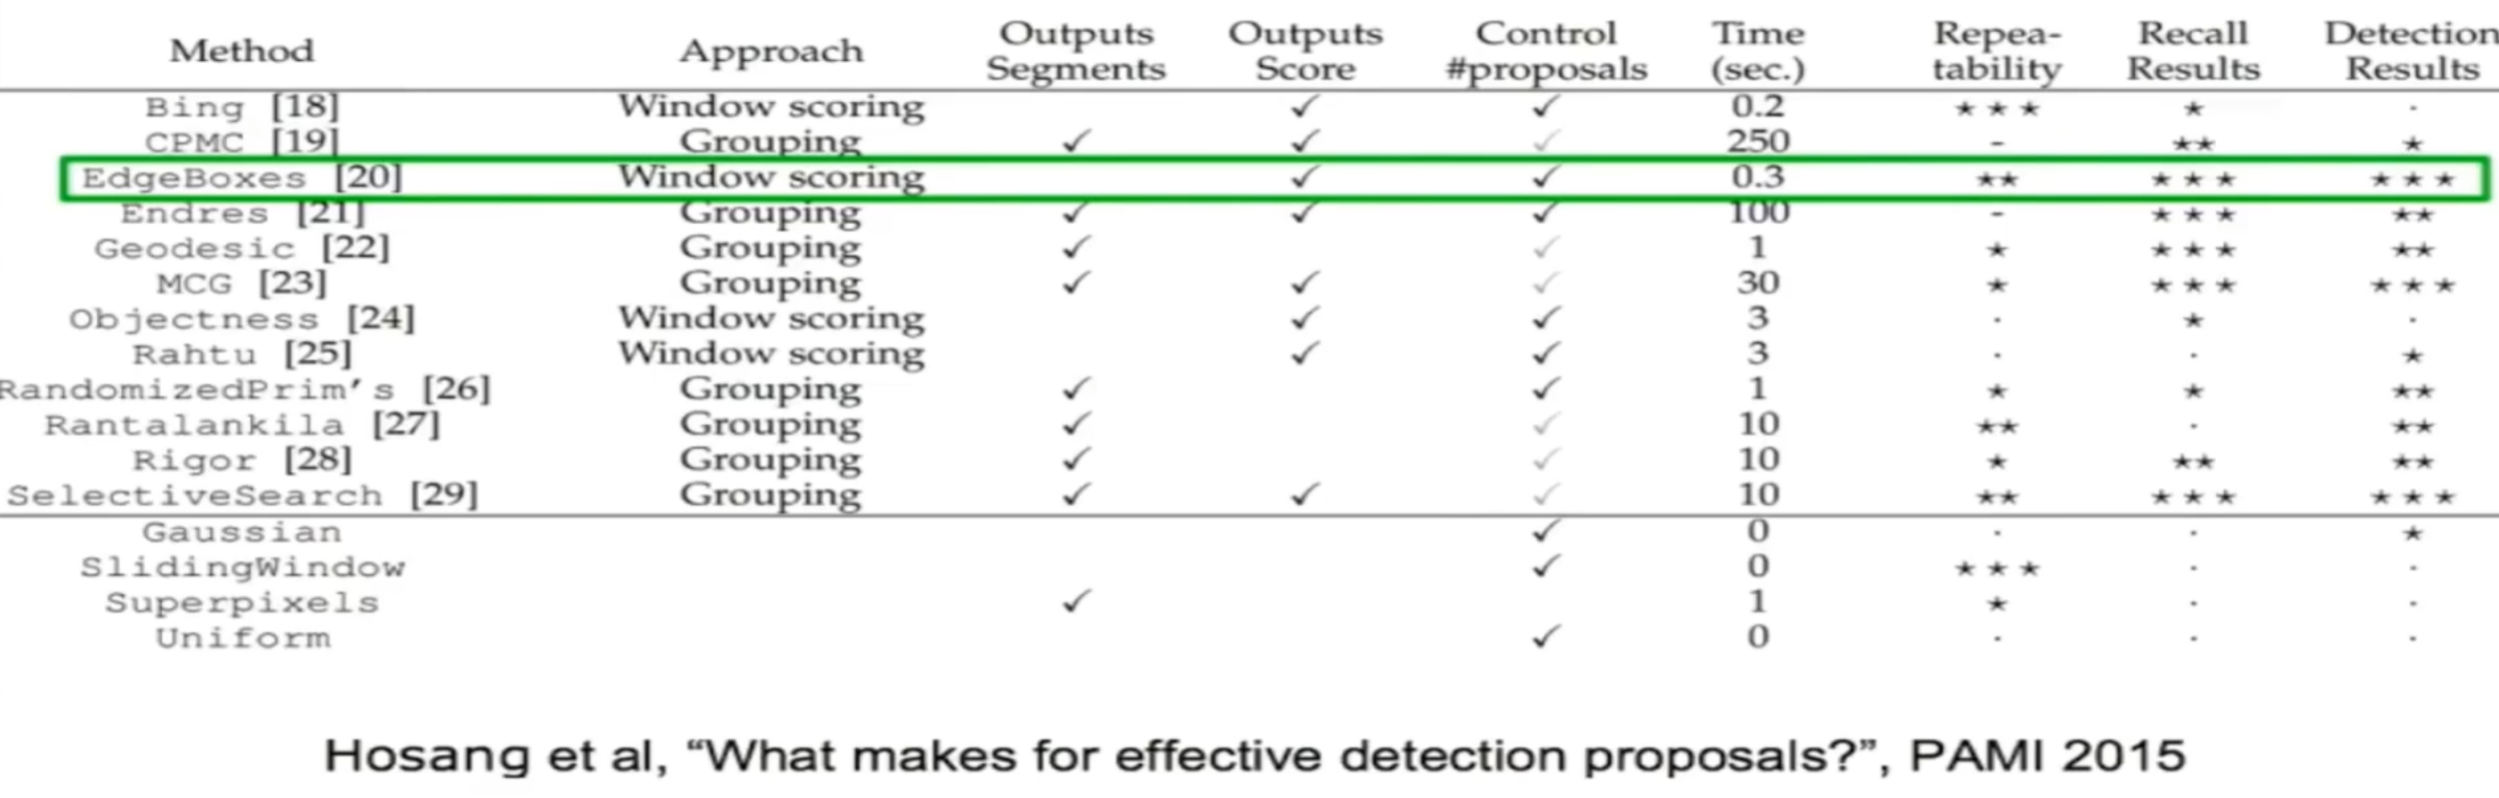
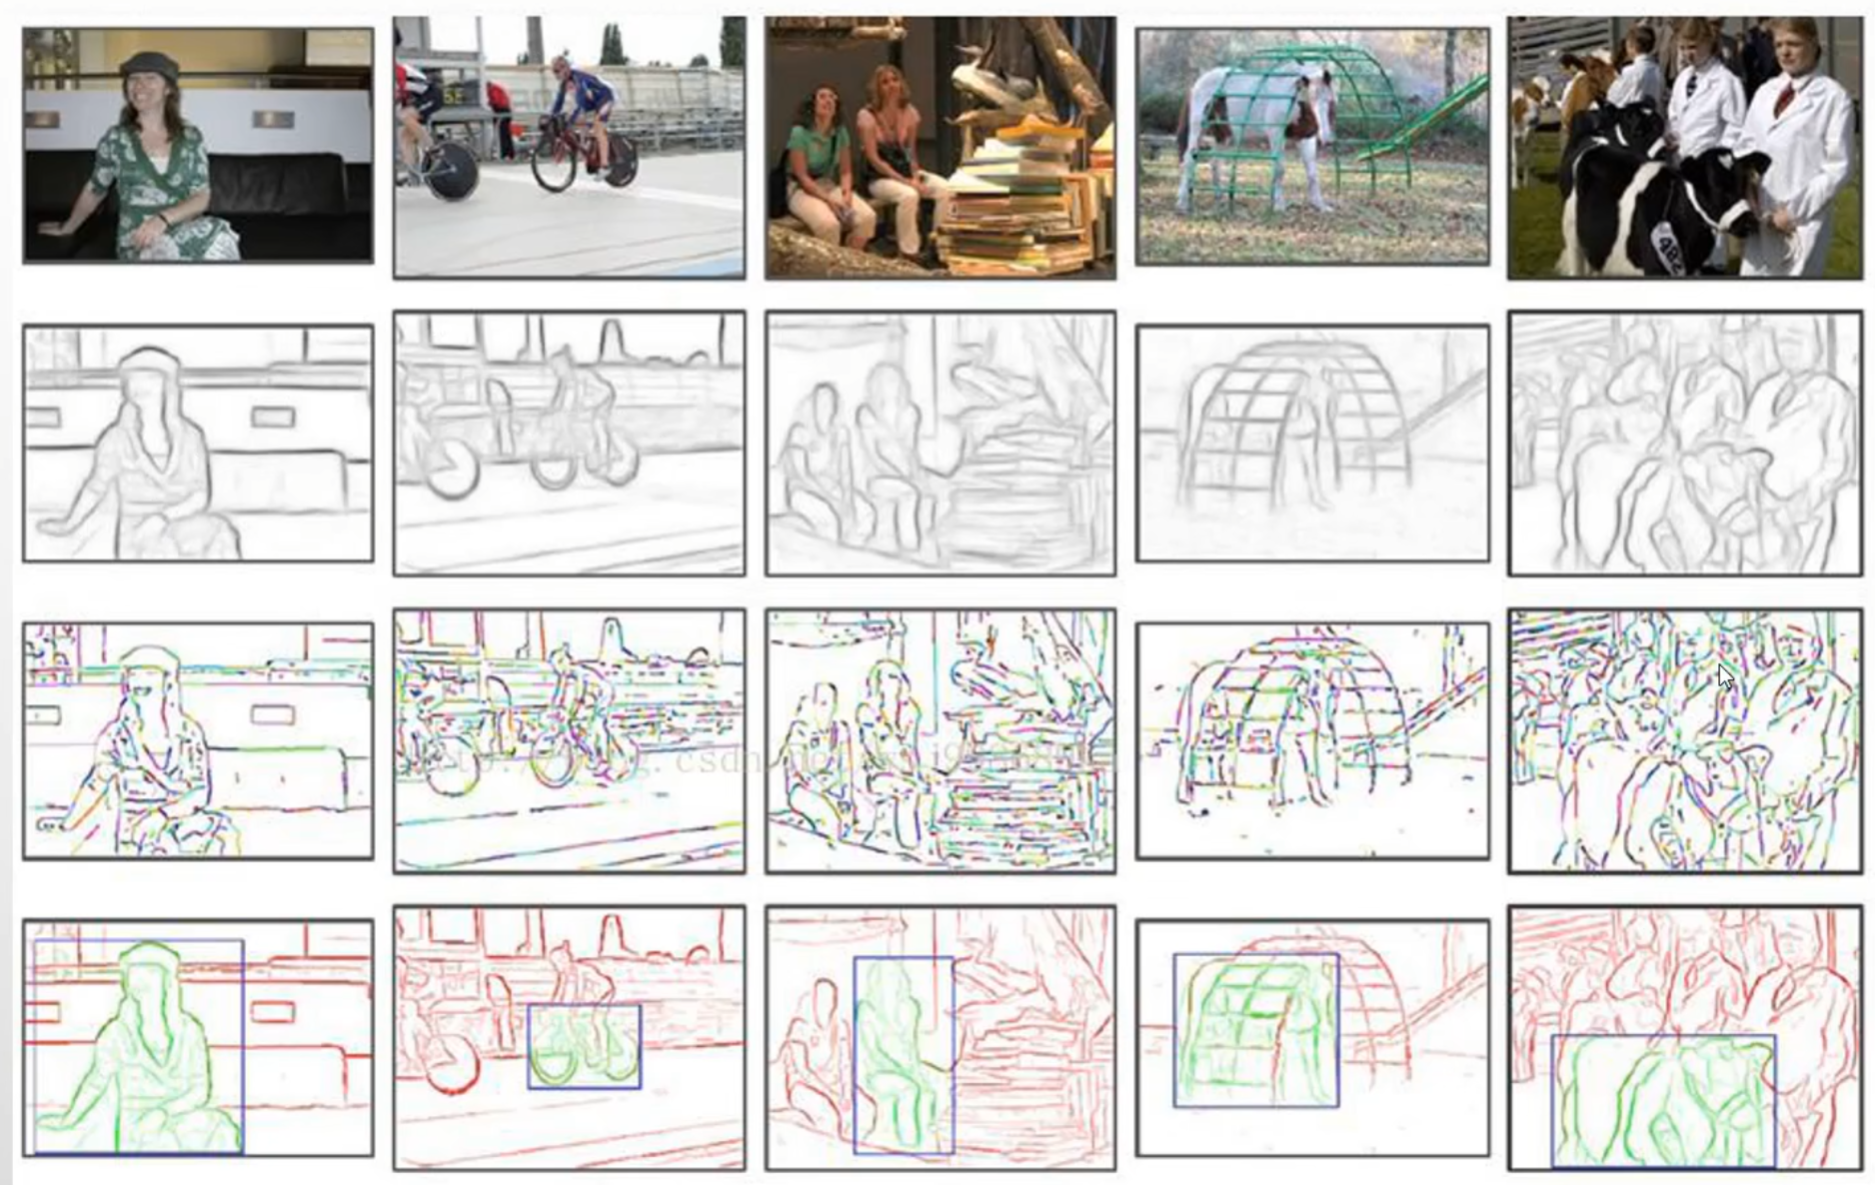
也可以使用 EdgeBoxes 来寻找候选框, 精度相同但速度很快
5.1.1. 如何去除冗余的检测框?
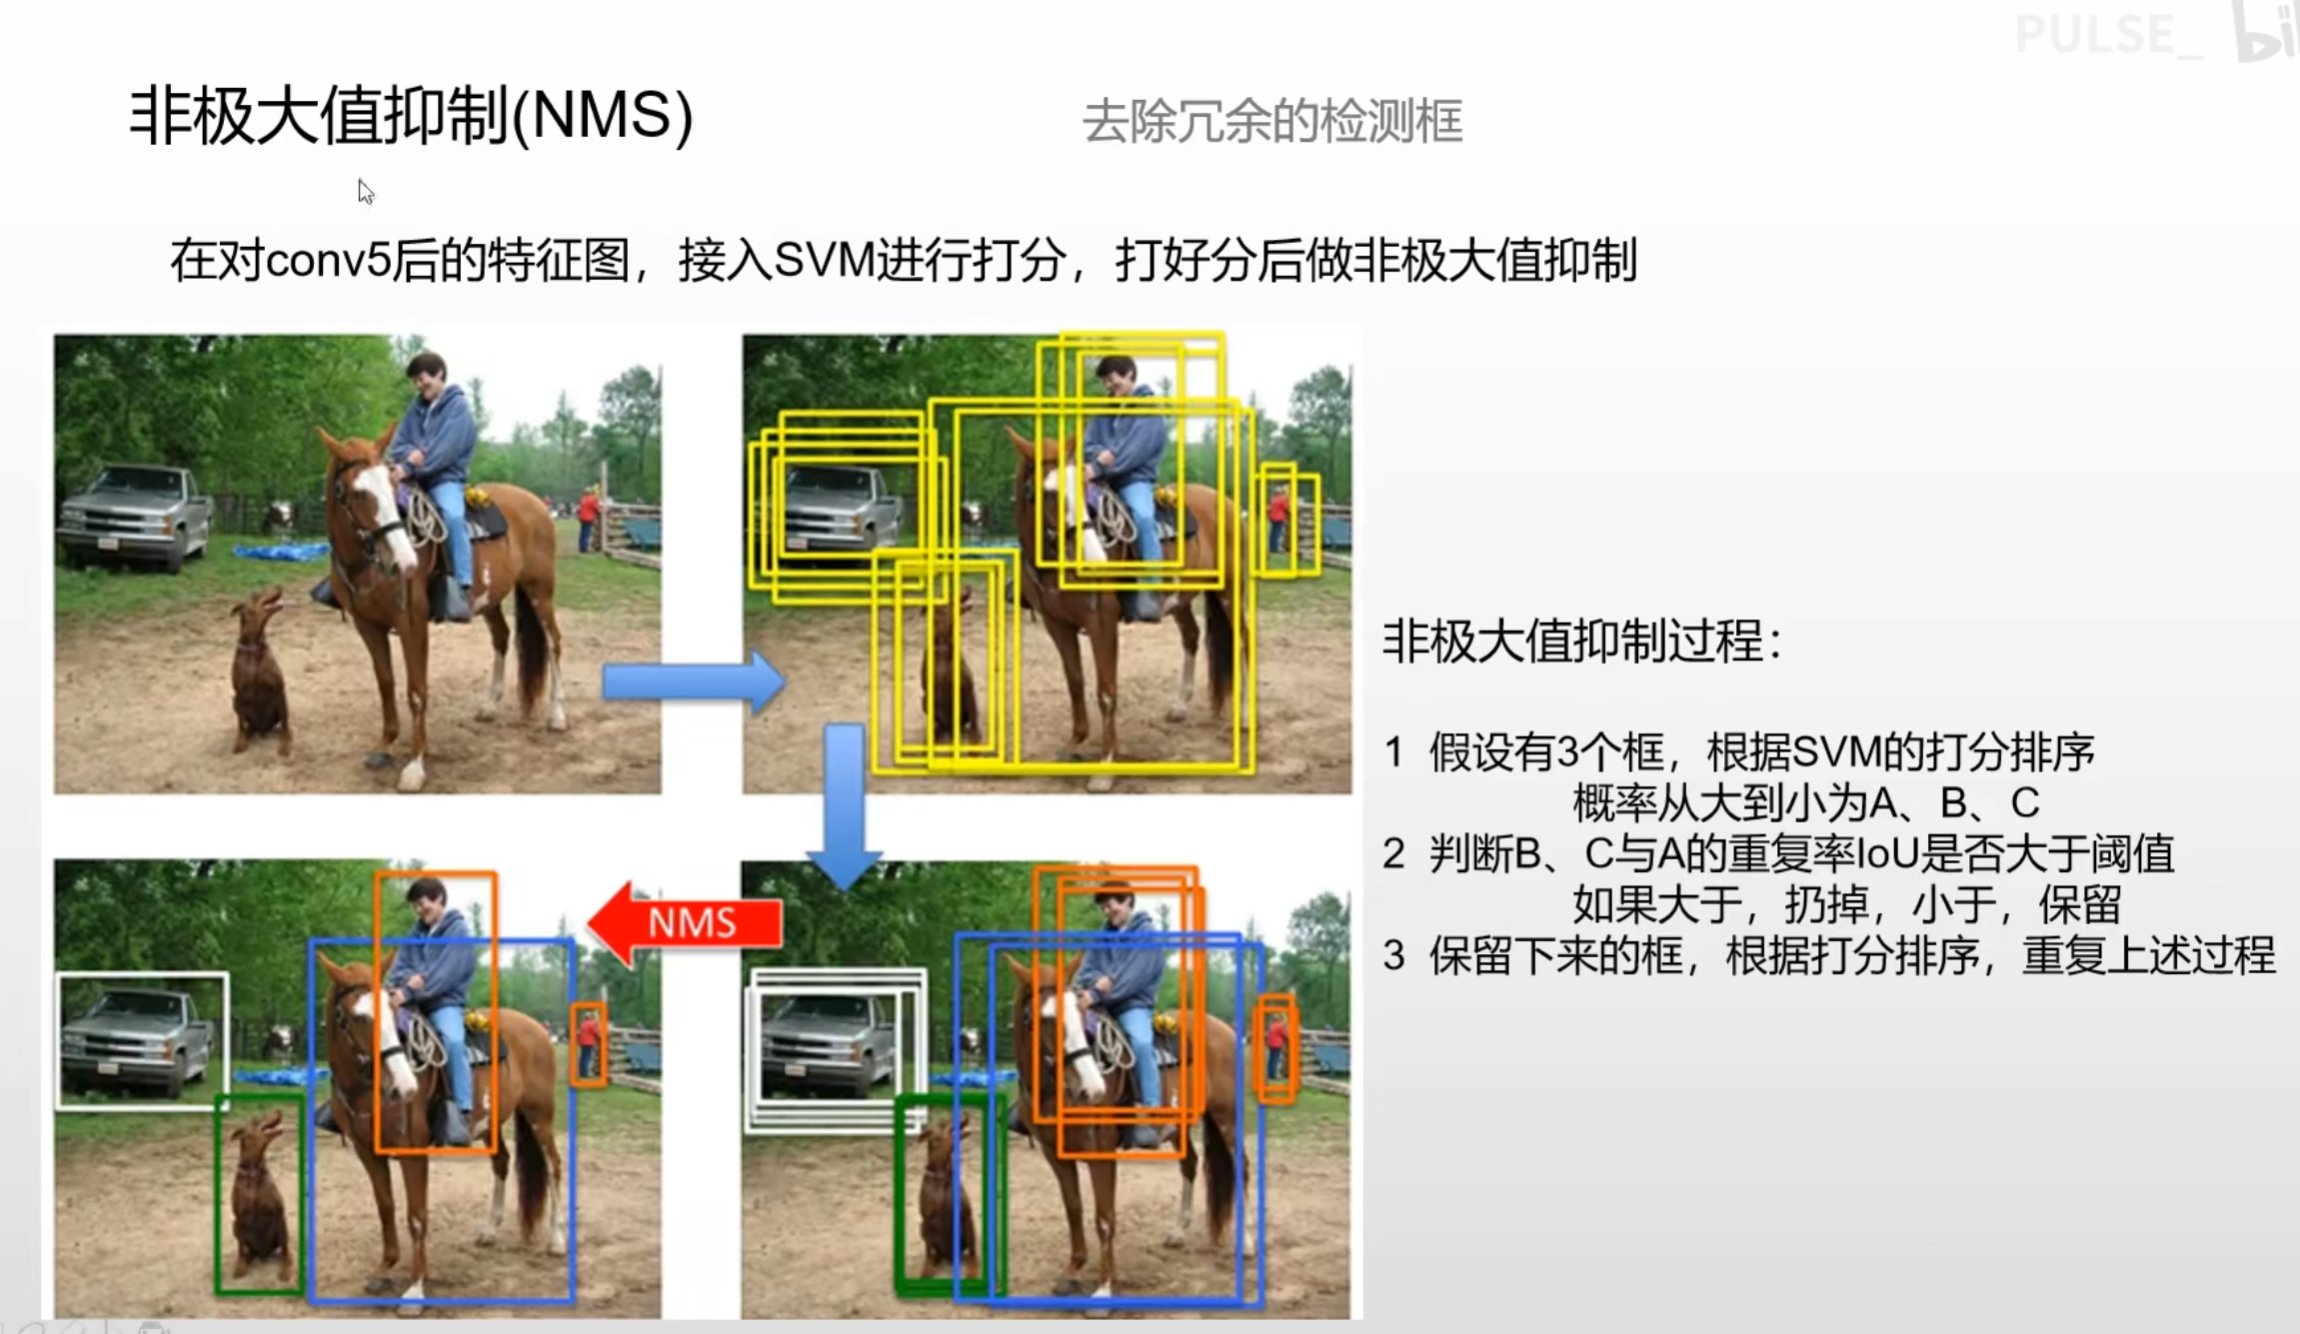
使用非极大值抑制 (NMS)
步骤如下:
- 建立两个表, 一个保留表, 一个候选表.
- 将所有框放入候选表.
- 从候选表中排序找到置信度最大的框 $\alpha$ 放入保留表.
- 用 $\alpha$ 与候选表中的所有框做 IoU 计算, 大于阈值 (如 0.5) 的从候选表中丢弃.
- 重复 3 和 4, 直到候选表为空.
-
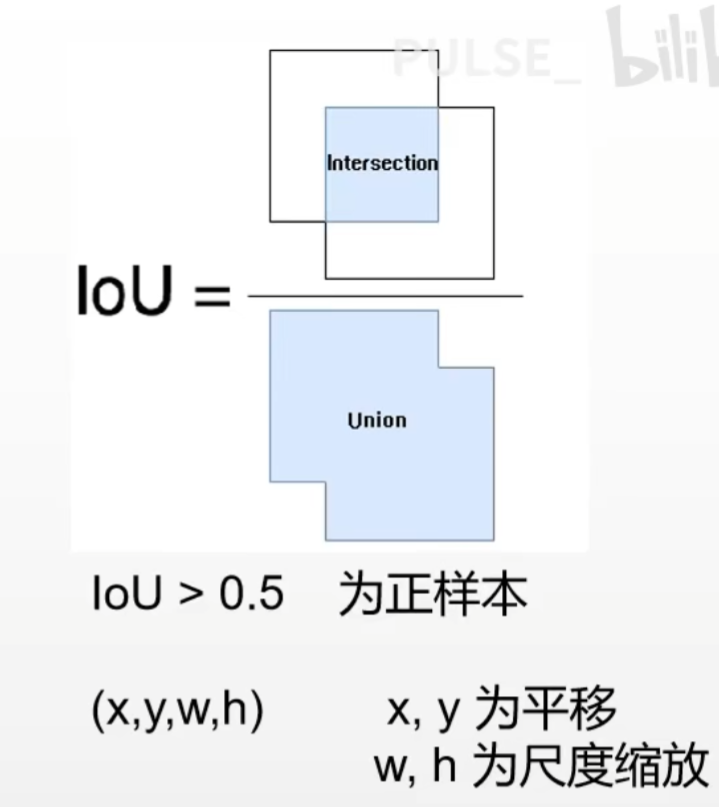
IoU计算
5.2. SPP-Net (空间金字塔池化) 2014
RCNN 在之后的改进之中, 借鉴了很多 SPP-Net 的思想.
-
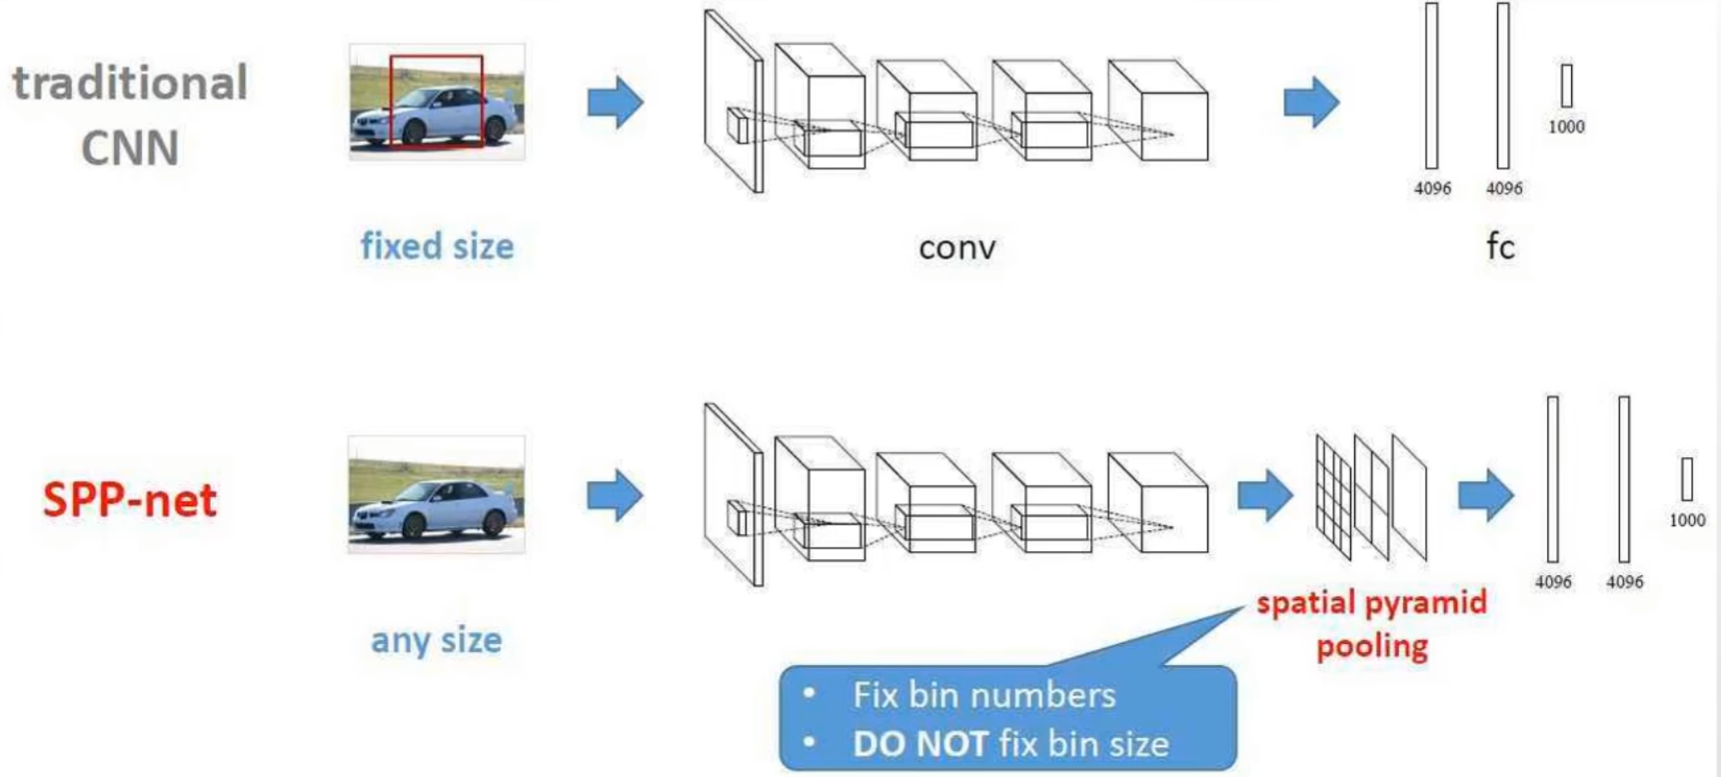
优点
-
输入的时候不需要缩放
-
基于空间金字塔池化层, 每幅图片只需要提取一次特征 (R-CNN 一张图片需要提取 2k 次特征)
-
如何做到的呢?
- 一张图片只经过一次卷积, 获得多个尺度的特征图.
- Selective search 获得原图上所有的边界框.
- 通过坐标映射 (Coordinate Mapping) 来算出需要预测的边界框对应各尺度的特征图上的位置. 从而获得大小不同的特征矩阵.
-
如何映射?
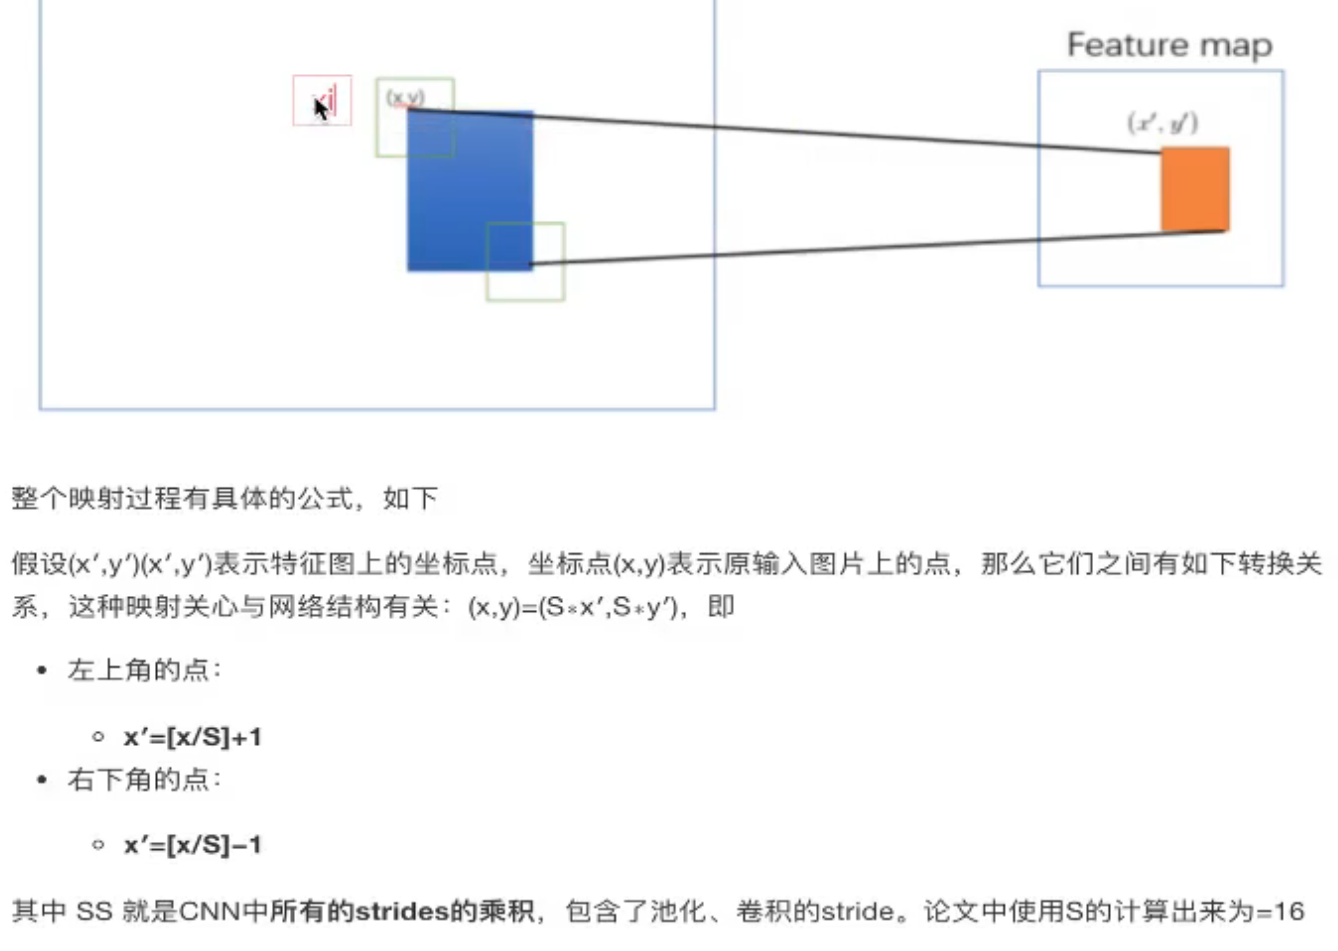
- $S$ 是 CNN 网络中所有层的步长的乘积.
-
- 对于图片大小有影响的只有全连接层. 因为全连接层的节点数是必须固定的, 所以必须使全连接层前面的特征图的尺寸满足全连接层的尺寸.
-
如何做到呢?
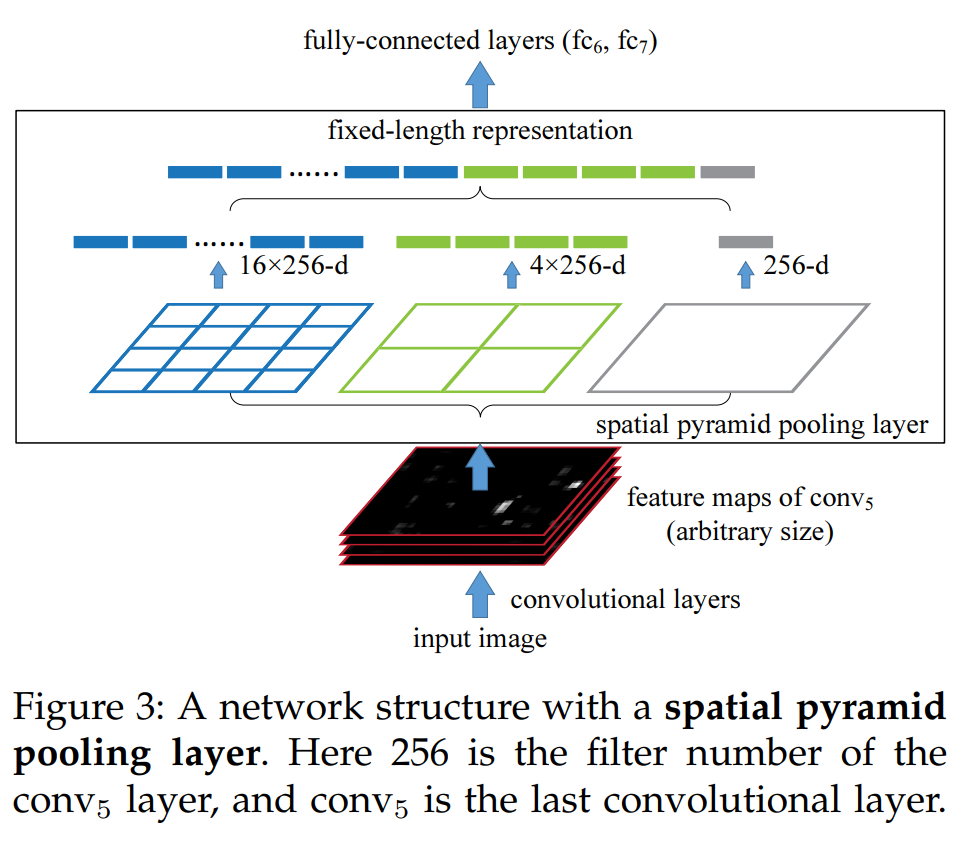
使用空间金字塔池化层 (Spatial pyramid pooling). 使用卷积块 (CNN block, 其中包括卷积层, 池化层, 激活函数) 提取特征之后, 使用 3 个不同尺度的池化特征图, 每个池化特征图取最大值 (作 Max pooling), 作为 FC 层的 21 个神经元.
eg:
- 假设原图输入尺寸 224x224, 并且卷积层有 256 个过滤器, 输出的特征矩阵尺寸是 13x13x256. 从这个特征矩阵中可以获得多个候选区域的映射矩阵.
- 每个映射矩阵都作 Max pooling, 于是矩阵的尺寸就变为 4x4, 2x2, 1x1. 将矩阵摊平. 就是 21x1 的向量, 输入全连接层. ← 这样的向量有 256 个.
-
-
-
-
缺点
-
SPP-Net 还是多段的训练, 依旧使用了 Selective search 模块来生成候选区域, 分类使用 SVM, 所以效率还是很低.
-
在输入 SPP 前, 所有候选框的特征图必须 resize 到正方形 (Max pooling 必须输入和输出尺寸为倍数关系), 这降低了效率.
-
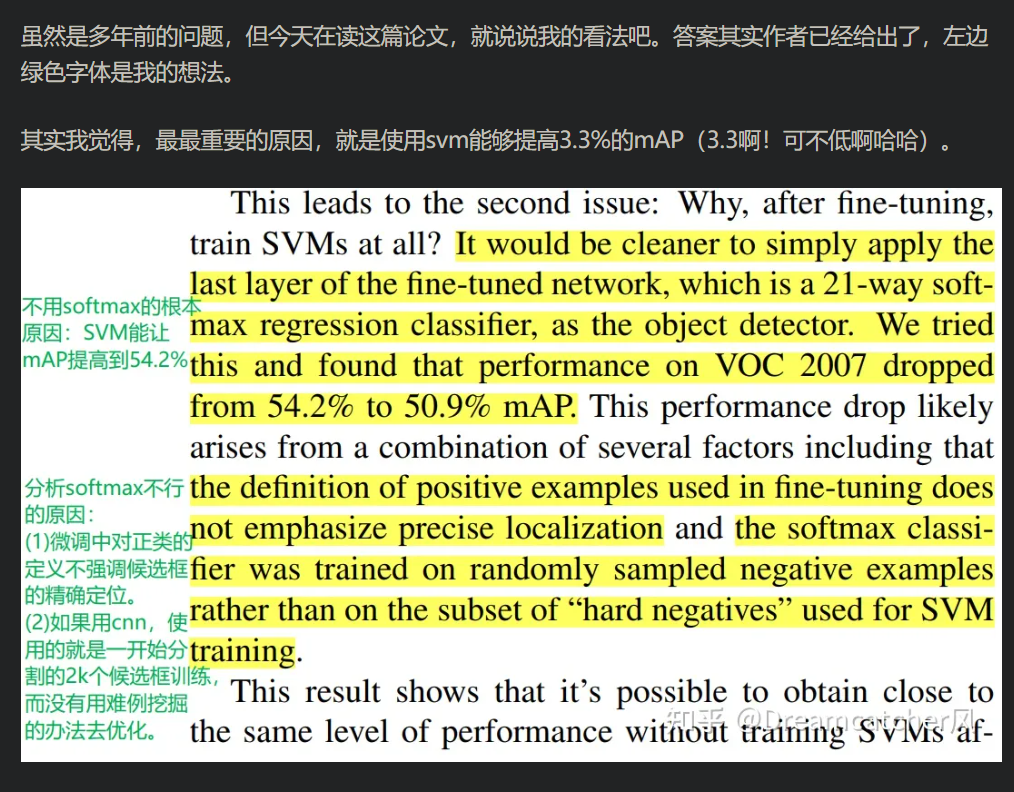
为什么论文用了 SVM 和 FC+softmax 两种方法作分类呢?
因为 SVM 在少量样本的情况下, 不容易过拟合, mAP 精度高于 FC.
-
5.3. Fast-RCNN 2015
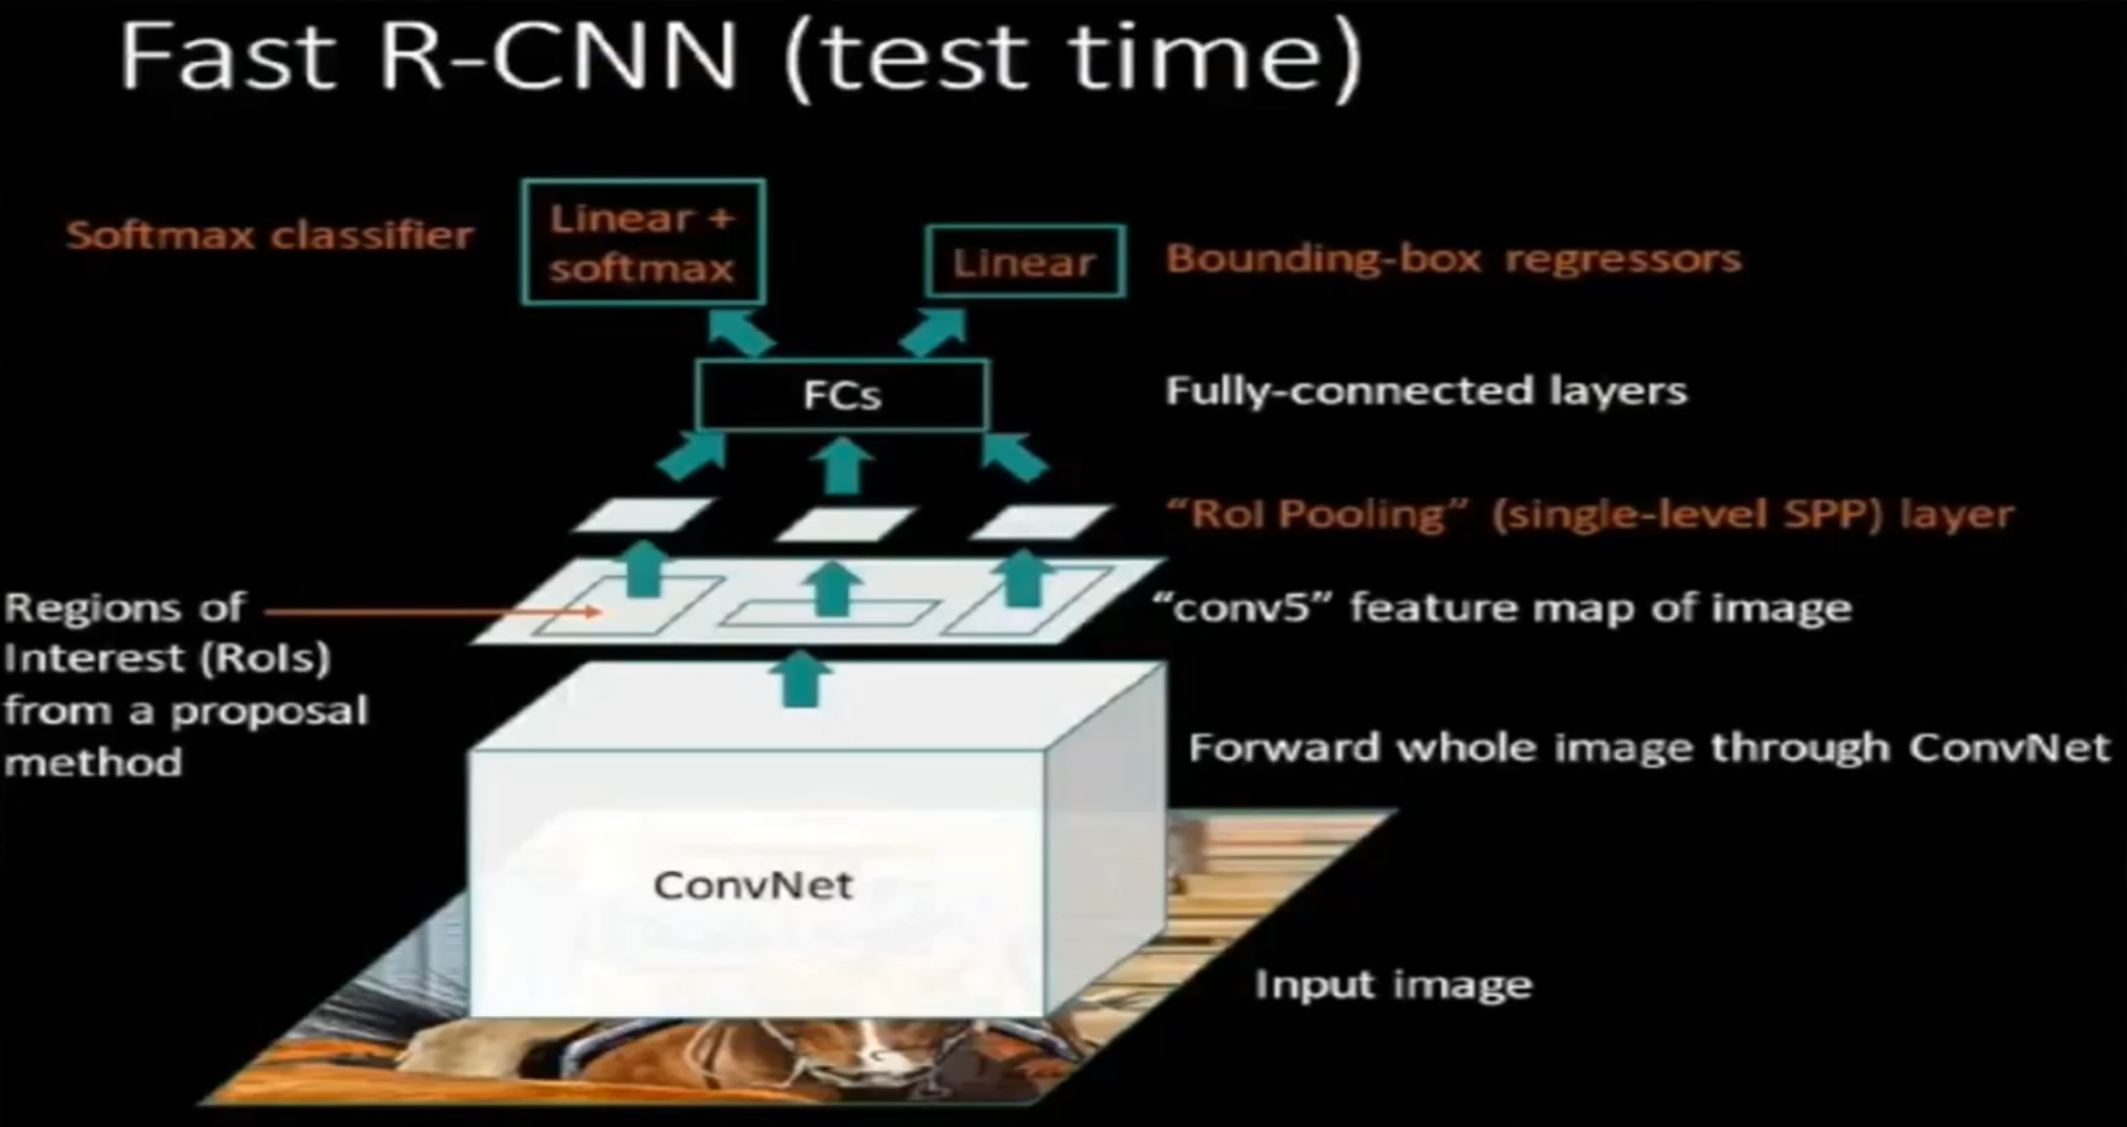
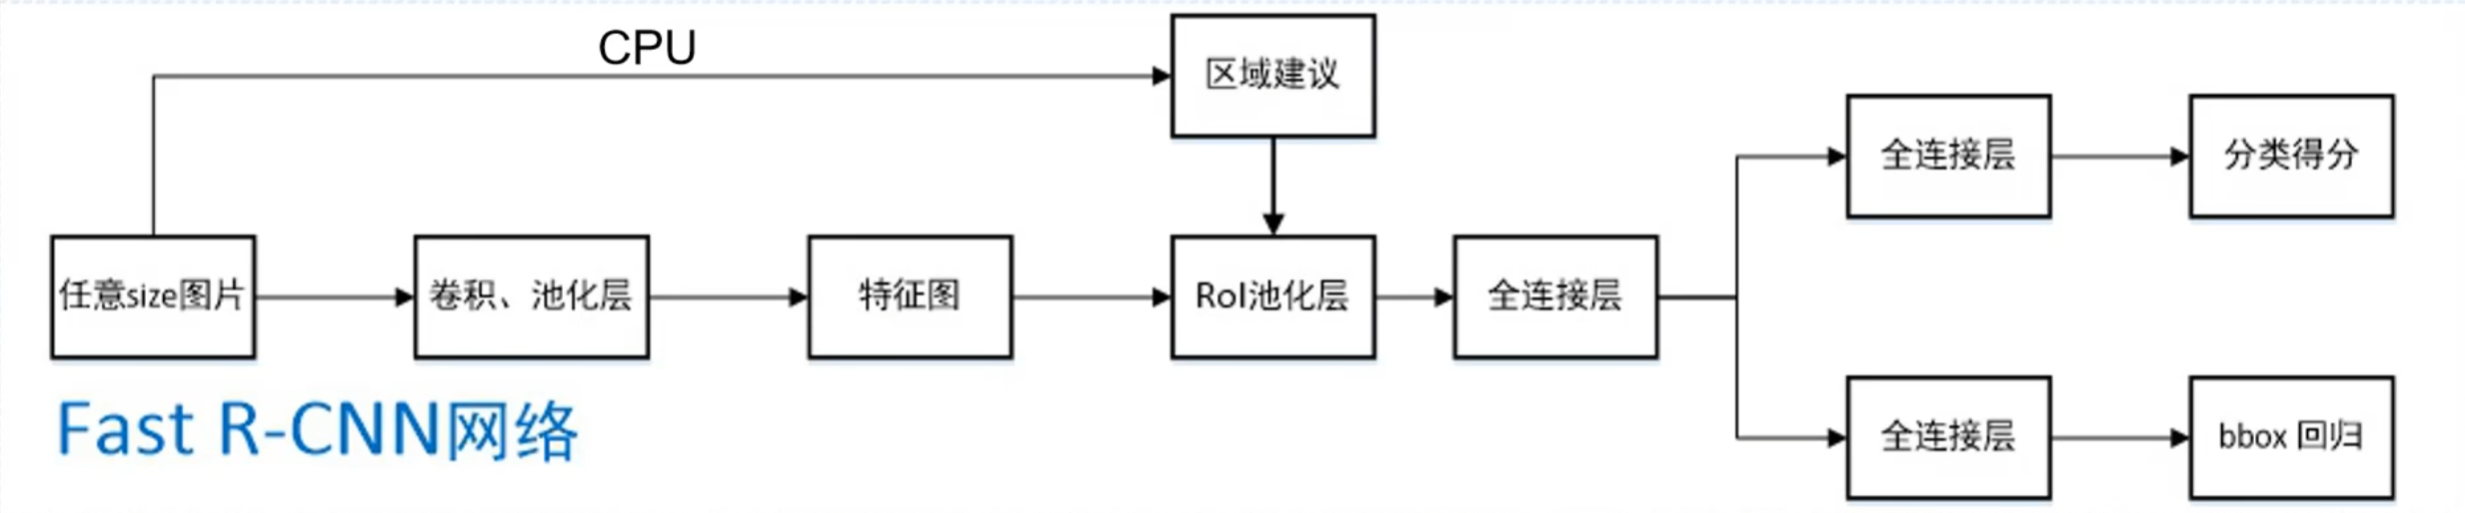
-
优点
-
优化了 SPP-Net 在 FC 之前做 Max pooling (SPP) 的操作. 使用 ROI pooling 的方法代替 SPP.
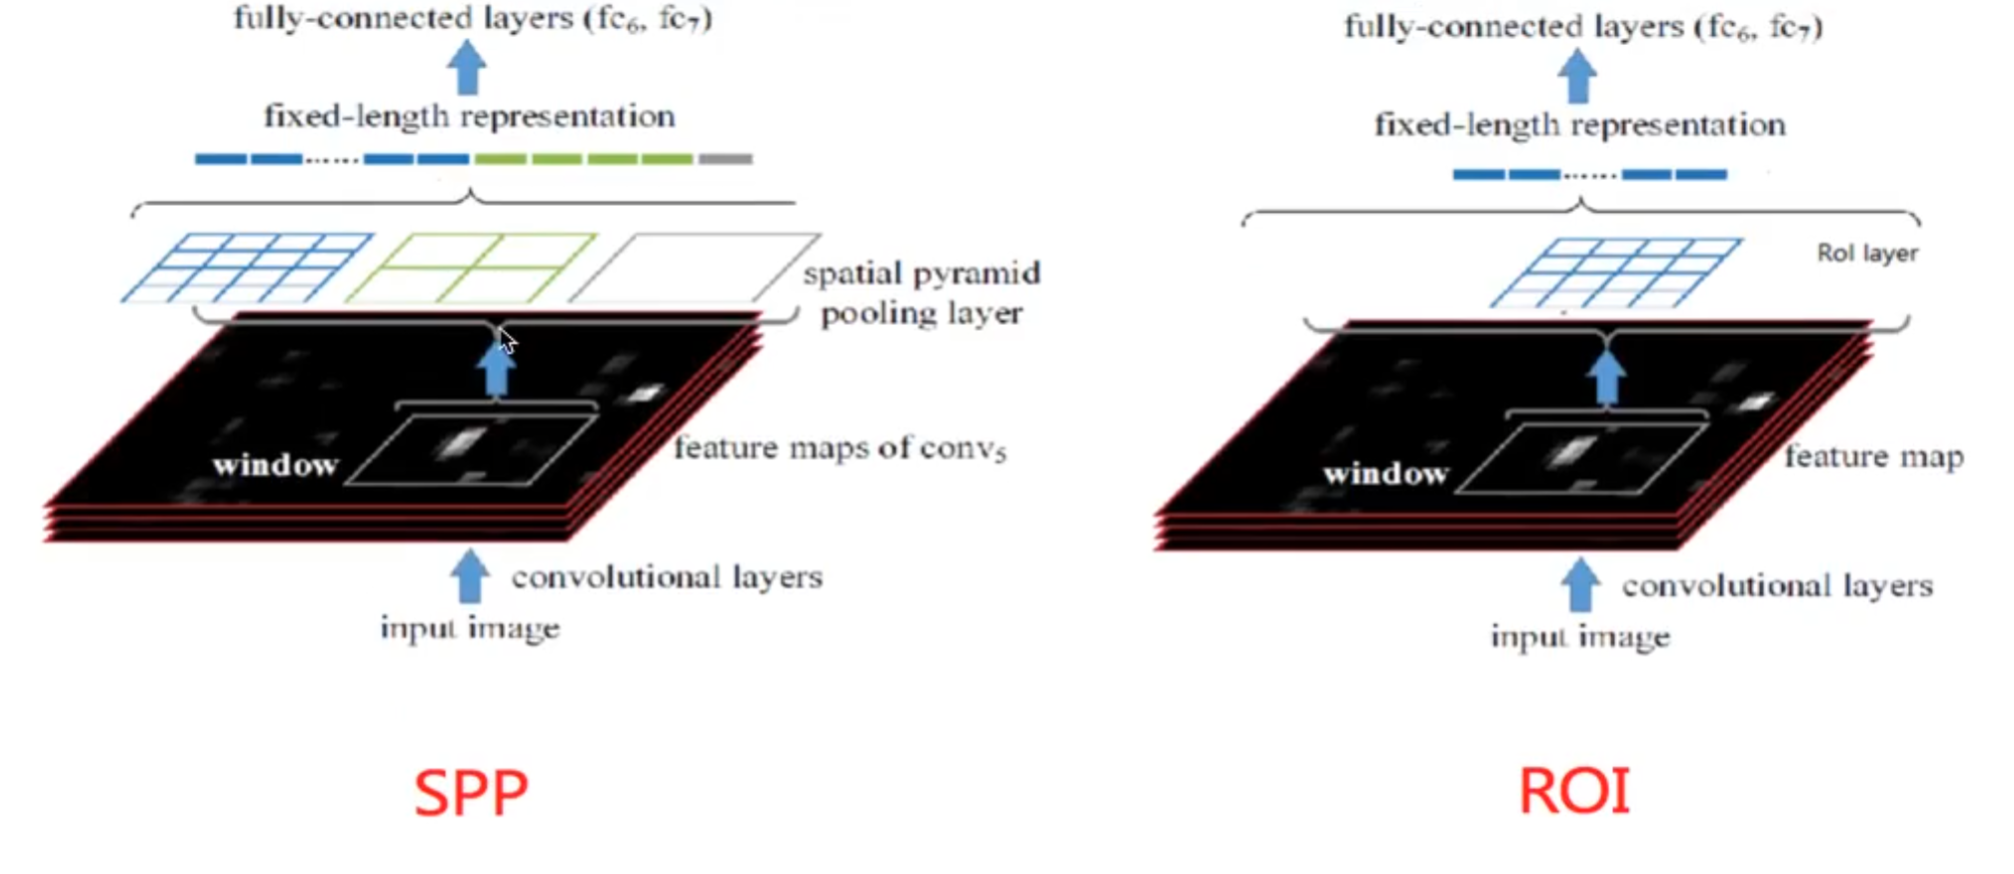
- ROI (Region of Intereset)
- ROI pooling 可以看作是空间金字塔池化的简化版本, 它通过将区域候选框对应的卷积层特征池化为尺寸为 $K*M$ . (SPP 进行 3 次最大池化, 并且输入 ROI 不需要 resize).
- 如果池化尺寸对不上 FC 的输入怎么办?
-
直接使用 卷积特征尺寸 / 块的尺寸 就可以了.
-
如: 特征尺寸 $5*7$, FC 输入尺寸为 $2*2$, 就动态调整特征尺寸变为 $5/2 * 7/2$.
-
下图是 ROI Pooling 的过程, 对应特征池化为 $2*2$, 最终得到结果.
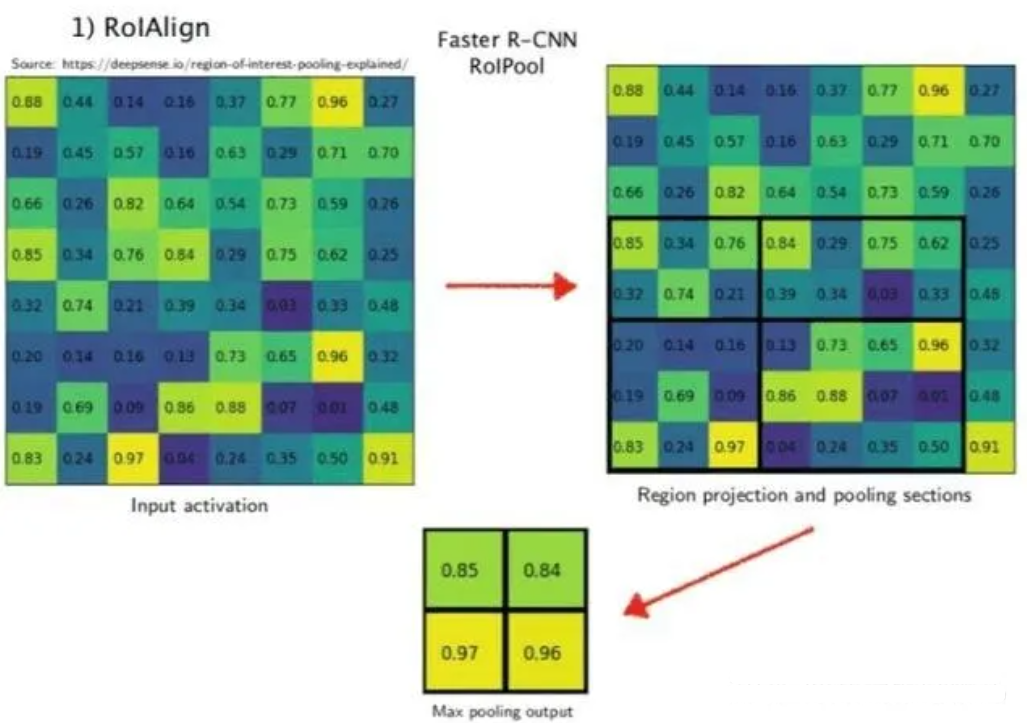
-
- 如果池化尺寸对不上 FC 的输入怎么办?
-
卷积复用, 提升了速度
-
分类器从 SVM 变为了 Softmax.
-
接近端到端的结构, 可以从 Softmax 和 Regressor 反向传播到卷积.
-
损失 Loss
-
分类: $N+1$ 路的 Softmax, $N$ 是分类数量, $1$ 是背景, 使用交叉熵损失.
-
回归: $4*N$ 路输出的 Regressor, $N$ 个类别每个都有一个单独的 Regressor, 使用平均绝对误差 (MAE) 损失 (即 L1 损失).
$$ \mathrm{Regressor\_Loss} = \frac{1}{m} \sum_{i=1}^m\left|\left(y_i-\hat{y}_{k_i}\right)\right| $$
-
-
-
缺点
-
依旧使用 Selective search 做候选框 (有大量重叠), 还不是完全的端到端结构, 速度还是太慢.
-
候选框 (Region proposal) 的坐标位置通常是小数, 输入 ROI 之前会将其整数化, 将整数化后的边界再次整数化获得池化结果, 这影响了检测的精度
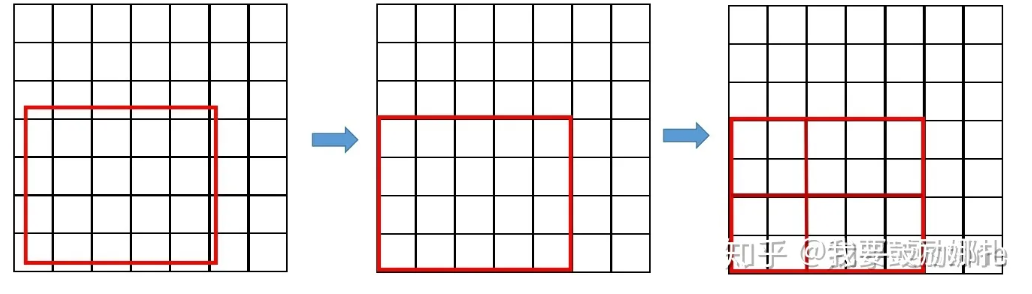
- 改进方案: ROI Align (Mask-RCNN中提出)
-
-
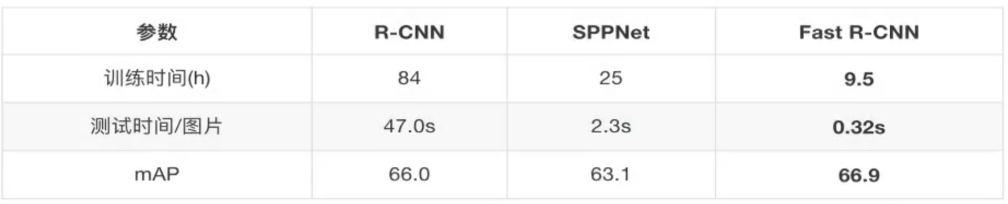
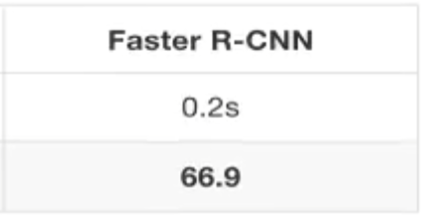
R-CNN, SPP-Net, Fast R-CNN 性能精度对比
5.4. Faster-RCNN 2015
-
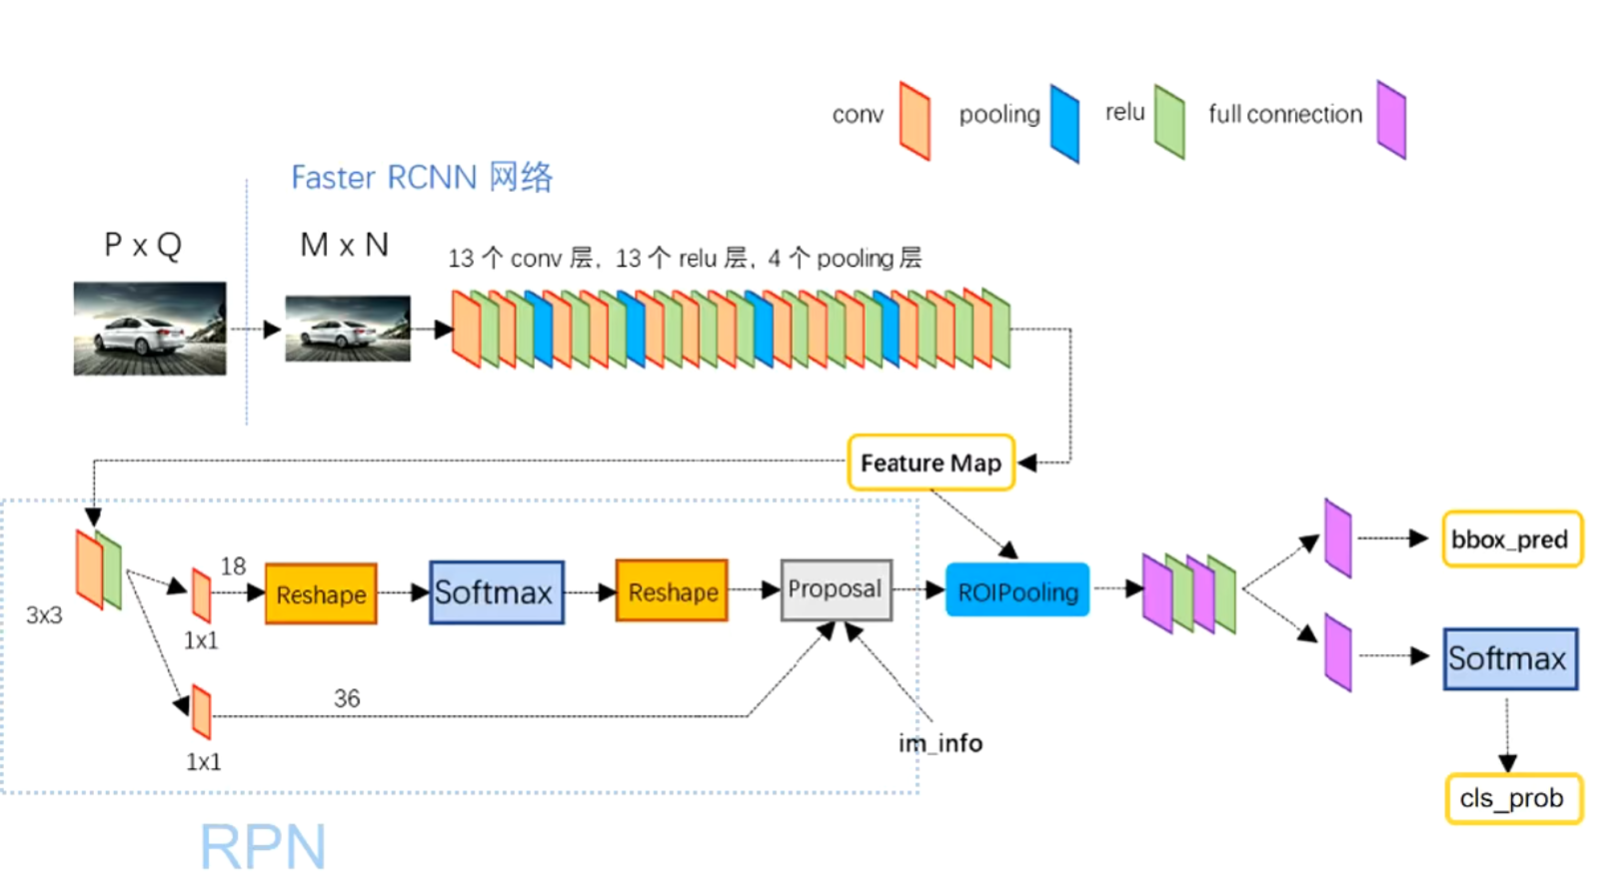
使用 RPN (Reginal Proposal Network 区域检测网络) 代替 Selective search, 达成了整体网络端到端的结构.
-
网络整体 backbone 用的还是卷积, neck 部分使用 RPN+ROI Pooling, head 部分 Regressor+Softmax.
-
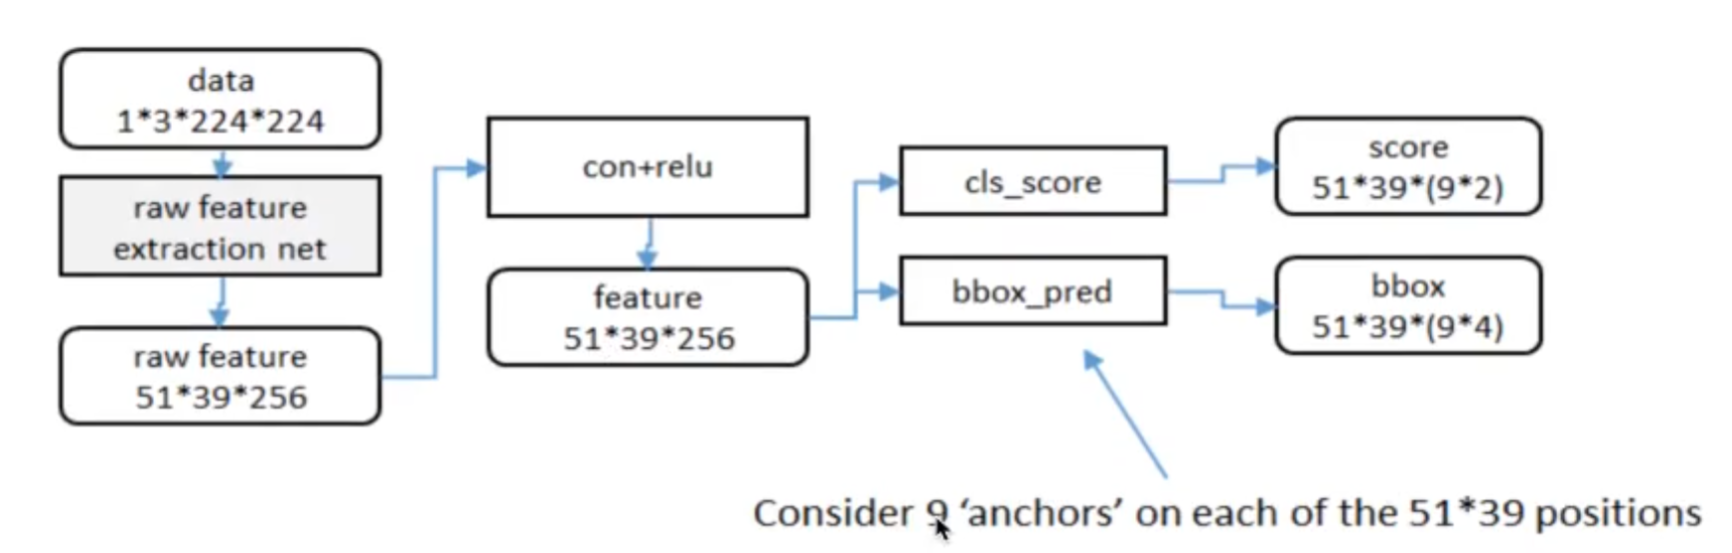
下面是举例, 可以看到特征图大小 $51*39*256 = 509184$, 另外每个特征图像素点还要各画 9 个 anchor box, 对于空间消耗还是很大的.
-
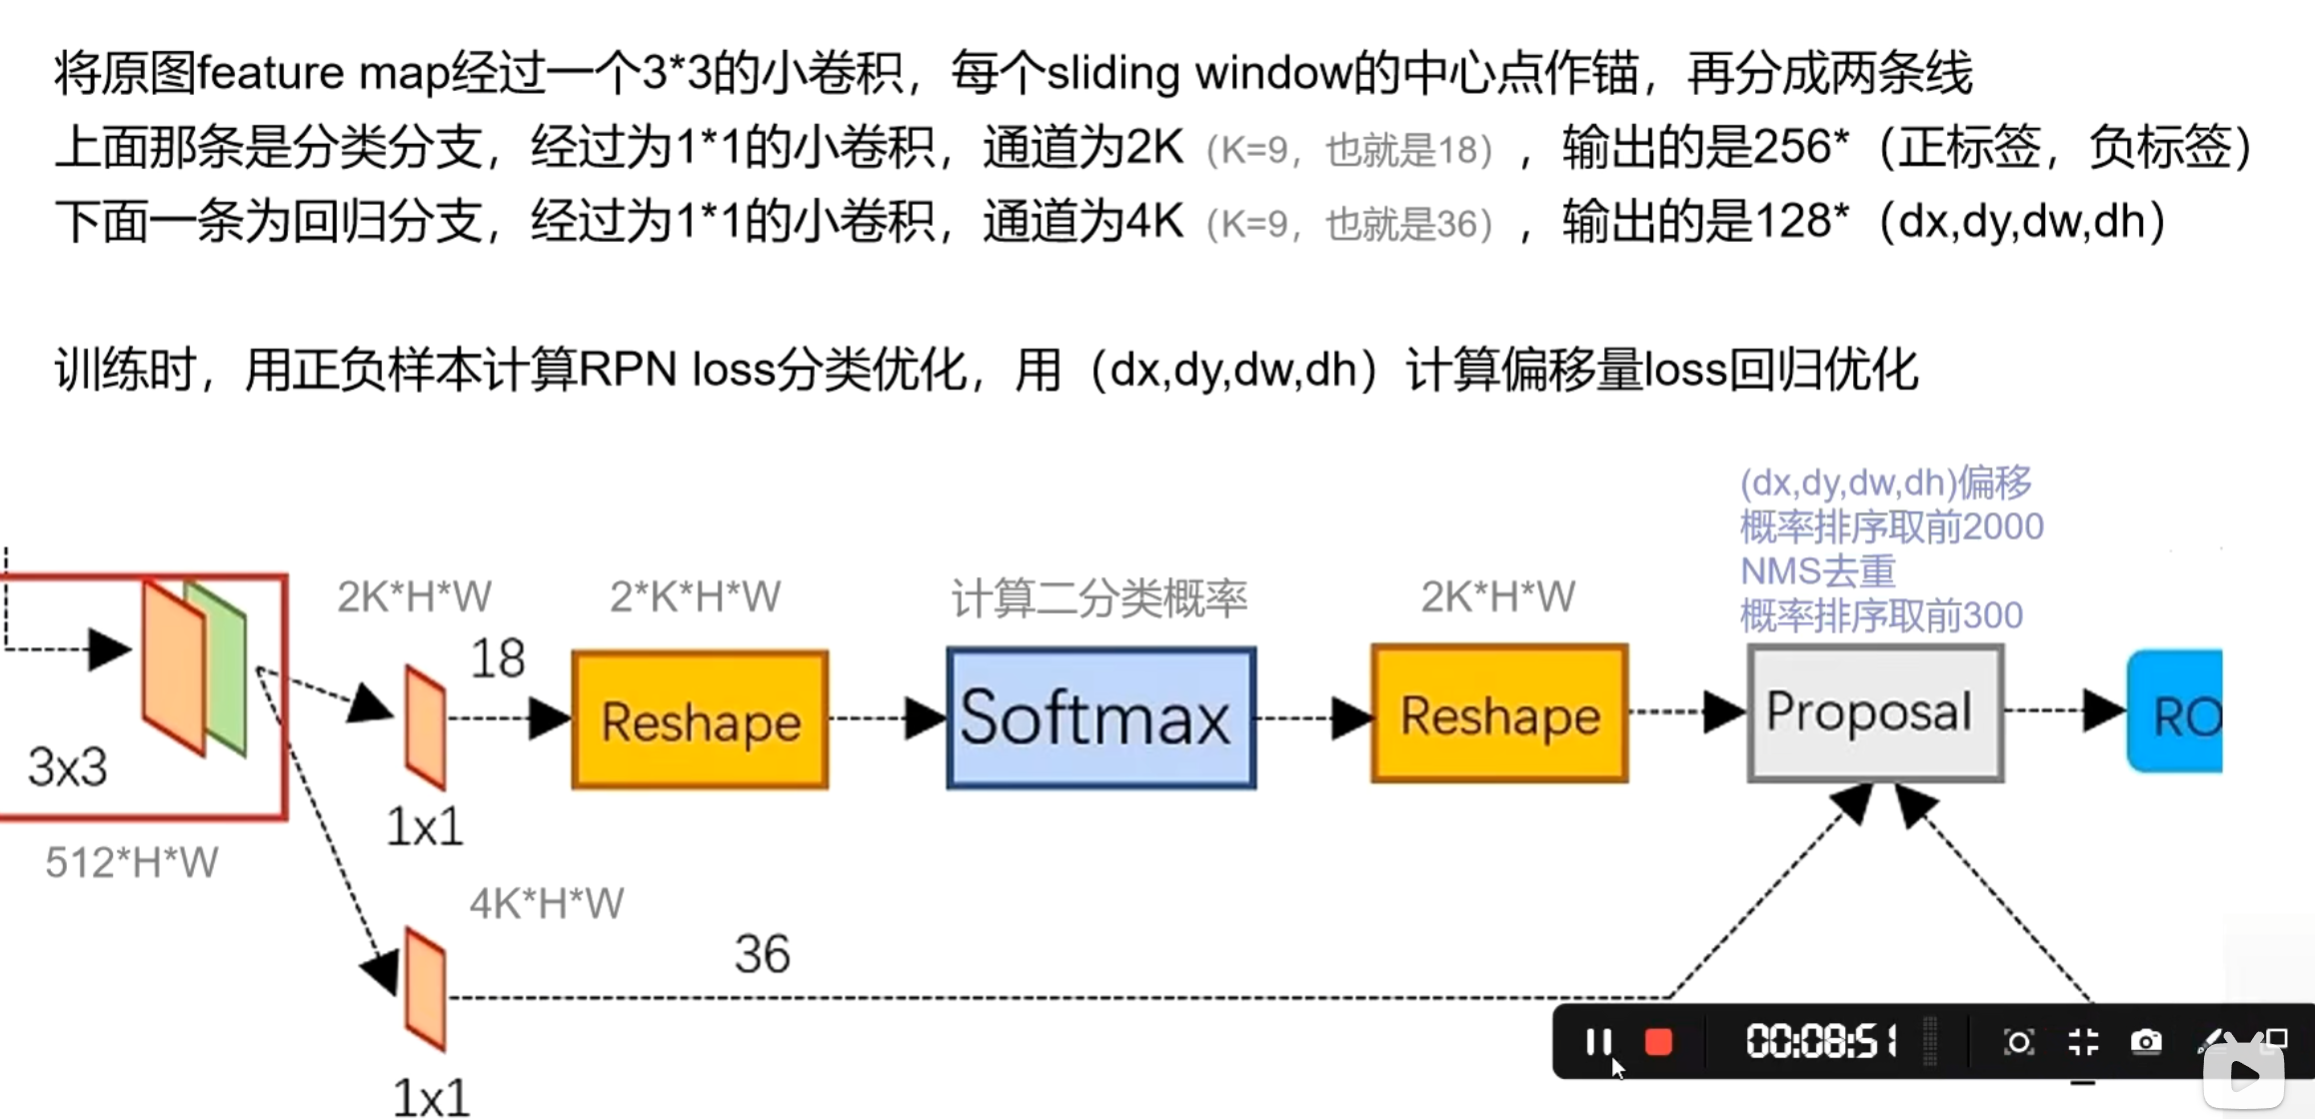
RPN部分
-
分两路走
- 分类分支: 使用小卷积, 计算一个二分类任务判断候选框里有没有东西
- 回归分支: 如果有东西, 需要做一个定位框的微调
-
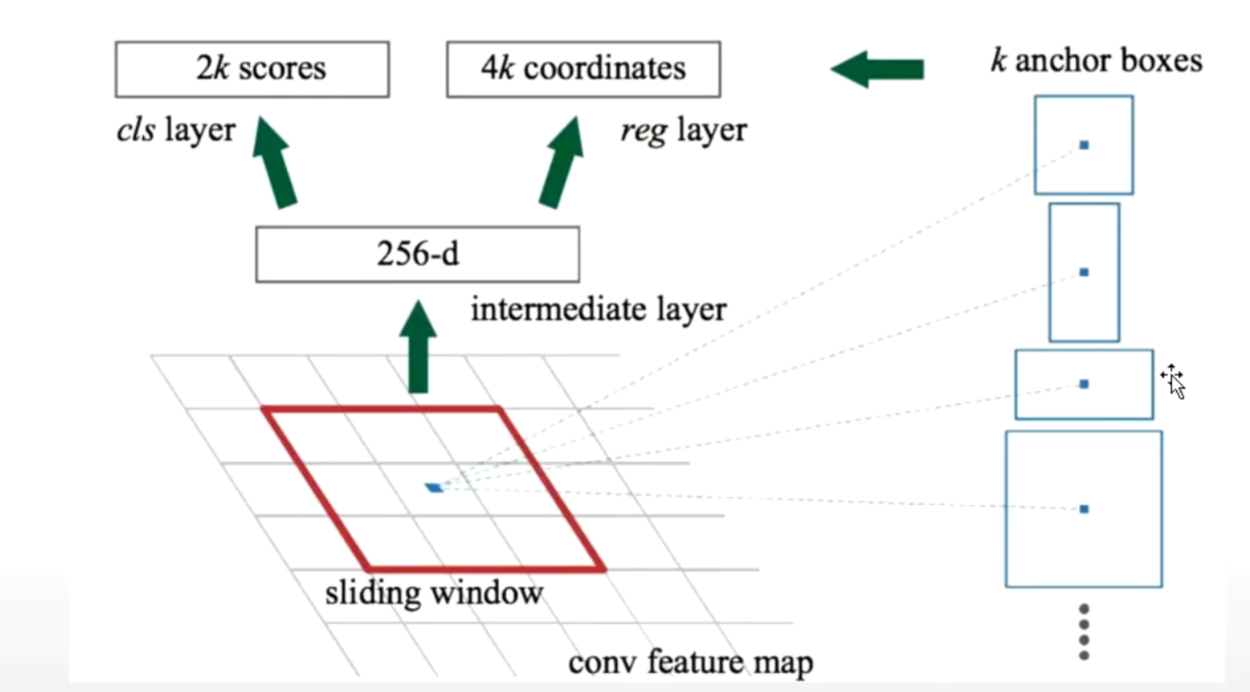
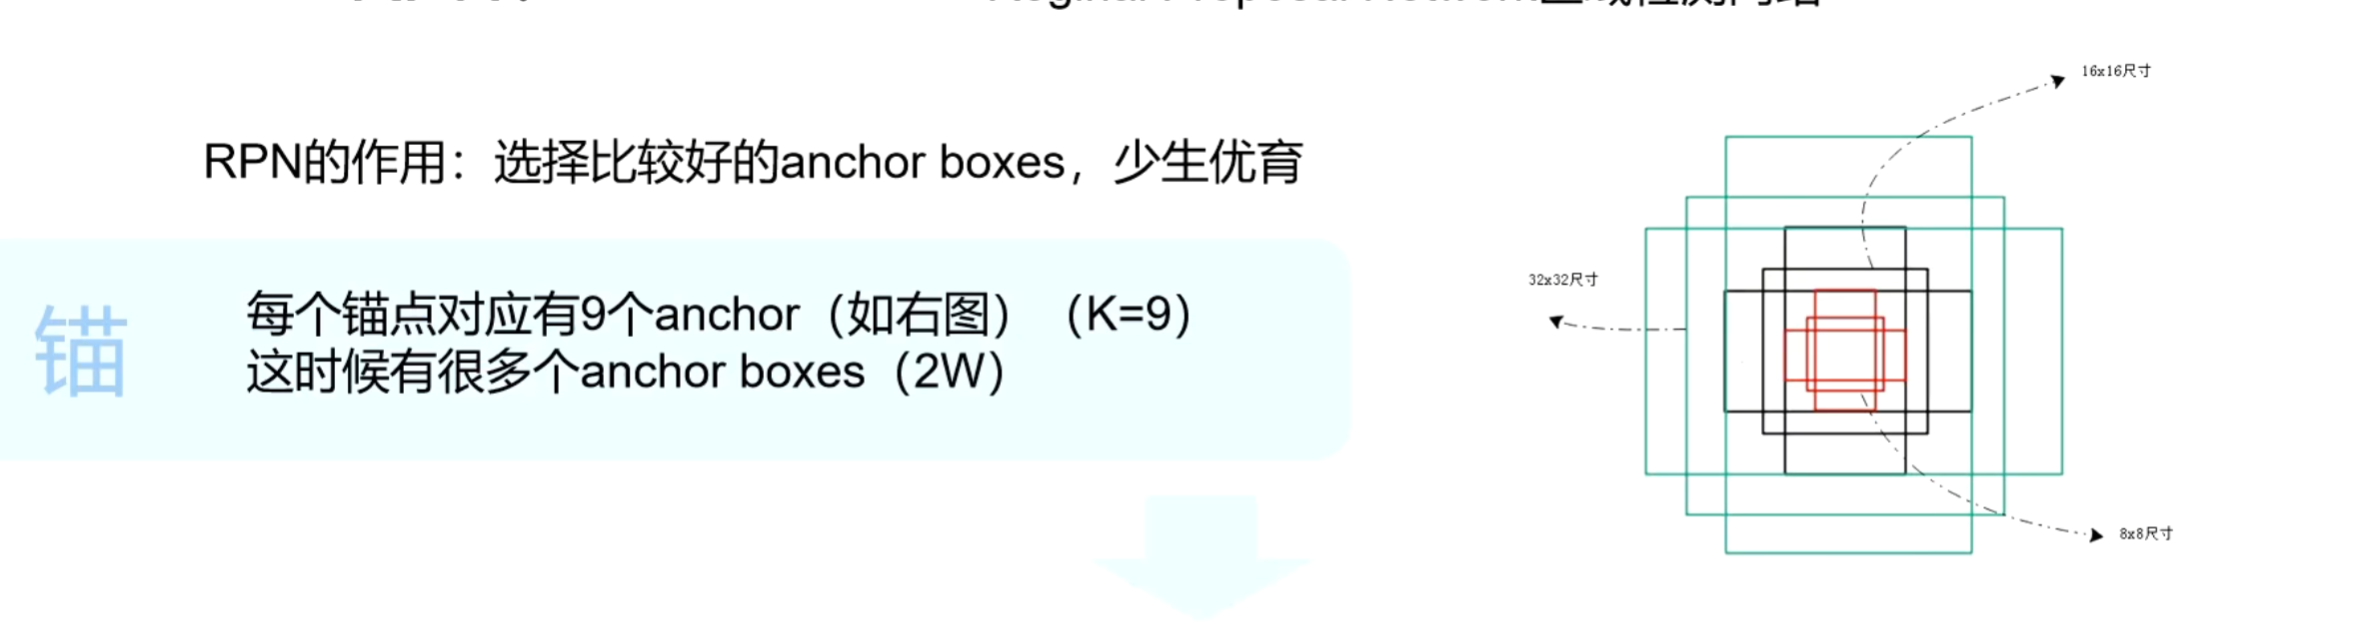
将原图的特征图经过一个 3*3 的卷积核, 每个滑动窗口的中心点为 anchor 的中心点, 在原图中框出多个不同尺度, 长宽比的 anchors (尺度: 128, 256, 512; 长宽比: 1:1, 1:2, 2:1).
-
RPN的预处理
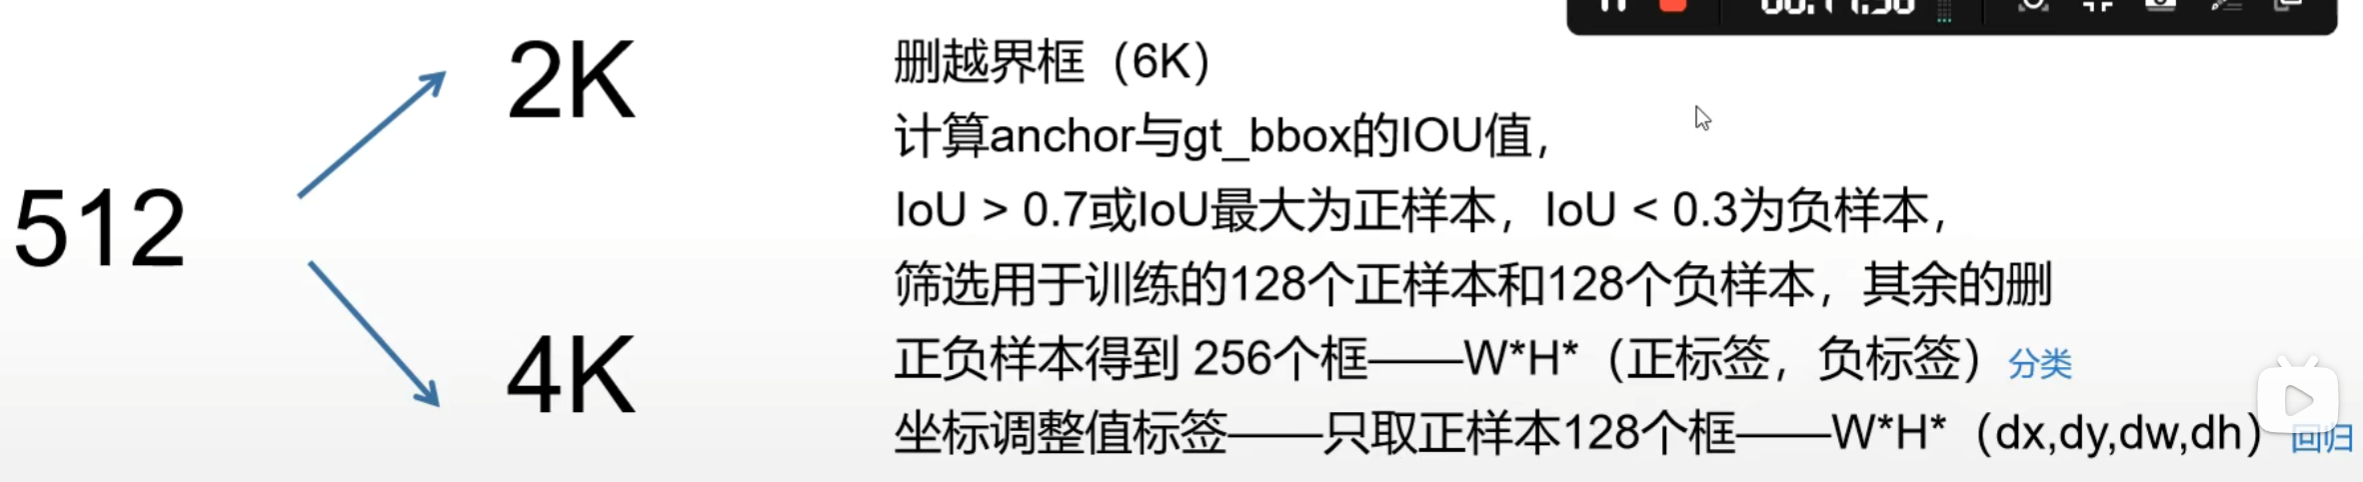
-
-
优点:
- 提出了RPN网络, 提升了性能, 并使得整体变为一个端到端的网络
-
缺点:
- 训练参数过大 (候选区域过多)
- 对于真实训练使用来说还是性能不够
5.5. YOLO
膜拜!YOLO目标检测竟被讲的如此简单!(完整版)YOLOv1-v8,草履虫都能听懂!这么好的课程还没人看?我不更了!!!_哔哩哔哩_bilibili
YOLO速度快, 可以用于实施检测任务; 但是相对的 mAP 会降低.
5.5.1. YOLOv1
-
YOLO 的结构
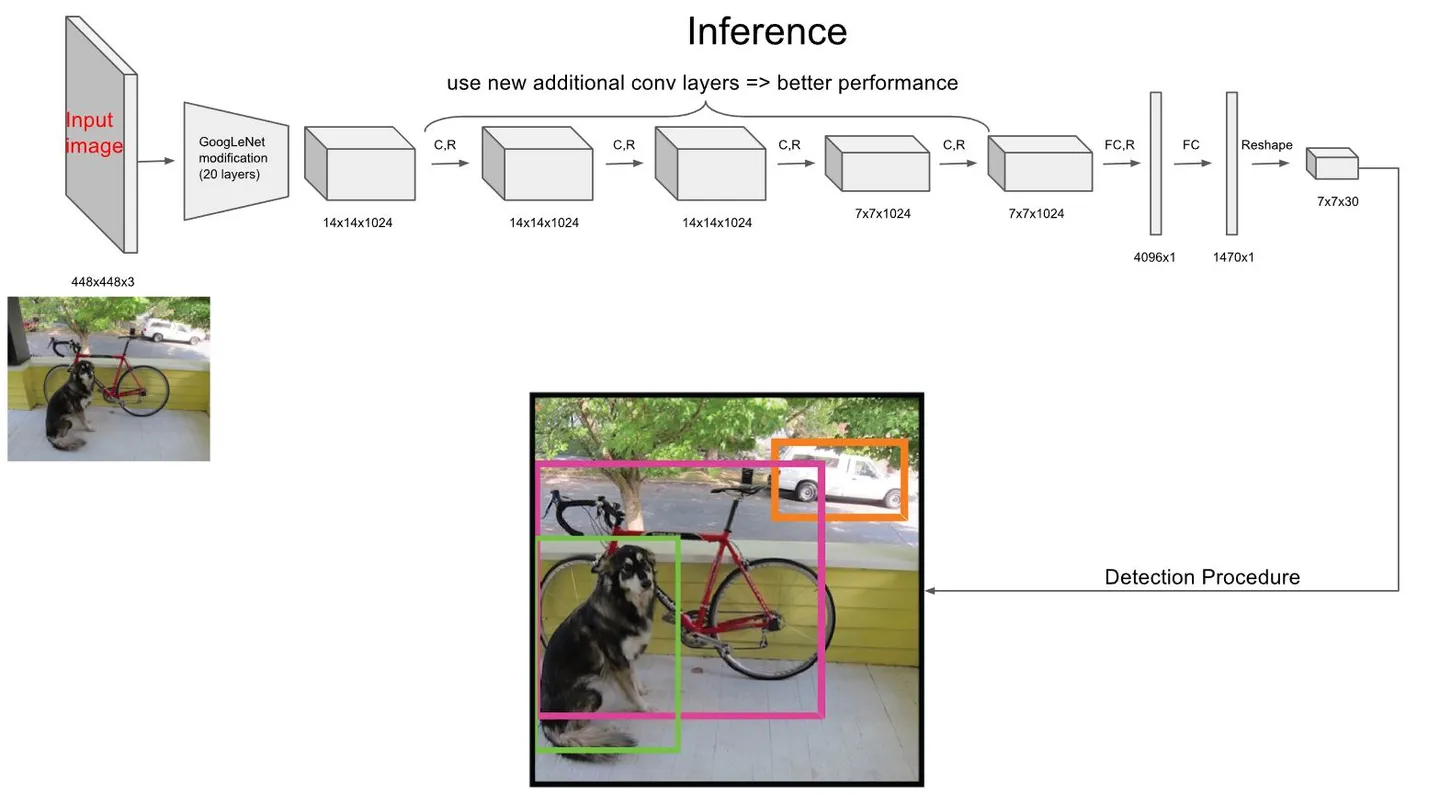
GoogleNet + CNN x 4 + FC x 2, 是端到端的结构
训练时, 图片输入尺寸为 $224*224*3$; 推理时为 $448*448*3$
-
为什么输入图片的尺寸是固定的?
因为 YOLO 网络中卷积直接接上了全连接层, 不像 Faster-RCNN 那样有 ROI 池化. 全连接层的输入尺寸是固定的, 导致网络的输入尺寸也只能固定了.
-
-
YOLO 训练流程
-
将输入图片尺寸 resize 到 $448*448$, 经过卷积 ($7*7*1024$) + 全连接 ($1470*1$) 网络之后 reshape 为 $7*7*30$ 的特征图.
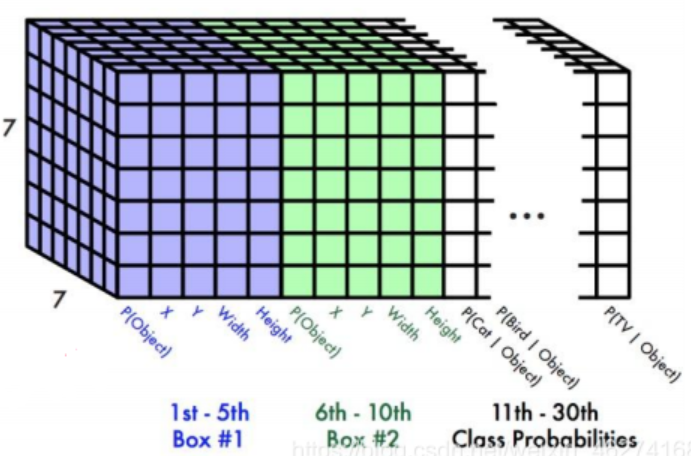
- 每个 $7*7$ 的特征图, 有 $49$ 个像素点
- 每个像素点都对应原图的一个正方形区域 (类似于感受野, 这里被称作单元格 (Grid cell)).
- 每个单元格默认预测 $2$ 个 Bounding box (bbox) 的置信度. 所以一张特征图有 $7*7*2=98$ 个 bbox. 训练时, 只使用置信度高的那个 bbox; 推理时, 使用 NMS 过滤掉置信度低的 bbox, 再分类 或者 先用阈值过滤一批置信度低的 bbox, 再分类别地对置信度进行 NMS (YOLO 源码). 但由于不同类别的 bbox 重叠度不会太高, 所以两种方法效果不会差太多. URL
-
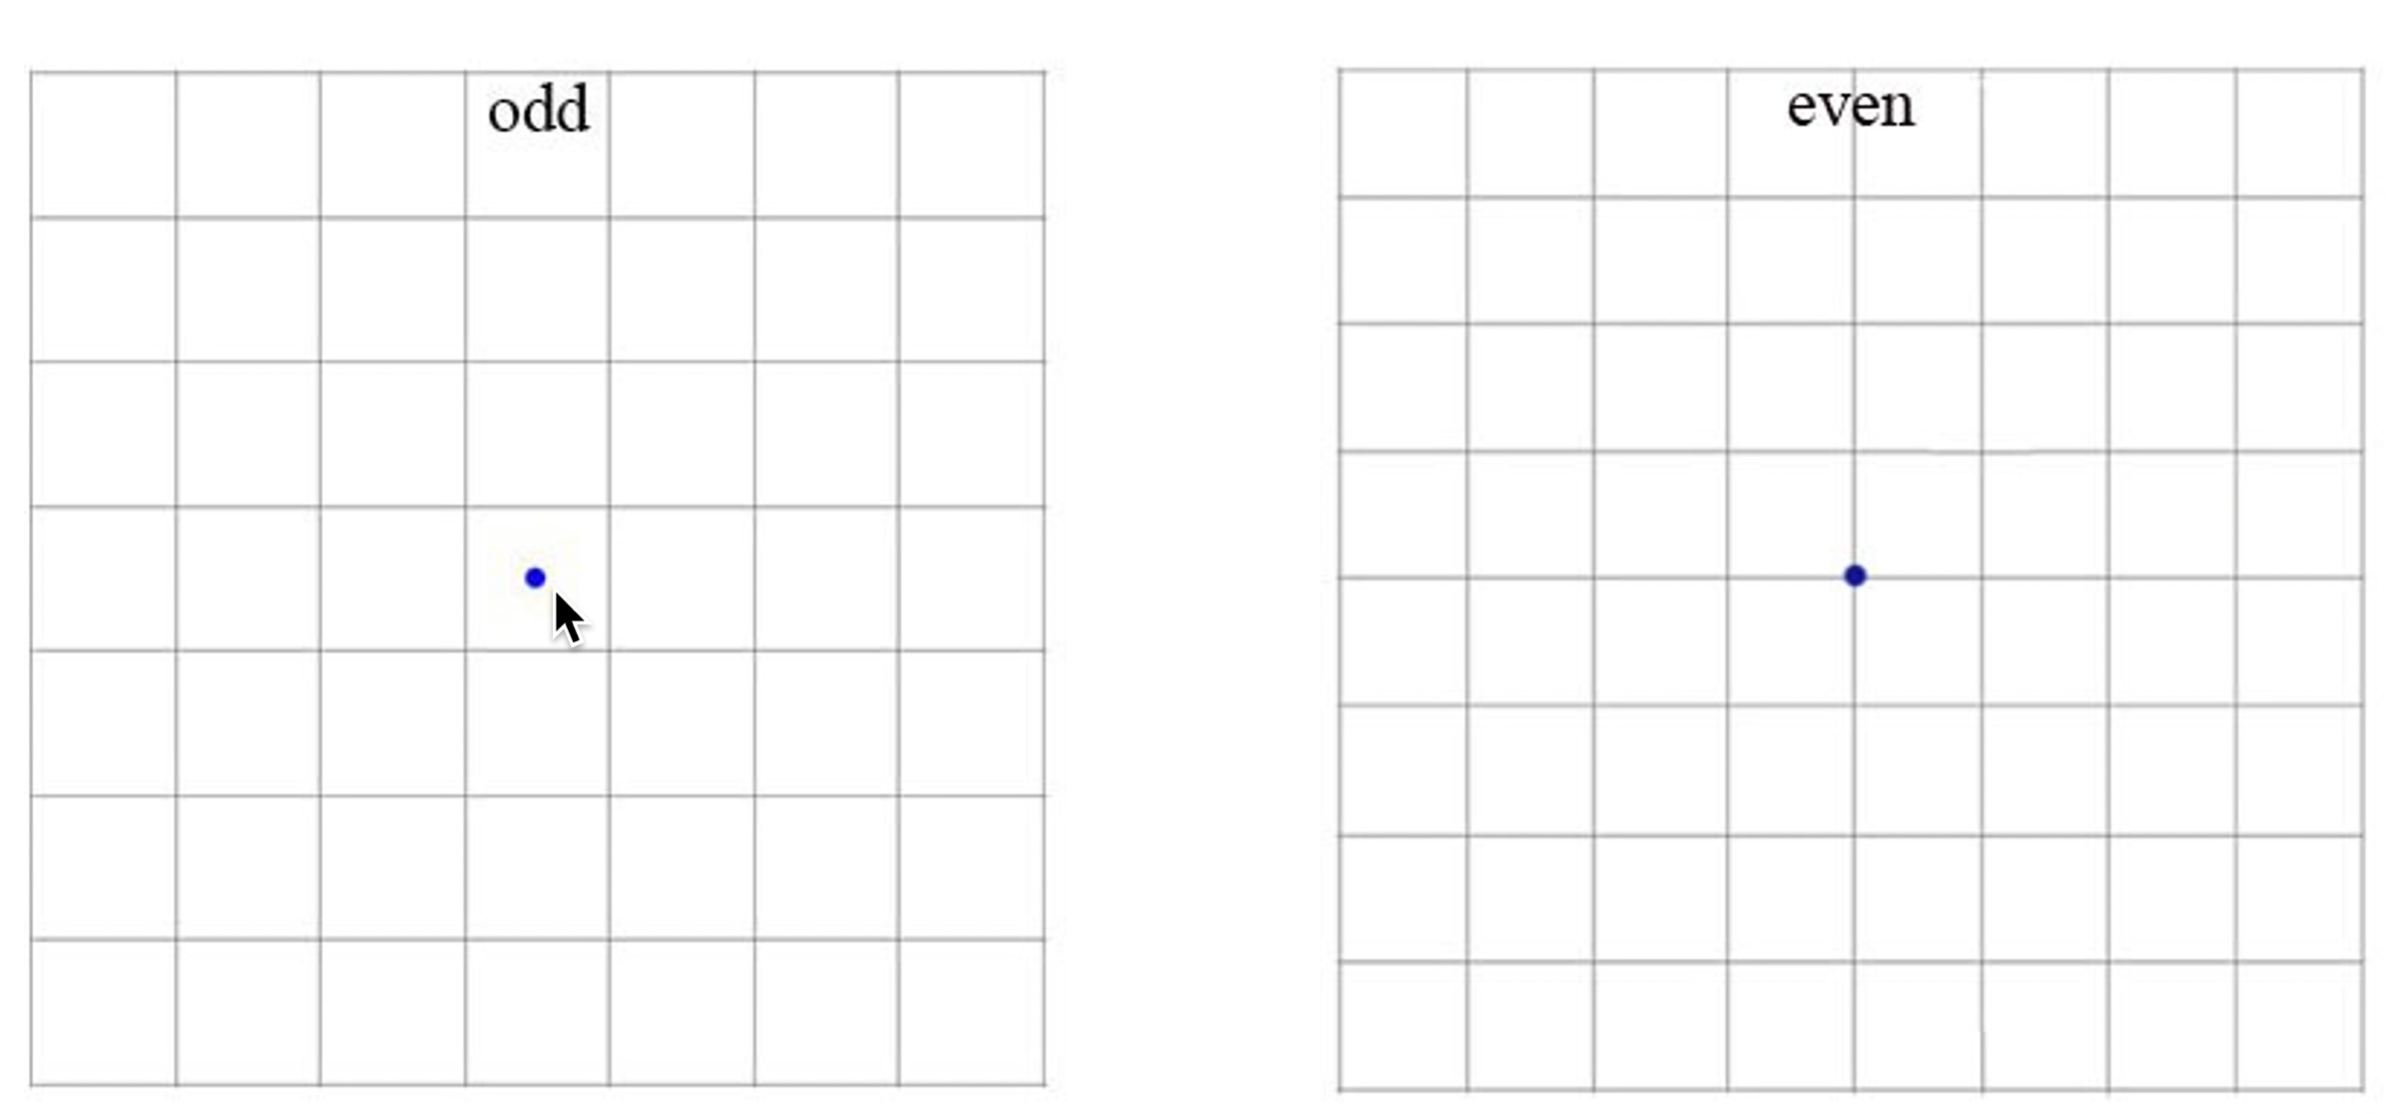
为什么特征图尺寸是奇数?
因为一般情况下, 照片的中心会有一个物体作为主体, 所以中心有一个 Gird cell 能提高精度.
-
bbox 的置信度
- 如果判断单元格中没有物体, 置信度为 0
- 如果判断单元格中有物体, 则置信度等于预测的 box 与 gt 的 IOU
- 如何判断单元格中有没有物体?
- 如果 gt 框的中心点在该单元格内, 则这个单元格包含物体
- 反之则不包含物体
-
- 每个 bbox 的参数:
-
位置参数: $x,y,w,h$ ($x,y$ 为 bbox 中心相对于单元格中心的偏移量, $w,h$ 为 bbox 的宽高相对整张图片的占比)
$$ x=\frac{x_c}{w_i} S-x_{c o l}, y=\frac{y_c}{h_i} S-y_{\text {row }} \quad w=\frac{w_b}{w_i}, h=\frac{h_b}{h_i} $$ -
置信度: $c$
-
- 30 又代表什么?
- $30$ 代表参数: $2*(4+1)+20$ (2 个bbox, bbox 的参数有 $5$ 个, 加上 $20$ 个分类在这个单元格上的概率)
- 每个 $7*7$ 的特征图, 有 $49$ 个像素点
-
于是每个单元格输出一个置信度高的 bbox 位置, 并选择一个概率大的类别.
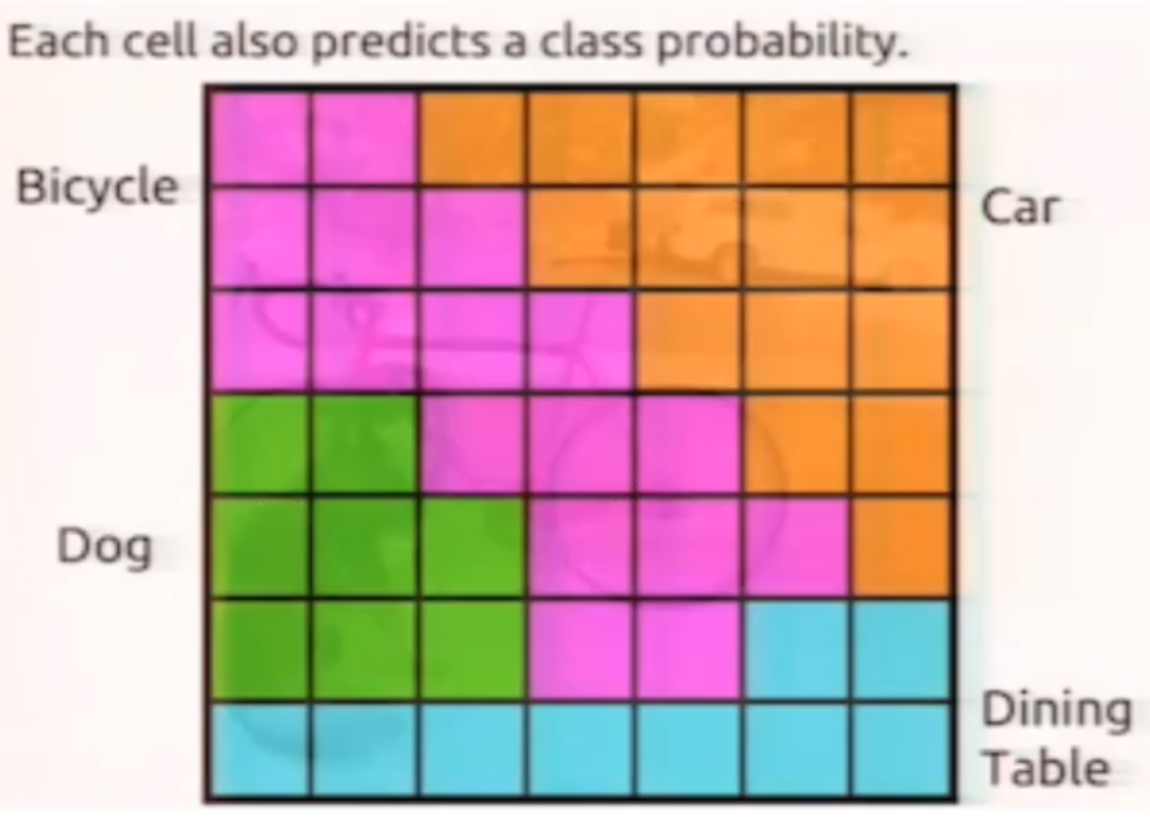
-
训练时预测框对应的目标标记 (GT) 怎么生成? Loss 是什么?
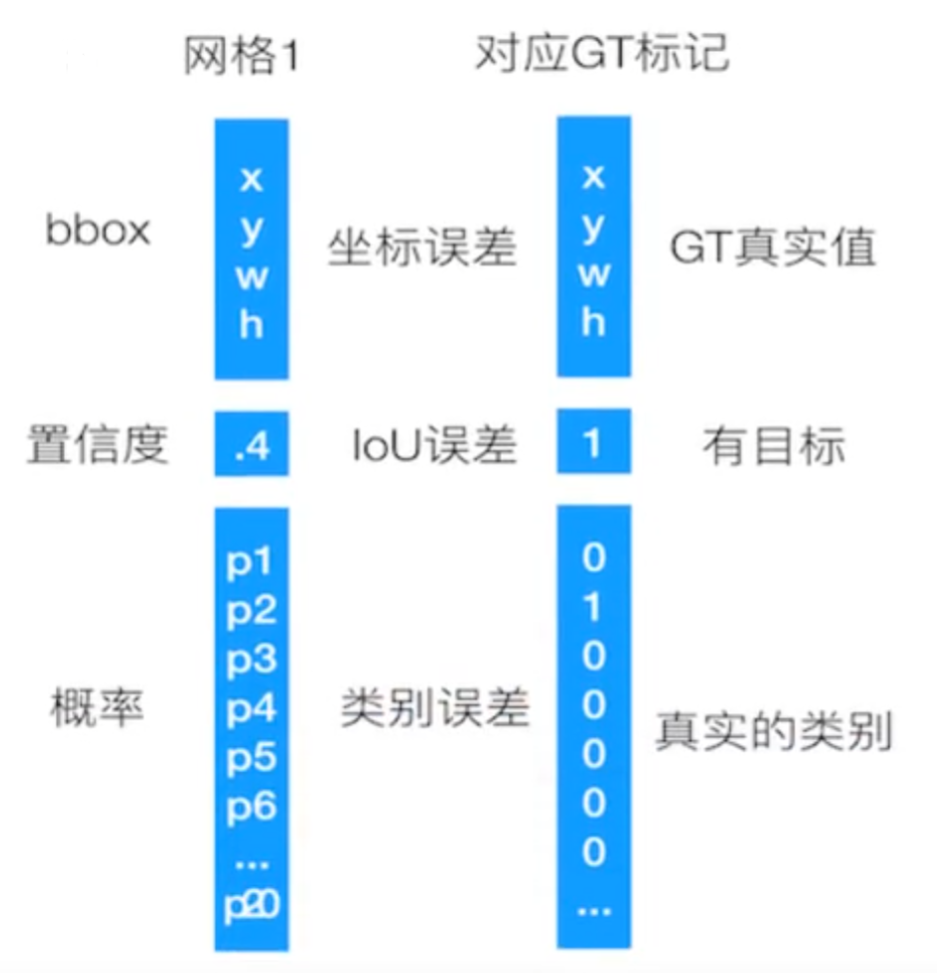
-
损失
总损失 = bbox Loss + 置信度 Loss + 分类 Loss; 用的都是预测值和 GT 值差的平方.
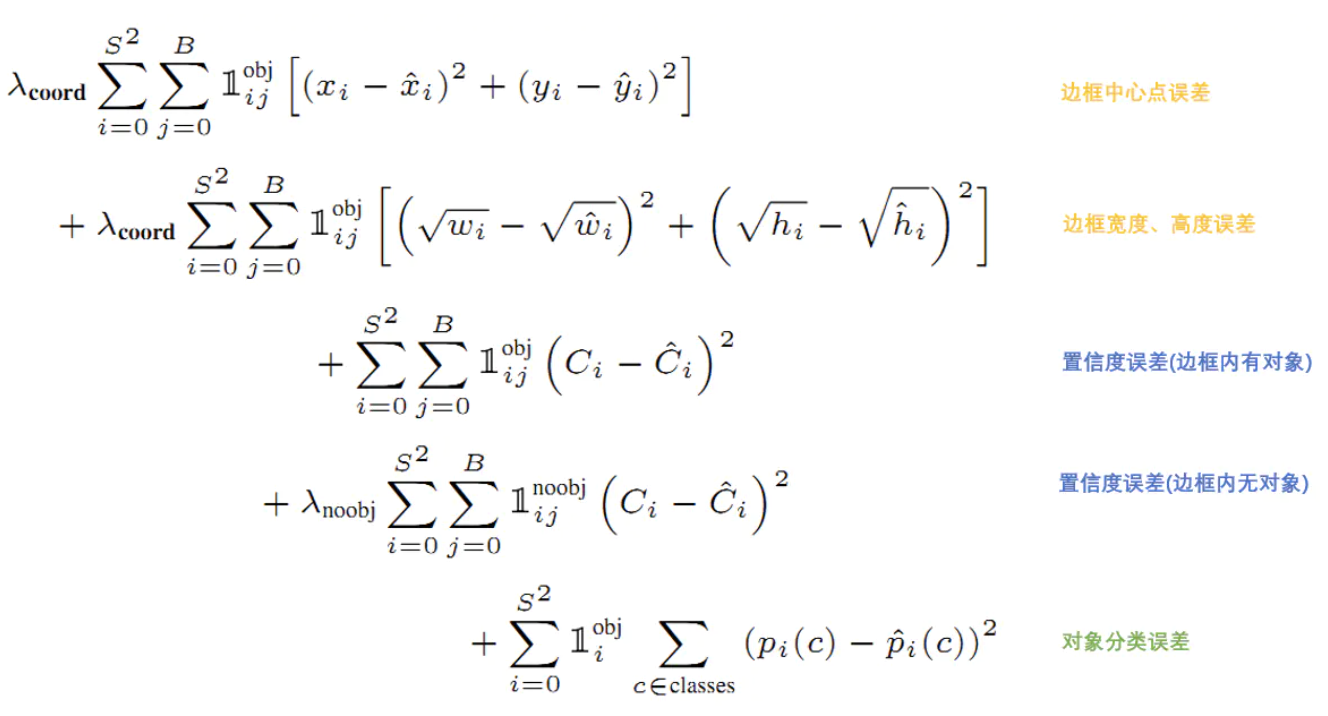
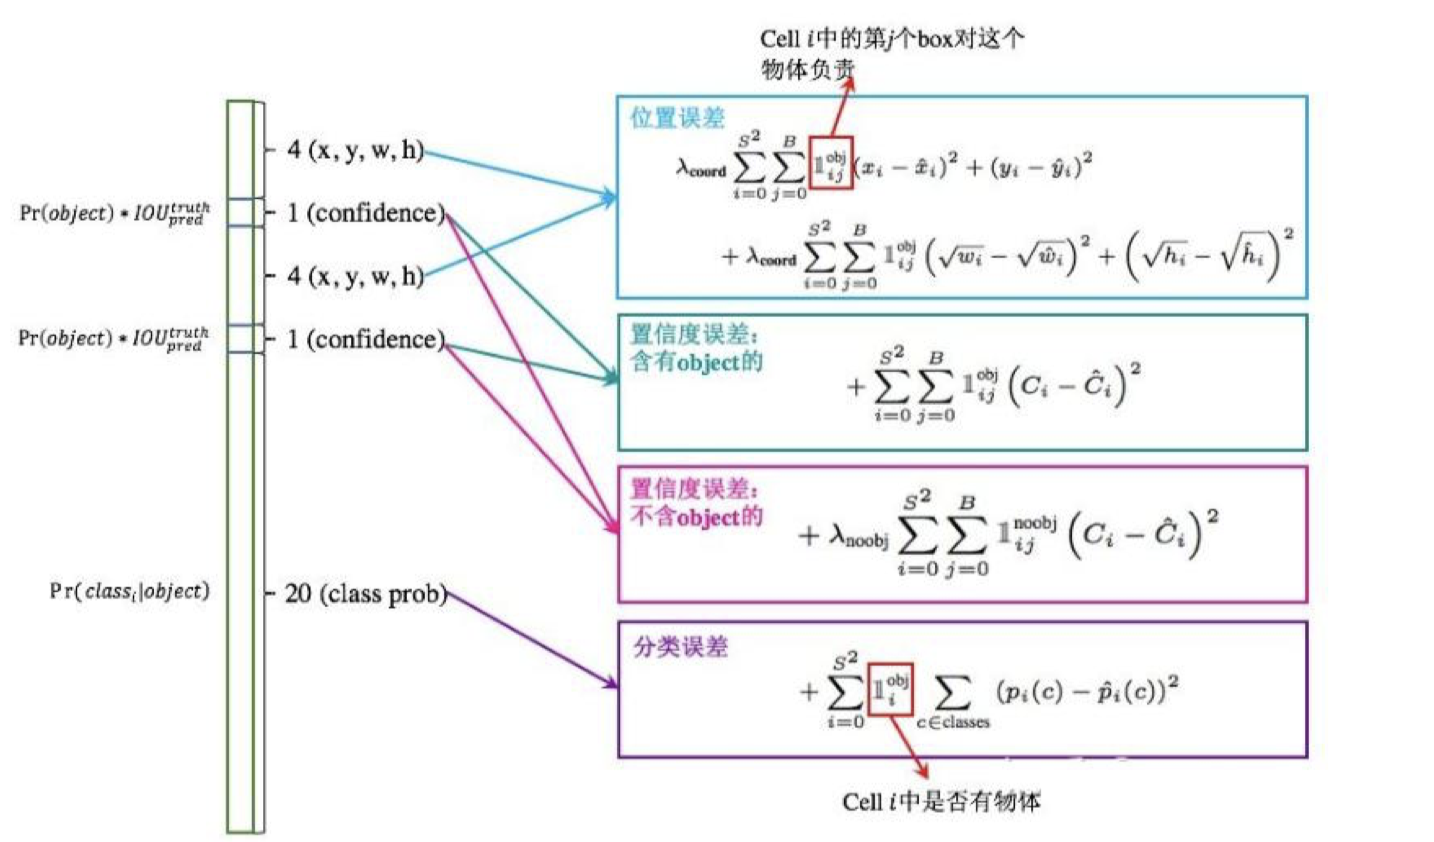
- 最后一个分类误差: GT 标签标注的物体概率为 1, 其他为 0; 预测出来的结果所有类别都是浮点数.
-
-
-
优点
- 速度快
-
缺点
-
准确率降低
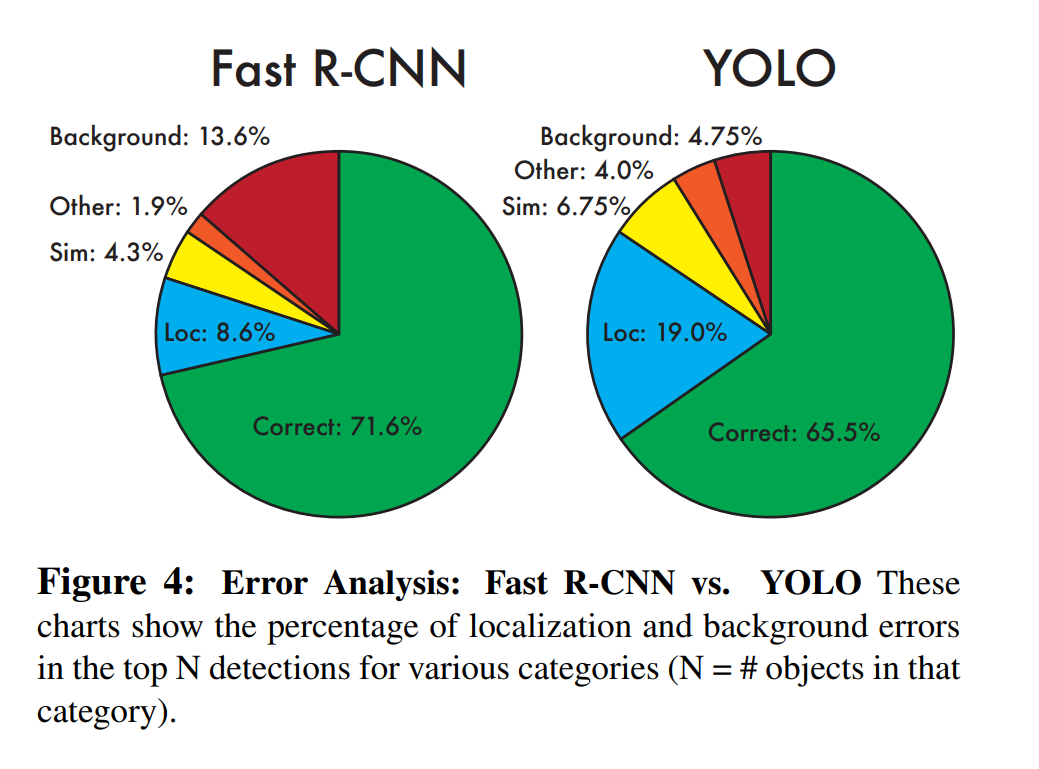
-
对于靠得很近的物体 (重点都在同一个单元格上), 和小目标检测效果都不好, 因为一个单元格只预测两个框.
-
5.5.2. YOLOv2
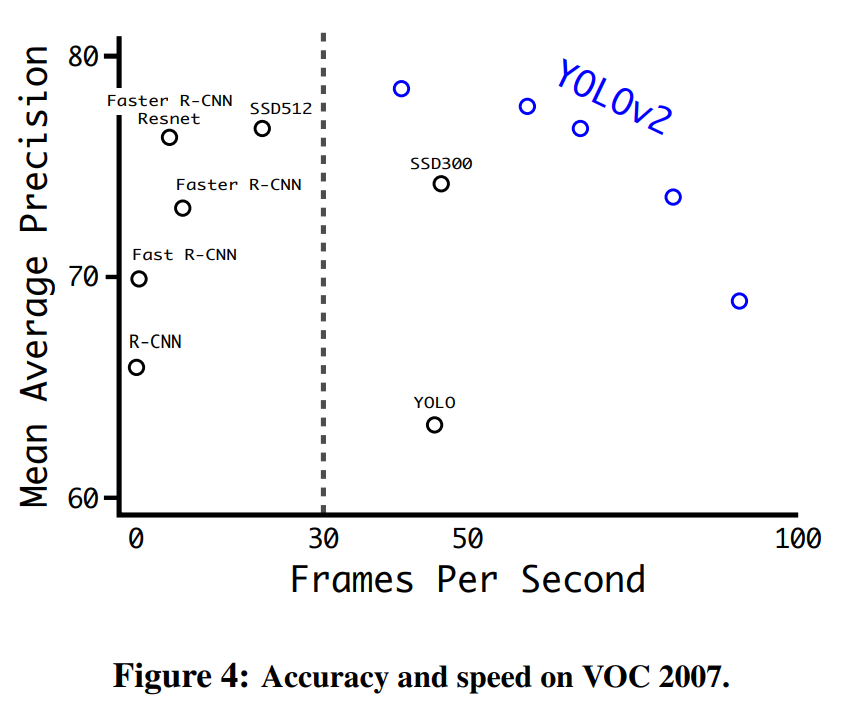
YOLOv2 性能精度与其他模型的对比图, 这里的 YOLOv2 的输入使用了不同尺寸的图片 (正方形).
大尺寸图片精度高速度慢; 小尺寸图片精度低速度快.
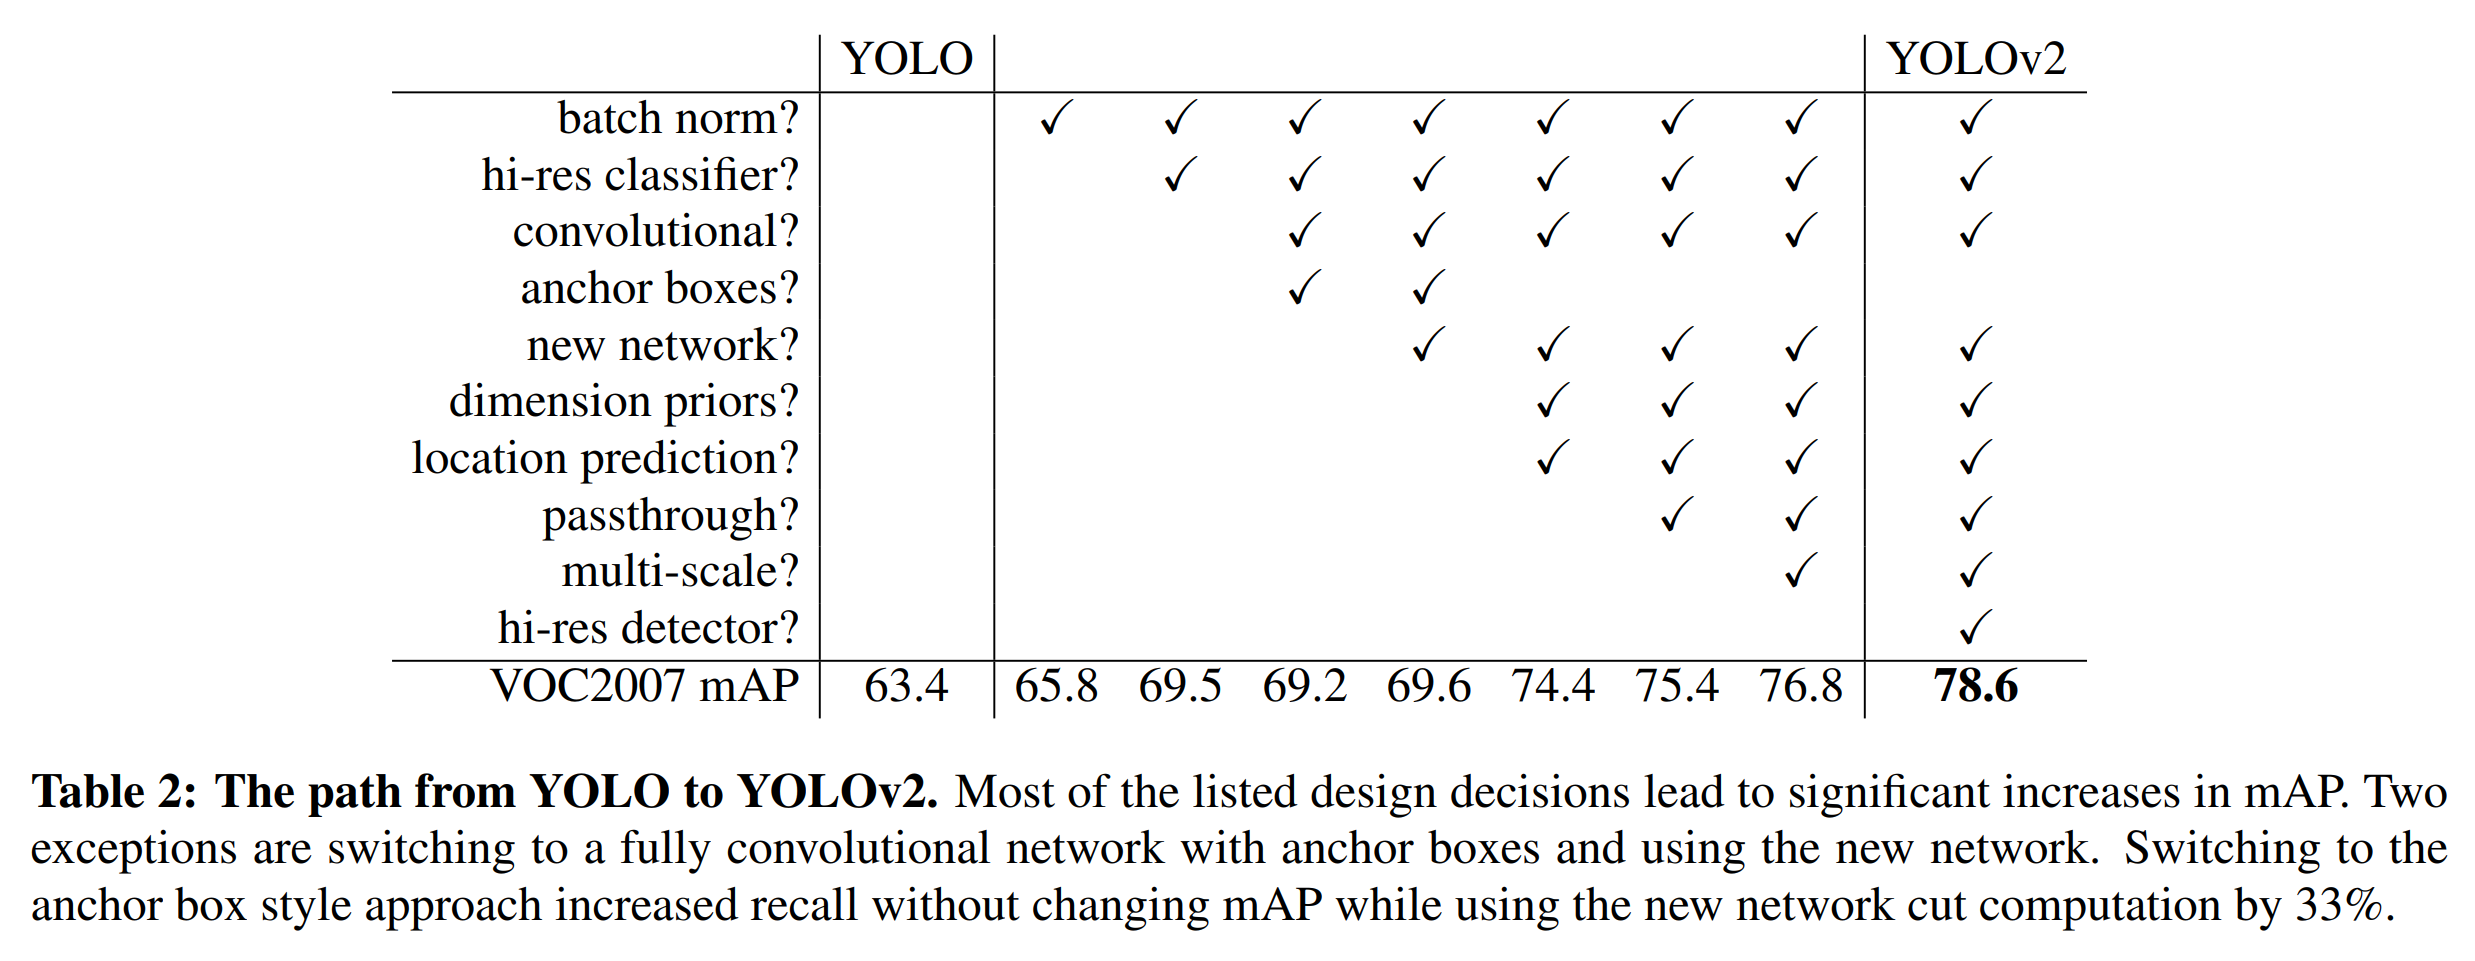
YOLOv2 对 YOLOv1 的一些小细节做了改进如下图
-
Batch Normalization
- 在卷积层后全都加上了 Batch Normalization 做归一化, 使得训练时收敛相对更容易. 并且去掉了 Dropout
- YOLOv1 并没有使用 BN
- BN 是什么?
-
BN 就是将所有值都减去均值, 再除以标准差. 这样就可以将数据变为以 0 为中心, 1 为标准差的分布. 为什么这么做? 因为很多的激活函数如 Sigmoid 函数, tanh 函数都是以 0 附近为非饱和区的, 数值太大或太小都会进入饱和区, 容易导致梯度消失难以训练.
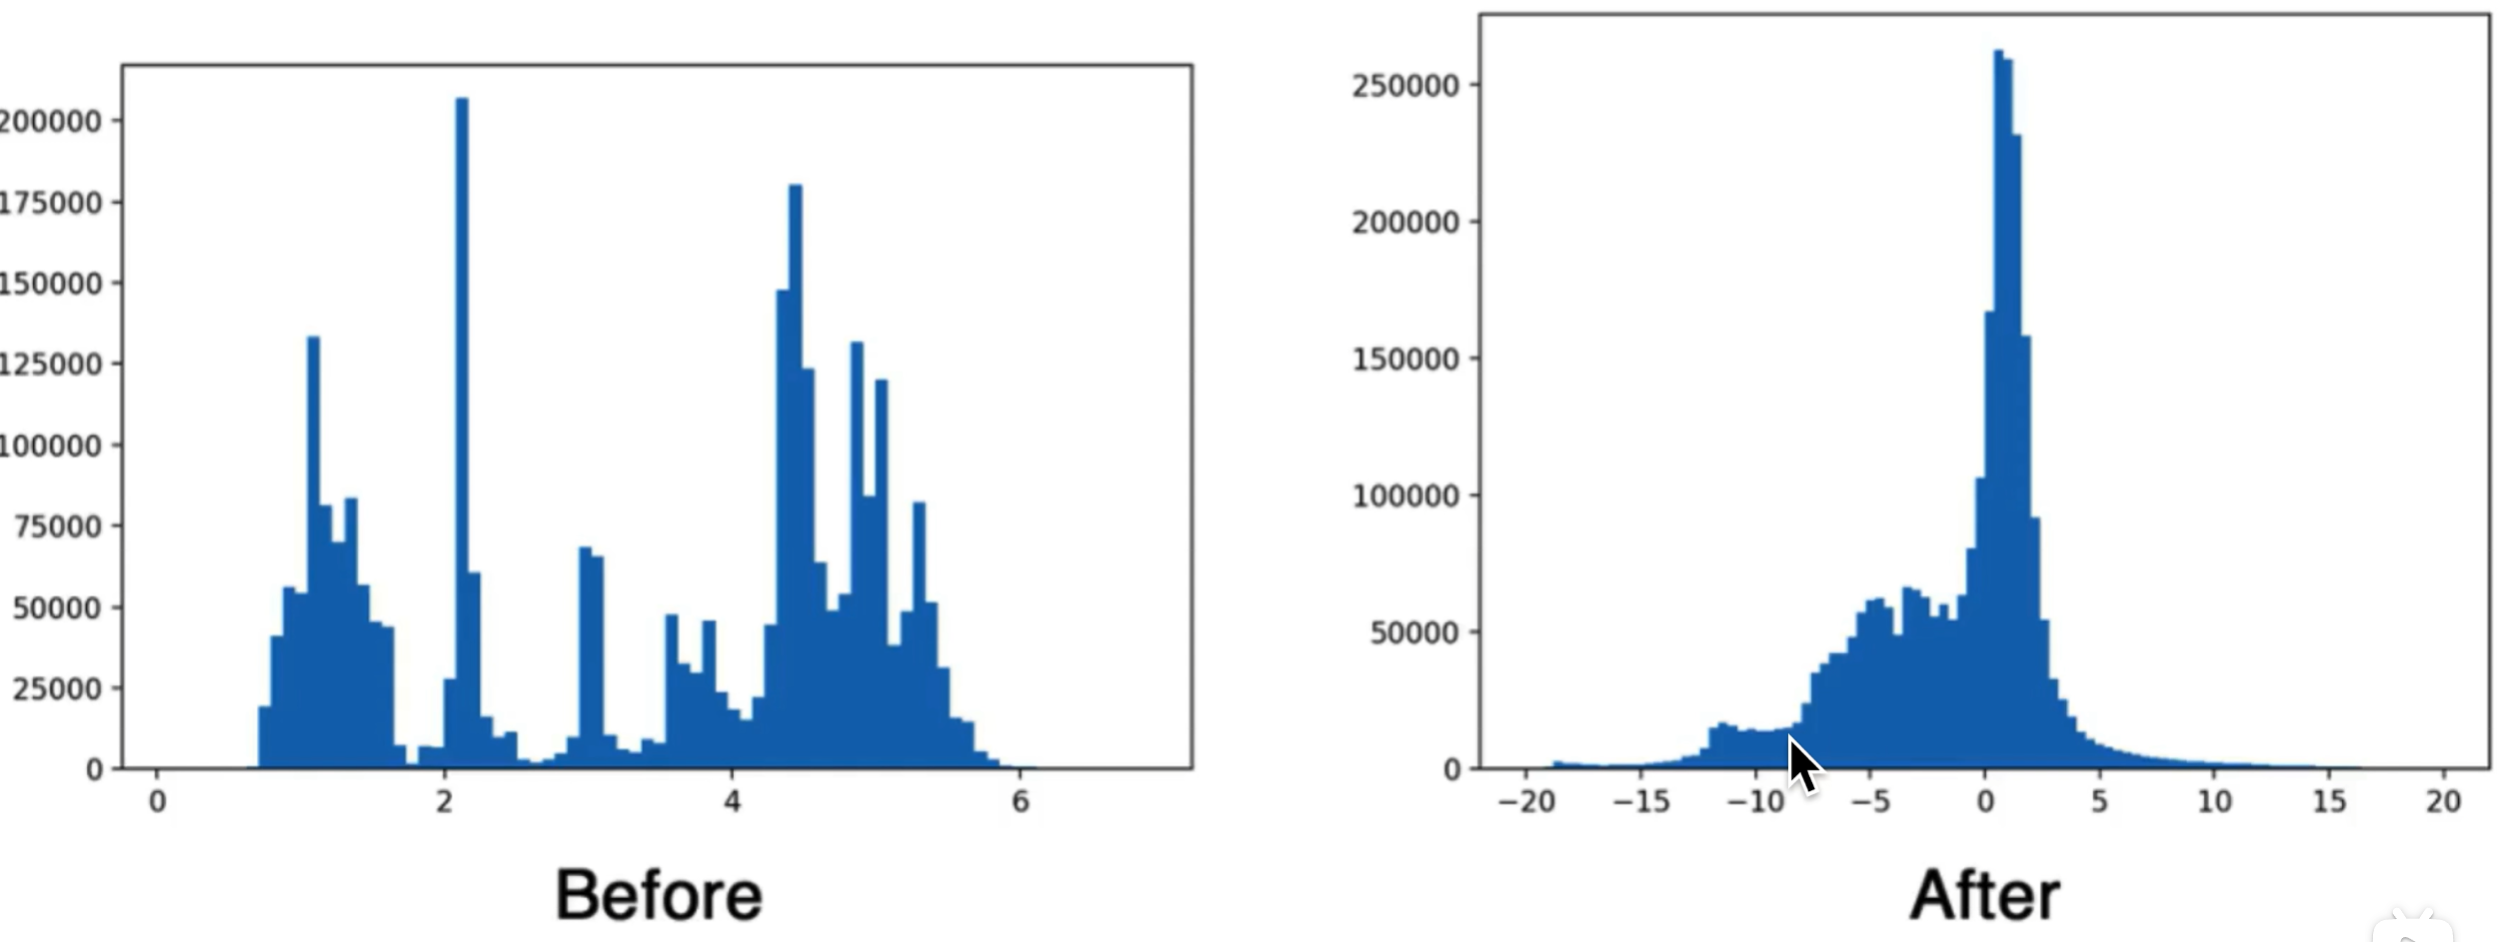
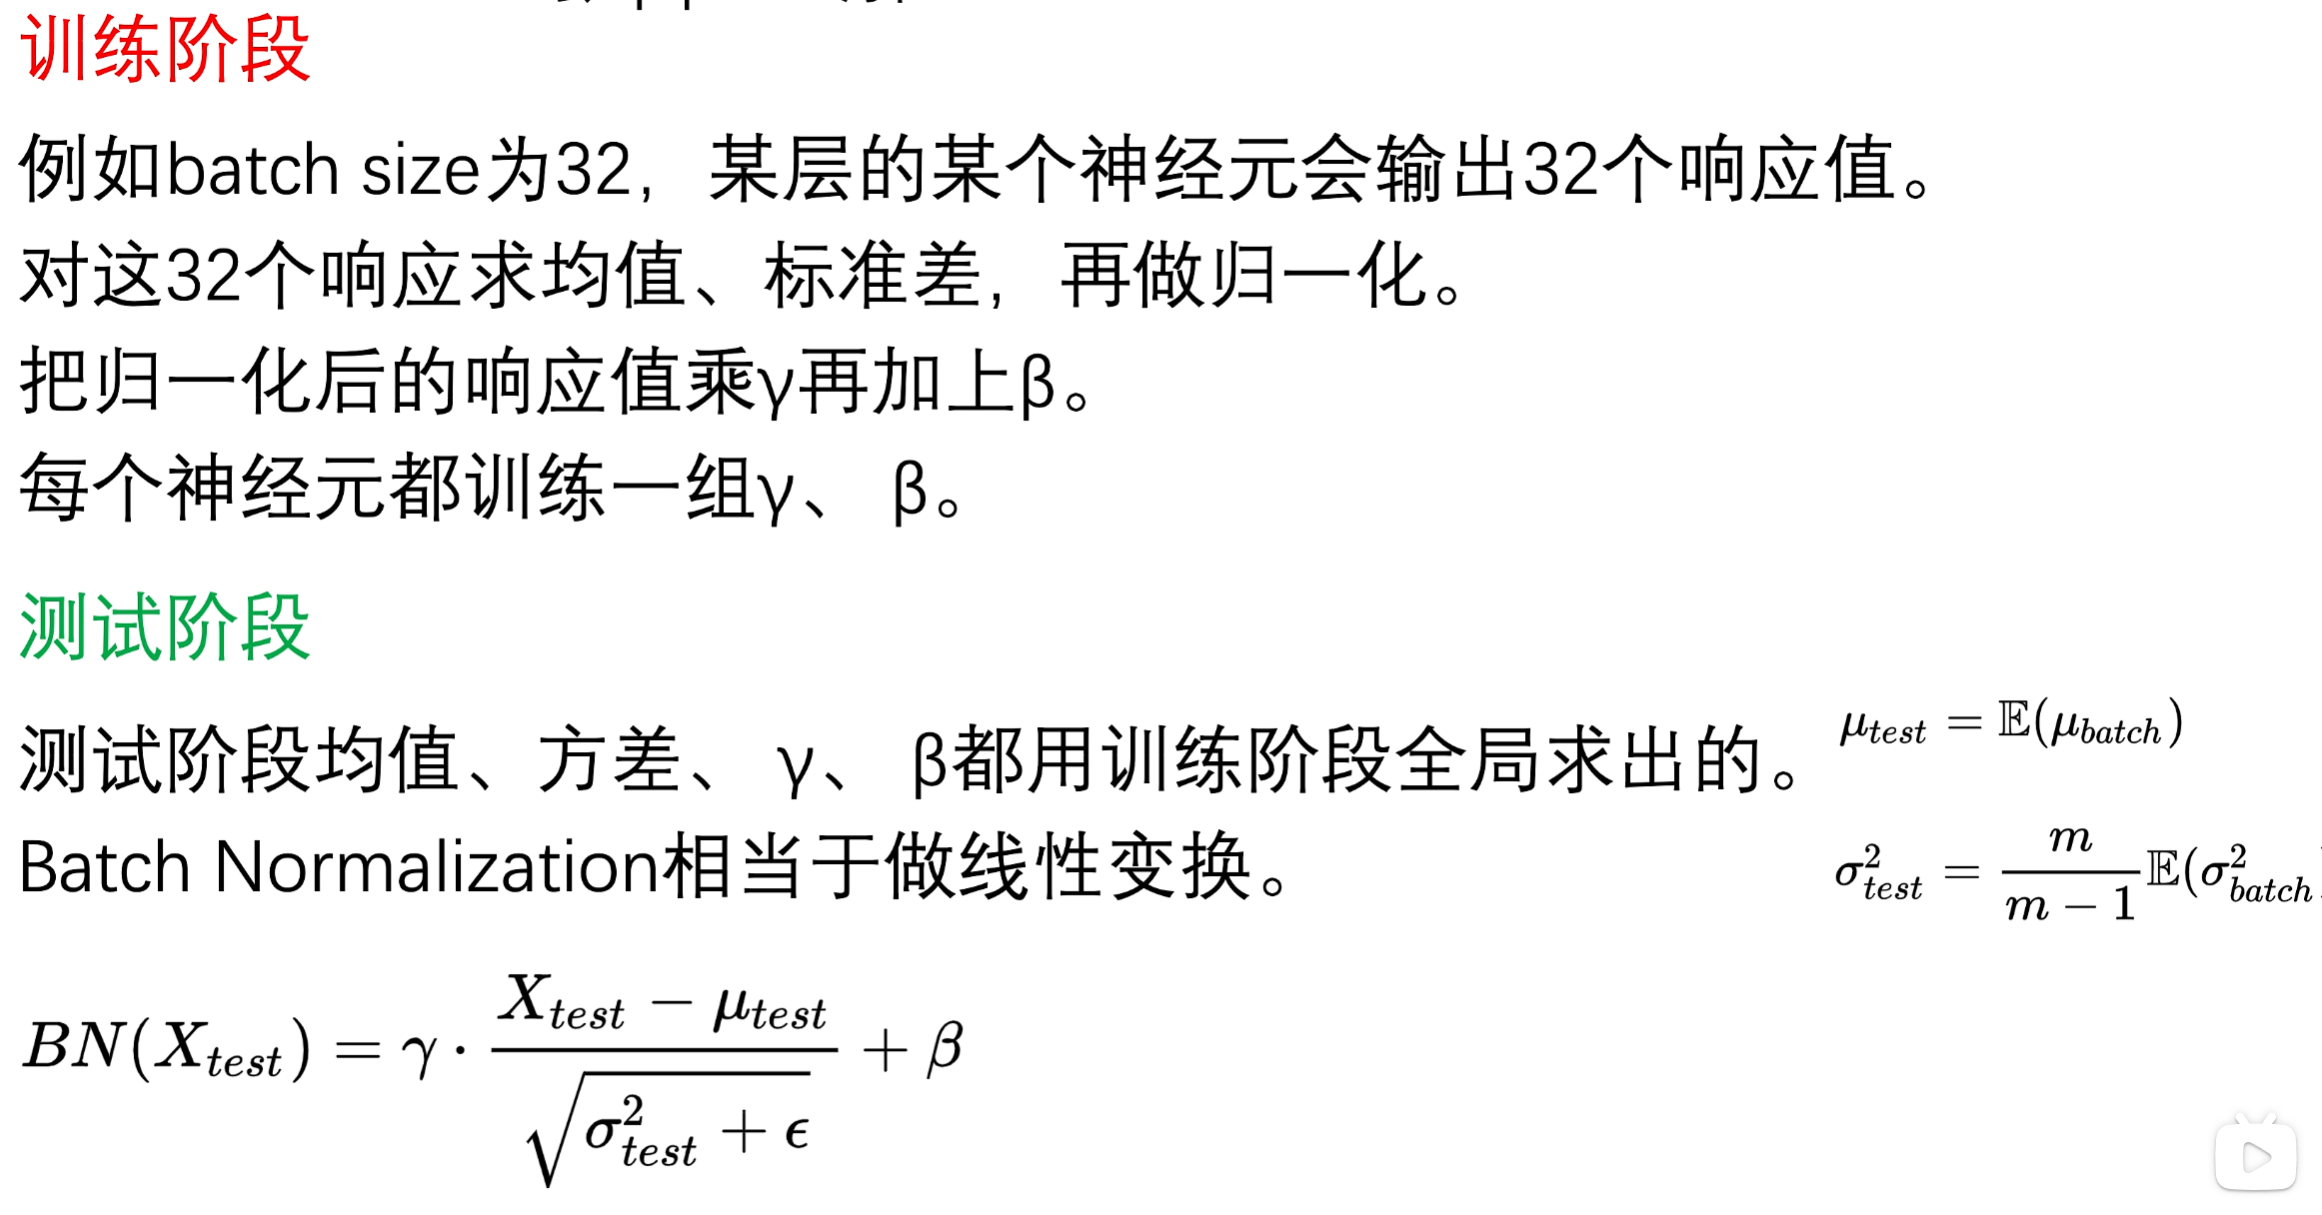
-
BN 的好处
- 加快模型收敛; 改善梯度(远离饱和区); 可以使用大的学习率; 对初始化不敏感; 有正则化的作用 (取代 Dropout)
-
- 结果: 使用 BN 层之后, 能够提升 2% mAP
-
更大分辨率 High Resolution Classifier
- v1 训练使用 $224*224*3$ 小分辨率图片, 推理使用 $416*416*3$ 大分辨率图片, 这样做可能导致模型水土不服
- v2 使用小分辨率图片后, 额外进行了 10 次大分辨率图片进行微调
- 结果: mAP 又提升约 4%
-
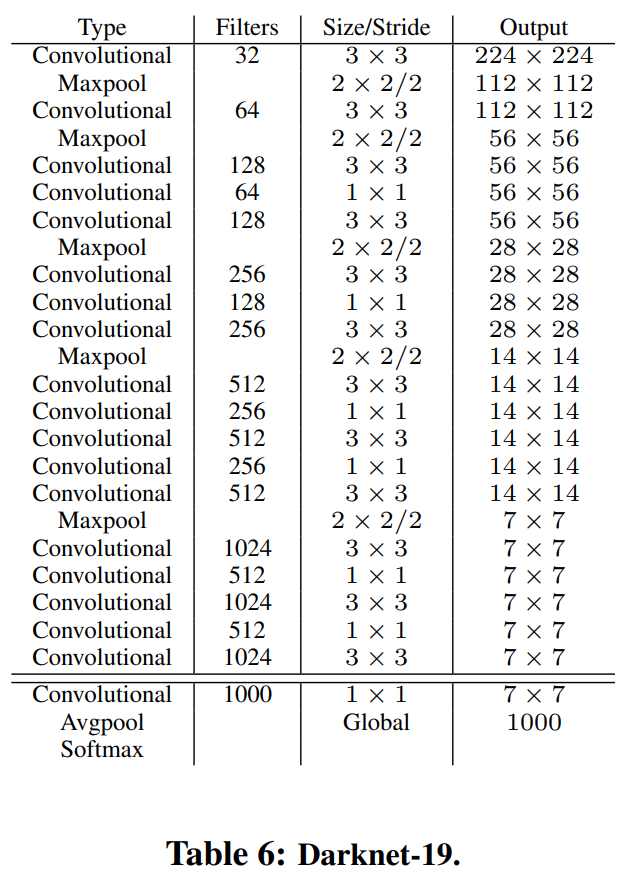
新的卷积网络结构 DarkNet-19
-
这个是分类模型结构图. 双横线以下的是分类模型独有的结构.
-
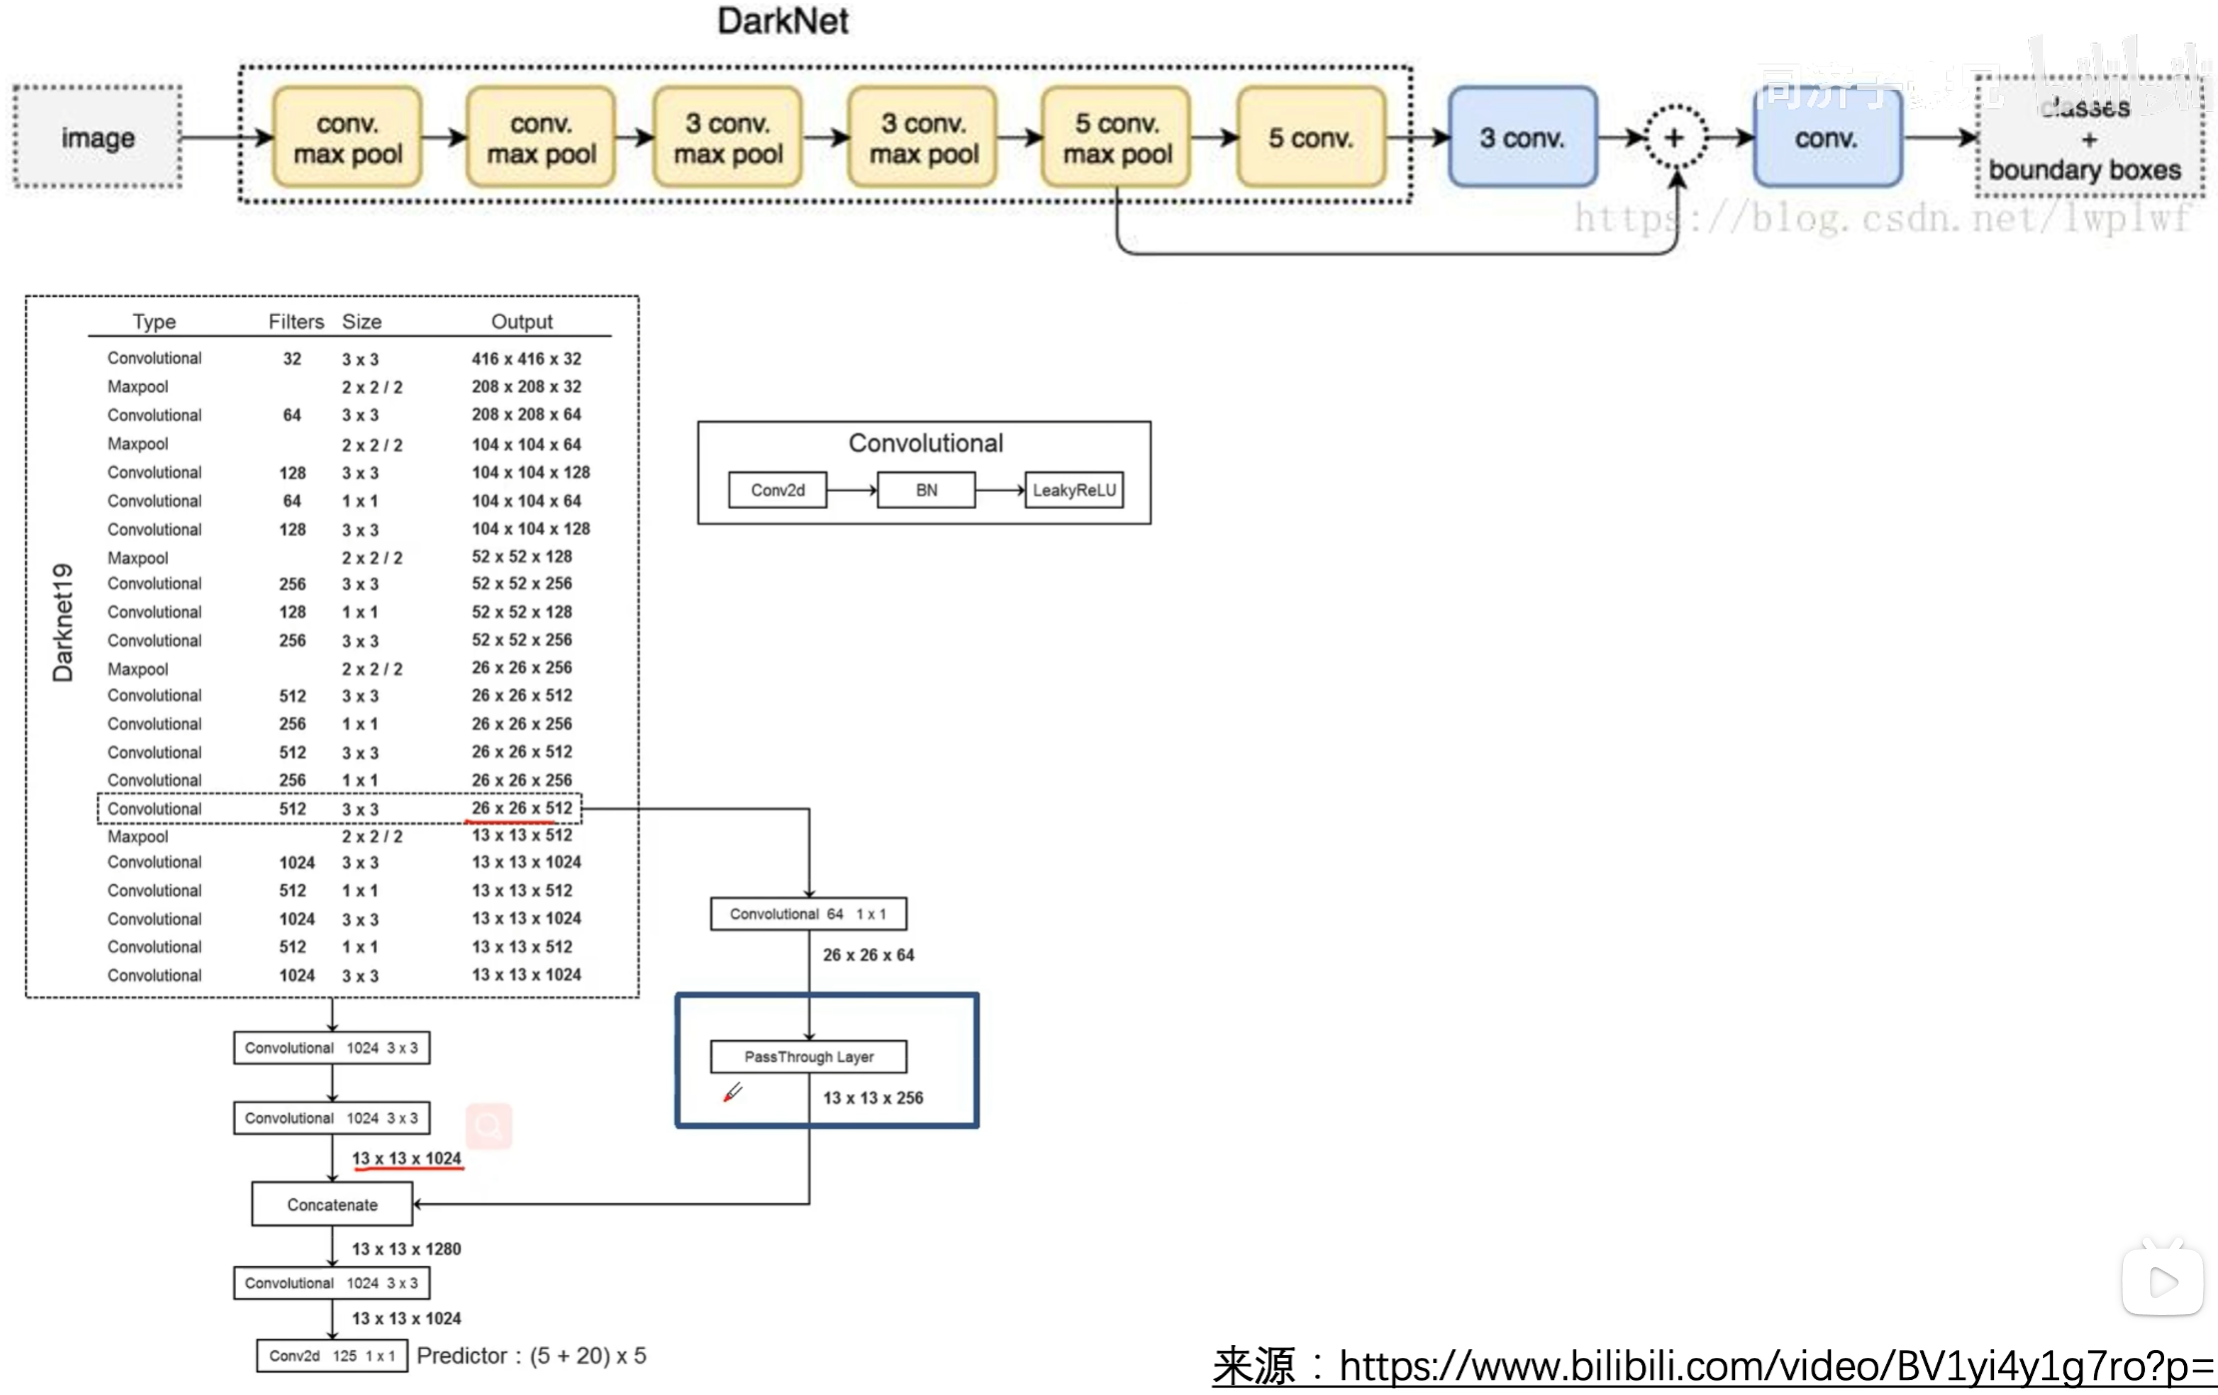
检测模型结构图, 虚线内的是 DarkNet, 外面的是检测模型独有的结构.
-
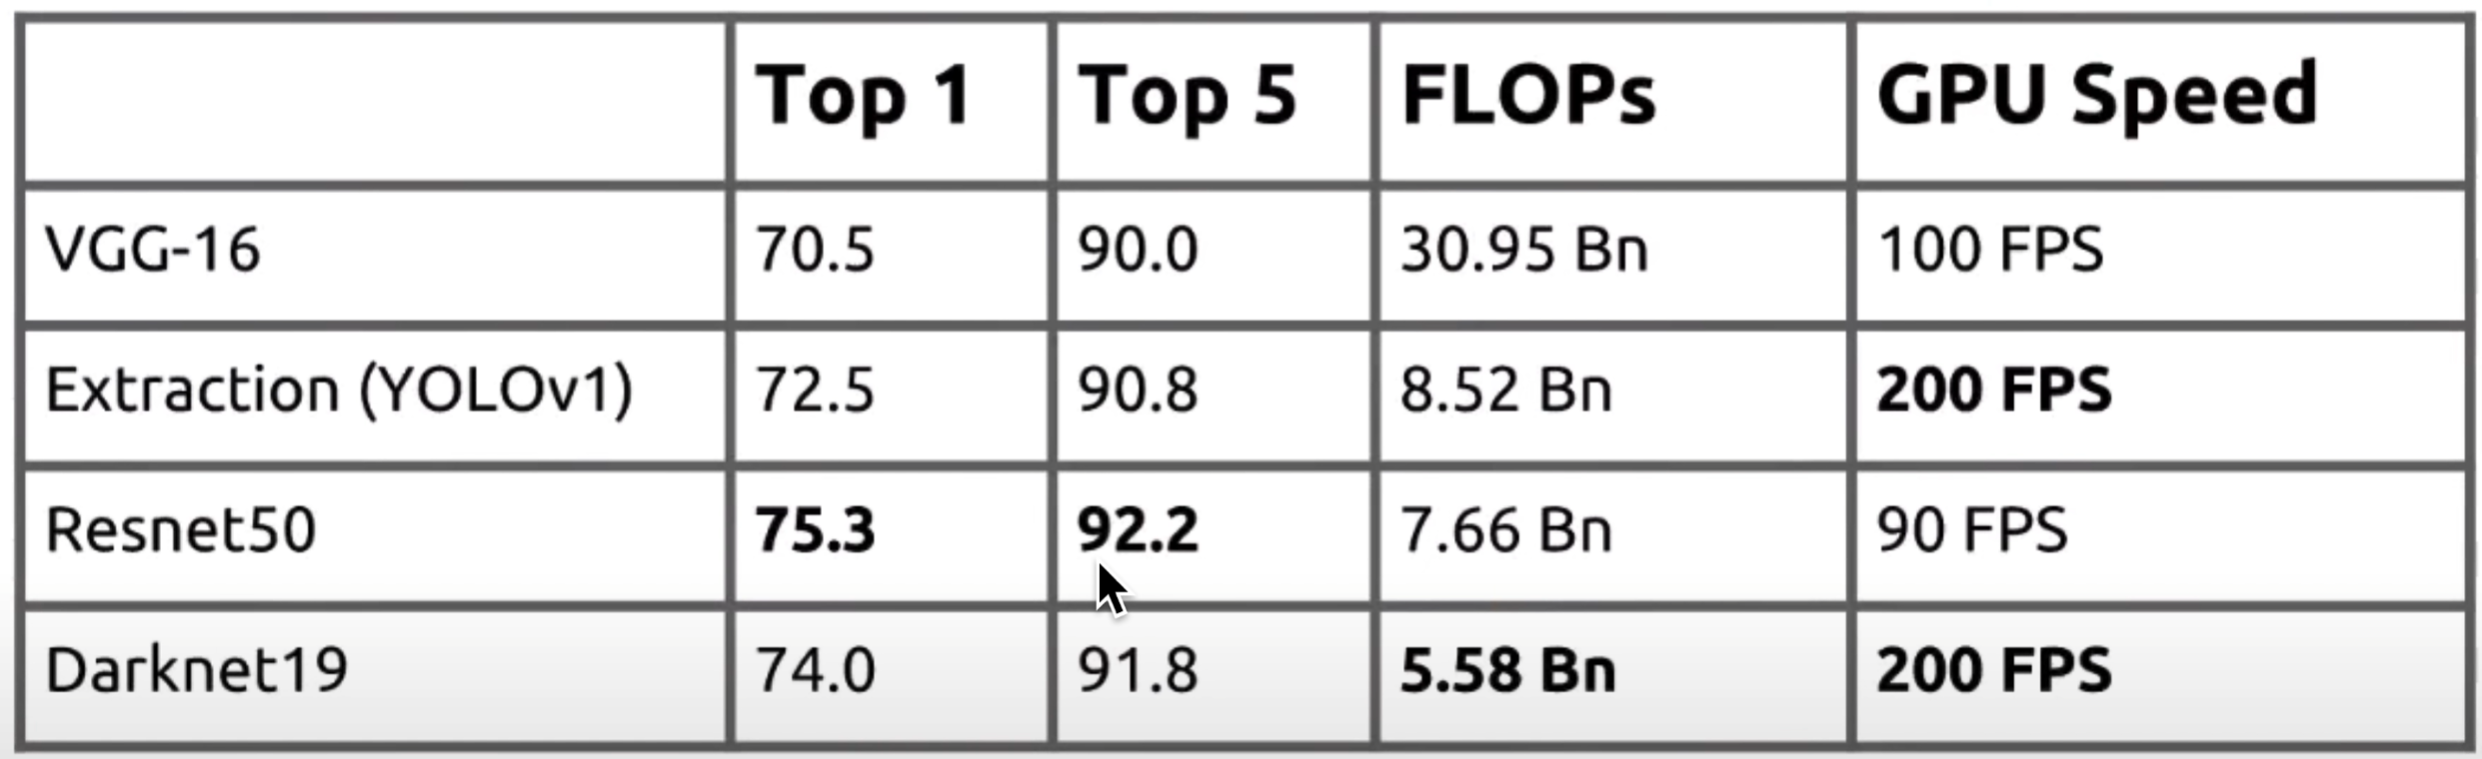
DarkNet 深度相对较浅, 所以速度较快, 同时精度较高
-
-
去掉了全连接层 (因为 FC 层参数多, 影响性能)
-
使用 5 次降采样, Max pooling 卷积尺寸 $2*2$, 步长 2, 所以总的步长为 $2^5=32$. 由于池化层的特性, 需要输入图片能被 32 整除, 所以 DarkNet 检测模型输入尺寸为 $416*416$. 这样最后池化得到的特征图尺寸为 $13*13$. (相比 YOLOv1 的 $7*7$ 特征图更大)
-
$3*3$ 卷积之间使用了 $1*1$ 卷积
- $1*1$ 卷积是什么? 作用是什么?
-
如果 $1*1$ 卷积的卷积核个数小于上层卷积层的卷积核个数, 并且步长为 1 的时候. (可以将其视作一个全连接层, 经过 $1*1$ 卷积的每一个卷积核都可以视作一次对上层特征矩阵的加权求和)
作用: 使用了 $1*1$ 卷积之后就可以在原先的基础上多加一层激活函数. 这样就可以在特征图的尺寸不变 (不损失分辨率) 的前提下, 增加网络的非线性表达能力.
-
为什么卷积网络要加激活函数? 为什么要增加非线性?
因为如果多层卷积网络没有激活函数, 那么它的效果和单层卷积网络是一样, 只能拟合线性特征.
增加激活函数之后, 多层卷积网络就可以拟合非线性的特征, 而实际情况图片的特征非常复杂, 并不是线性的.
-
-
如果 $1*1$ 卷积的卷积核步长不为 1 的时候, 可以理解为是一种池化操作.
-
$1*1$ 卷积的降维操作还可以减小网络的参数量.
-
- $1*1$ 卷积是什么? 作用是什么?
-
-
Anchor Box
-
YOLOv2 参考了 Faster-RCNN 使用 Anchor 方法, 但是添加的不是手动设置尺寸的先验框, 而是用聚类提取尺寸的先验框.
-
YOLOv1 推理时预测 98 个框/张图片, YOLOv2 推理时超过 1000 个框/张图片. 虽然 mAP 没有获得提升, 但是 Recall (查全率) 得到了大幅提升.

-
聚类提取先验框 Dimension Clusters
- YOLOv2 使用了聚类的方法提取先验框.
- 以前的方法生成的框的比例都是固定的, 不一定能完全适合特定的数据集
- YOLOv1 是将图均分 49 格每格生成 2 个框, 训练后对框进行偏移.
- Faster-RCNN 将特征图的每个像素作为 Anchor 生成 9 个候选框 (长宽比手动设定, 带有一定的主观性), 训练后对框进行偏移.
- YOLOv2 基于 COCO 数据集, 将数据集中的标注框进行了聚类
- k-means 聚类需要设置 聚类数量 $k$ 和 距离指标 $d$.
-
聚类数量默认为 5, 超过 5 之后的 IOU 提升不大了.
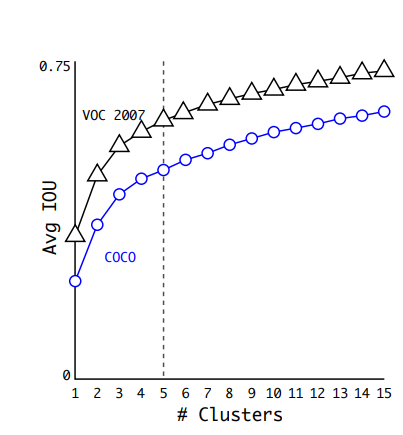
-
距离指标公式如下:
$$ d(box, centroid)=1-IOU(box, centroid) $$- 先验框的目的是使预测框与 GT 框的 IOU 更高, 所以这里使用 box 与 聚类中心的 box 之间的 IOU 作为距离指标.
-
- k-means 聚类需要设置 聚类数量 $k$ 和 距离指标 $d$.
- 以前的方法生成的框的比例都是固定的, 不一定能完全适合特定的数据集
- YOLOv2 使用了聚类的方法提取先验框.
-
-
直接位置预测 Direct location prediction
候选框偏移量参数 $x,y,w,h$ 预测的时候, $x,y$ 为 bbox 中心相对于单元格中心的偏移量, 中心点 $(x,y)$ 很可能飘出单元格 (Grid cell) 外, 这样对导致训练收敛出现问题 ←YOLOv1的缺陷. YOLOv1 的偏移公式如下:
$$ \begin{array}{c} x = (t_x*w_a)-x_a \\ y = (t_y*h_a)-y_a \end{array} $$YOLOv2 预测的 bbox 中心点是相对于对应单元格本身的偏移量, 预测 5 个参数: $t_x,t_y,t_w,t_h,t_o$. 公式如下:
$$ \begin{aligned}b_x & =\sigma\left(t_x\right)+c_x \\b_y & =\sigma\left(t_y\right)+c_y \\b_w & =p_w e^{t_w} \\b_h & =p_h e^{t_h} \\\operatorname{Pr}(\text { object }) * \operatorname{IOU}(b, \text { object }) & =\sigma\left(t_o\right)\end{aligned} $$- $\sigma\left(t_x\right),\sigma\left(t_y\right)$ 是预测 bbox 中心点相对于单元格边缘的距离, 单元格边缘长度为 1. $\sigma$ 是 Sigmoid 函数, 所以结果只能是 0 到 1 之间.
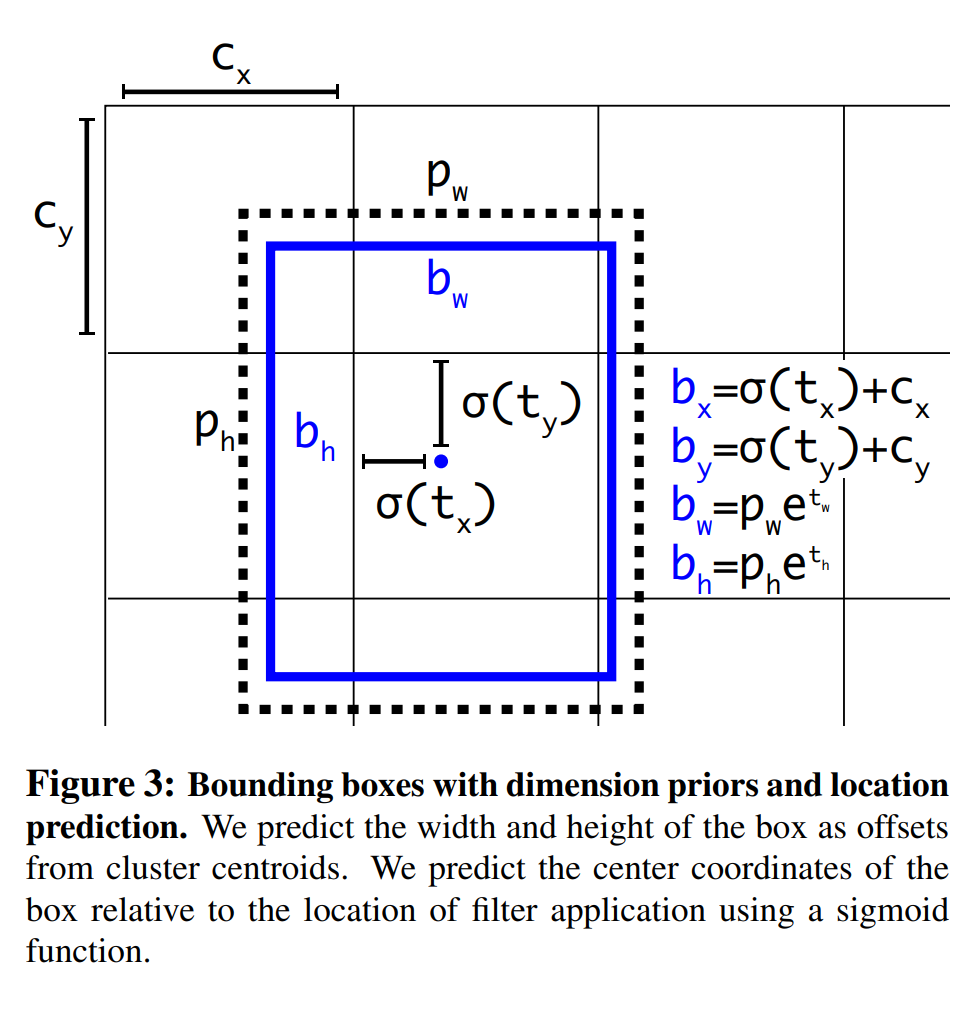
-
Pass through (精细特征 Fine-Grained Features)
-
使用不同尺寸的特征图来强化不同尺寸目标的检测能力, 过程中运用了一个小技巧 (Pass through). 分类模型没有用 Pass through layer.
-
由于 YOLOv1 使用的是最后一层的特征, 所以感受野很大, 对小目标的识别就变得很差. 所以需要融合之前的特征 (要将高分辨率特征拆分并叠加后获得细粒度特征 (Pass through)).
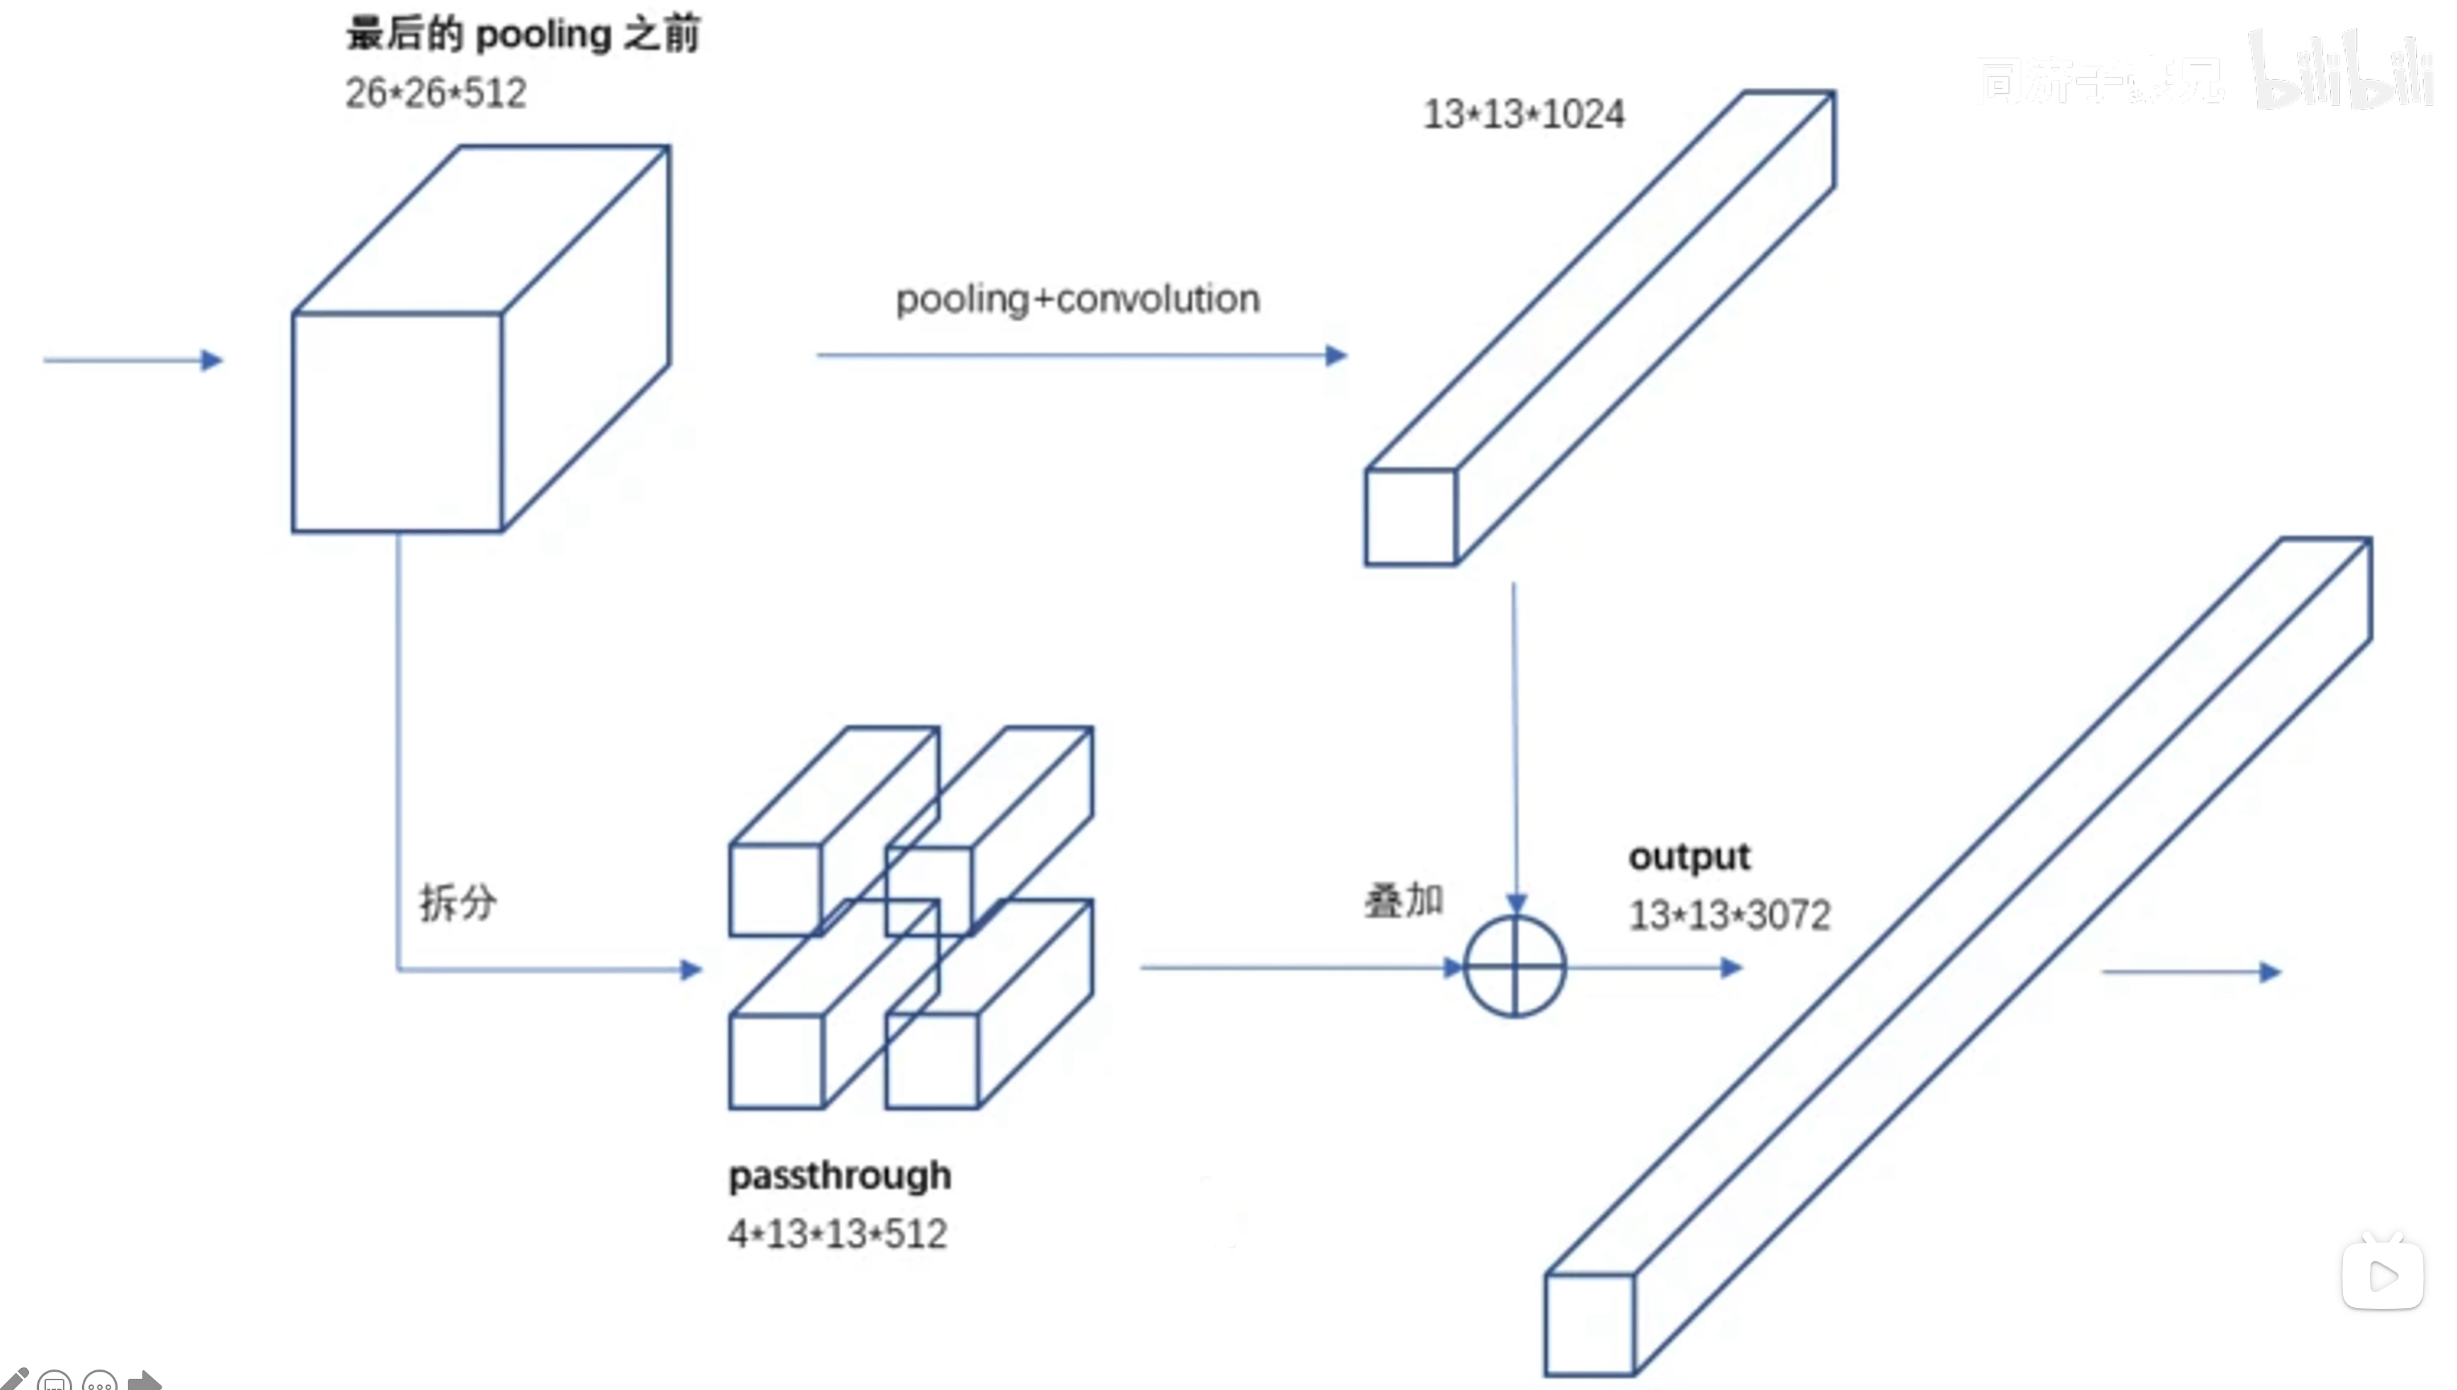
-
Pass through 特征图 (这么做之后图片尺寸减小了, 但是保留了大部分的信息)
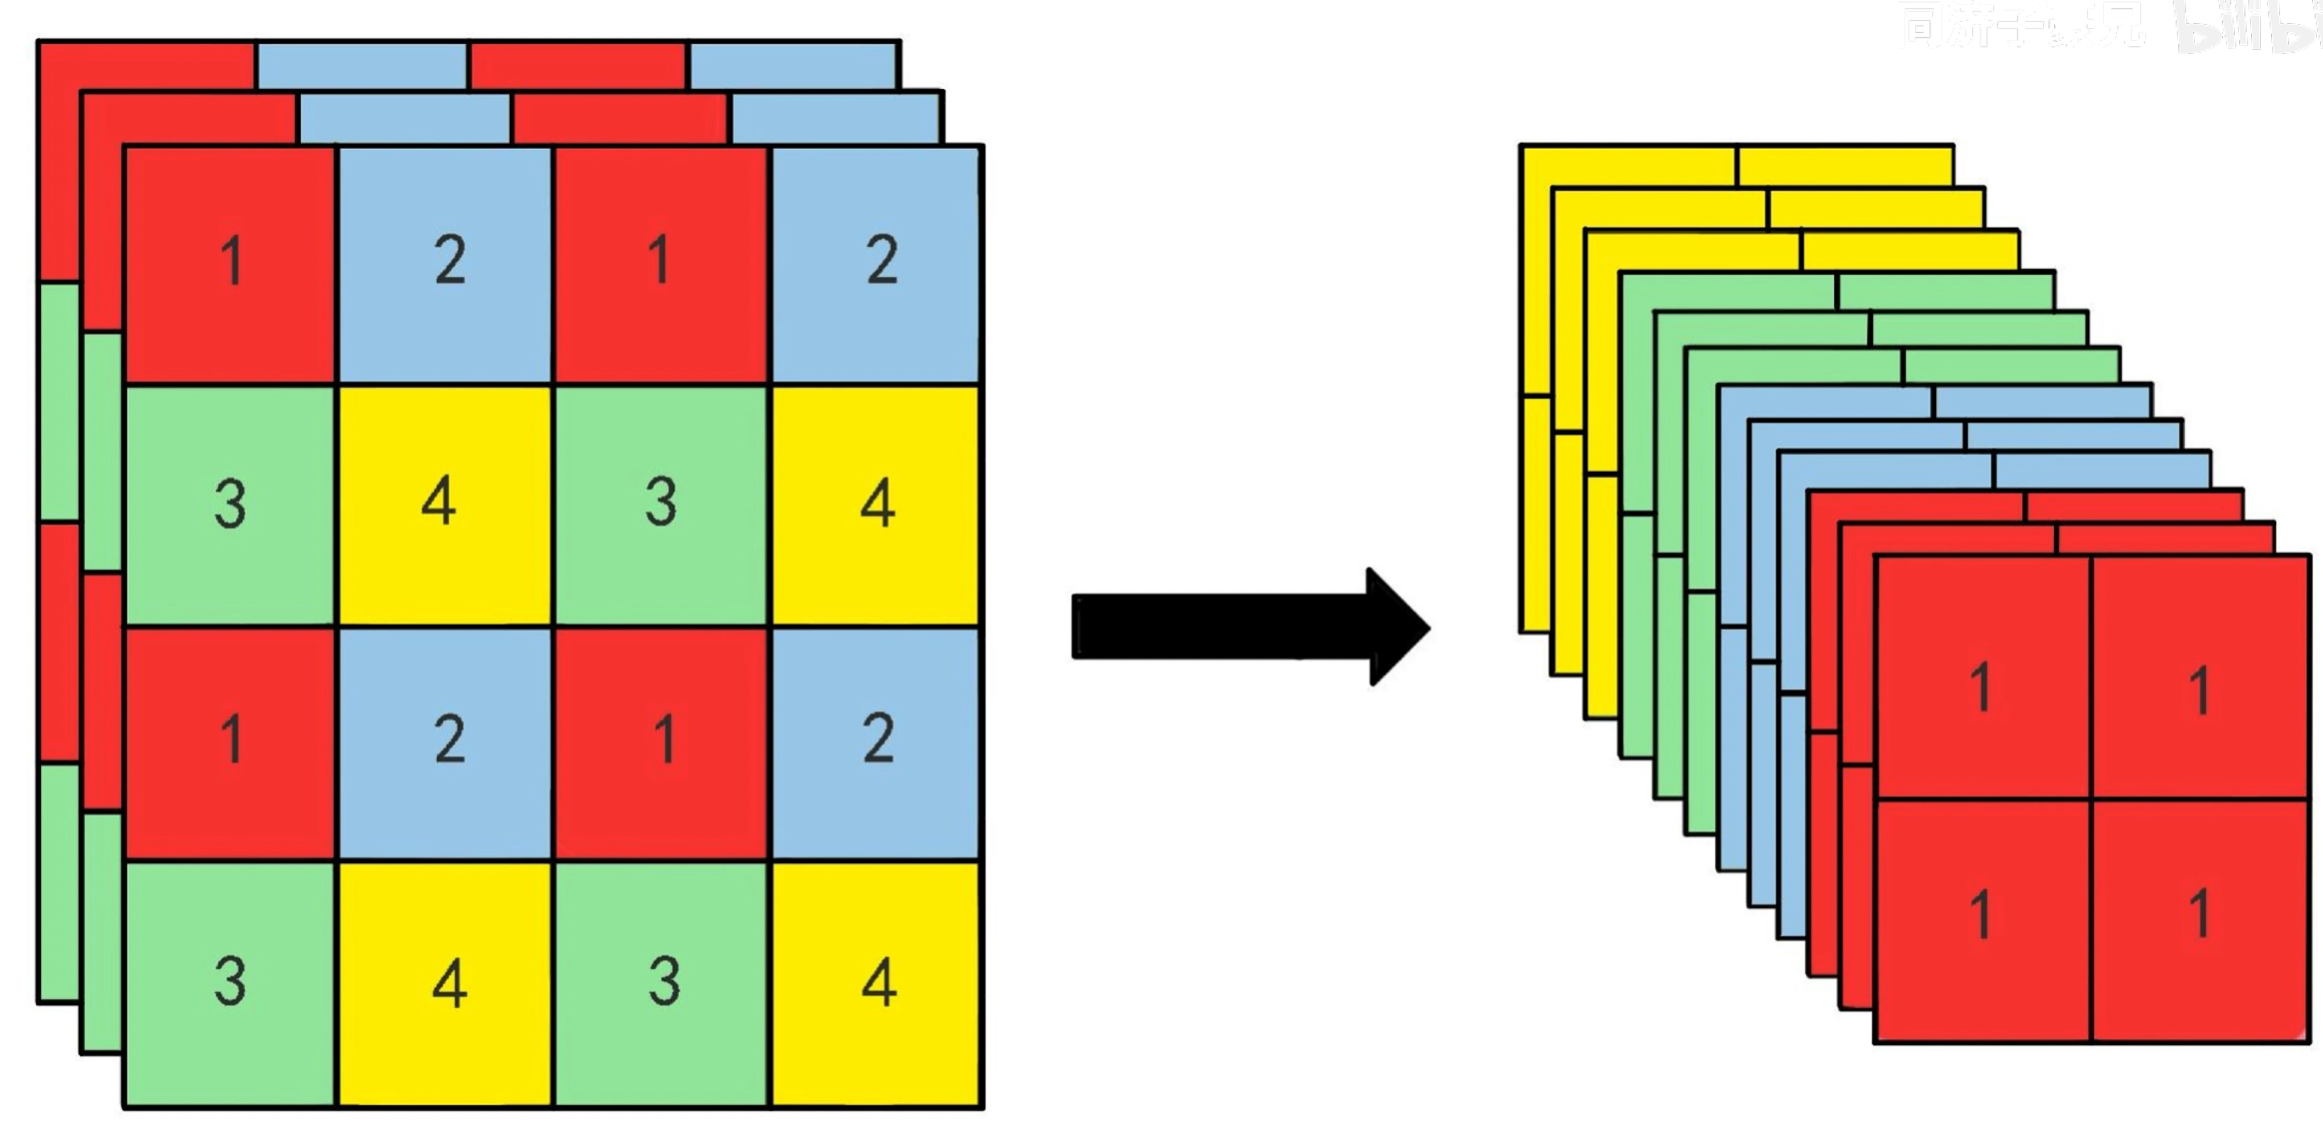
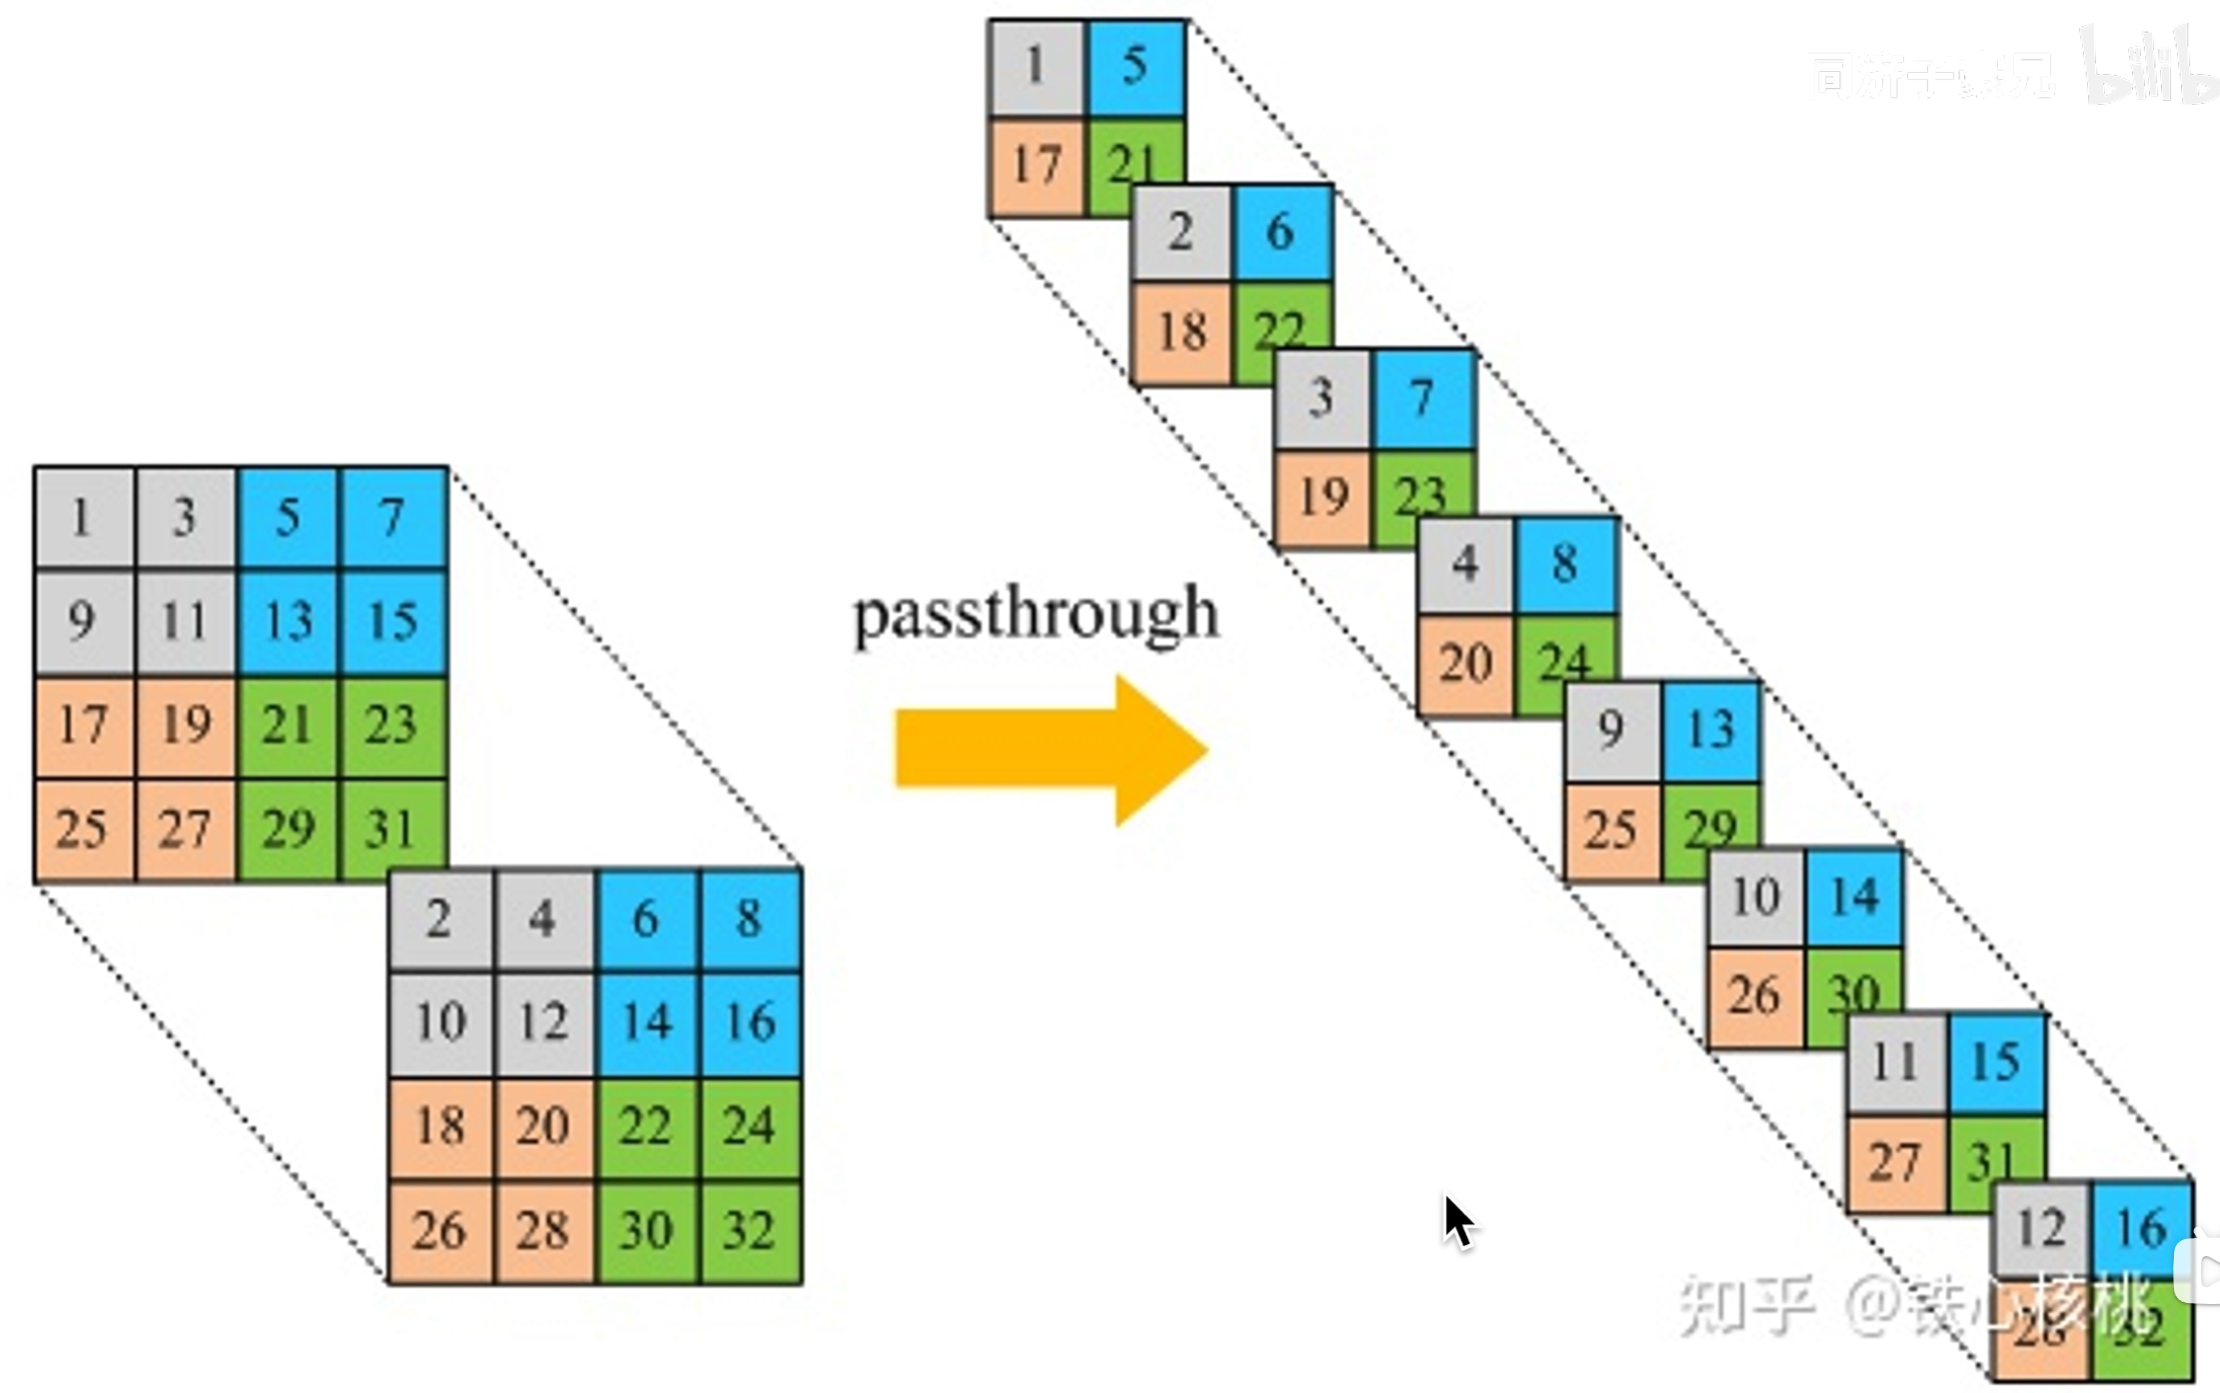
-
-
选用了 $26*26*512$ 尺寸的特征图, 用 $1*1$ 卷积将这个特征图尺寸改为 $26*26*64$, 使用 Pass through 层再将尺寸变为 $13*13*256$. 将这个矩阵融合到卷积输出的 $13*13*1024$ 的特征图中.
-
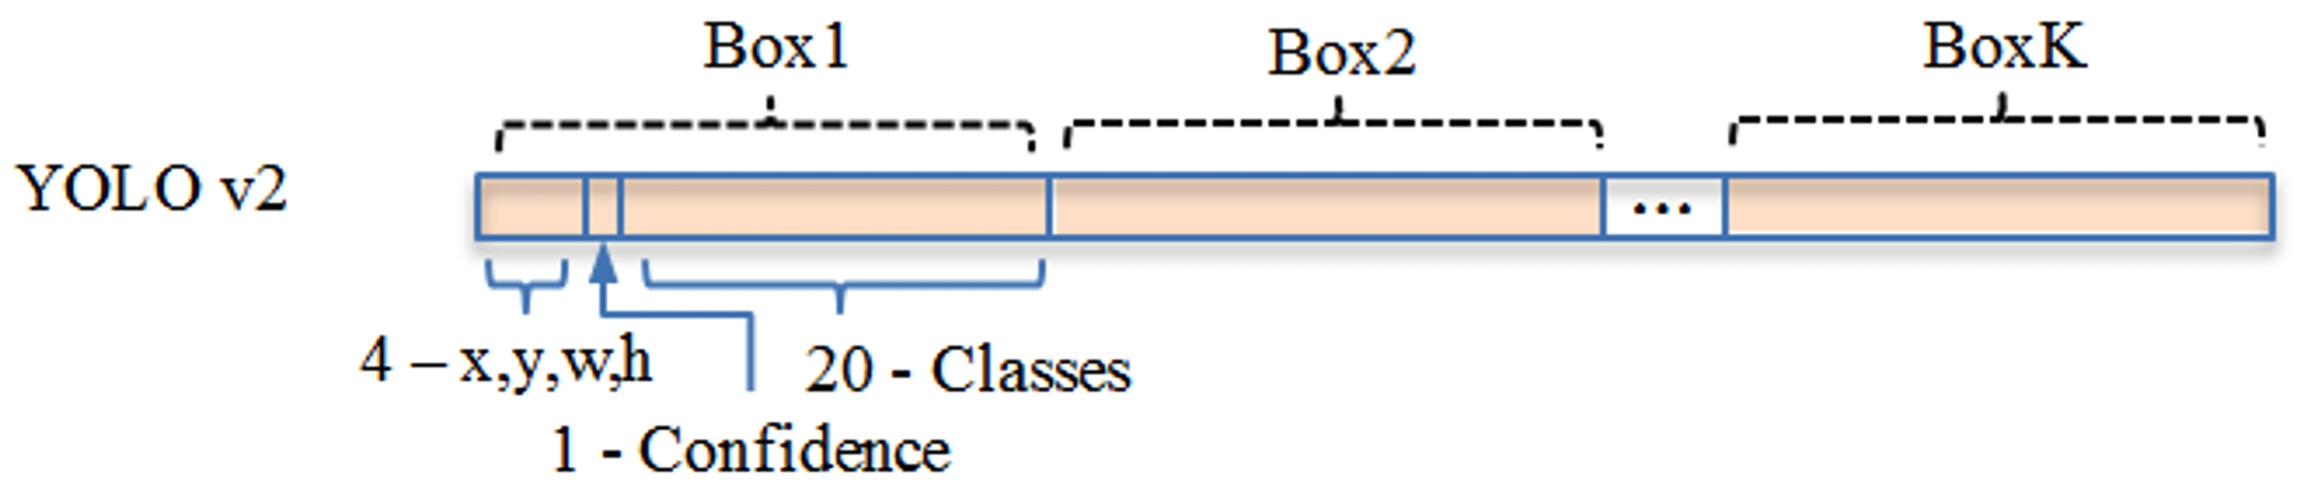
注意最后输入预测的尺寸 $125*1*1$, $125=(5+20)*5$ 是 $(x,y,w,h,c + classes)*(anchor\_box)$.
-
-
-
多尺度 Multi-Scale
-
YOLOv2 可以检测尺寸在 $320*320 \sim 608*608$ 之间的图片, 注意图片尺寸必须被 32 整除 (因为网络池化层的特性, 每次池化特征尺寸就要除 2).
-
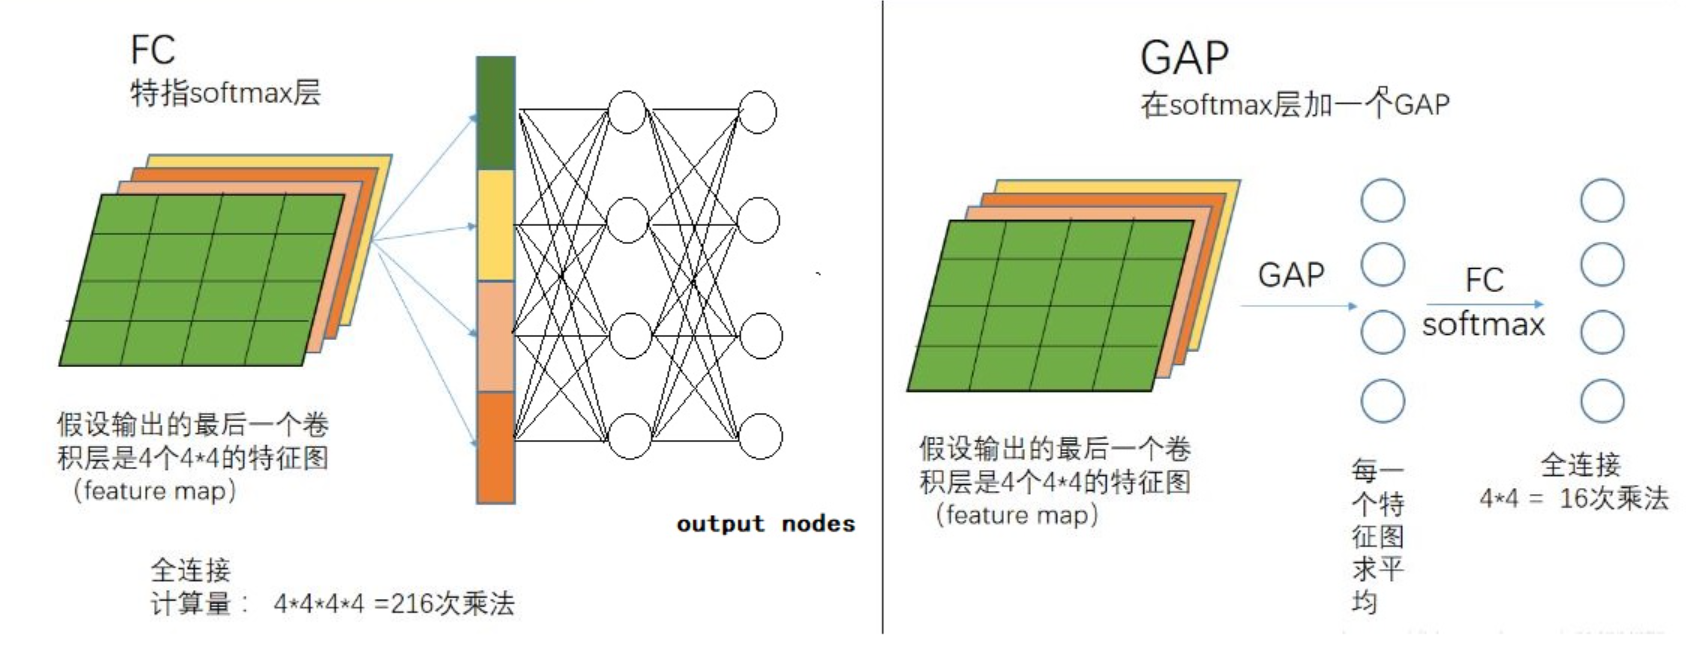
由于 DarkNet 网络中没有了全连接层, 取而代之的是 Global average pooling (GAP 全局均值池化) 层. 根据 DarkNet 网络, 将特征图输入 GAP 层之后, 输出还是特征图数量的特征图, 但是特征图的尺寸变为 $1*1$ (GAP 将每一个特征图都分别求了一个平均值), 之后使用 Softmax 来分类就行了.
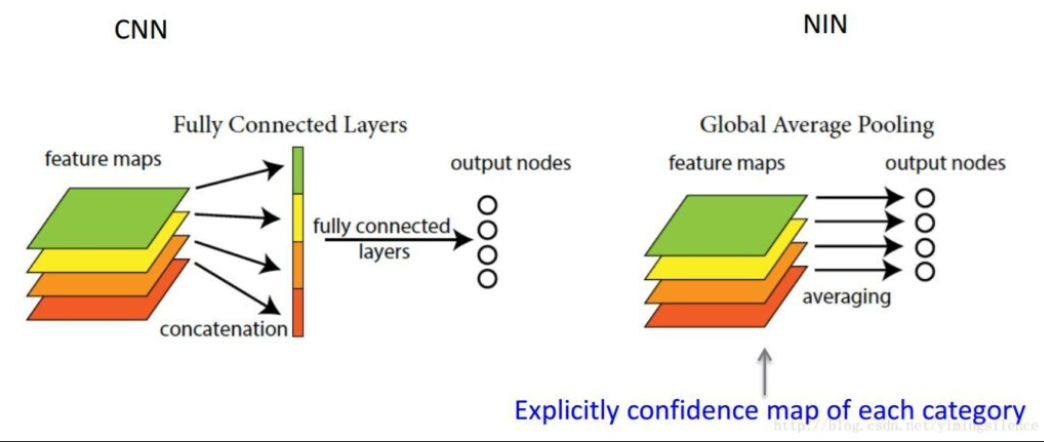
全连接层的计算量大于 GAP
-
-
Loss
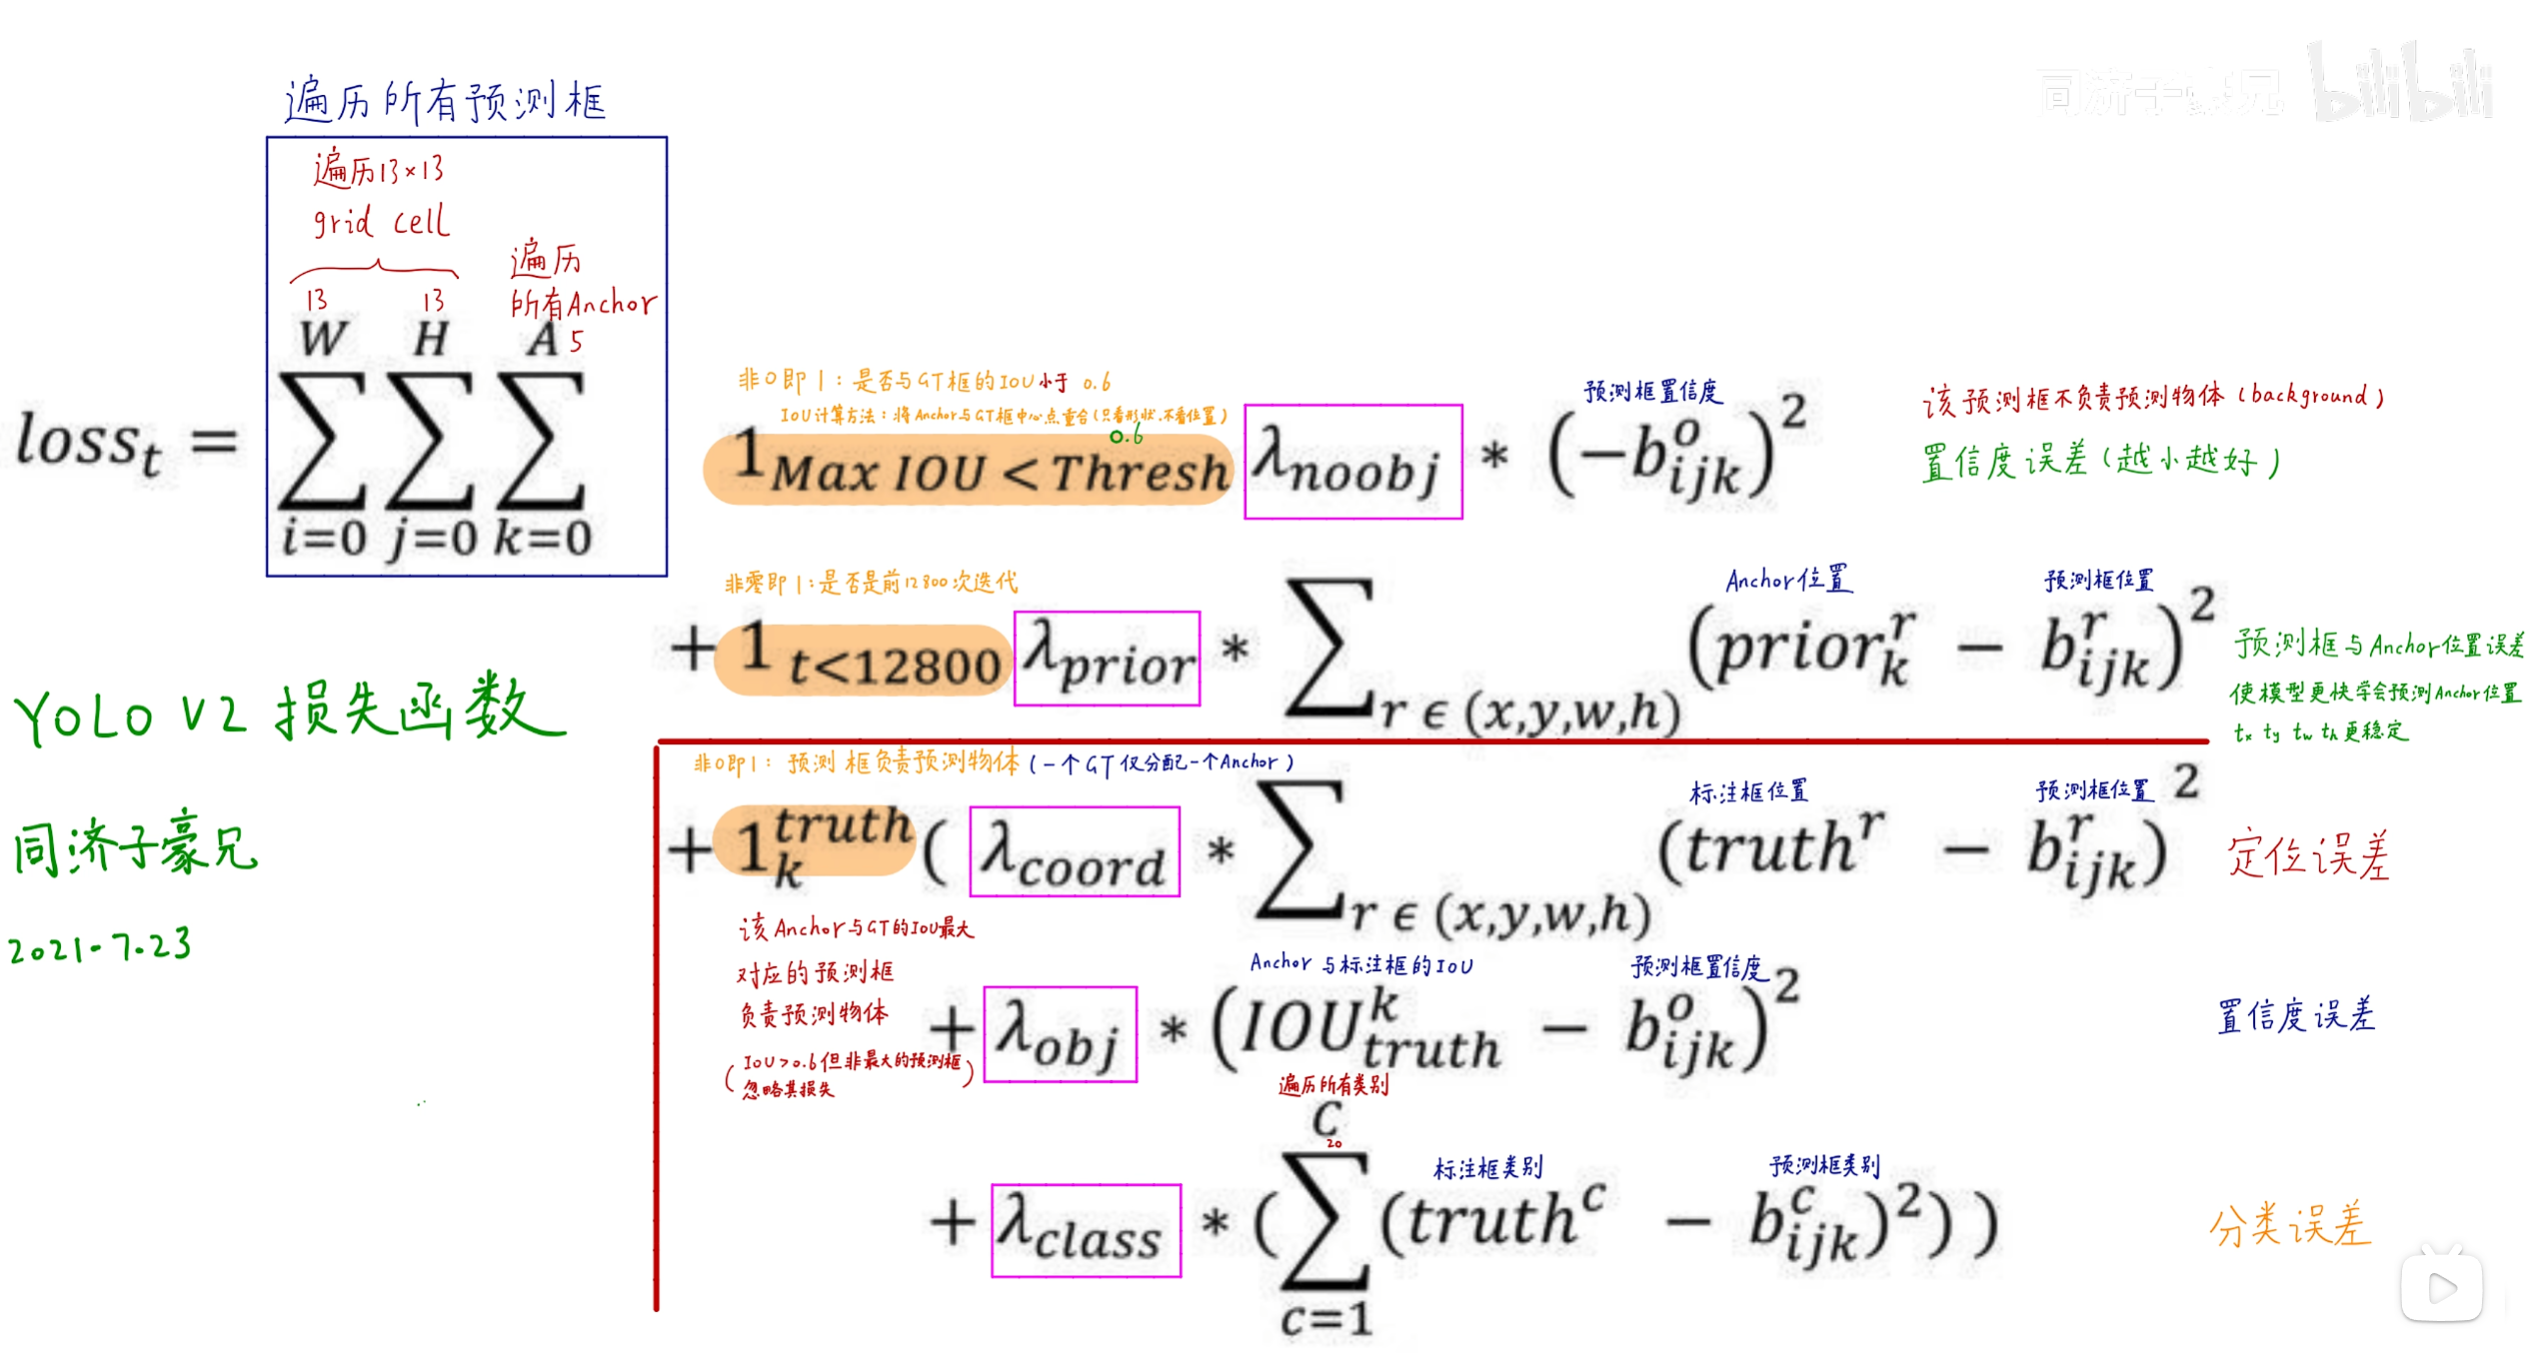
5.5.3. YOLOv3
深入浅出Yolo系列之Yolov3&Yolov4&Yolov5&Yolox核心基础知识完整讲解
【精读AI论文】YOLO V3目标检测(附YOLOV3代码复现)_哔哩哔哩_bilibili
YOLOv3 的推理速度提升, 并且对于小目标的检测能力增加了.
下边左图是 IOU 在0.5到0.95之间的各阈值所获得的平均值结果, 右图是 IOU 为 0.5 作为阈值获得的结果.
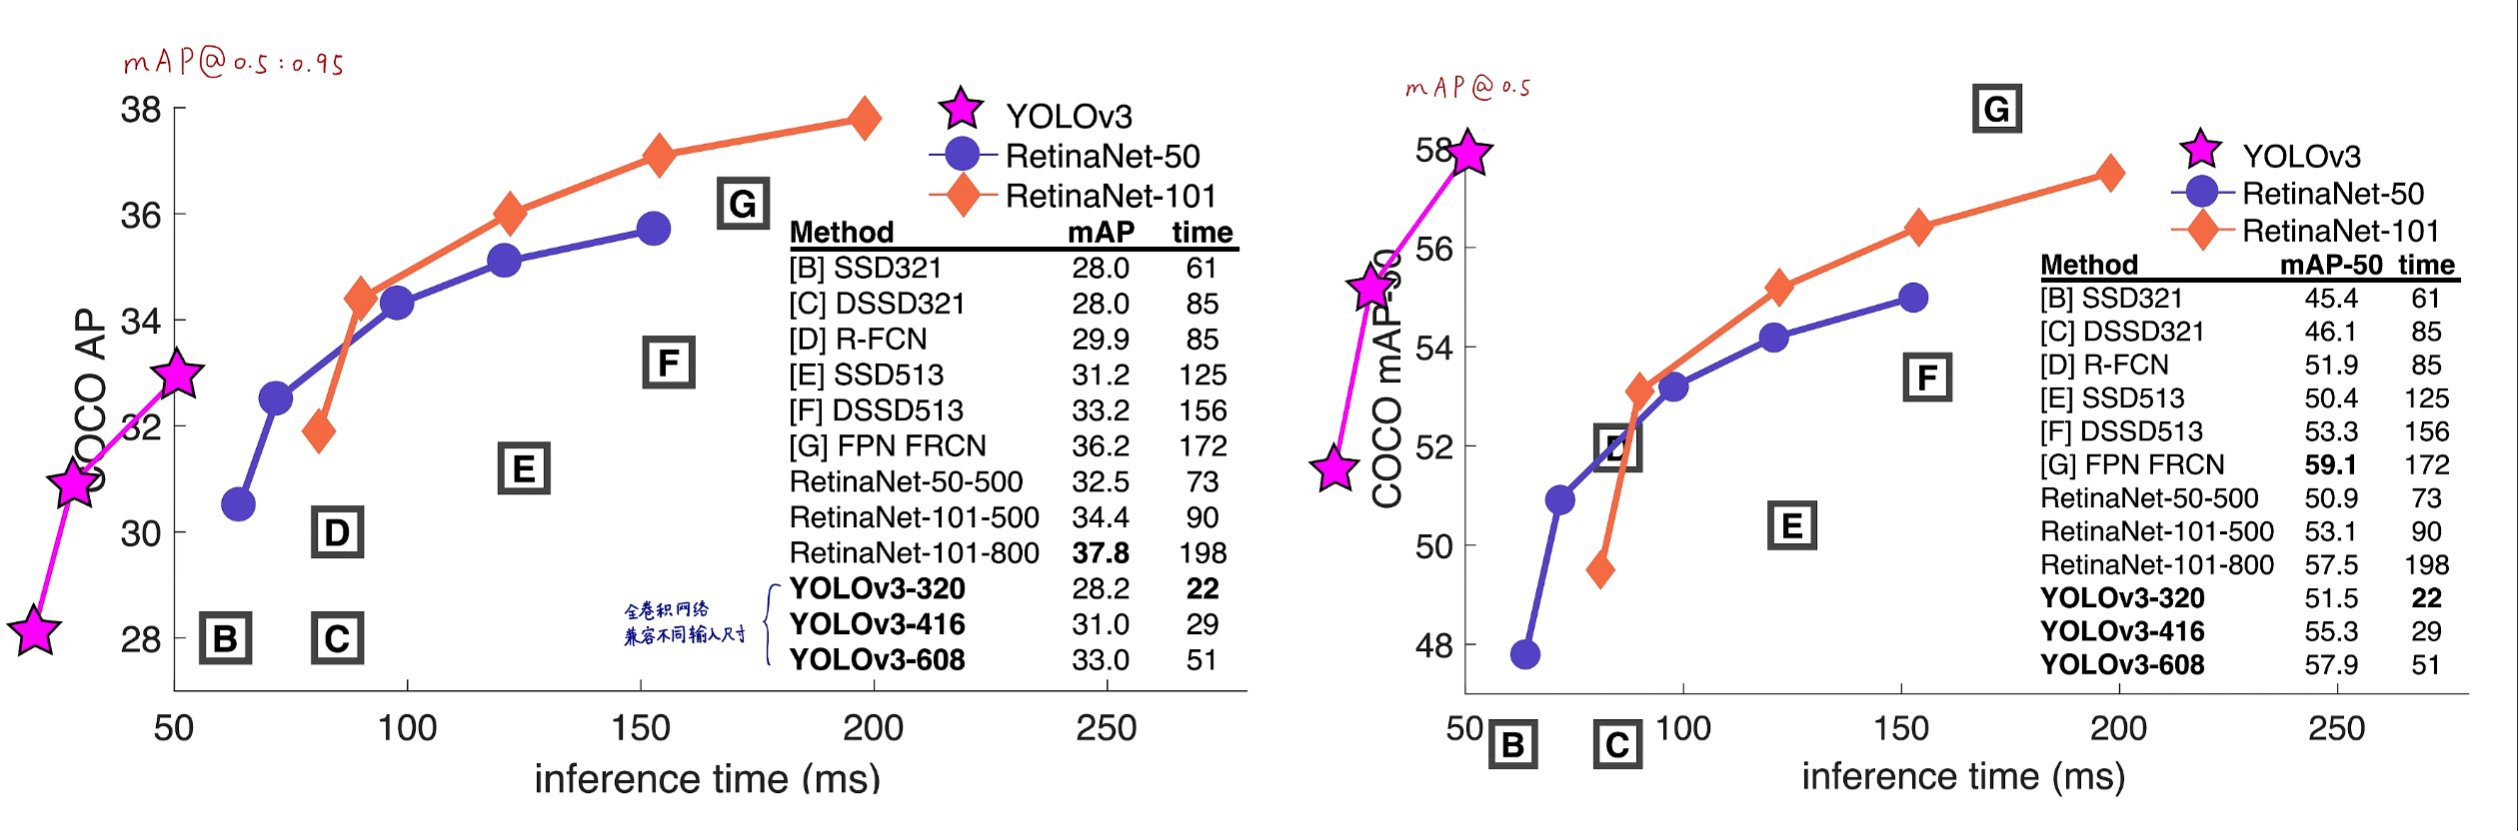
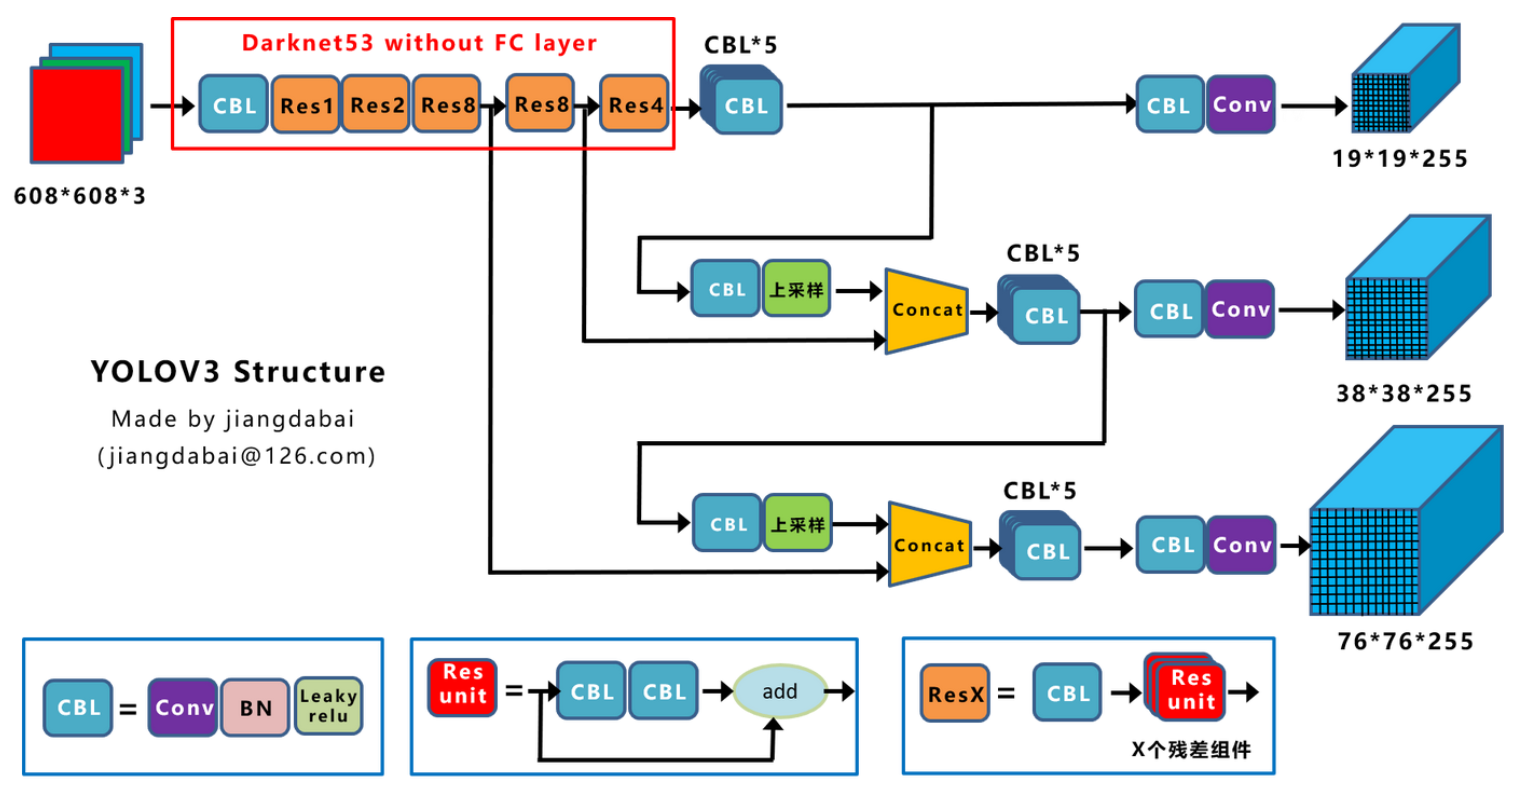
这次模型的输入为
$416*416*3$ (用于预测的特征矩阵尺寸 $13,26,52$);
$608*608*3$ (用于预测的特征矩阵尺寸 $19,38,76$).
-
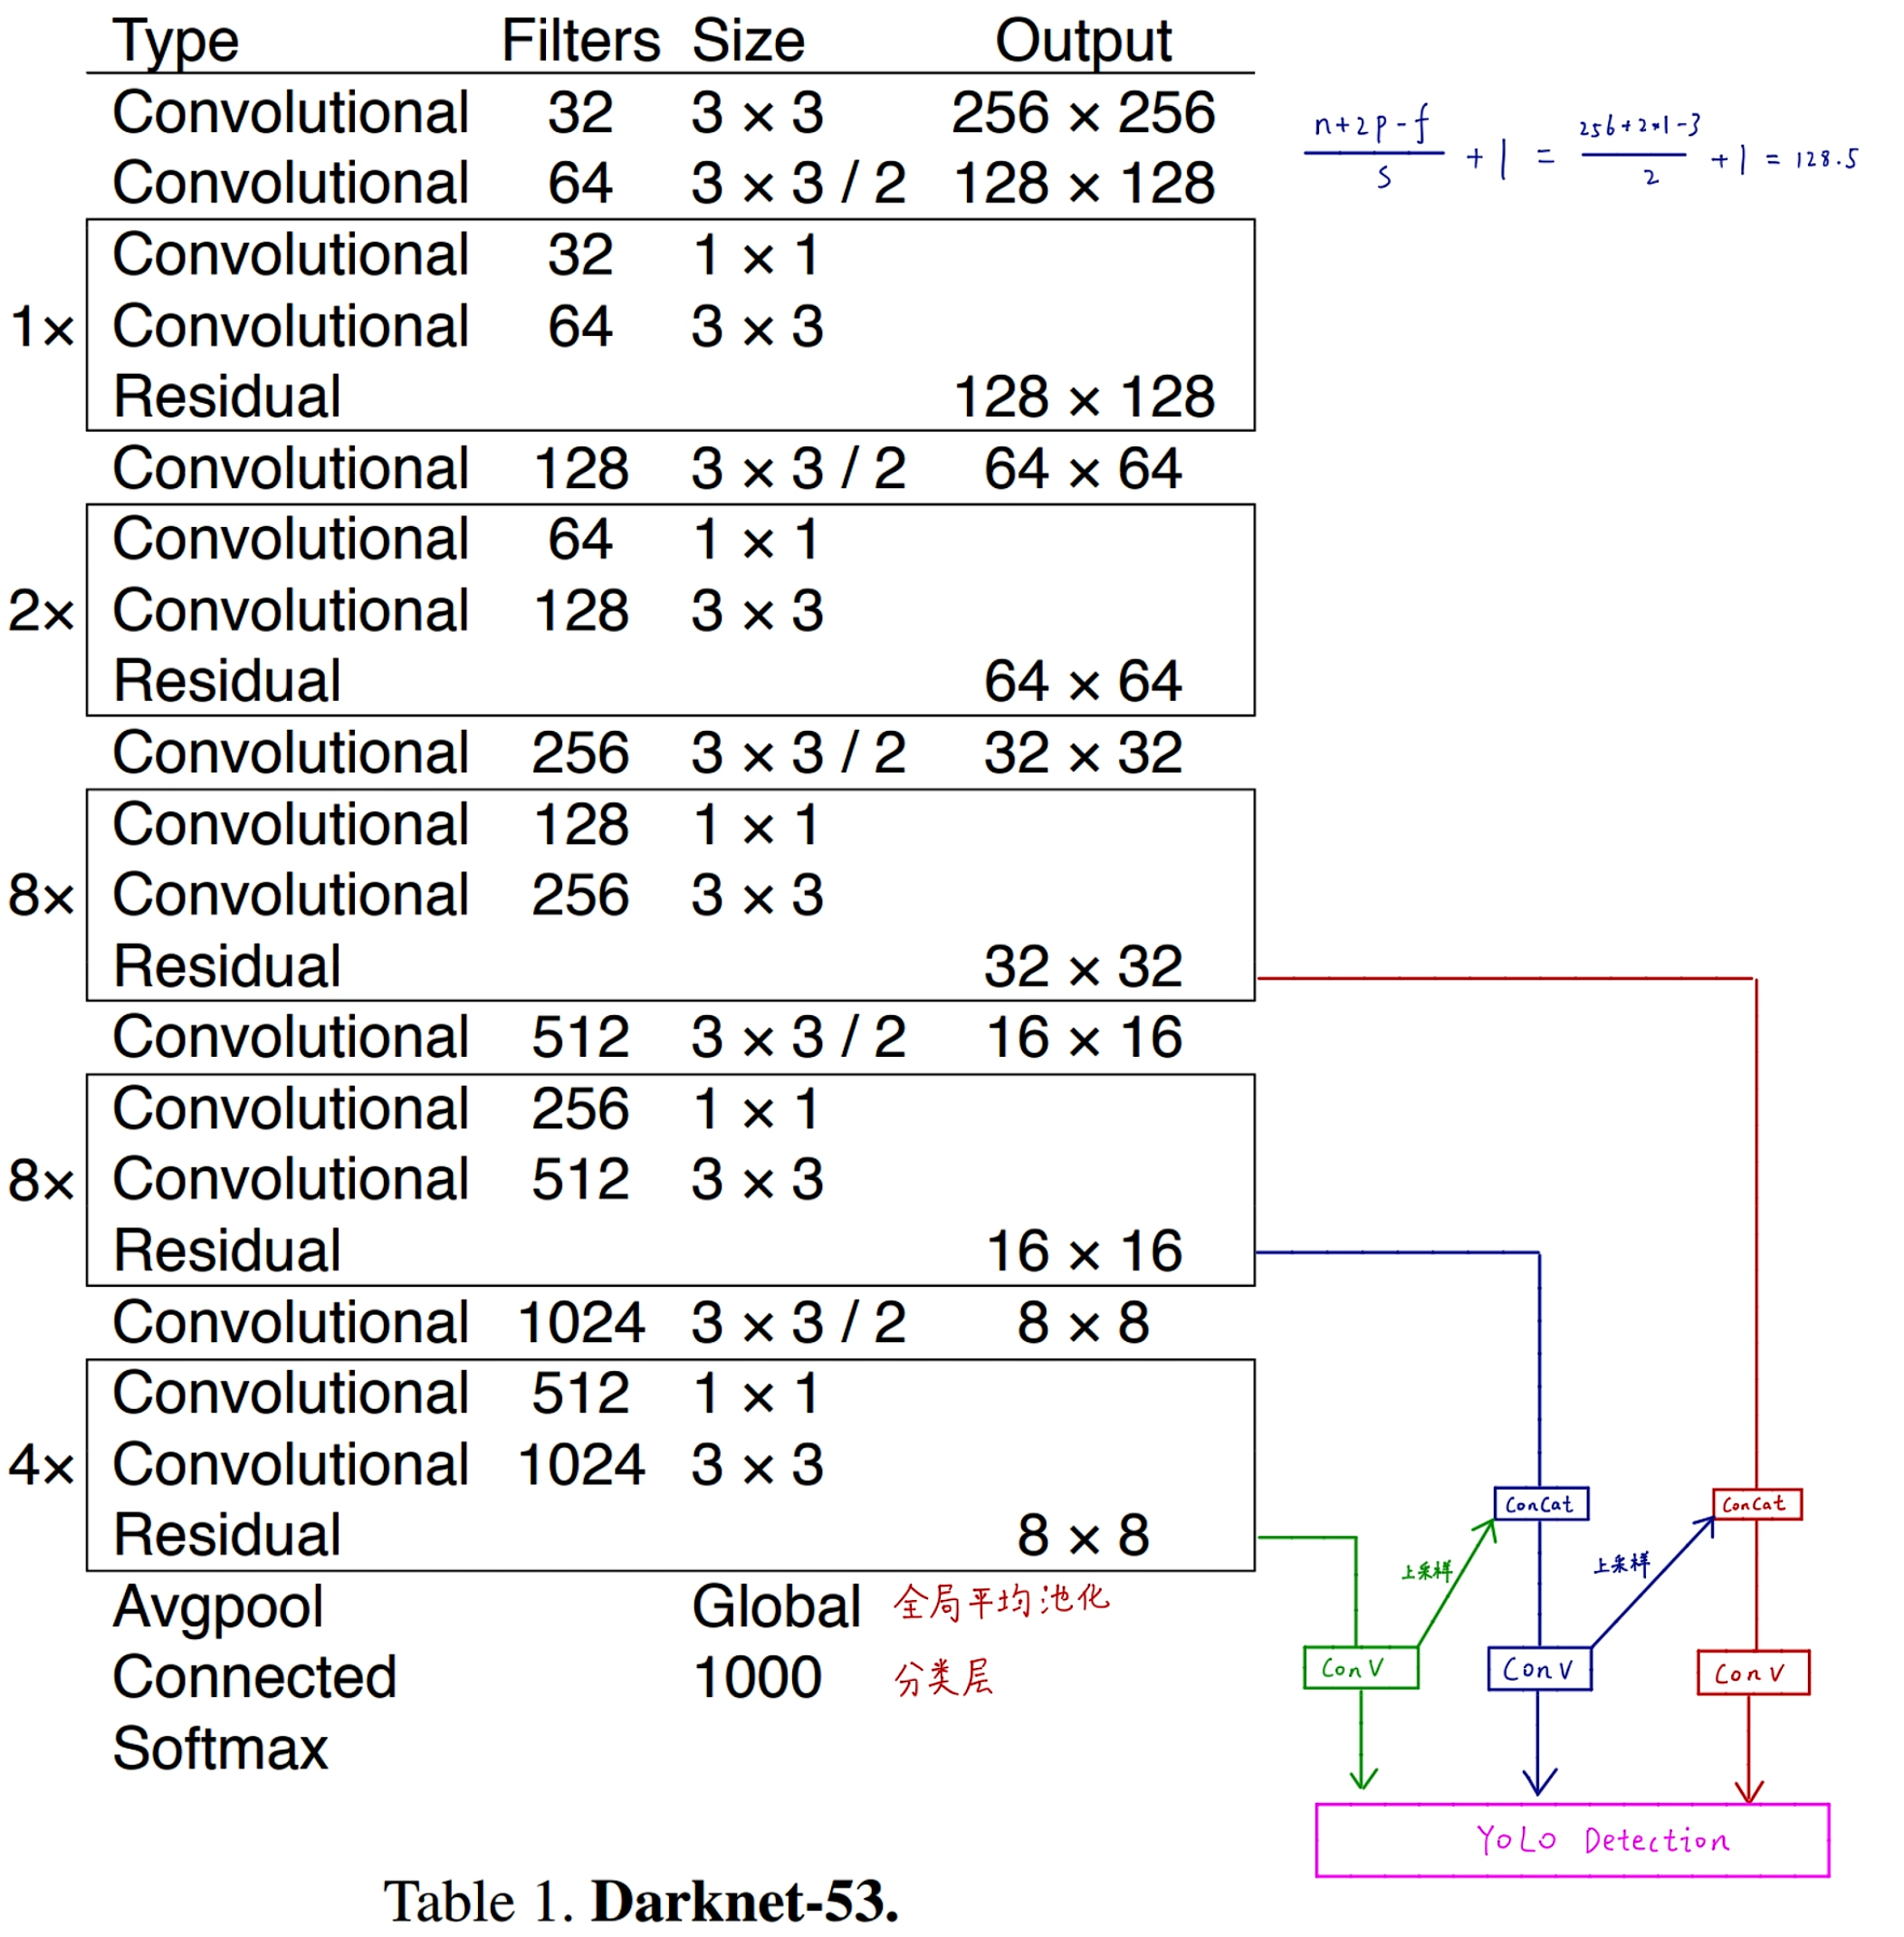
更大的 Backbone (DarkNet-53)
-
DarkNet-53 网络结构图
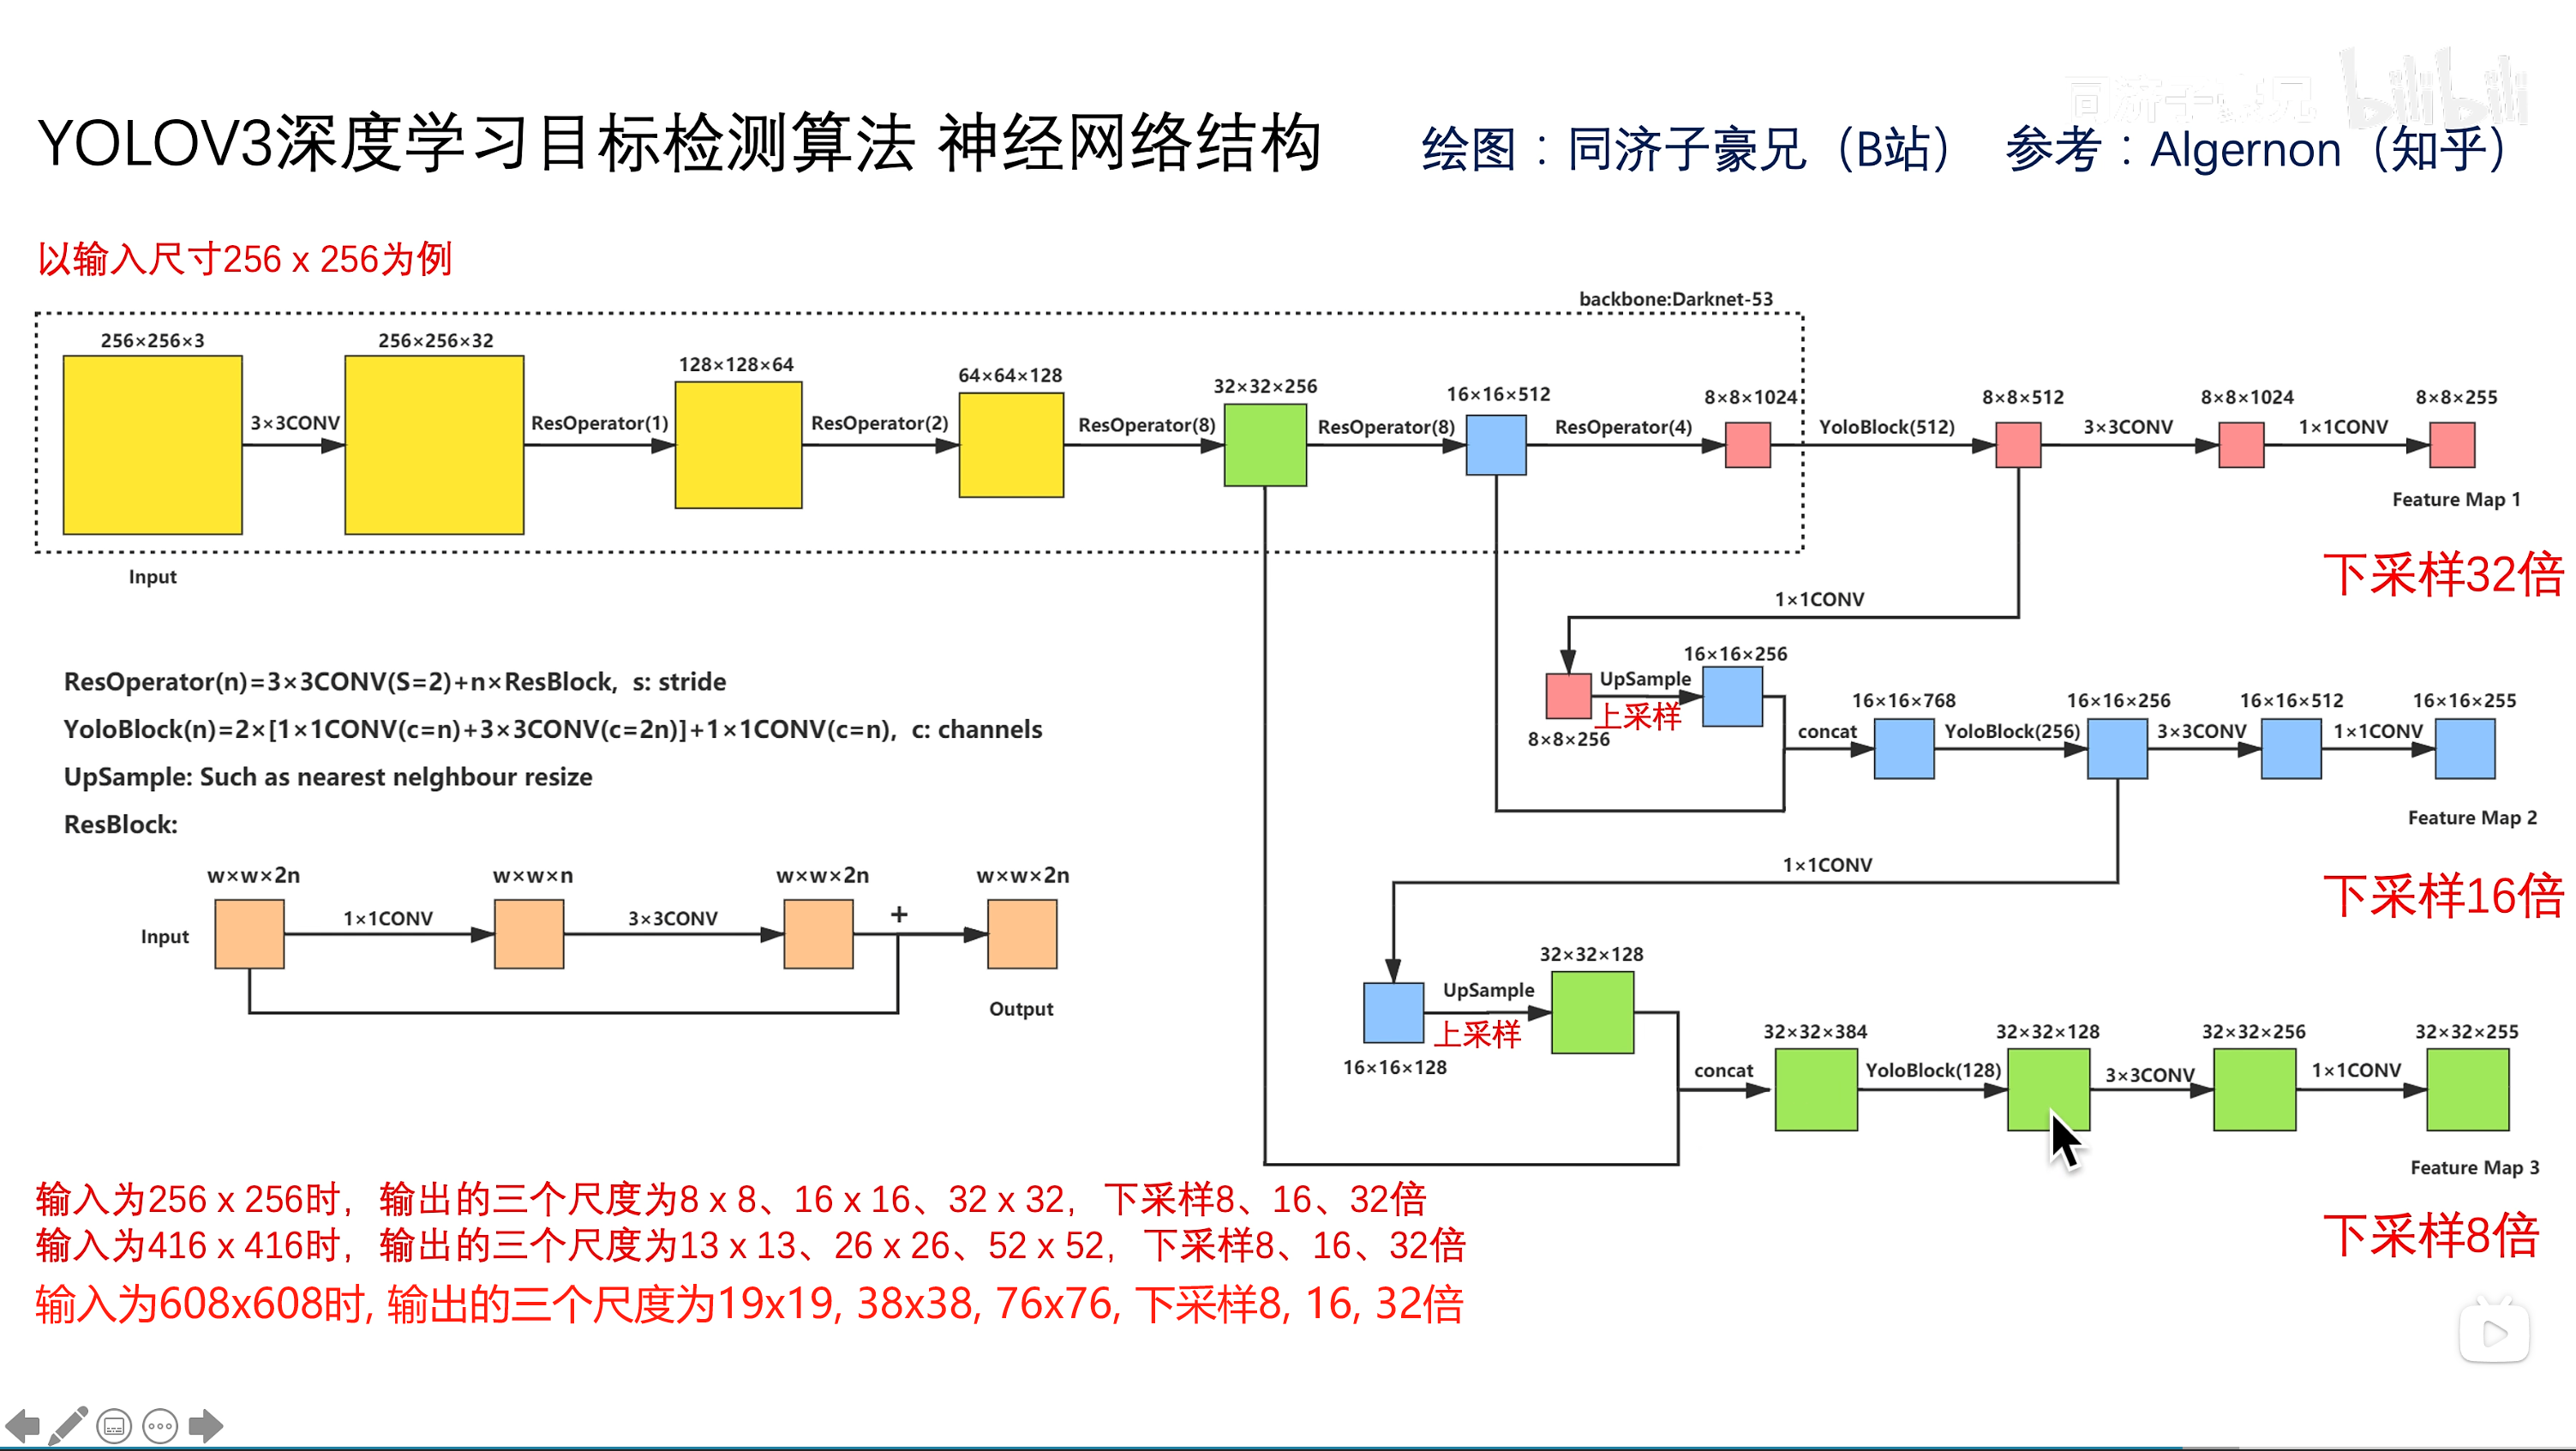
-
从 YOLOv2 的 19 层卷积网络增加到了 53 层.
-
DarkNet-53 由 52 层卷积层 + 1 层 FC 层构成, 其中大部分卷积层都加了残差连接.
-
由于 DarkNet 尾端有 3 次卷积缩小特征尺寸, 所以最小的输入图片必须大于 32x32, 并且尺寸是 32 的倍数.
-
DarkNet-53 等精度接近 ResNet-101, 每秒可进行的浮点运算量和 FPS 高于 ResNet-152.
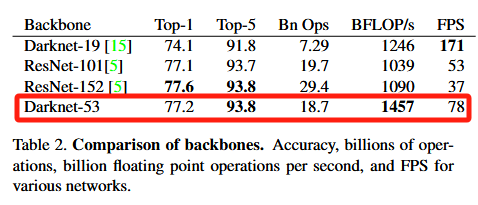
-
-
更多的候选框
-
这次每个单元格内生成一个中心点作为 Anchor, 根据 Anchor 生成 3 个候选框, 特征的尺寸为 $N*N*(3*(4+1+80))$. (这里的 $N$ 有三个不同的尺度 $52*52,26*26,13*13$)
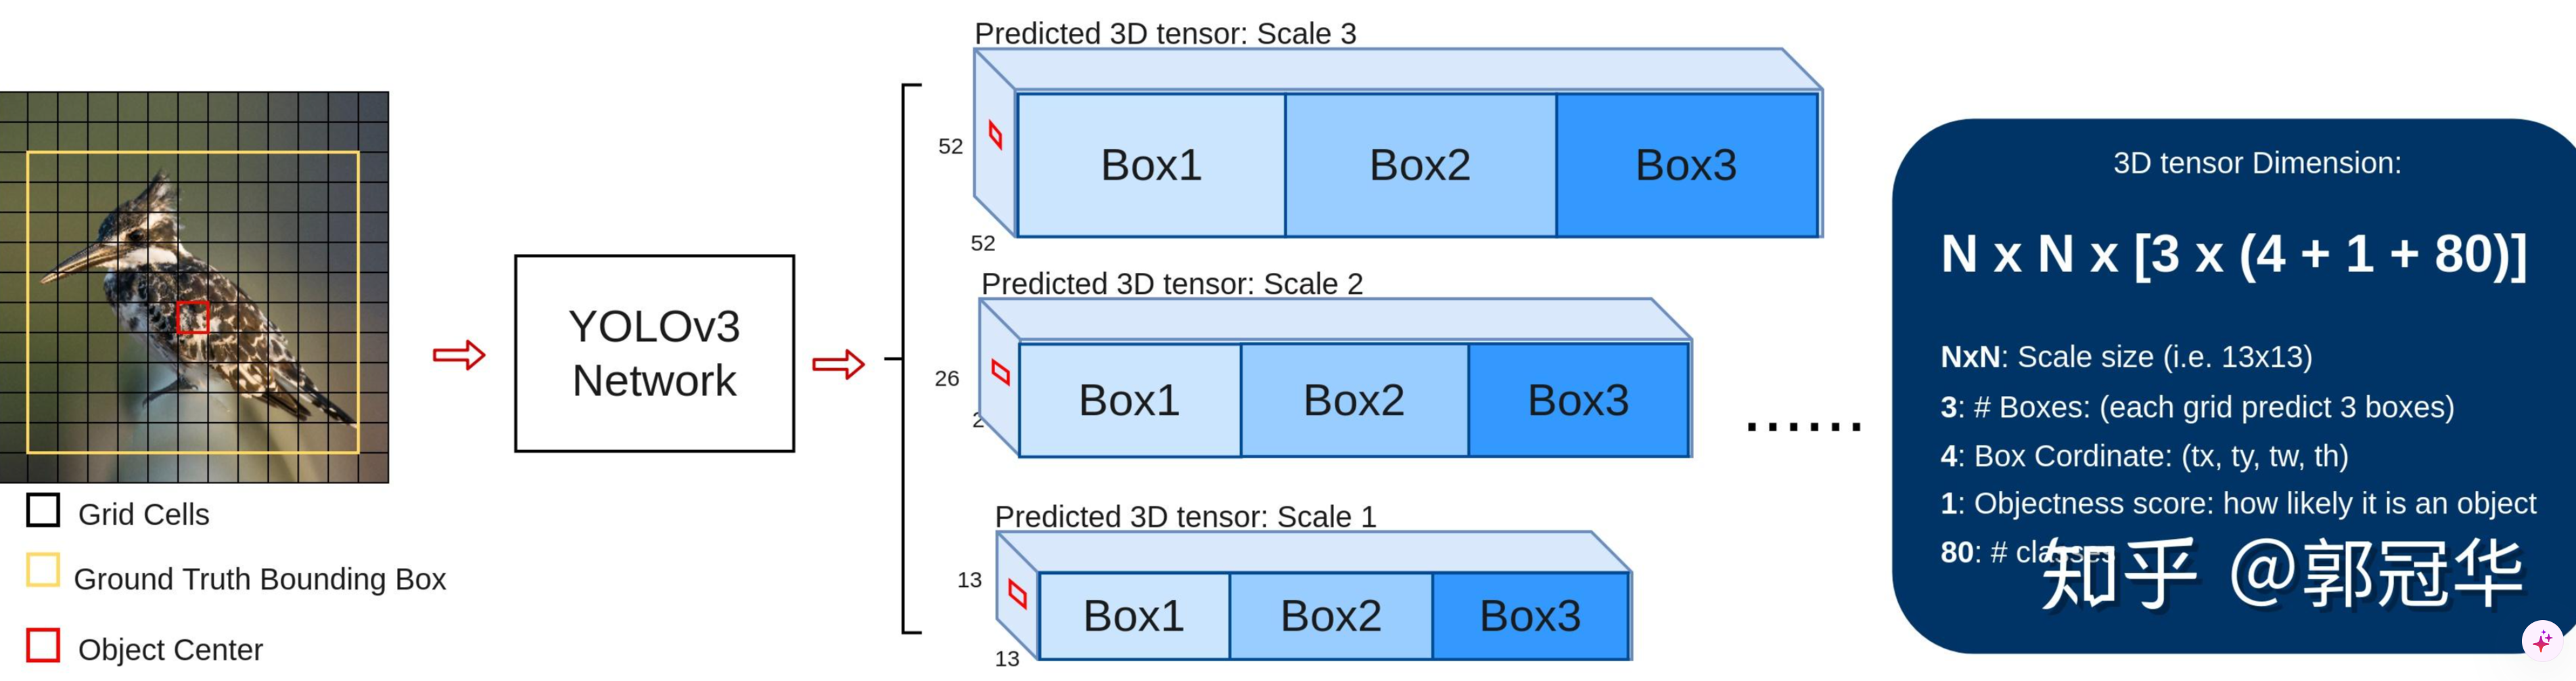
-
这三个不同尺度的特征图中如果有物体, 那么物体的中心肯定有一个 Anchor. 问题是应该选择哪个尺度和形状的候选框才能正好概括到物体?
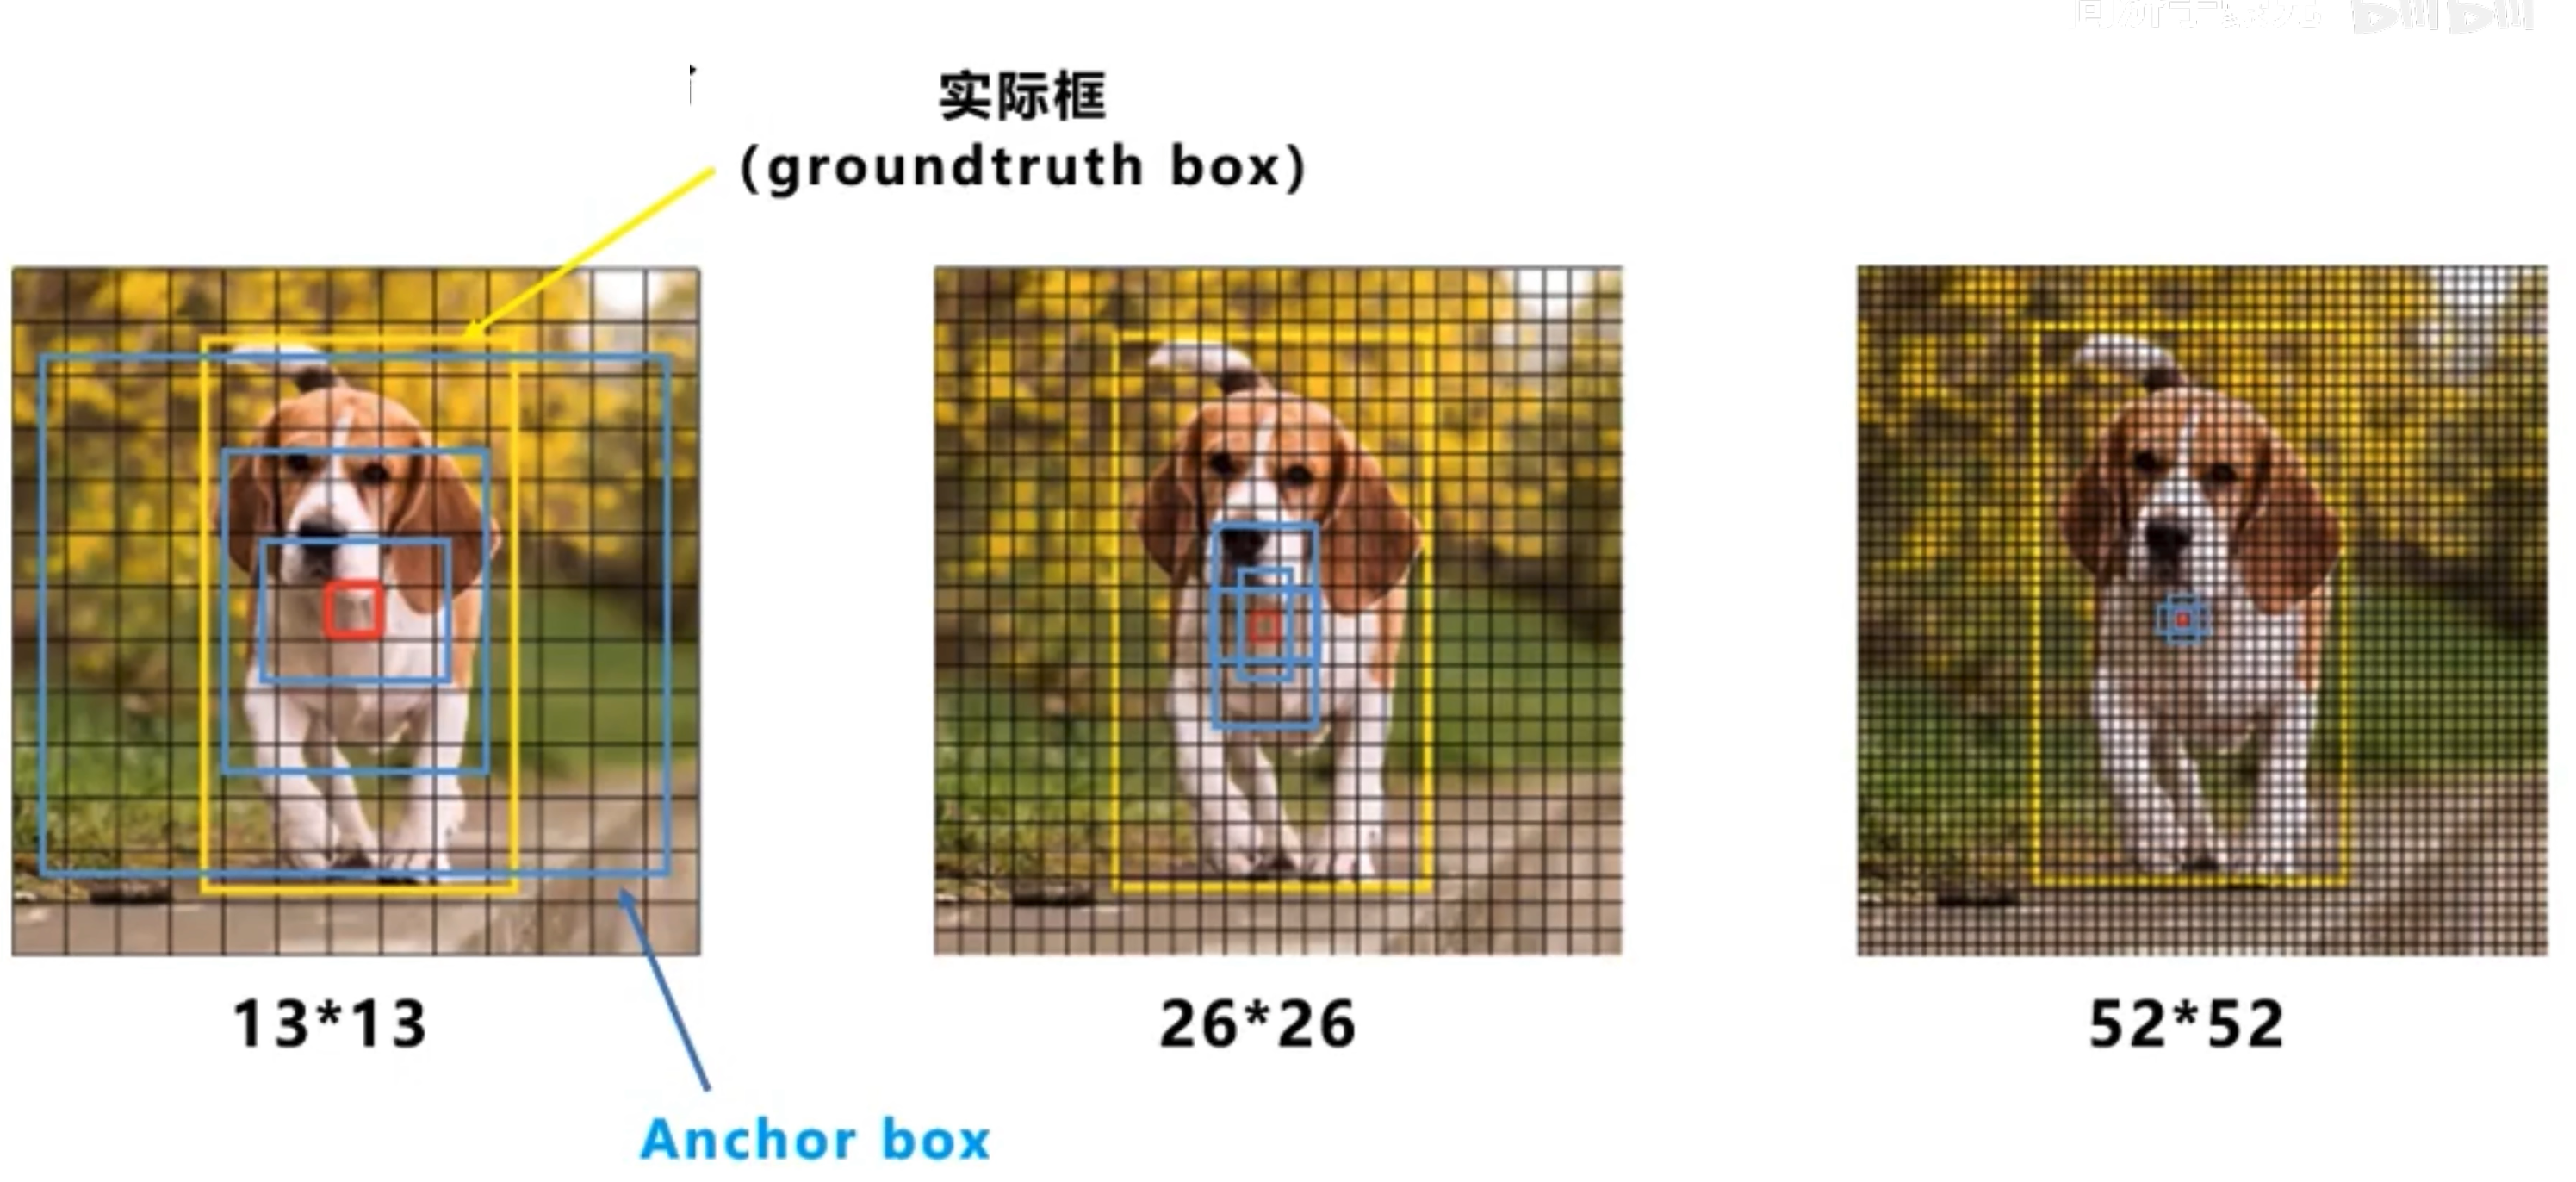
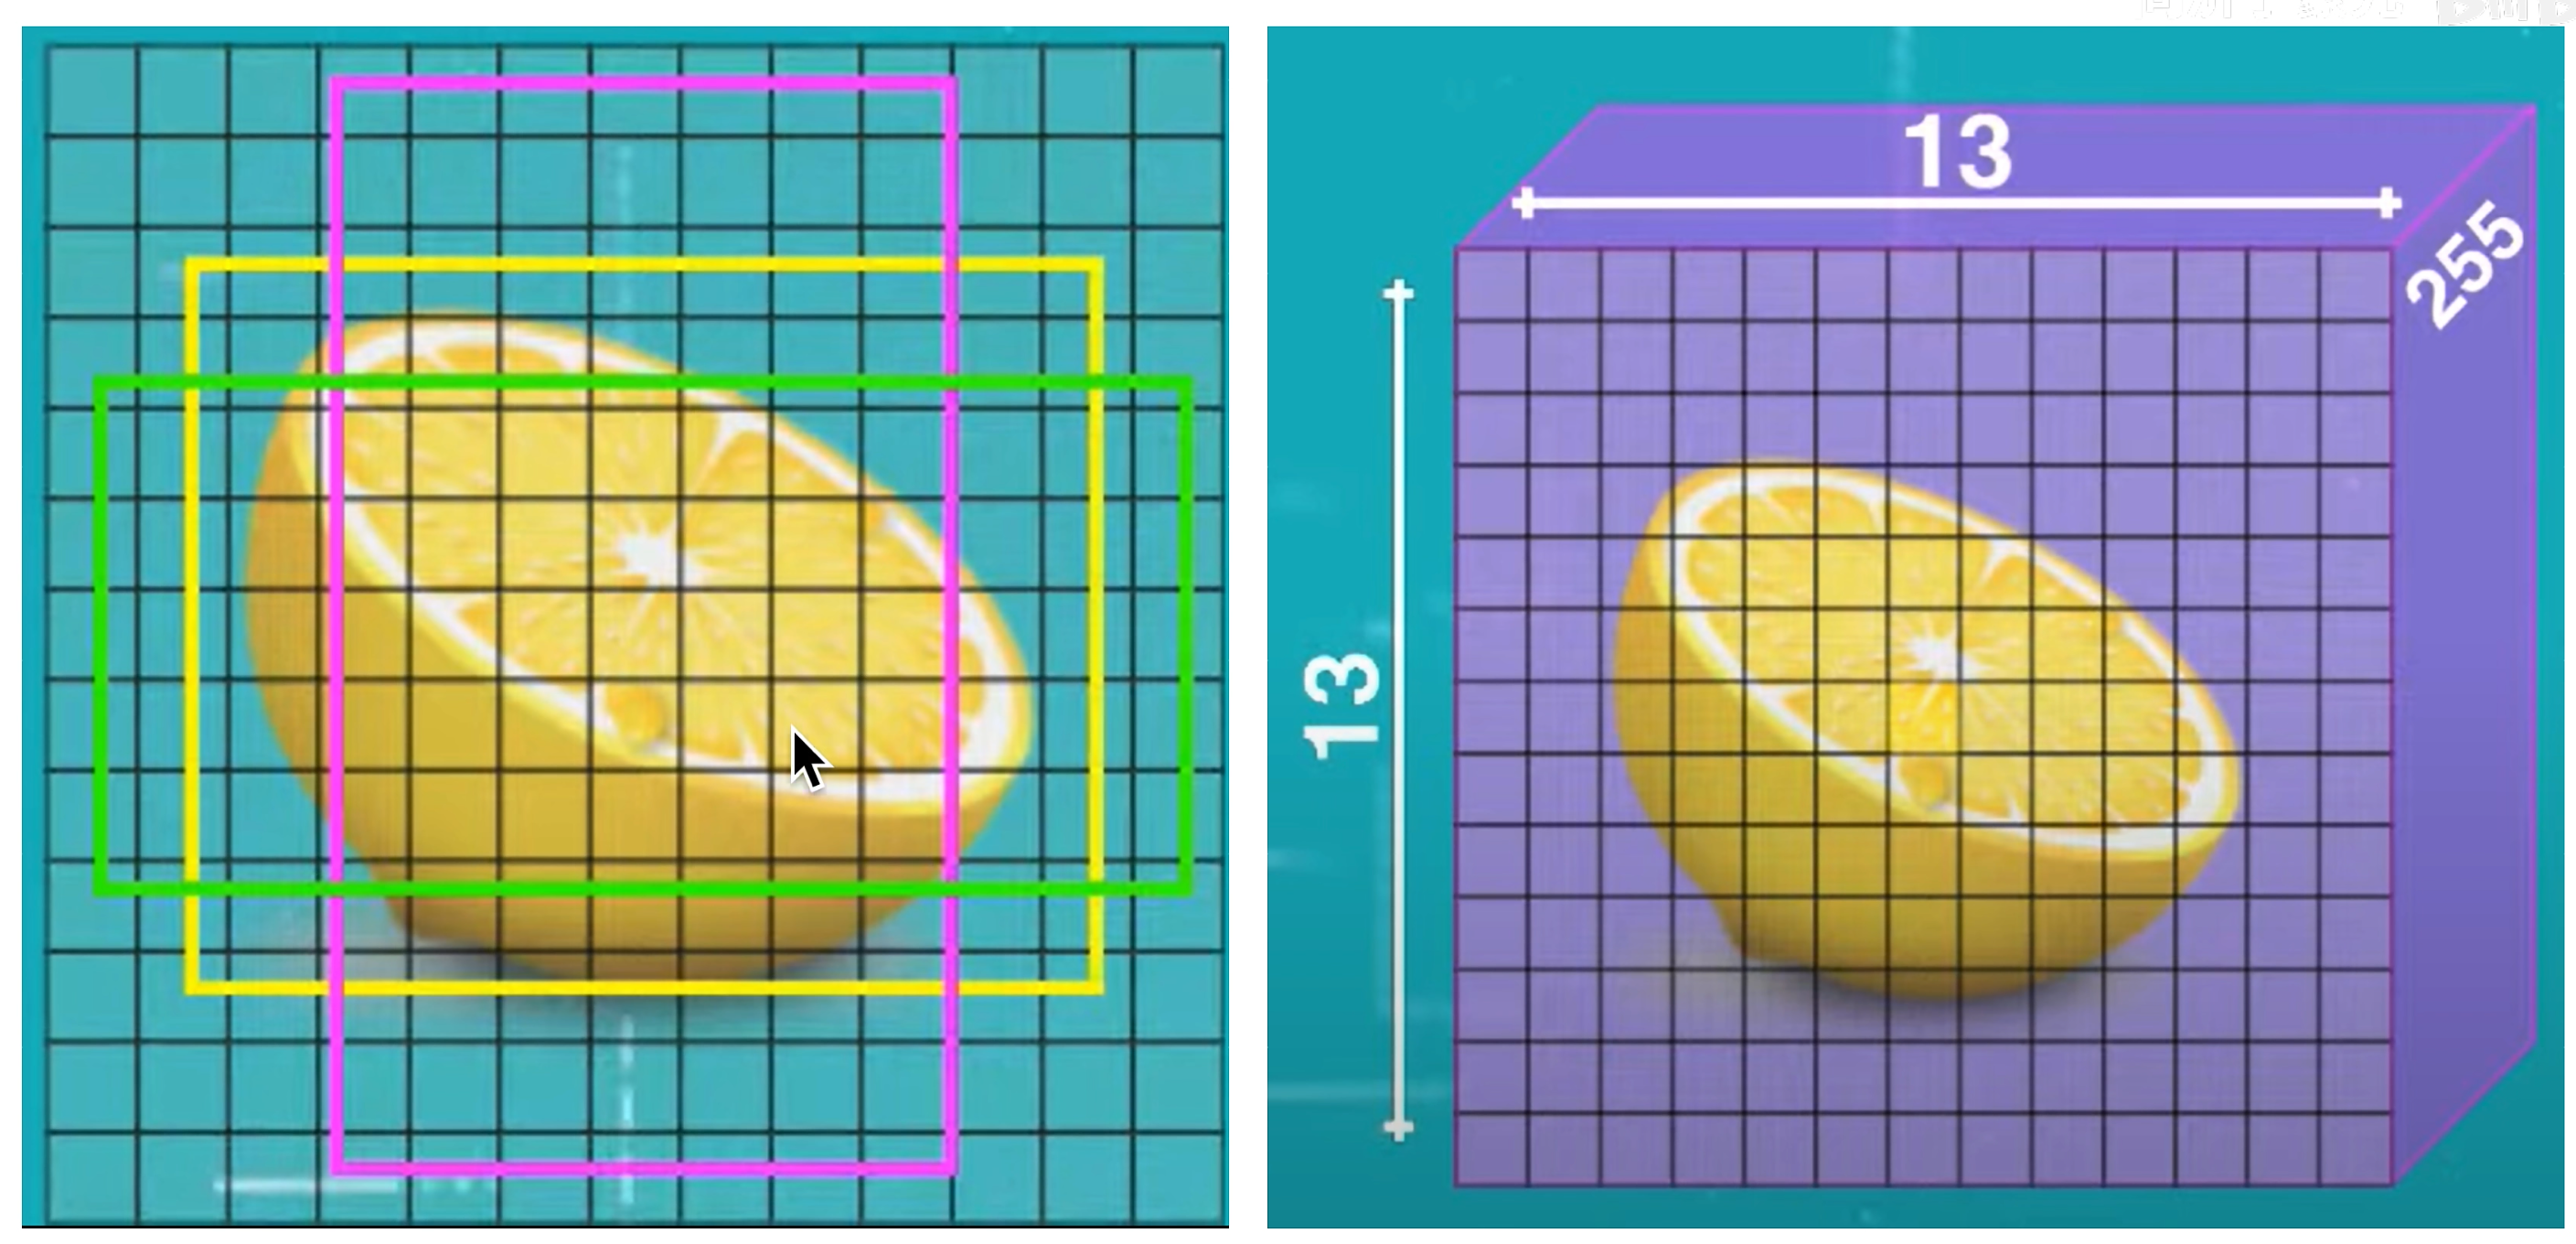
- 这次与 YOLOv1 不同, 不是看候选框的置信度, 而是与指定 GT 框做 IOU, IOU 最大的候选框作为正样本; 剩下的与指定 GT 框的 IOU 大于手动指定阈值(如 0.5), 则忽略; 其他候选框作为负样本.
-
-
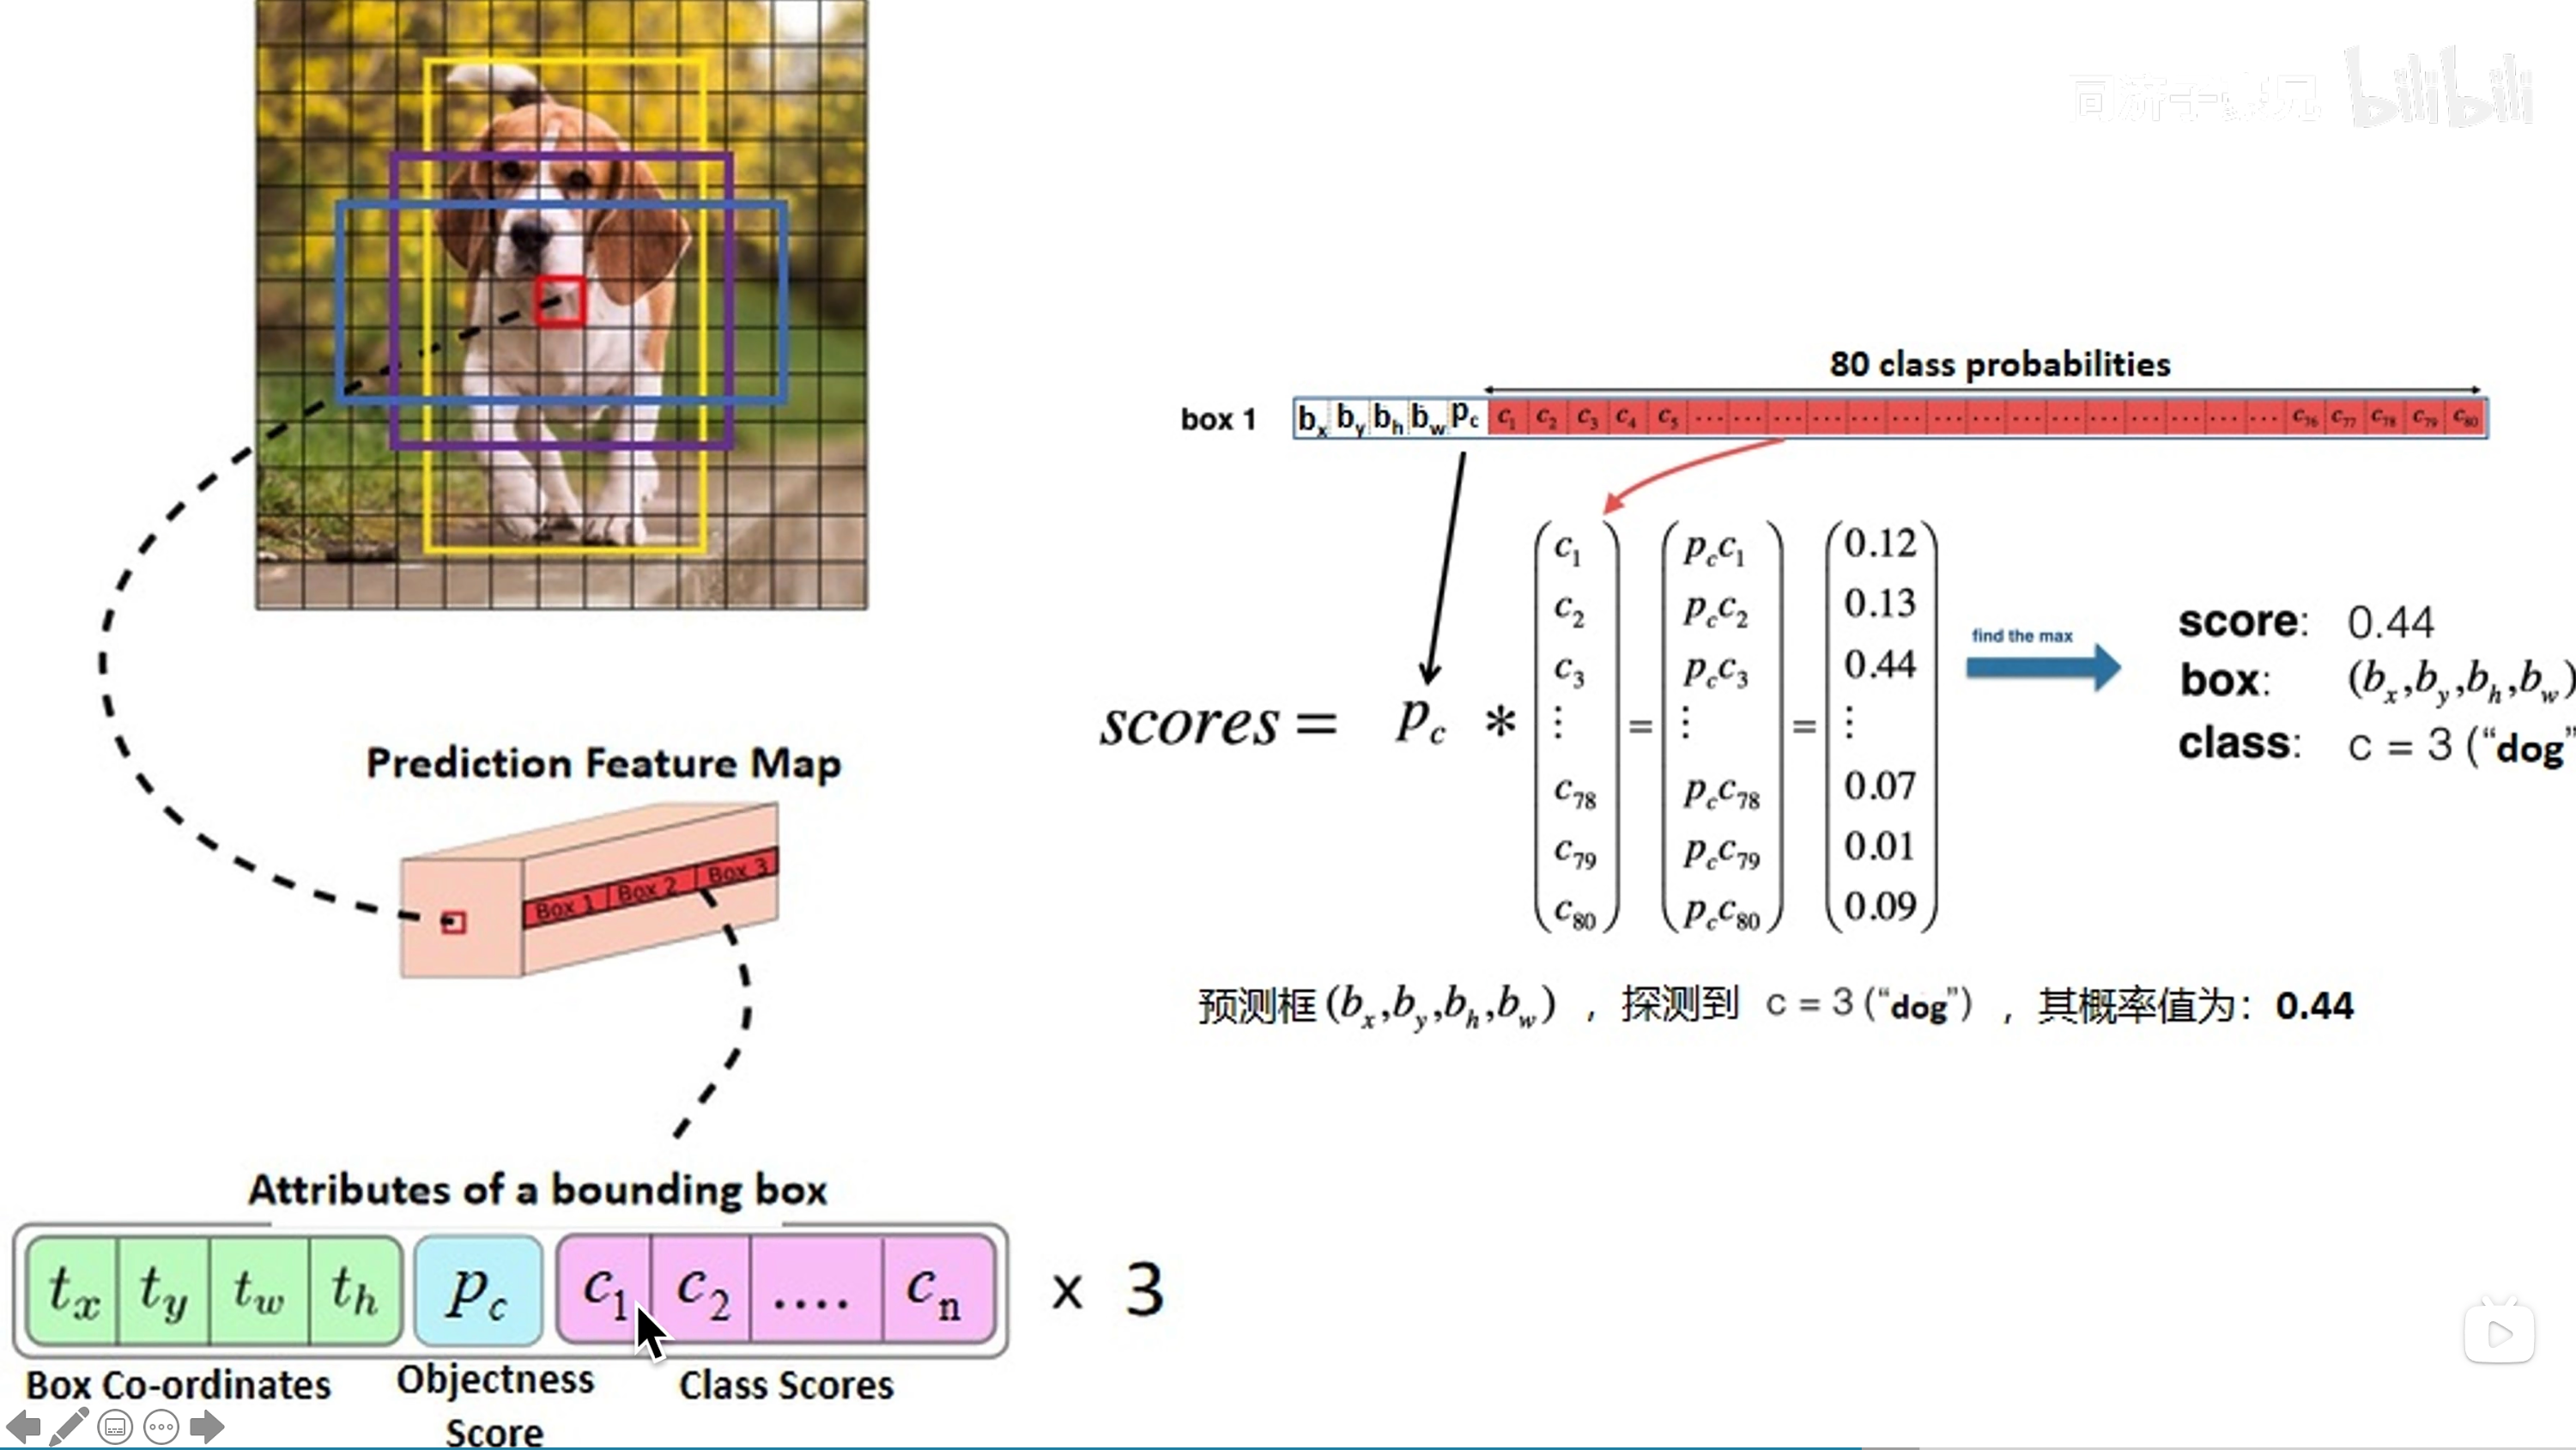
分类预测置信度
获取预测分类的置信度方法: 候选框的置信度 x 类别的置信度.
-
损失 Loss
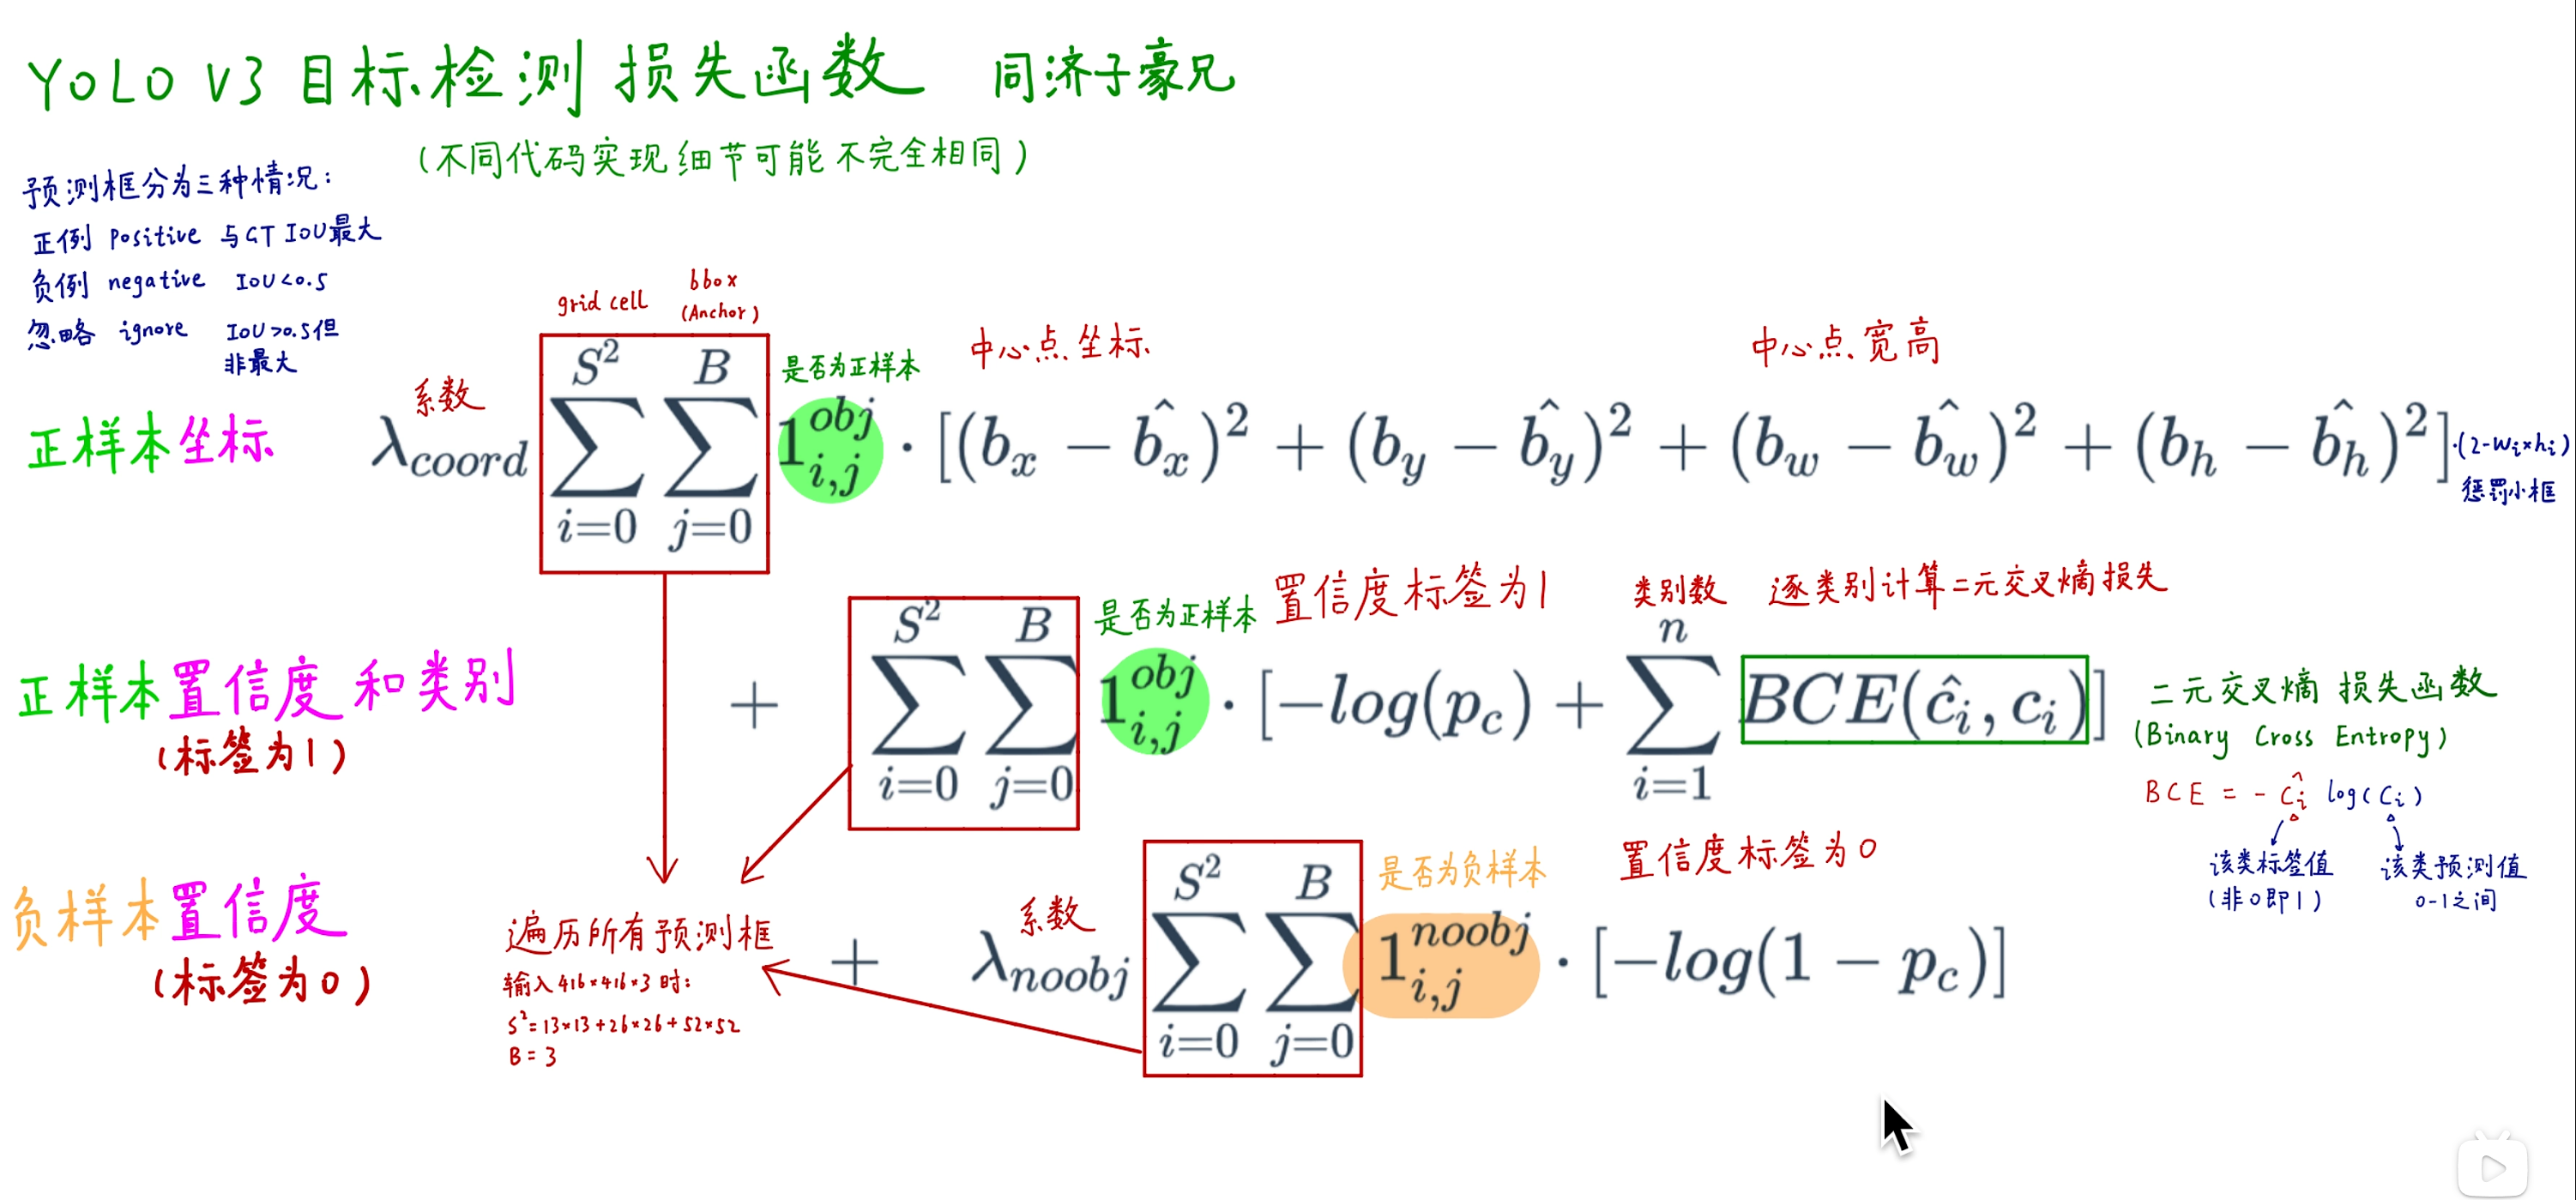
- 遍历所有候选框, 当输入尺寸为 $416*416*3$ 时, $S^2=13^2+26^2+52^2$ ← 三个尺度; $B=3$ ← 每个单元格 3 个候选框
- 正样本
- 正样本候选框回归损失, $x,y,w,h$ 与 GT 的距离.
- 正样本分类损失, 逐类别计算二元交叉熵损失 + $-log(候选框粗选置信度)$.
- 负样本
- 负样本候选框粗选损失, $-log(1-候选框粗选置信度)$.
-
模型训练过程
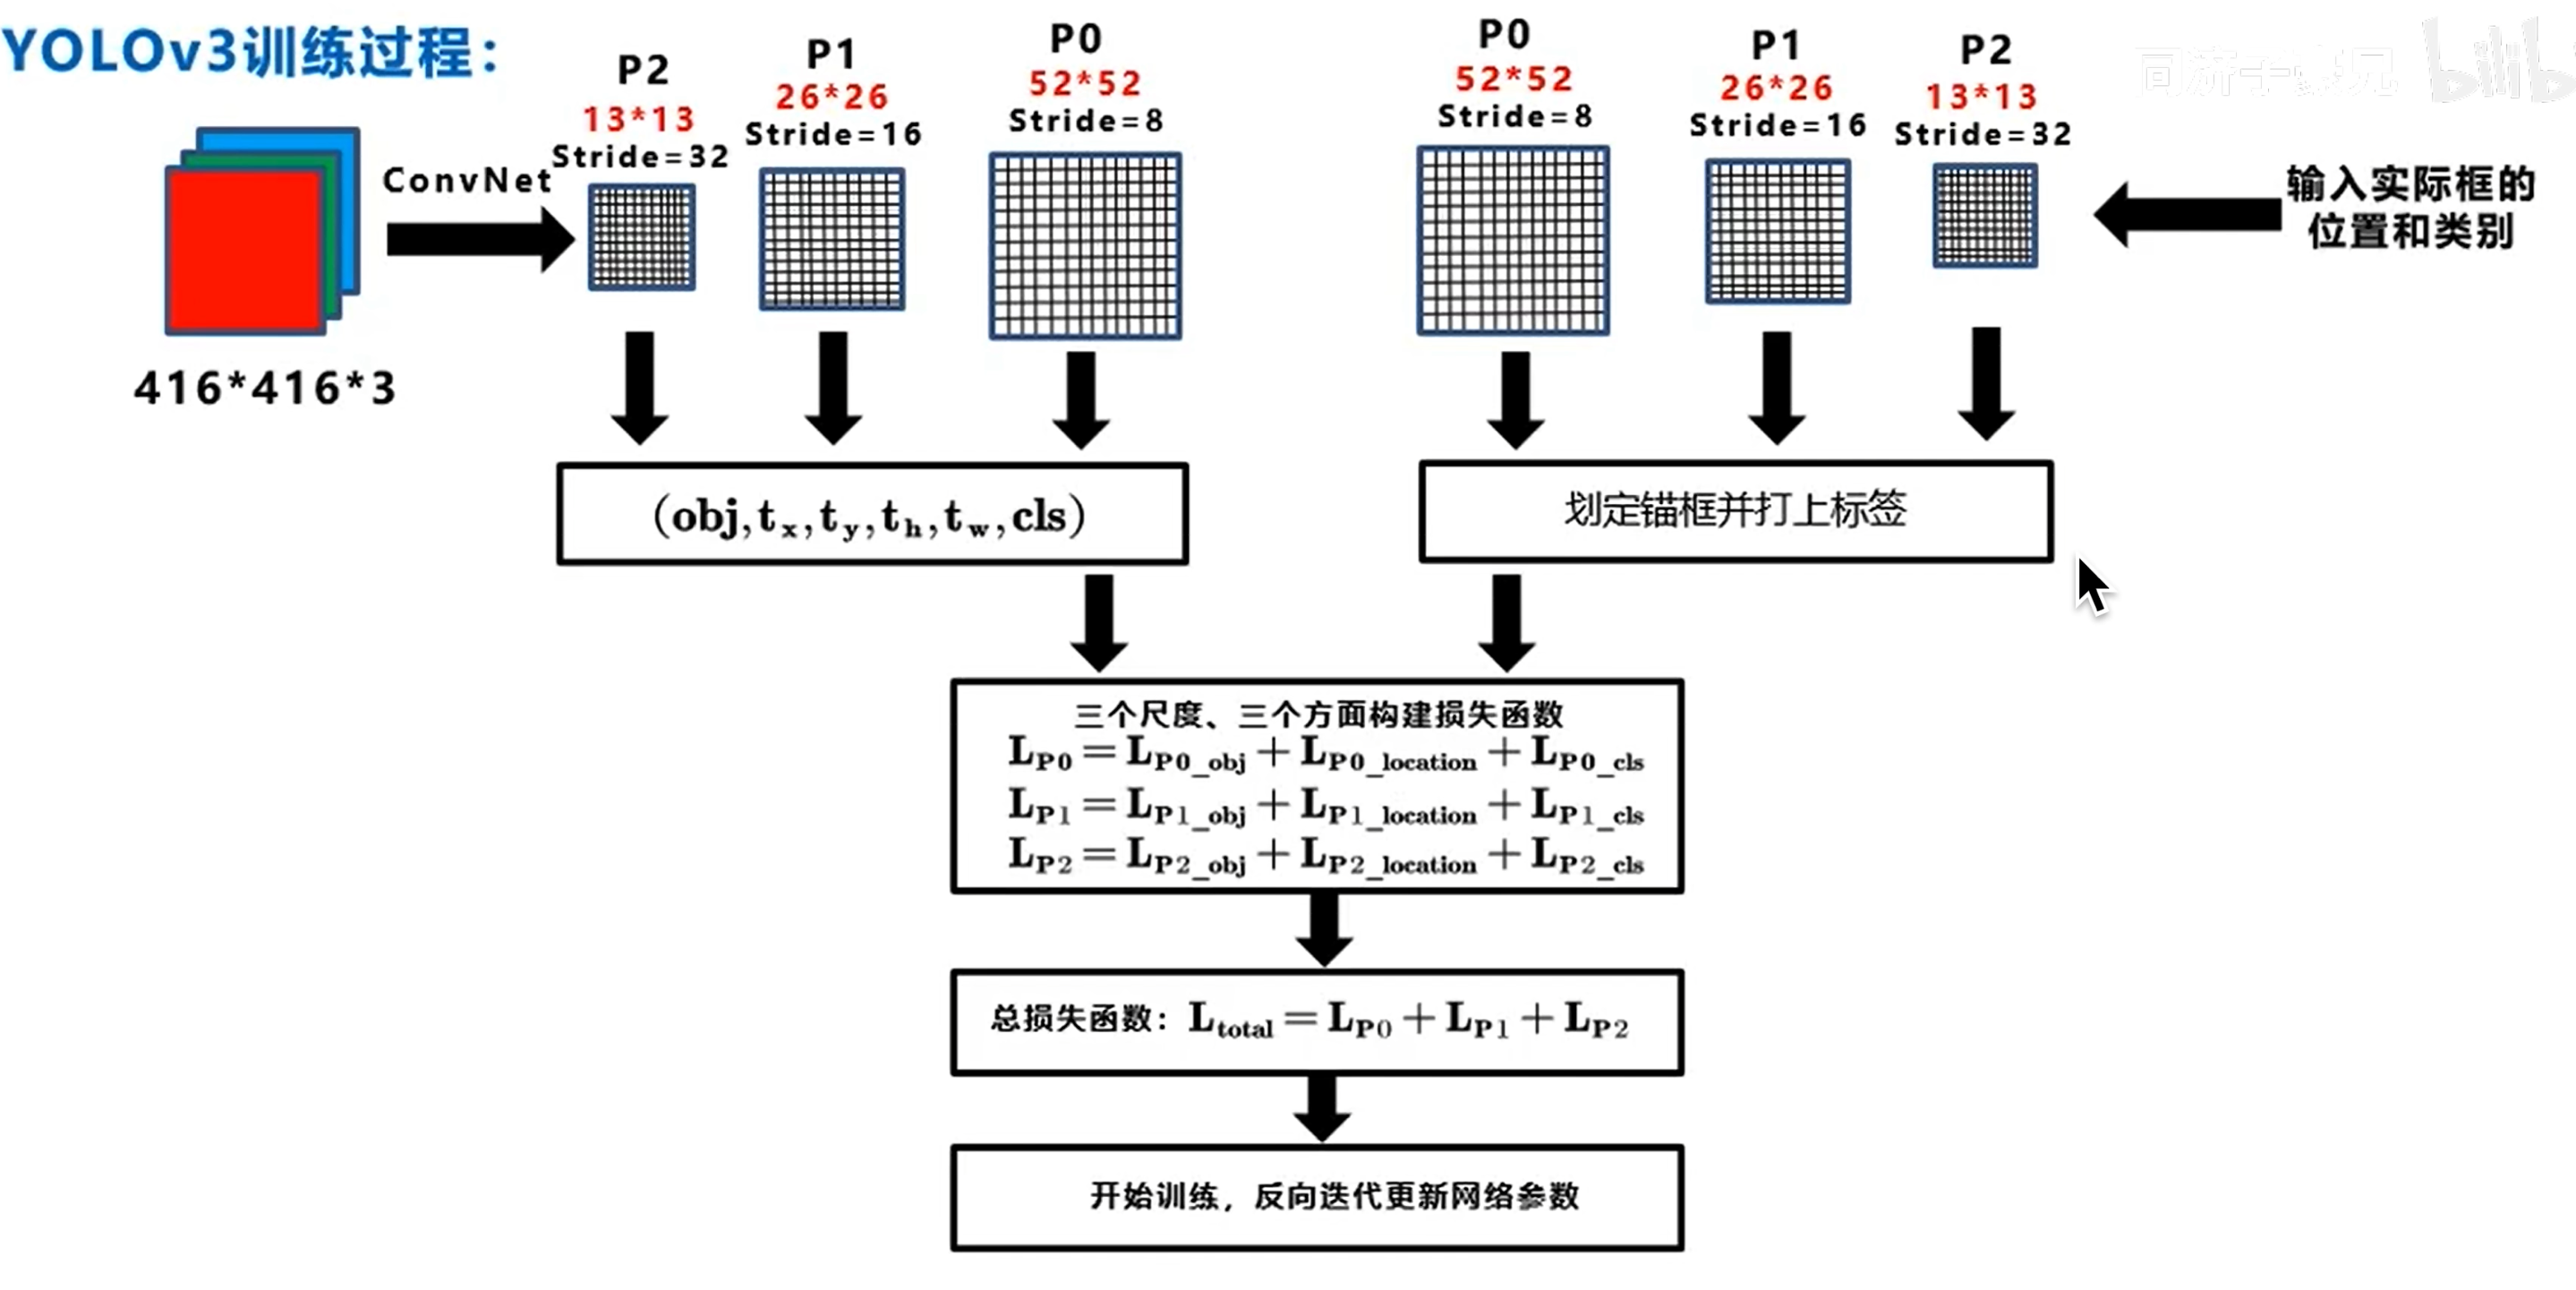
- 实际的 GT 数据也需要换算到相应的单元格, 找到对应的 $x,y,w,h$.
-
模型测试过程
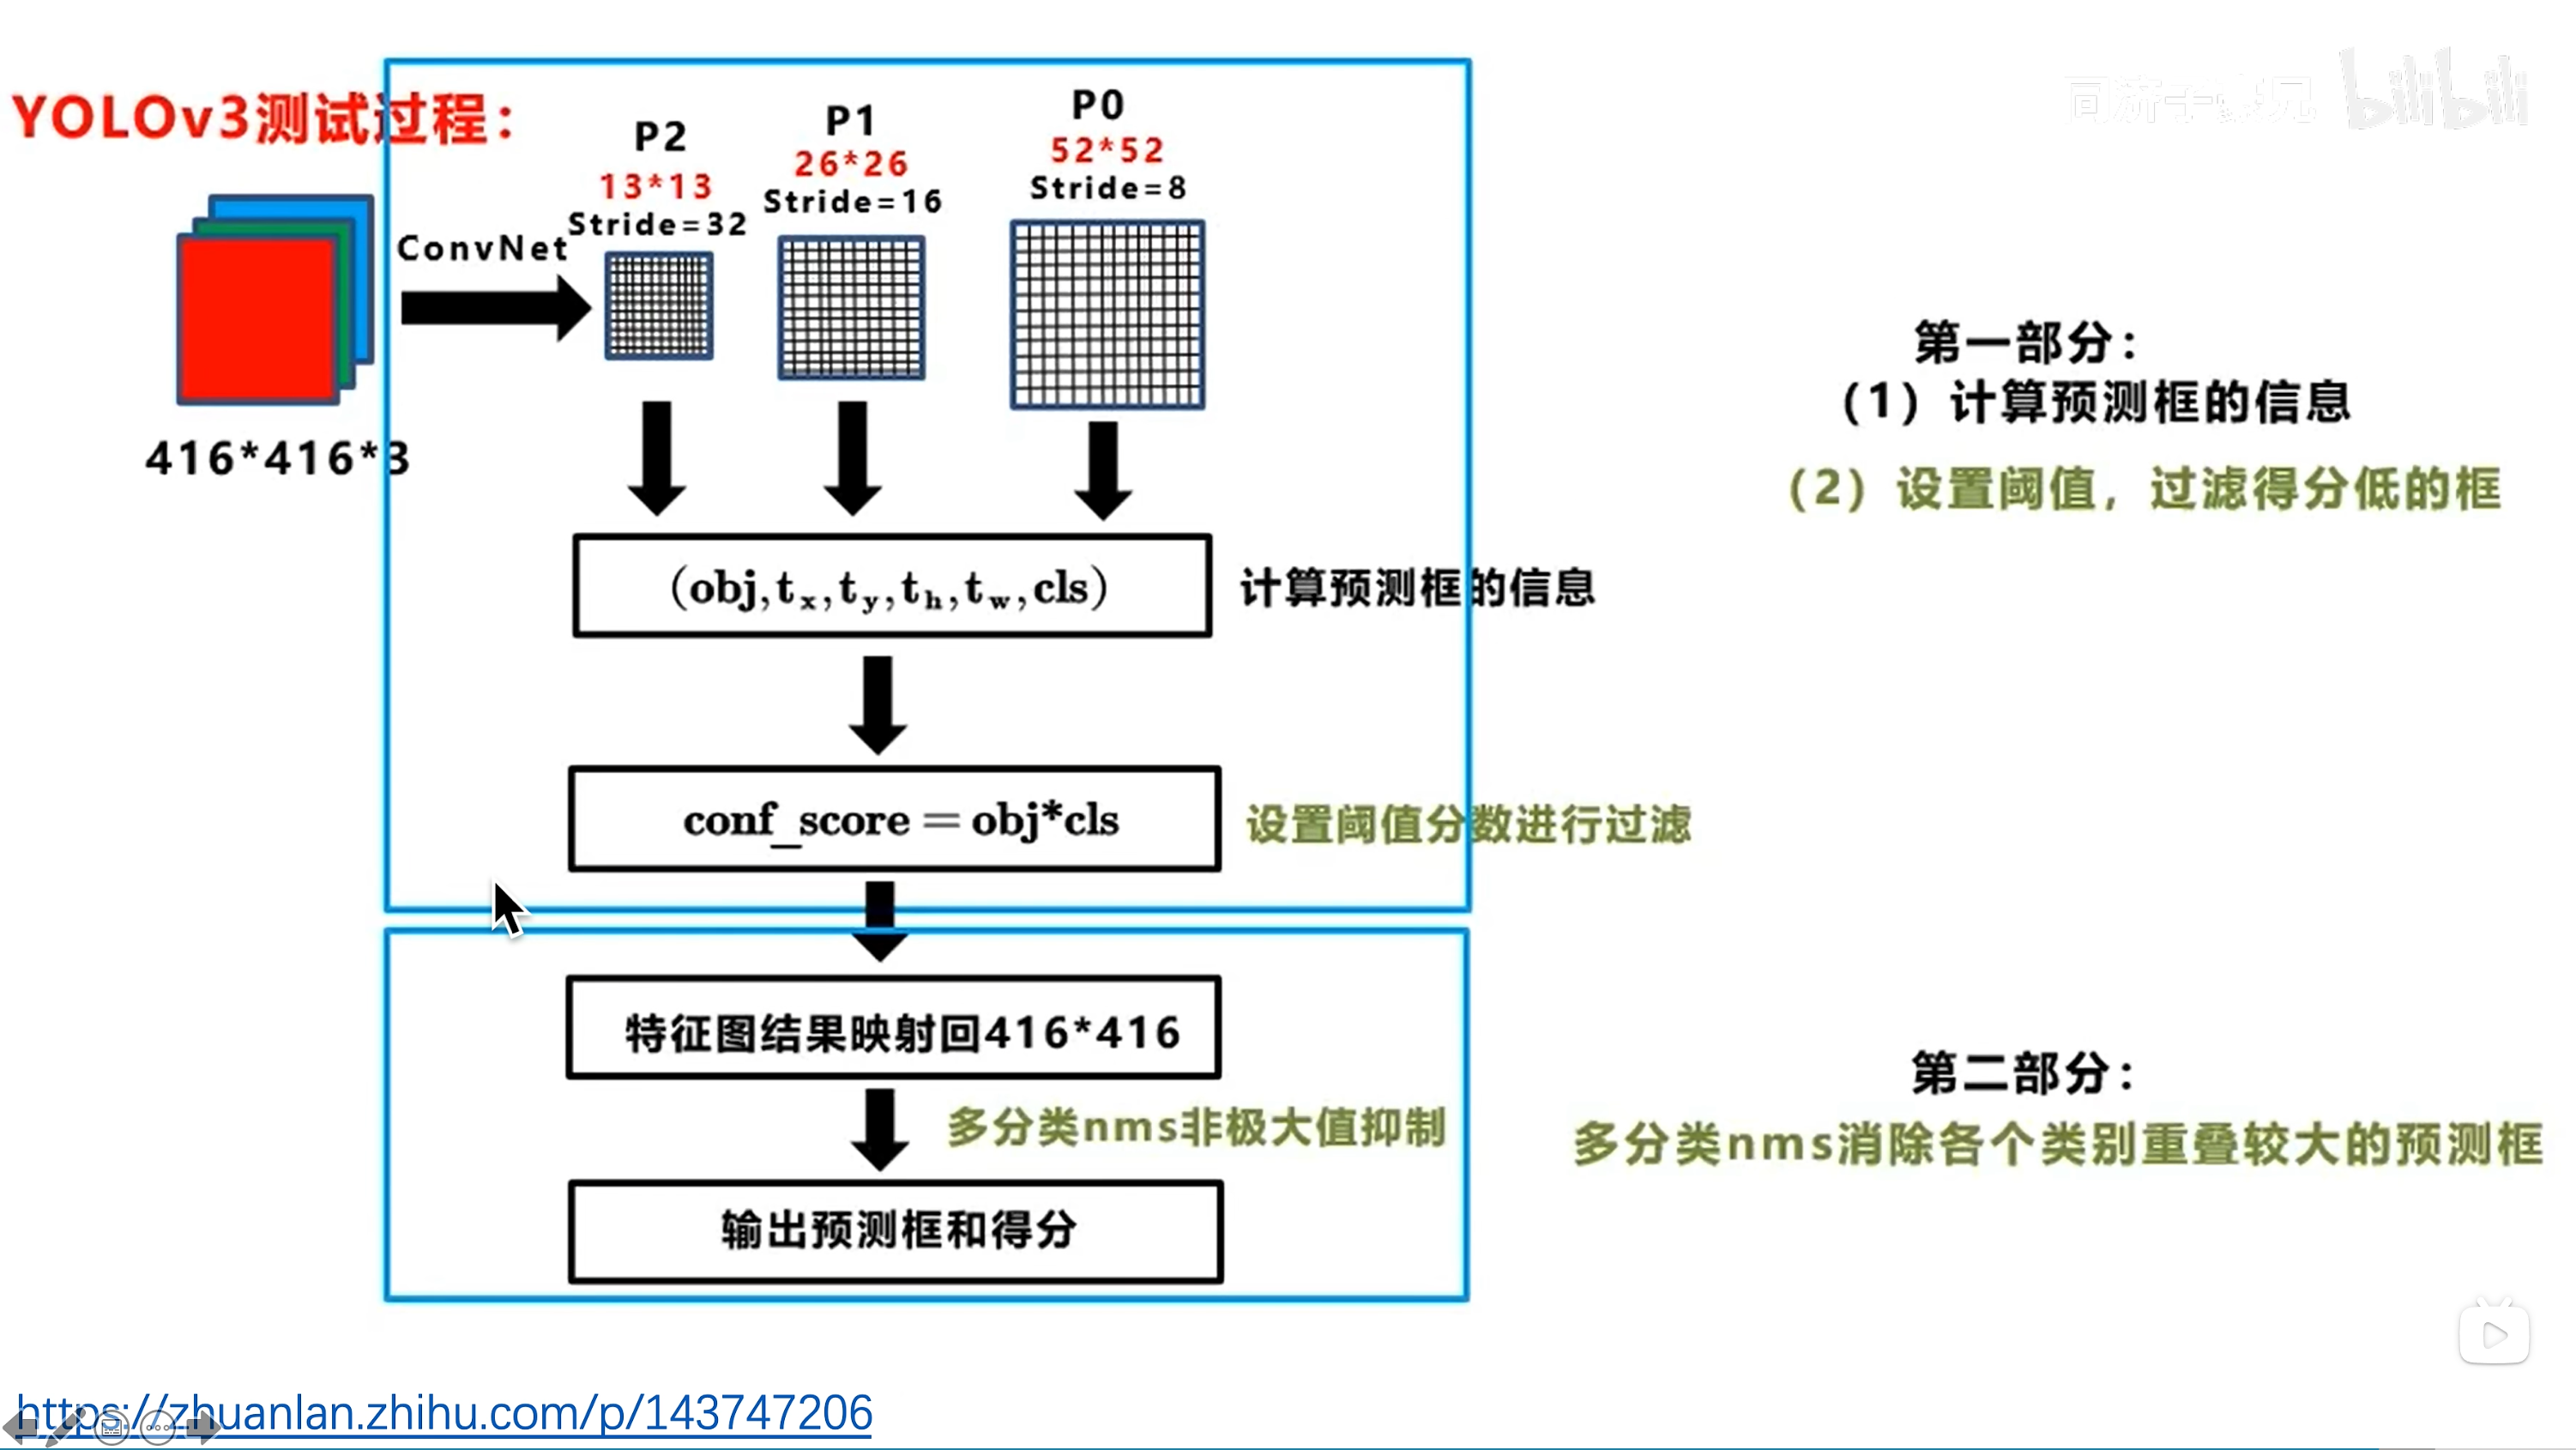
- 手动设置置信度阈值
- 多分类非极大值抑制
5.5.4. YOLOv4
深入浅出Yolo系列之Yolov3&Yolov4&Yolov5&Yolox核心基础知识完整讲解
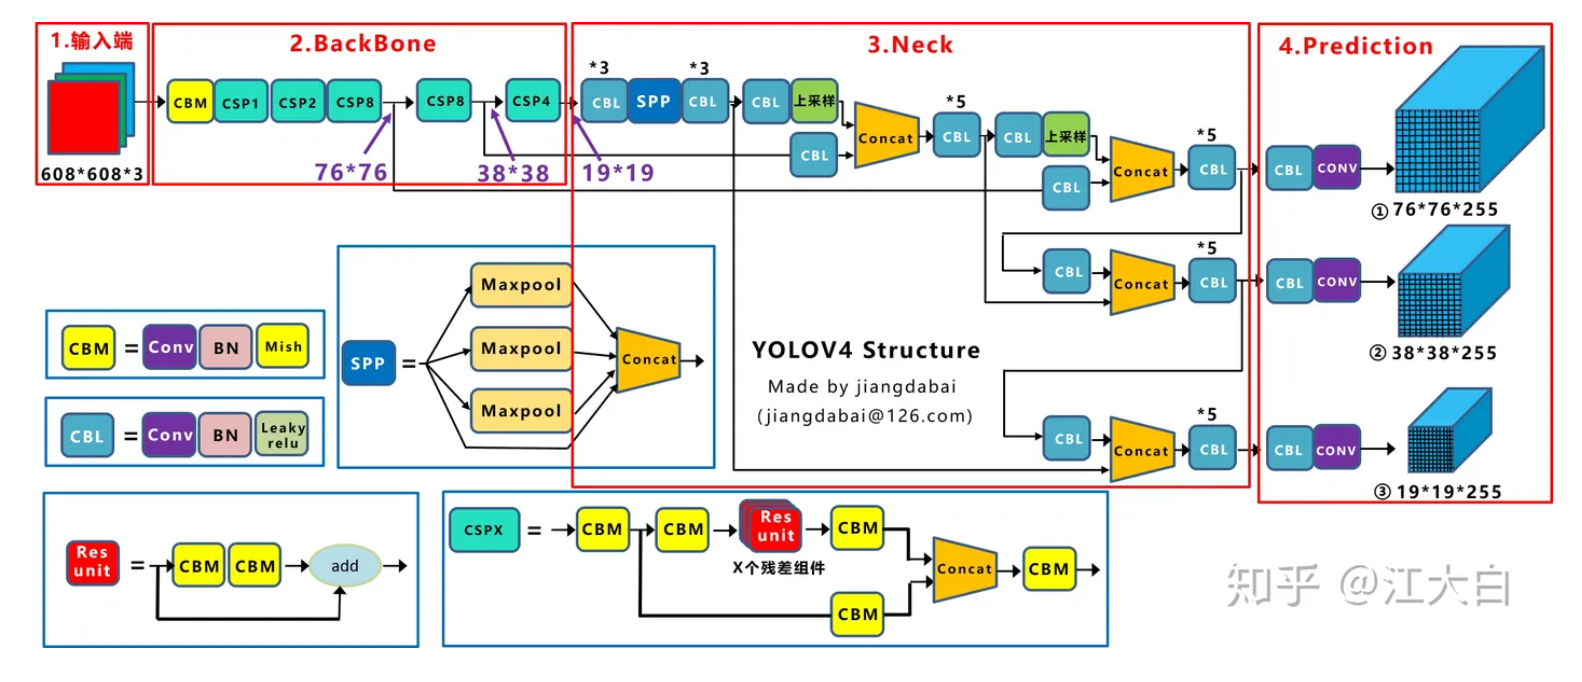
-
预处理 数据增强
Mosaic 数据增强
对输入图片进行了随机缩放, 随机裁剪, 随机排布.
用途:
对于模型来说, 小目标的 AP 通常比普通目标低. 而COCO数据集包含大量的分布不均匀的小目标.
-
Backbone 部分的更新
CSPDarkNet-53 代替了 DarkNet-53;
网络中的一些改动:
-
在 Backbone 部分用 CBM 模块代替了 CBL 模块; 使用 Mish 激活函数代替 Leaky ReLU.
- 优点: 增强卷积的学习能力, 在轻量化的同时保持准确性; 降低内存消耗.
- 理论上对负值的轻微允许可以获得更好的梯度流, 而不是像 ReLU 中那样的硬零边界, 而且平滑的激活函数允许更好的信息深入神经网络, 从而得到更好的准确性和泛化.
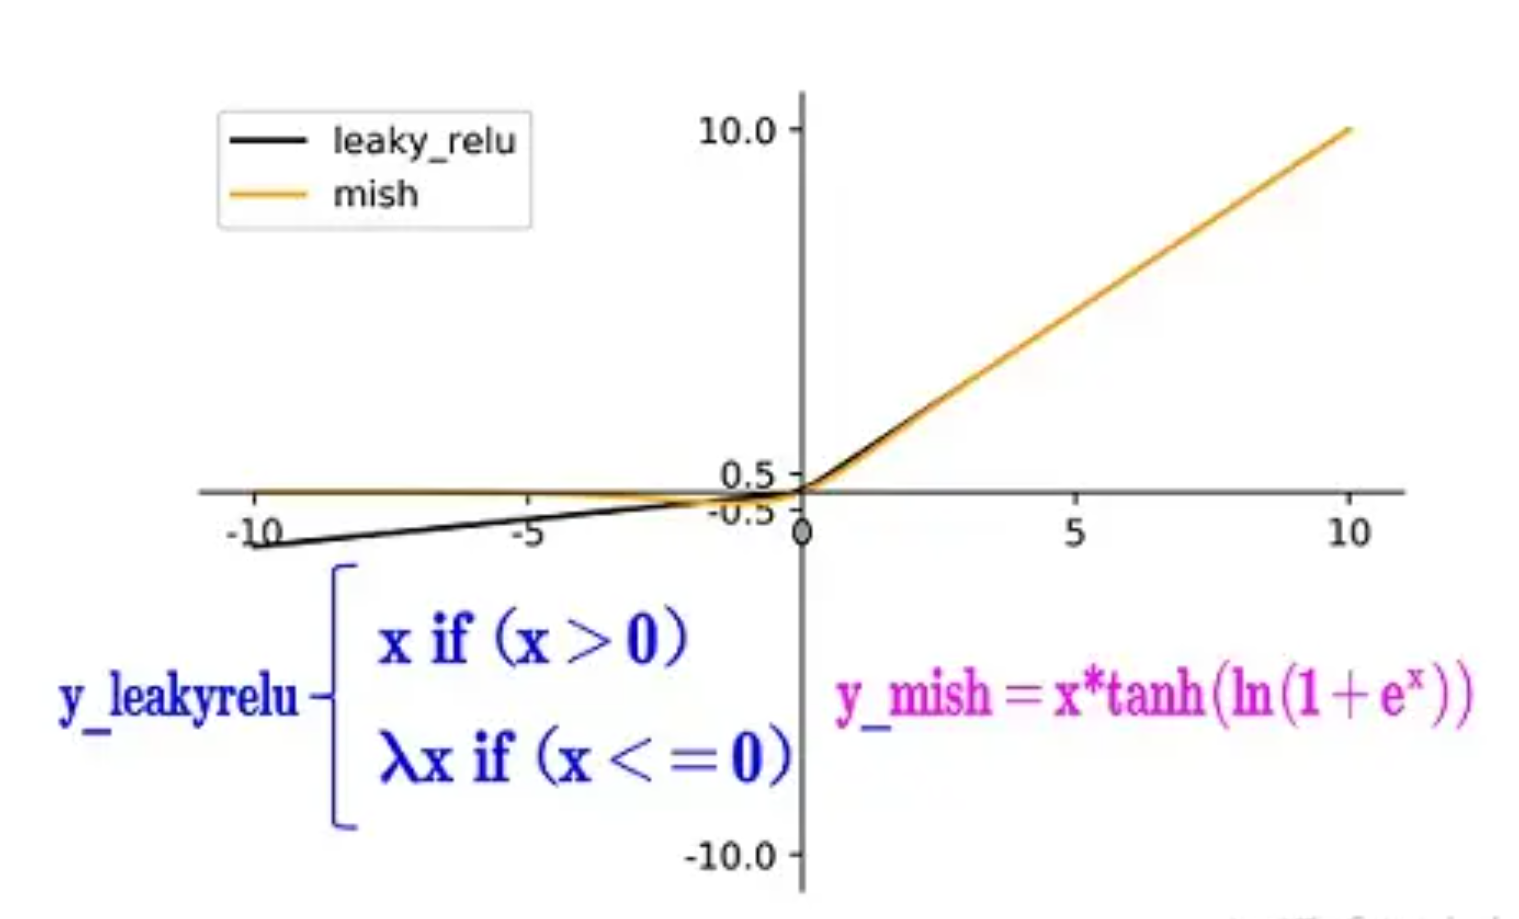
-
CSP 模块代替了残差模块
增强CNN学习能力的Backbone:CSPNet - pprp - 博客园
-
CSPNet 的作者认为推理计算量过高是因为网络优化中的梯度信息重复造成的.
-
CSPDenseNet 在学习 DenseNet 重复使用各尺度特征的梯度信息的同时, 通过截断梯度流来防止过多的重复梯度信息.
- DenseNet 是 ResNet 后推出的网络, 更加的激进, 通过前后层的密集连接 (dense connection) 使每一层都接收到前面所有层的信息; 同时通过融合不同层的特征图, 来实现特征的重用 (feature reuse). 这两个优点增强了 DenseNet 的性能.
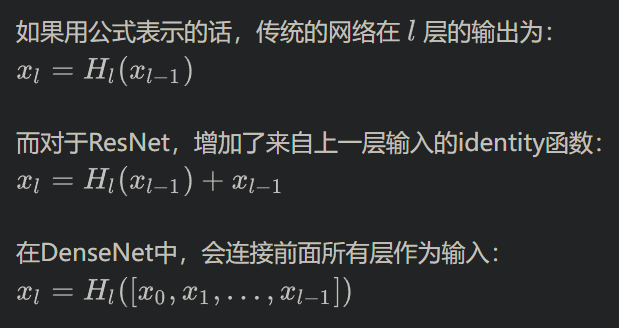
- 其中的 $H_l$ 函数表述非线性转化函数 (non-linear transformation), 其中可以包含 BN, ReLU, Pooling 和 Conv.
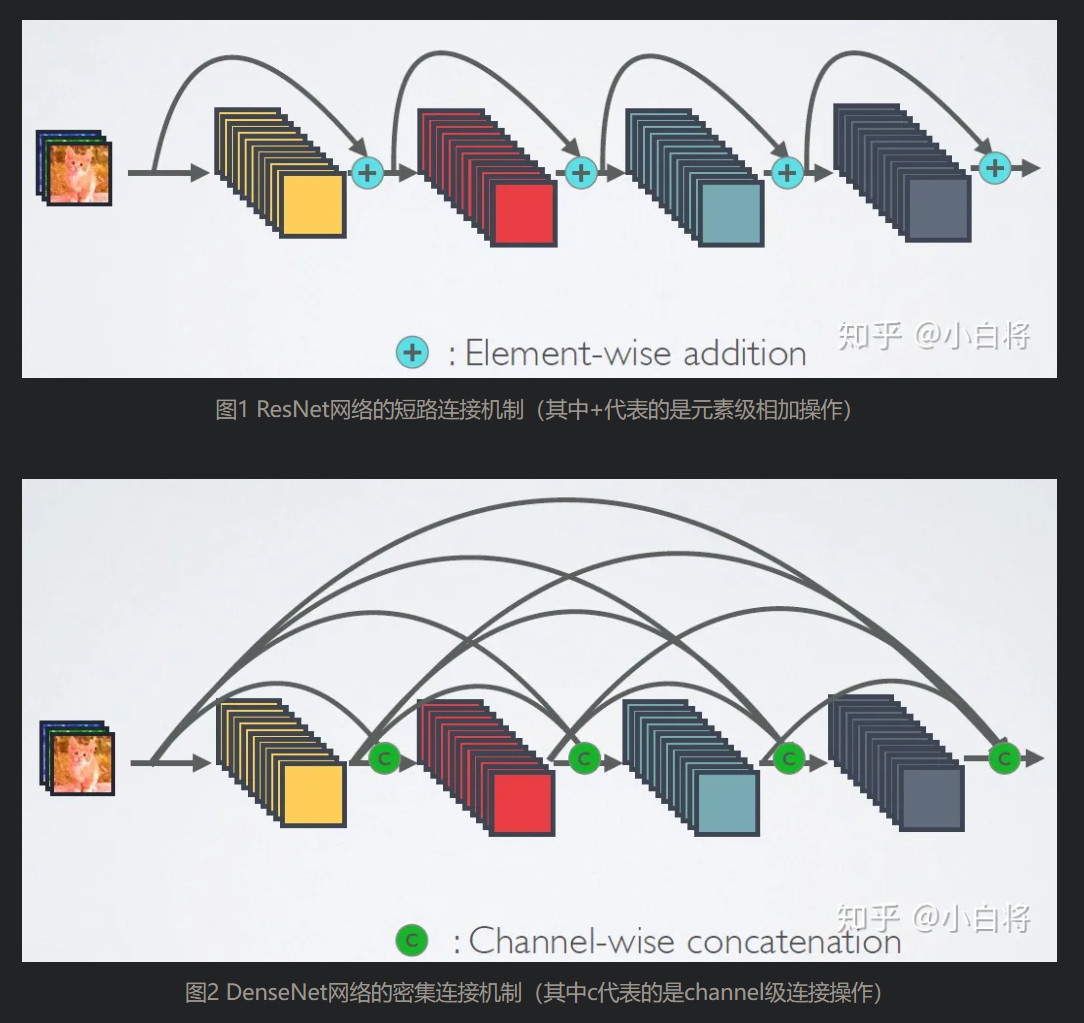
DenseNet 的正向传播
$$ \begin{aligned}& \mathbf{x}_1=\mathbf{w}_1{ }^* \mathbf{x}_0 \\& \mathbf{x}_2=\mathbf{w}_2{ }^*\left[\mathbf{x}_0, \mathbf{x}_1\right] \\& \vdots \\& \mathbf{x}_{\mathbf{k}}=\mathbf{w}_{\mathbf{k}}{ }^*\left[\mathbf{x}_{\mathbf{0}}, \mathbf{x}_1, \ldots, \mathbf{x}_{\mathrm{k}-1}\right]\end{aligned} $$DenseNet 的反向传播
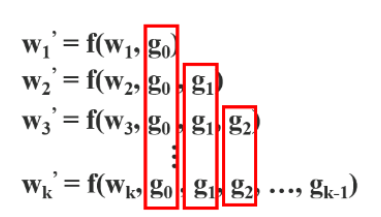
- 可以发现大量的梯度信息被用来更新不同尺度层的权重.
CSPDenseNet 的正向传播
$$ \begin{aligned}& \mathbf{x}_{\mathrm{k}}=\mathbf{w}_{\mathrm{k}} *\left[\mathbf{x}_0,, \mathbf{x}_1, \ldots, \mathbf{x}_{\mathrm{k}-1}\right] \\& \mathbf{x}_{\mathrm{T}}=\mathbf{w}_{\mathrm{T}}*\left[\mathbf{x}_0,, \mathbf{x}_1, \ldots, \mathbf{x}_{\mathrm{k}}\right] \\& \mathbf{x}_{\mathrm{U}}=\mathbf{w}_{\mathrm{U}} *\left[\mathbf{x}_0, \mathbf{x}_{\mathrm{T}}\right]\end{aligned} $$CSPDenseNet 的反向传播
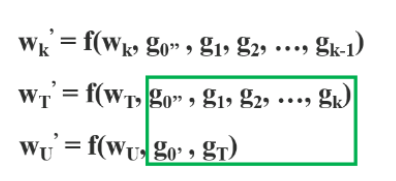
- 可以看到密集层和部分过度层不包含另一方重复的梯度信息, 由此截断了梯度流, 防止了重复的梯度信息传递.
-
CSPX 模块包含 $5+2*X$ 个卷积层, 模块中的第一个卷积层步长为 2, 其他卷积层的步长为 1, 导致内个 CSPX 都具有下采样 1/2 的能力.
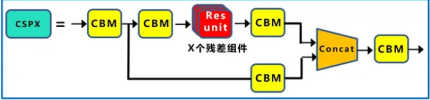
-
-
Dropblock 等于是在做 Cutout 数据增强, 在图片上挖掉一块. 这样可以影响到卷积, 而 Dropout 那样的随机开孔对卷积的影响太小. 而对于 Cutout 来说, 只能在输入层用, Dropblock 则可以用在网络中每个特征图上.
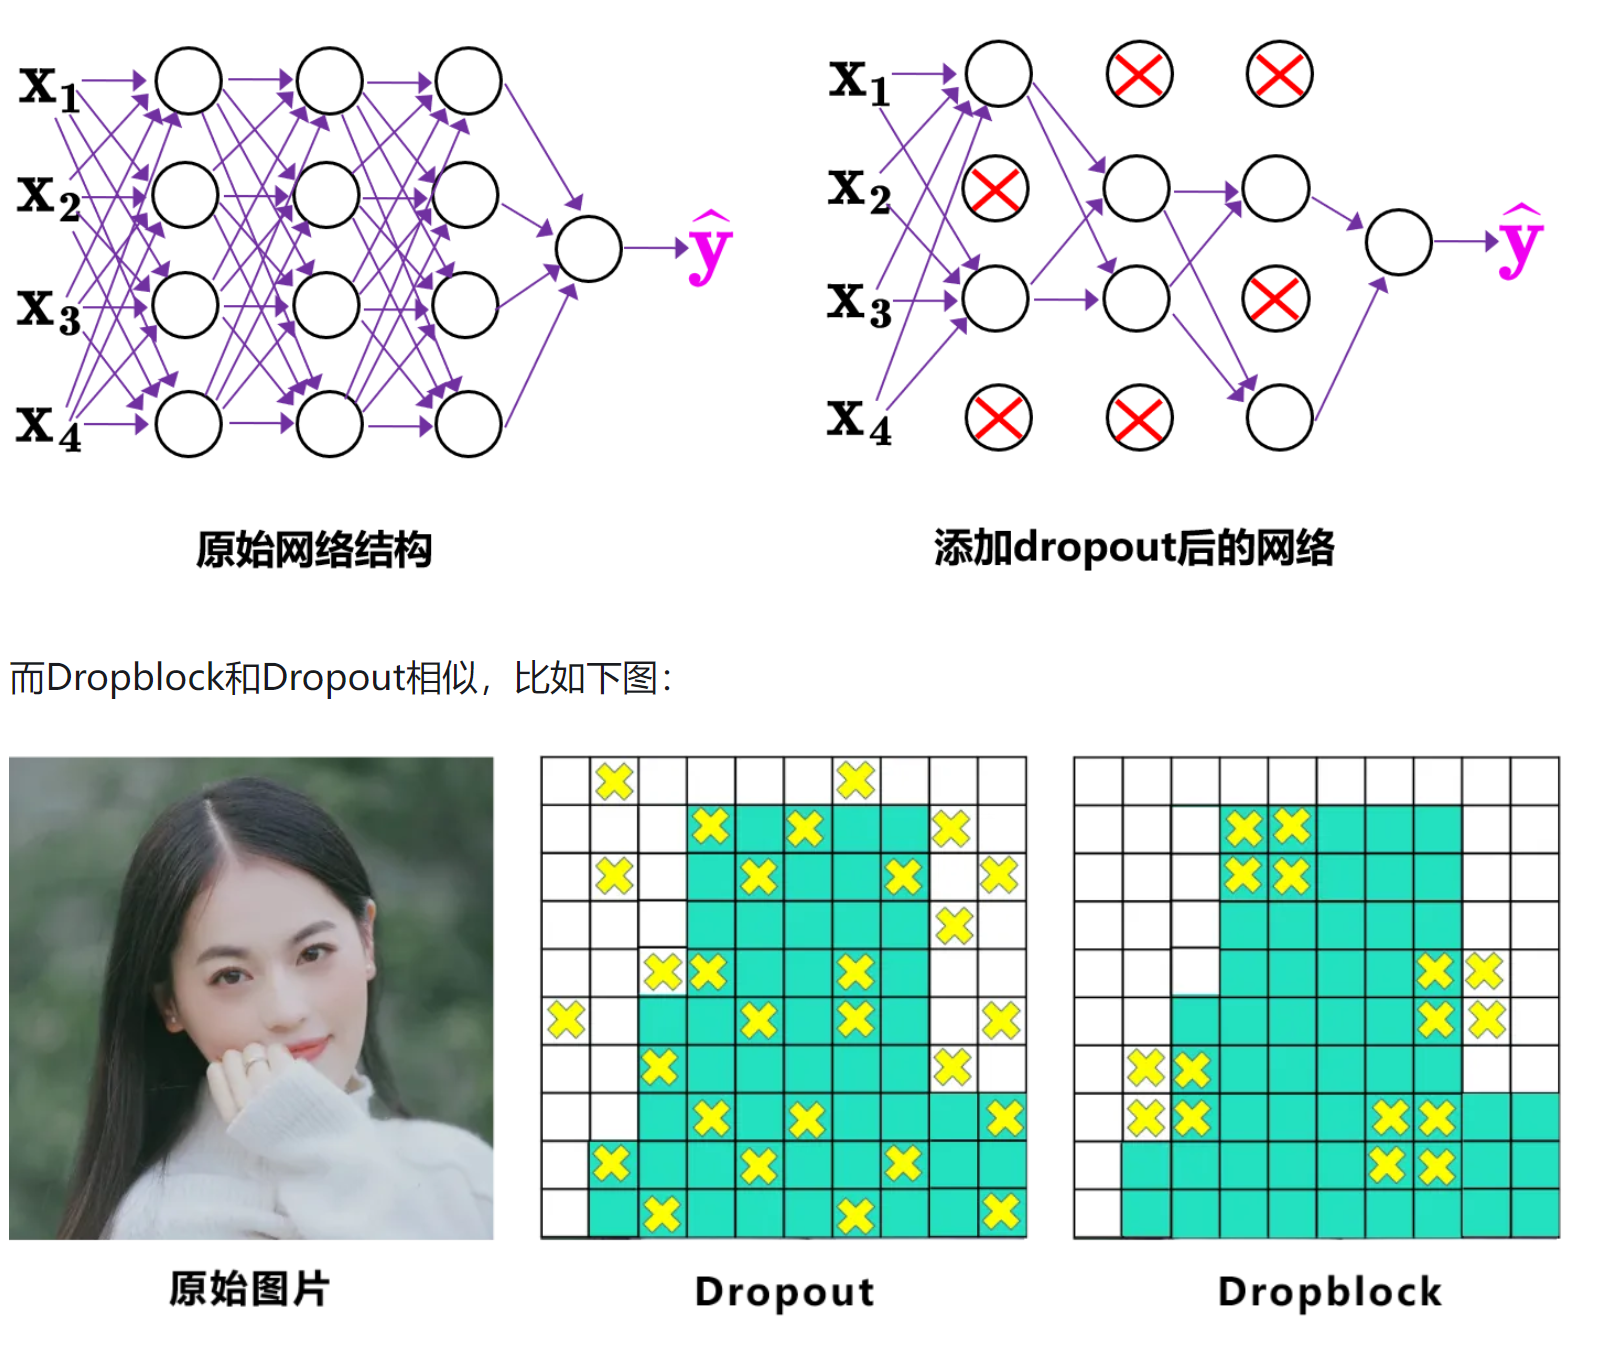
-
-
Neck 部分的更新
-
使用 SPP 模块进行多尺度融合;
-
与 YOLOv3 的 FPN 结构不同, YOLOv4 在 FPN 层后面还添加了一个自底向上的特征金字塔.
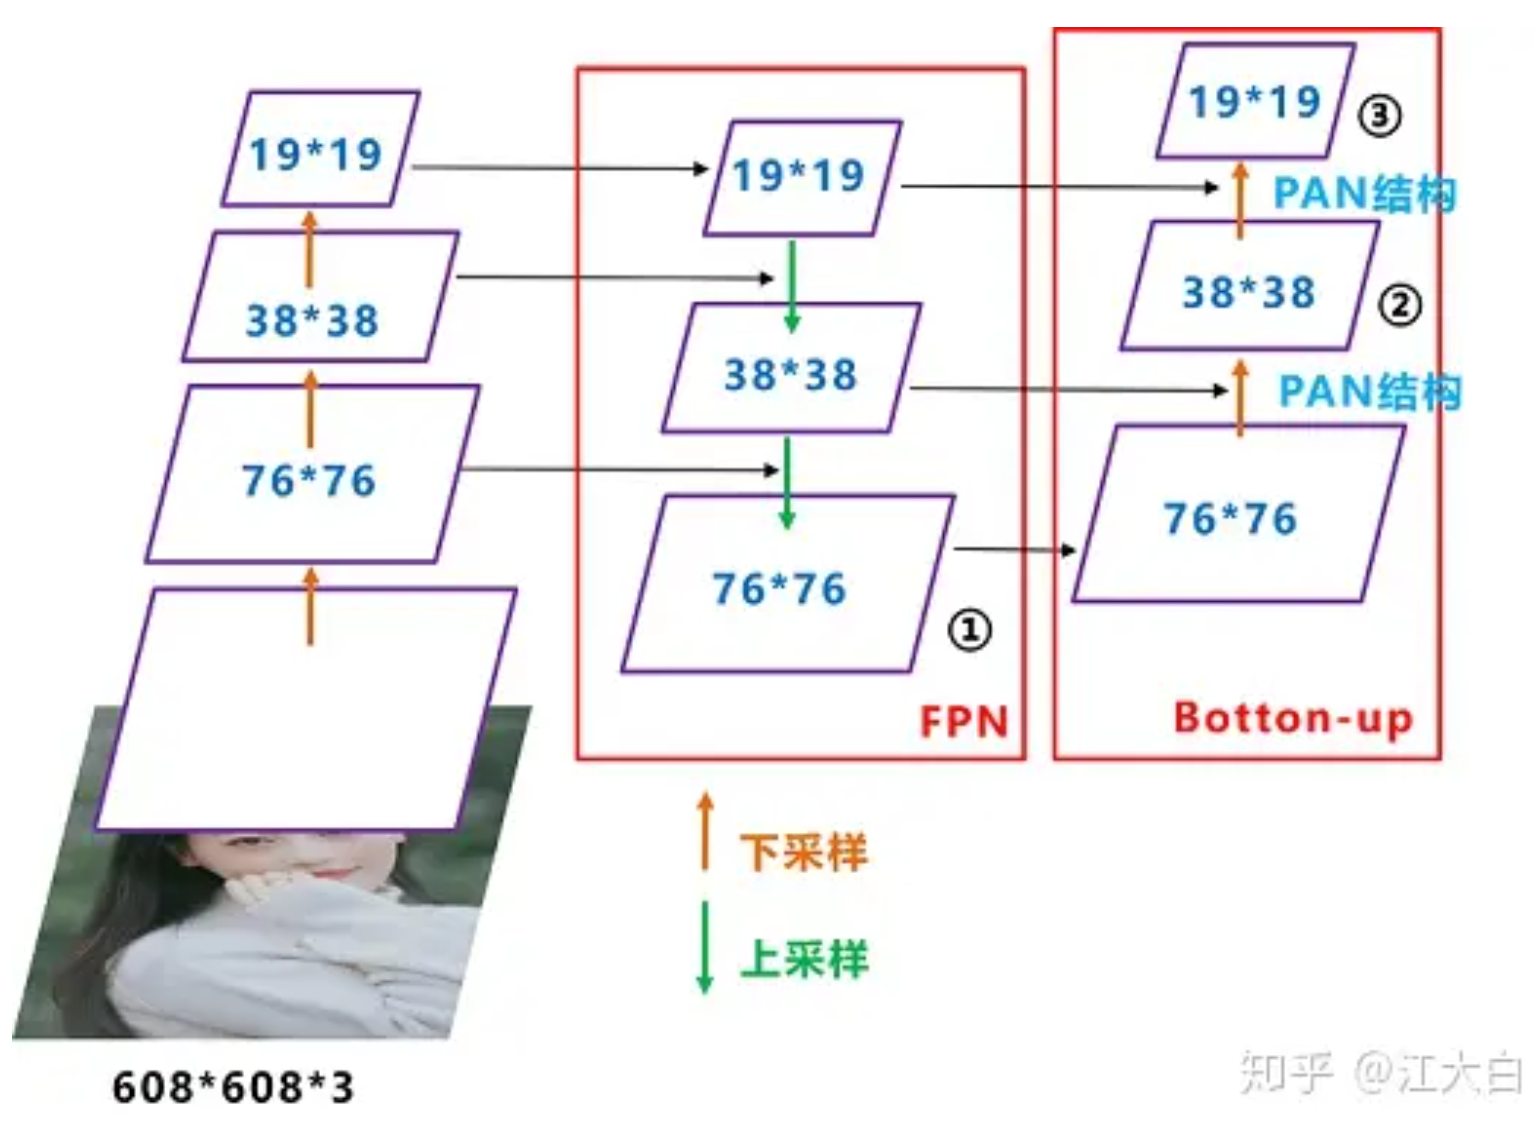
-
PAN结构
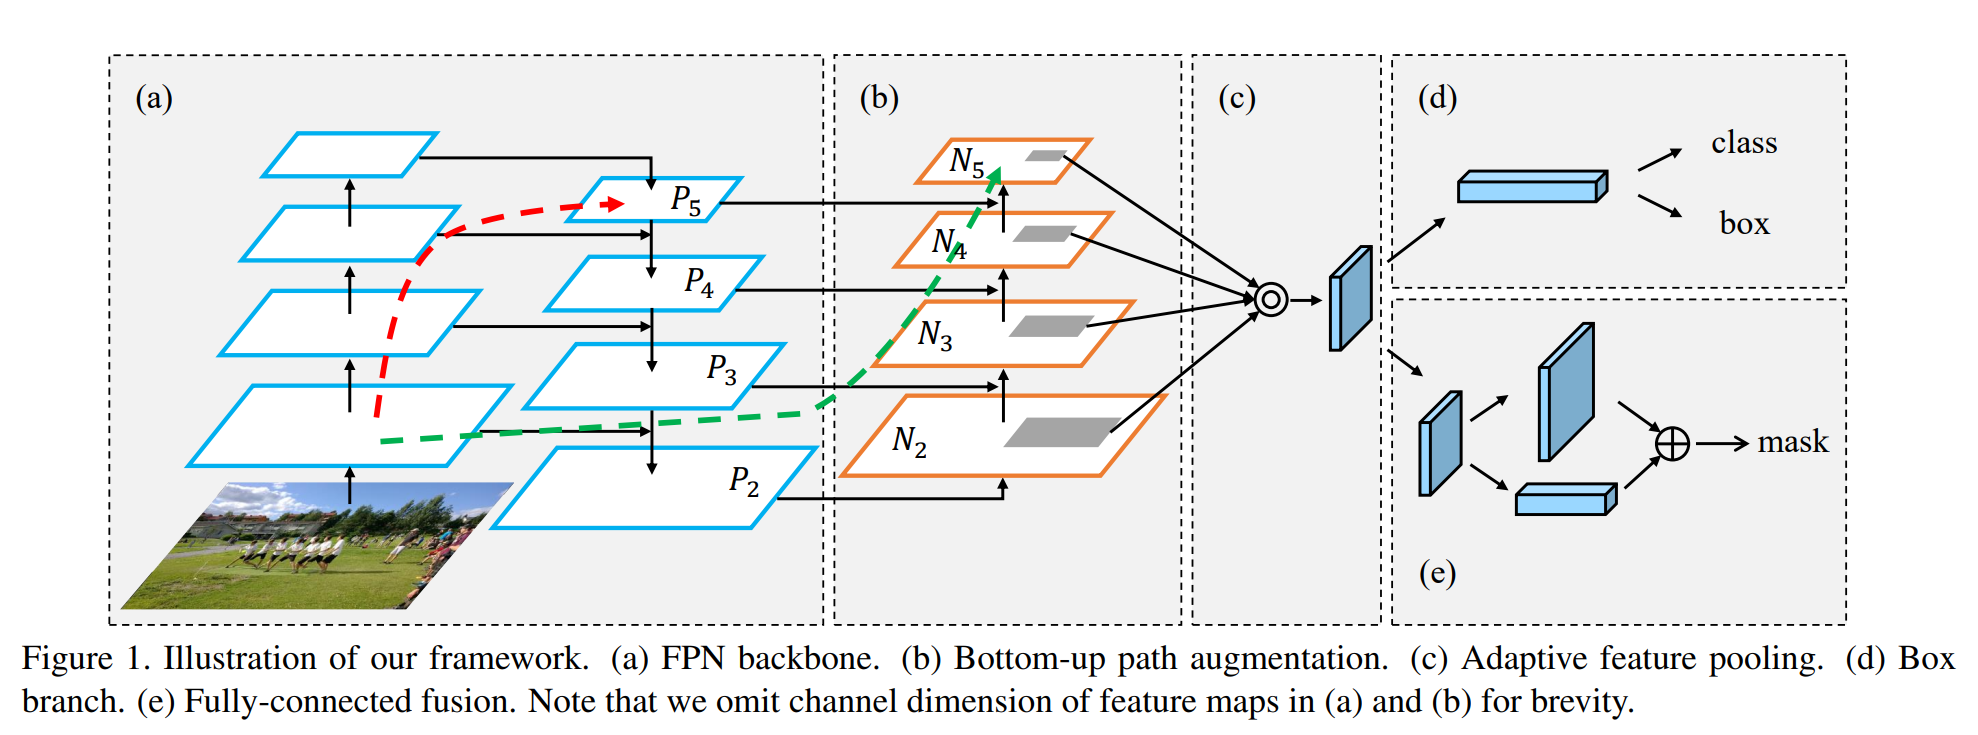
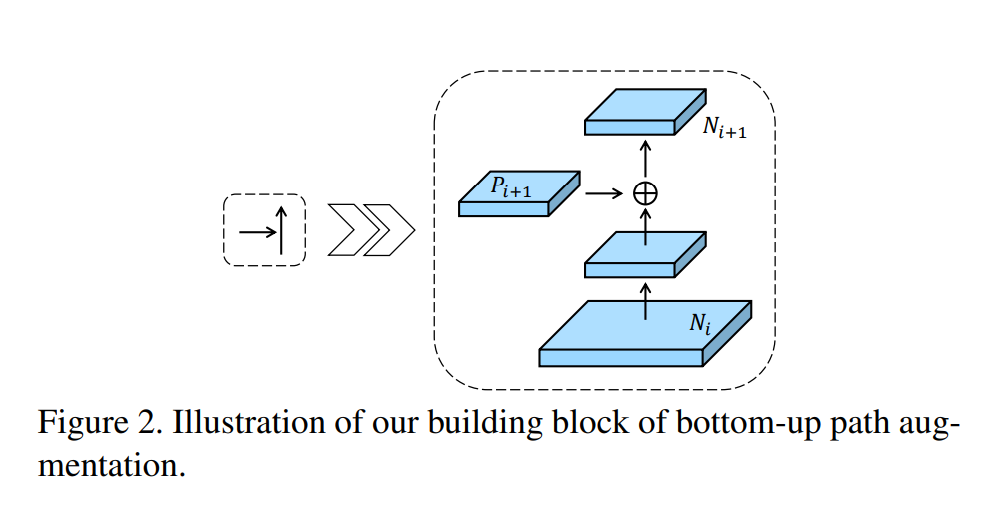
- (b) 区域特征图 $N_i$ 从下至上与 $P_{i+1}$ 向融合, 计算出 $N_{i+1}$.
-
-
损失 Loss
YOLOv4 添加了CIoU Loss
CIoU Loss
-
CIoU Loss 之前的 DIoU Loss
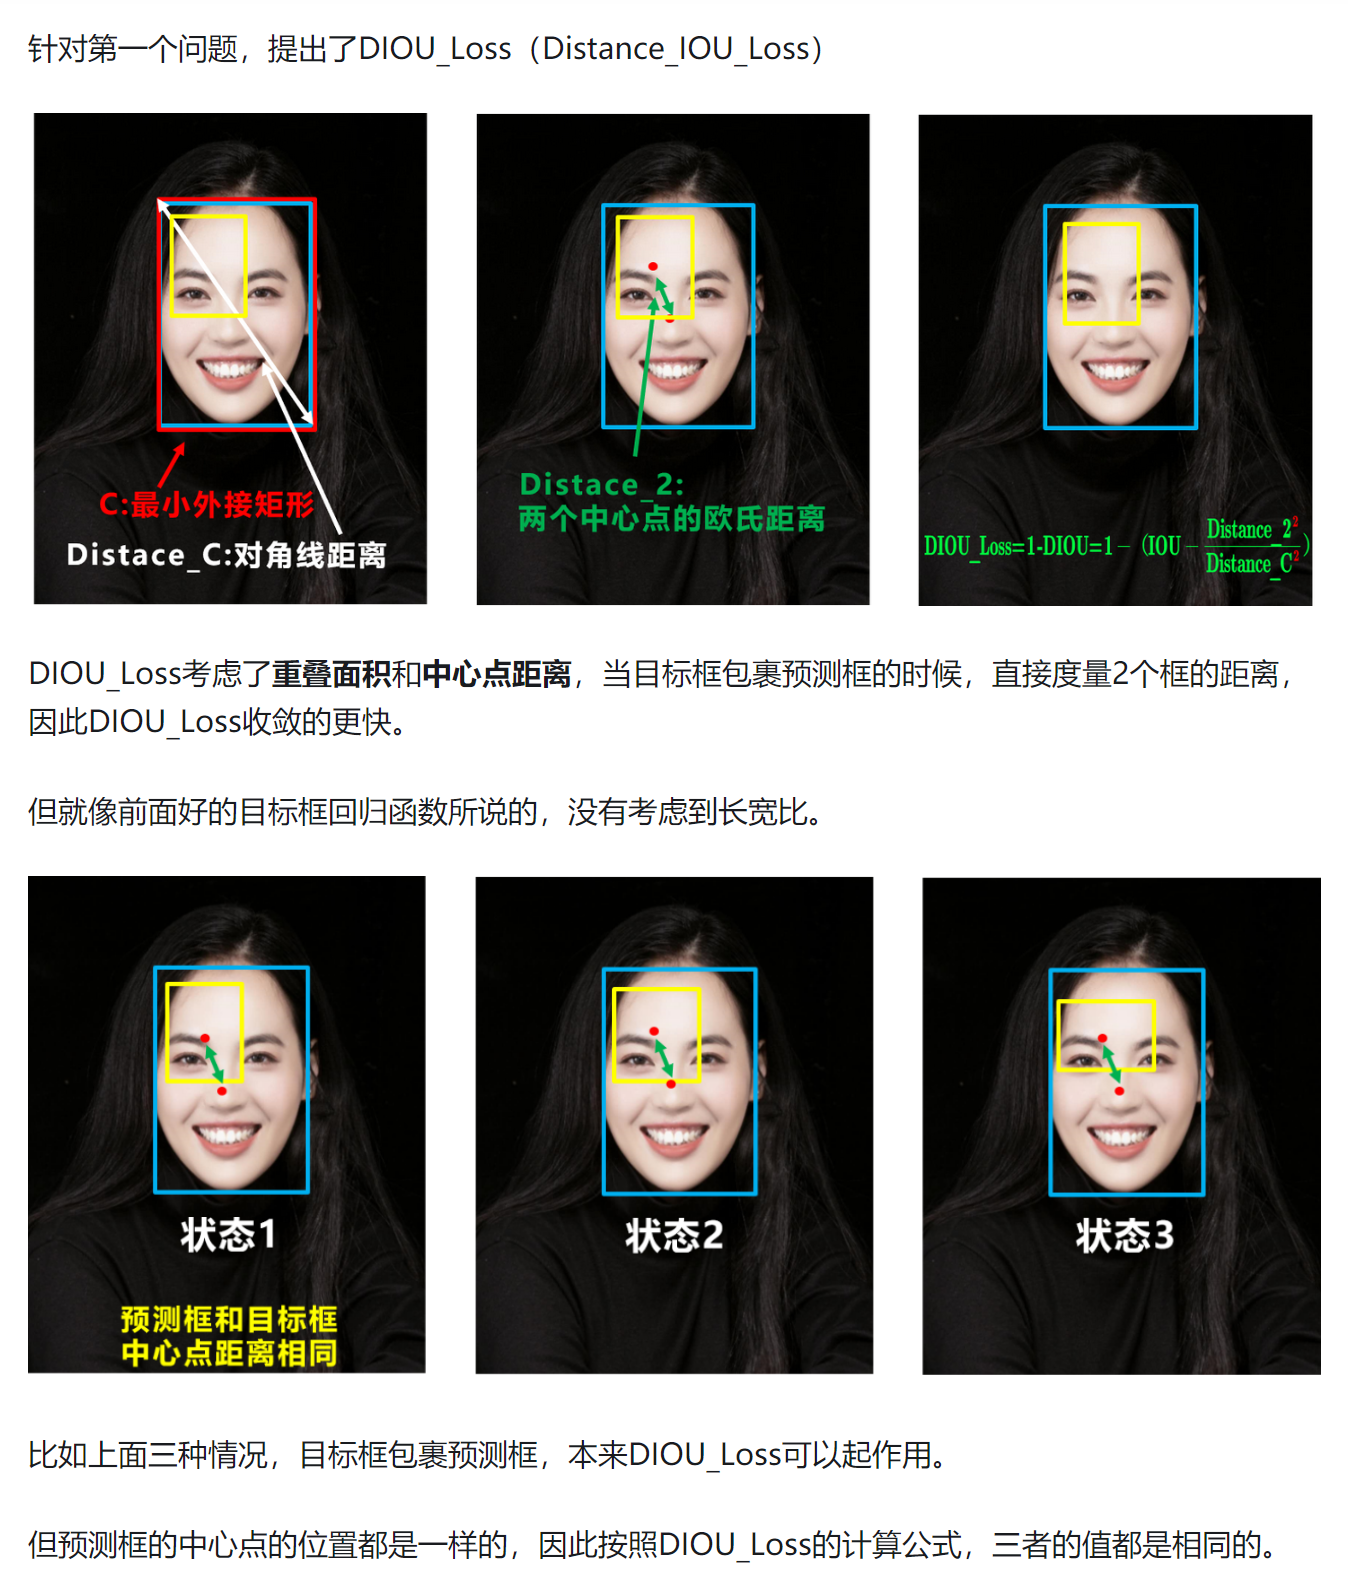
-
CIoU Loss 同时考虑了重叠面积, 中心点距离, 预测框与 GT 框的长宽比. 公式如下
$$ \text{CIOU_Loss}=1-\mathrm{CIOU}=1-\left(\mathrm{IOU}-\frac{\text{Distance_2}^2}{\text{Distance_C}^2}-\frac{v^2}{(1-\mathrm{IOU})+v}\right)
$$
$$ \nu=\frac{4}{\pi^2}\left(\arctan \frac{w^{\mathrm{gt}}}{\mathrm{h}^{\mathrm{gt}}}-\arctan \frac{\mathrm{w}^{\mathrm{p}}}{\mathrm{h}^{\mathrm{p}}}\right)^2 $$
-
-
DIoU nms
将 NMS 中的 IoU 计算换成了 DIoU 计算, 因为考虑到了候选框的中心点位置信息, 所以在重叠物体较多的问题中, DIoU nms 效果由于传统 nms.
-
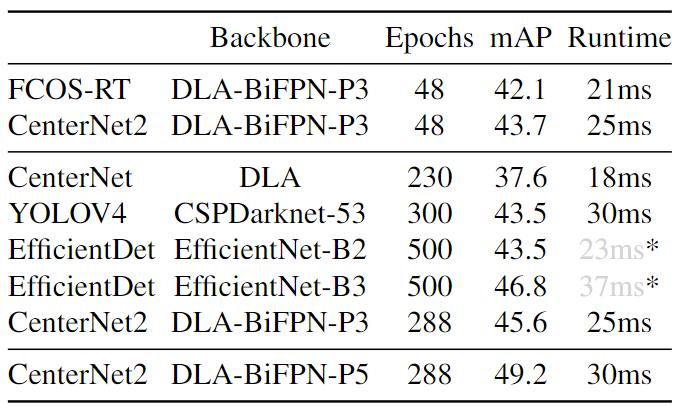
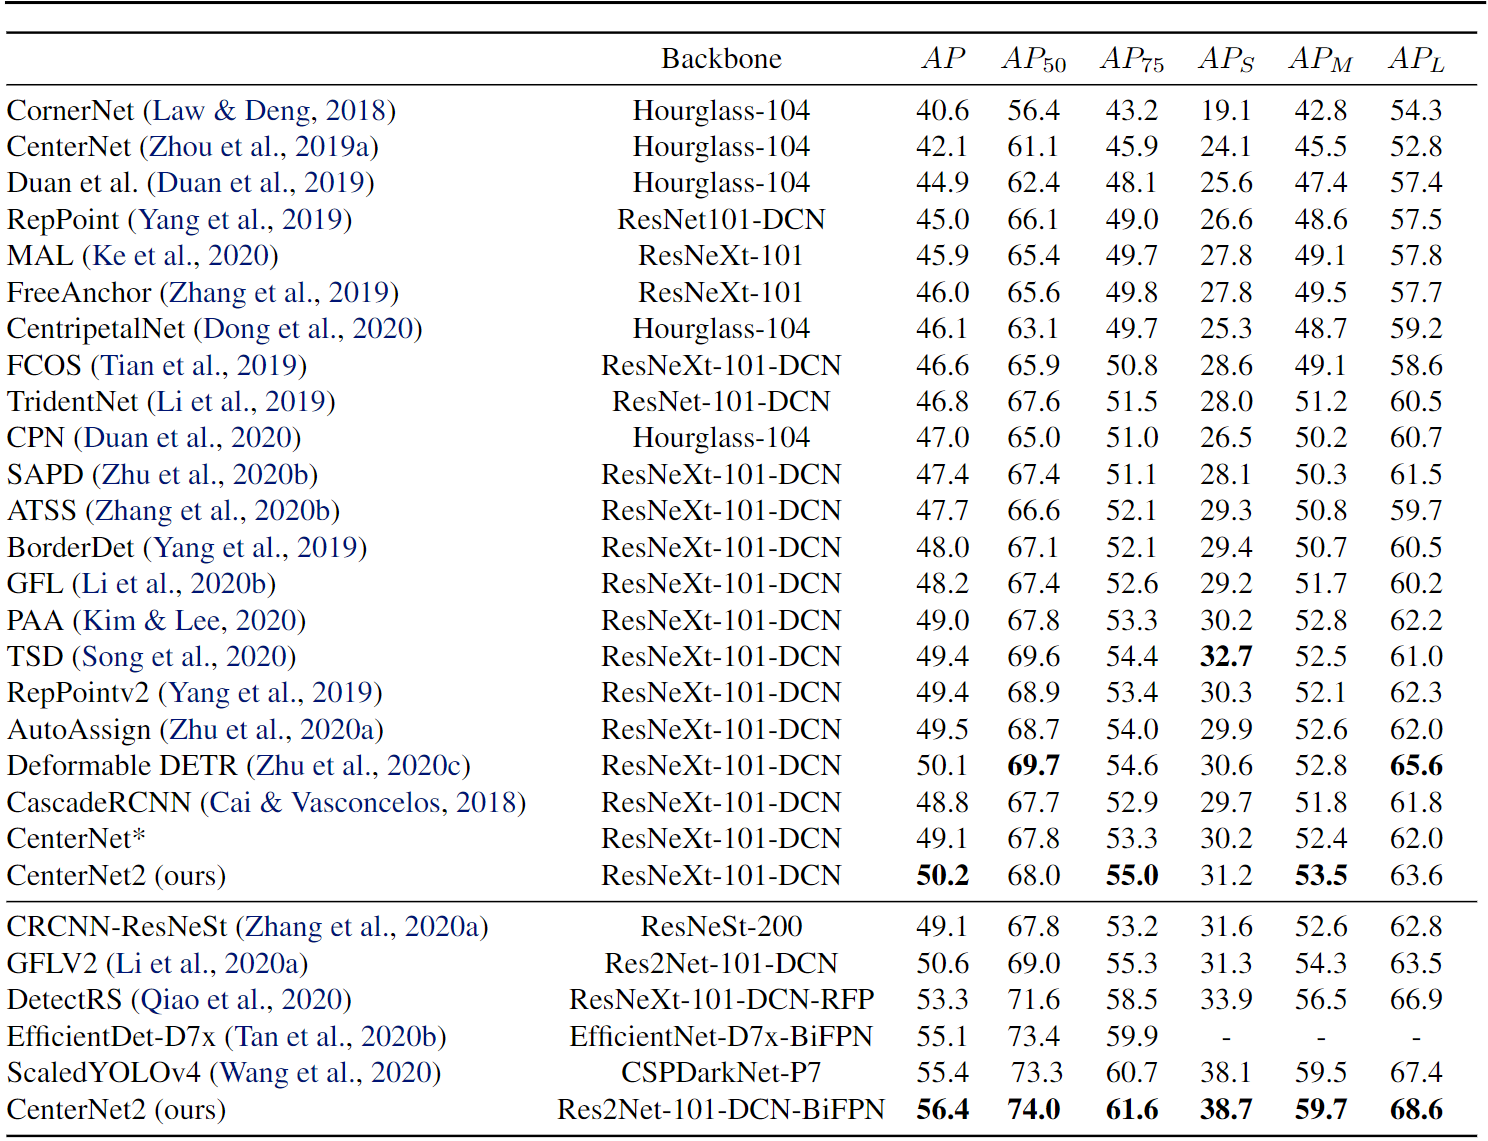
同级别精度和效率 CenterNet2
5.5.4. YOLOv5
-
数据增强
- Mosaic 数据增强
- RandomAffine 随机仿射变换
- MixUp 随机混合两张图片, 改一改透明度
- 图像模糊等采用 Albu 库实现的变换
- HSV 颜色空间增强
- 随机水平翻转
-
Auto Anchor 自适应锚框计算
与 YOLOv3 类似使用数据集中的 GT 聚类获得, 不同是聚类的标准不再是 IoU, 而是宽高比.
YOLOv5 在 COCO 数据集上的初始 Anchor 如下, 每一行对应一个尺度, 各有 3 各宽高比例.
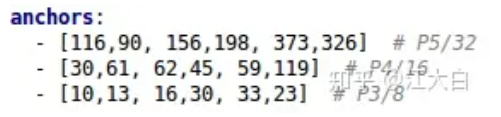
-
自适应图片缩放 (推理时使用)
-
由于数据集中的图片长宽比例都不同, 需要按比例缩放并填充黑边, 但是如果黑边过多会造成信息冗余, 推理速度下降.
-
使用图像自适应来添加最少的灰边, 这样推理速度上升了 37%.
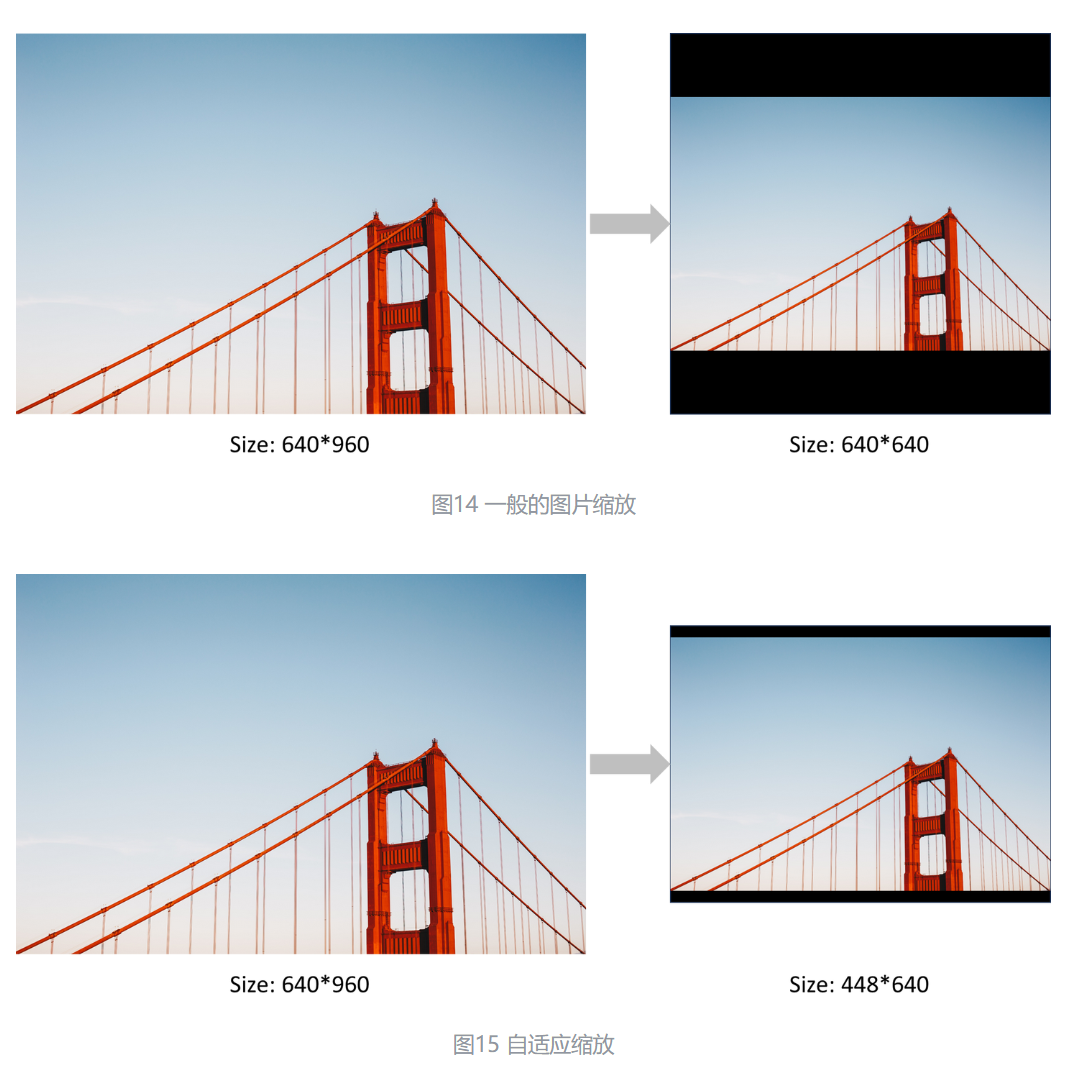
-
-
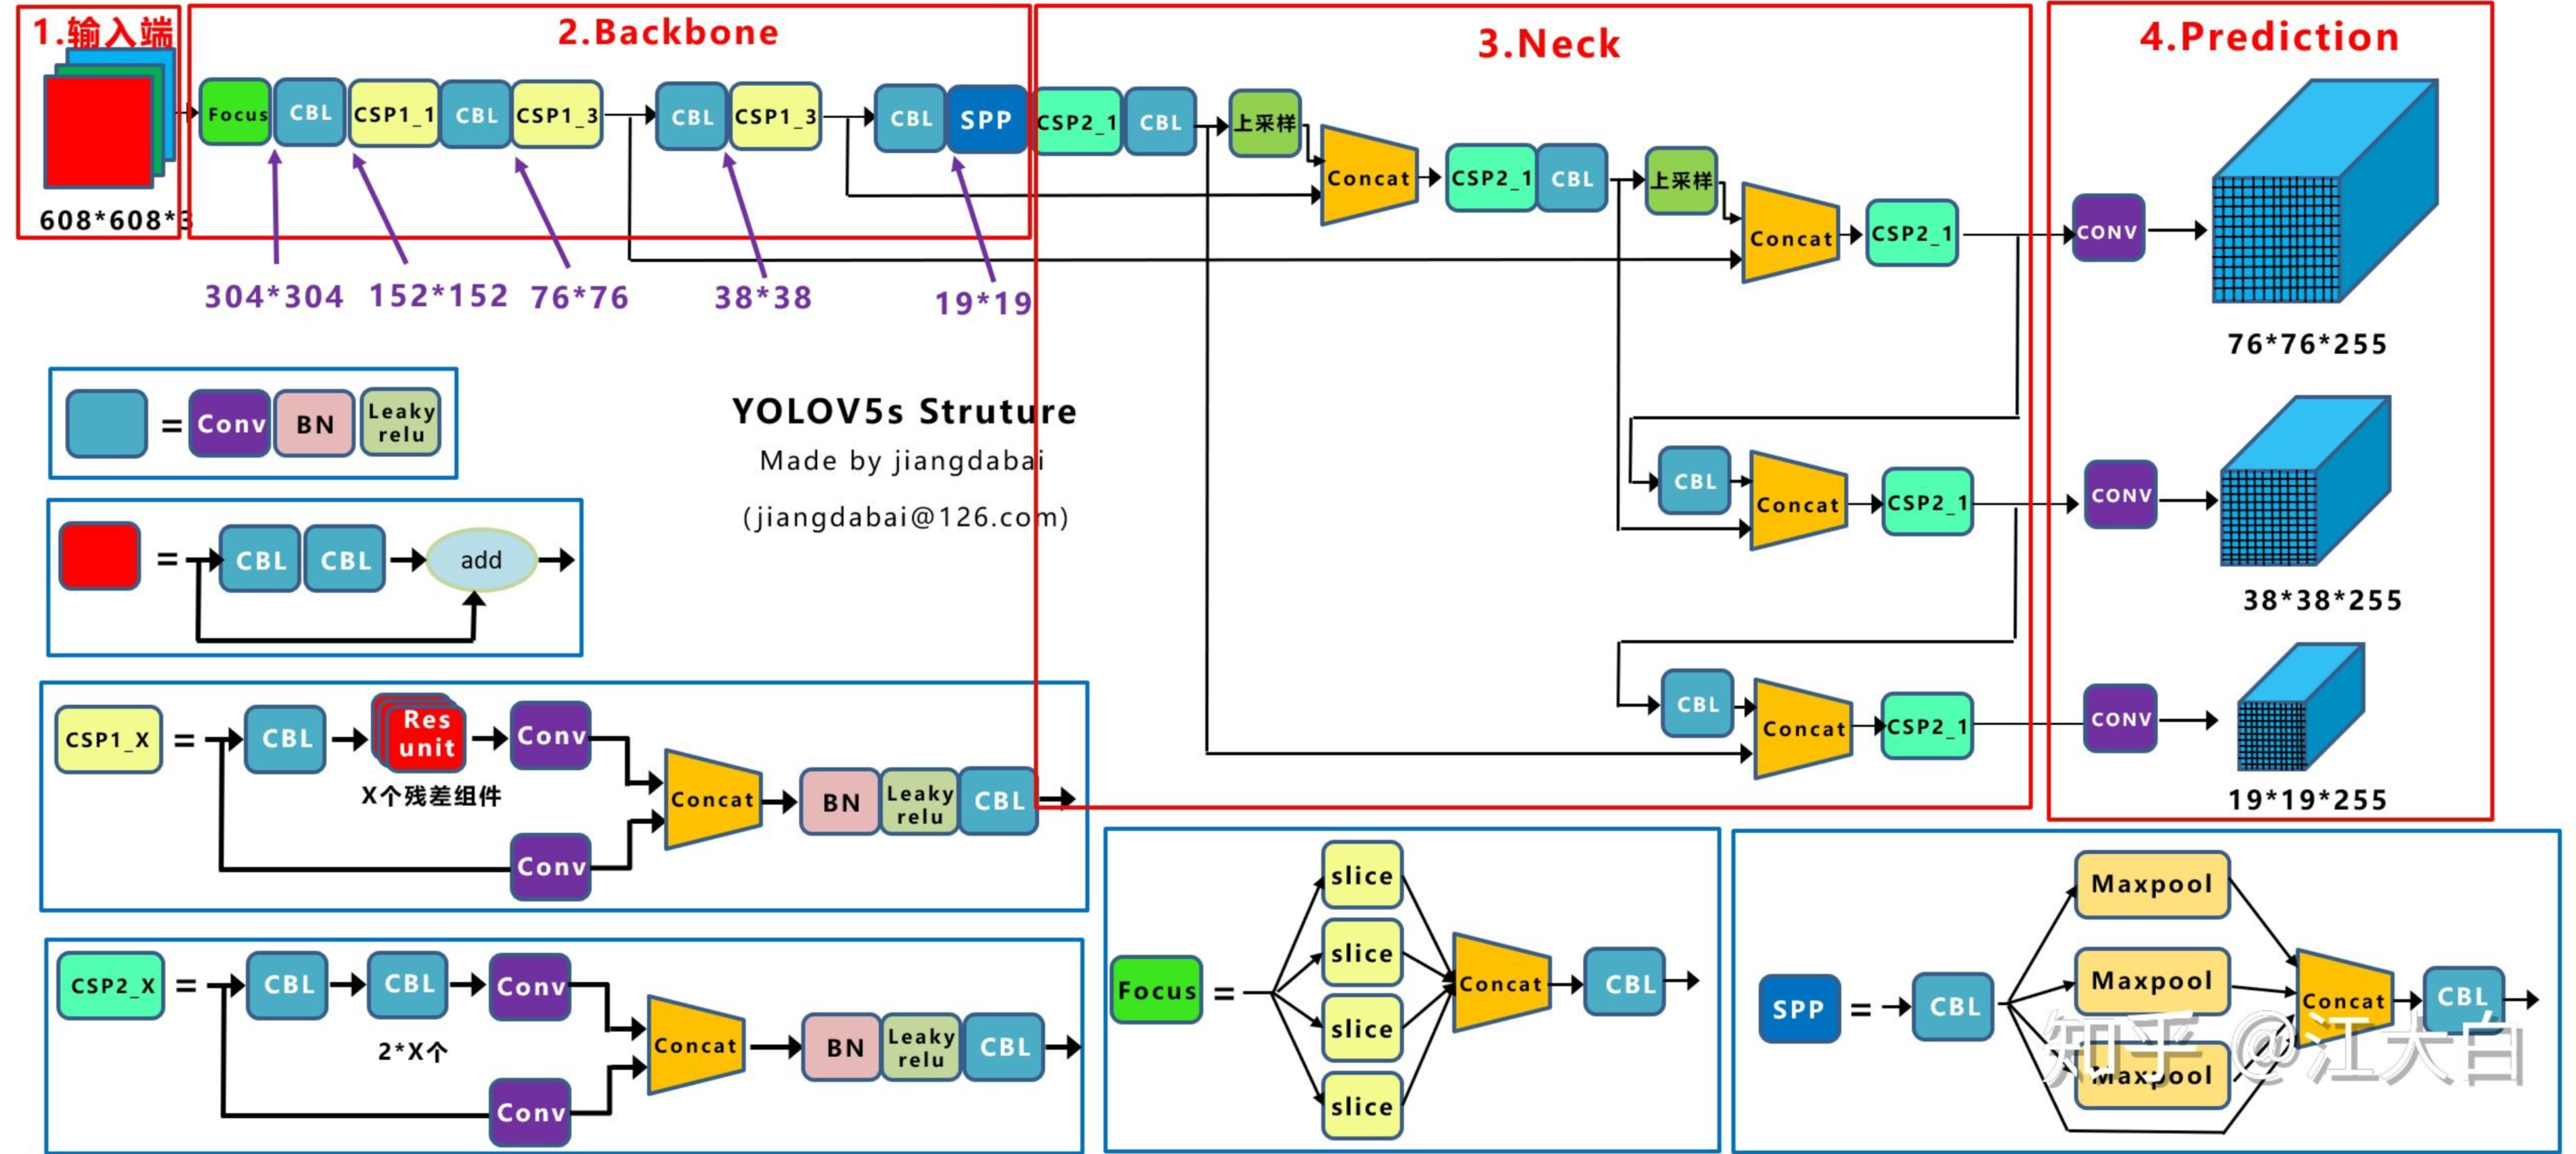
Backbone 部分使用了 Focus 结构
就是 Pass through 特征图, 将图片尺寸减半. (Pass through 可以增强小目标识别, 但是用在这里似乎并不为了提升 mAP, 作者说是为了提速)
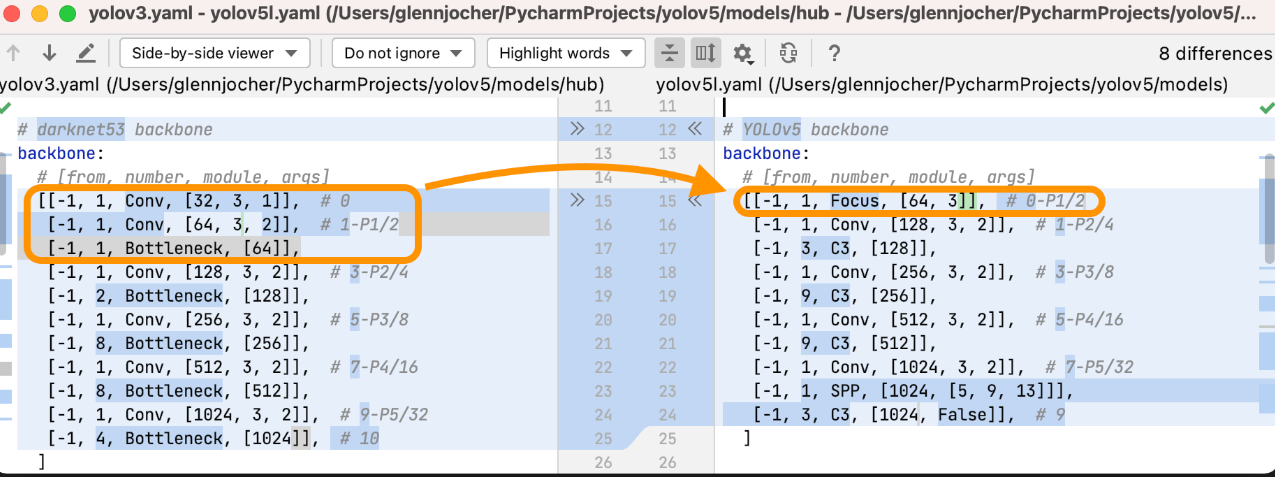
- 可以看到 YOLOv5 相比 YOLOv3 相同为位置参数量明显减少.
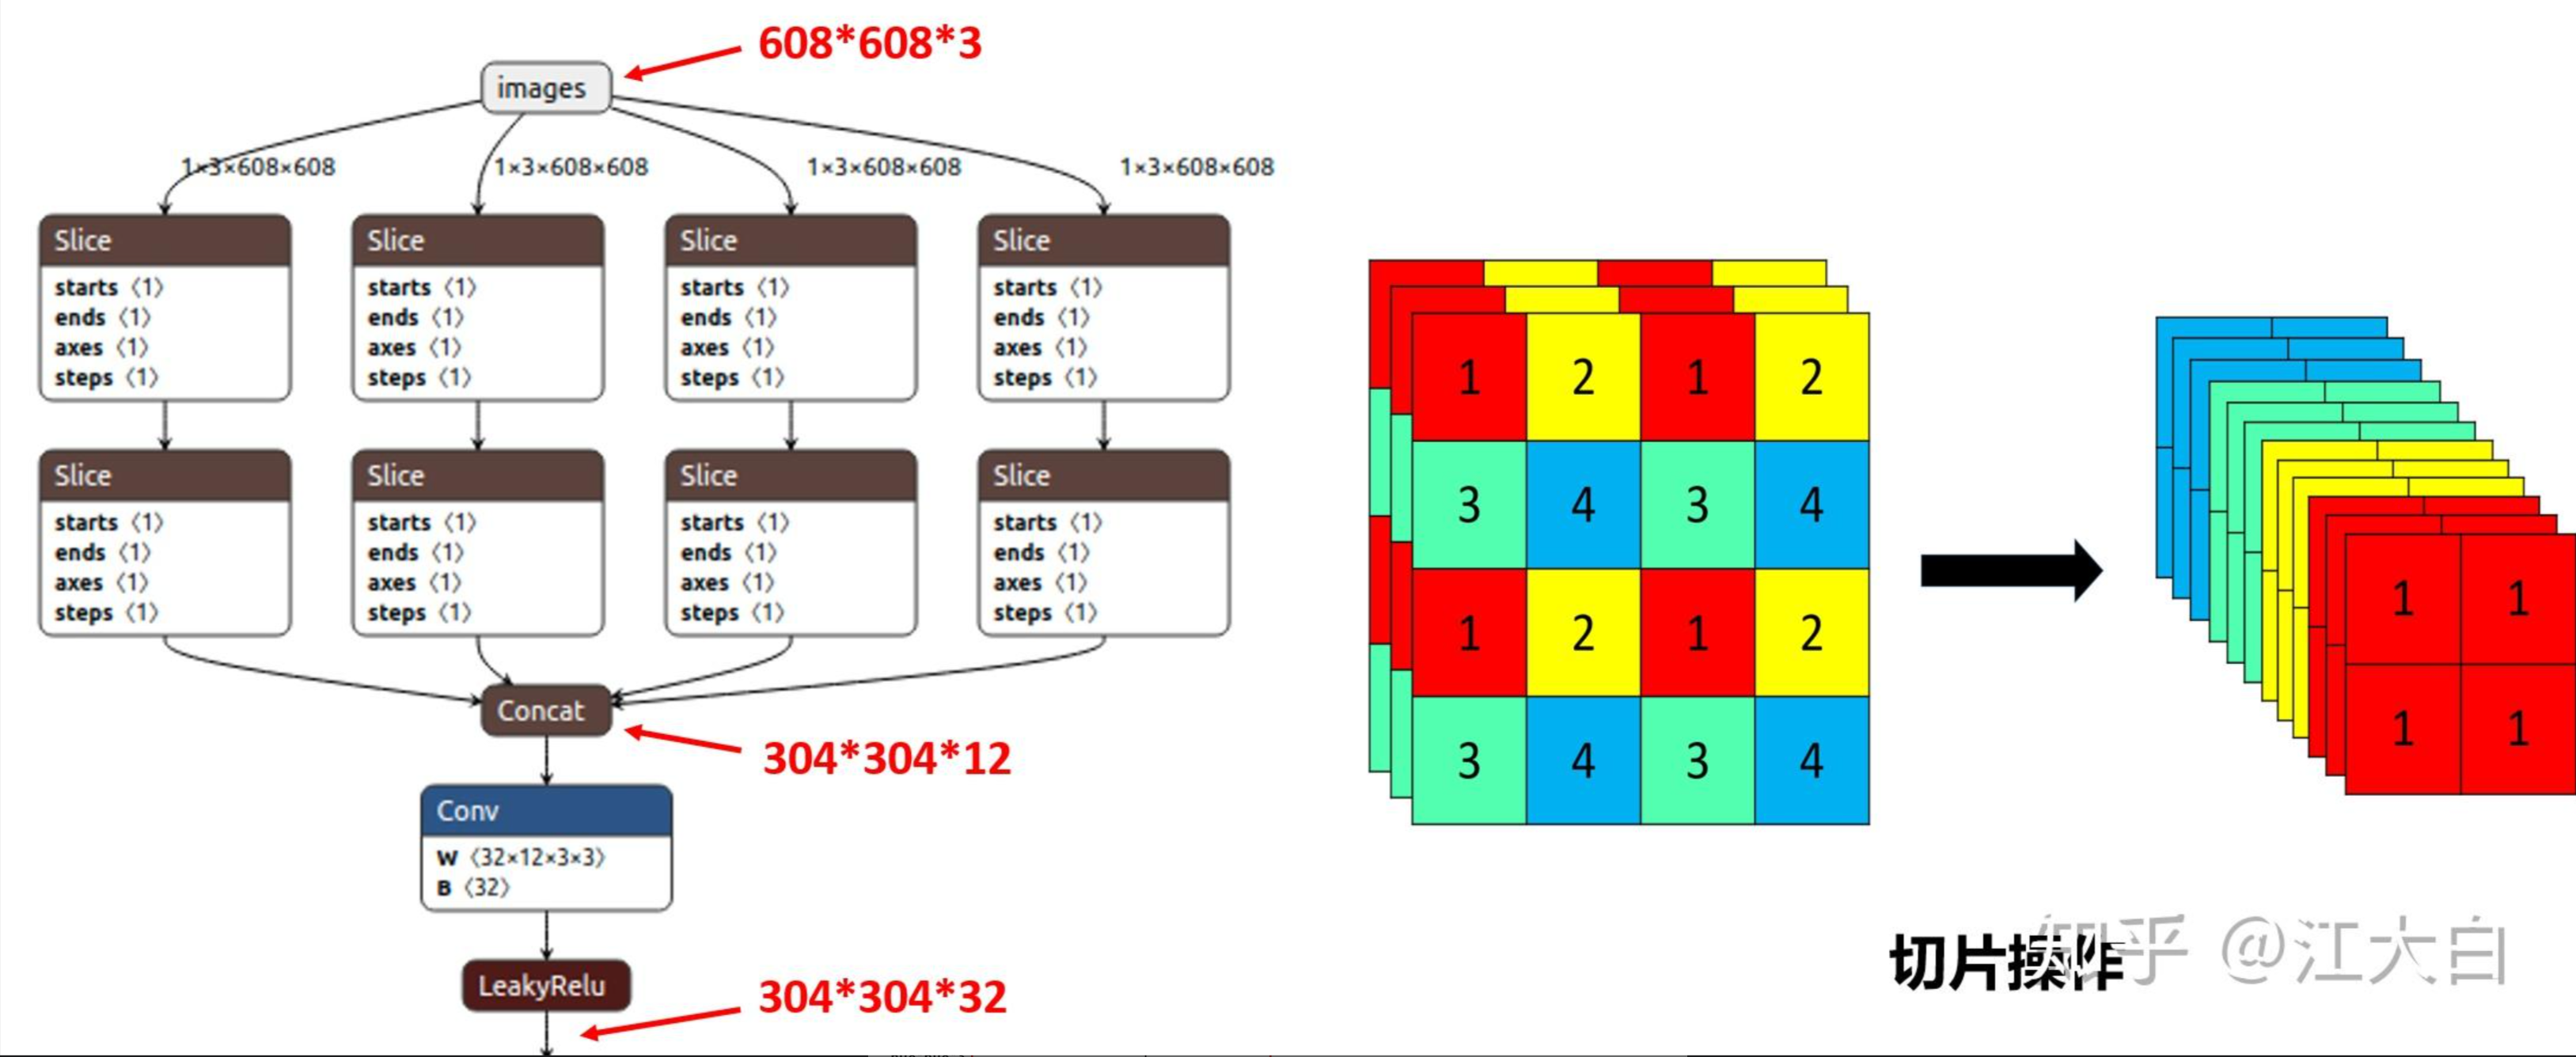
- 卷积层参数: 卷积核尺寸 3x3, 步长为 1. 有 32 个卷积核. 每个卷积核对 12 层特征图进行卷积, 得到的结果相加, 所以最后有 32 层.
-
Neck 部分使用了新的 CSP2 结构
5.5.6. YOLOv8
如何看待YOLOv8,YOLOv5作者开源新作,它来了!? - 知乎
特点:
- 提供了一个全新的 SOTA 模型, 包括 P5 640 和 P6 1280 分辨率的目标检测网络和基于 YOLACT 的实例分割模型. 和 YOLOv5 一样, 基于缩放系数也提供了 N/S/M/L/X 尺度的不同大小模型, 用于满足不同场景需求
- 骨干网络和 Neck 部分可能参考了 YOLOv7 ELAN 设计思想, 将 YOLOv5 的 C3 结构换成了梯度流更丰富的 C2f 结构, 并对不同尺度模型调整了不同的通道数, 属于对模型结构精心微调, 不再是无脑一套参数应用所有模型, 大幅提升了模型性能. 不过这个 C2f 模块中存在 Split 等操作对特定硬件部署没有之前那么友好了
- Head 部分相比 YOLOv5 改动较大, 换成了目前主流的解耦头结构, 将分类和检测头分离, 同时也从 Anchor-Based 换成了 Anchor-Free
- Loss 计算方面采用了 TaskAlignedAssigner 正样本分配策略, 并引入了 Distribution Focal Loss
- 训练的数据增强部分引入了 YOLOX 中的最后 10 epoch 关闭 Mosiac 增强的操作, 可以有效地提升精度
-
模型结构图
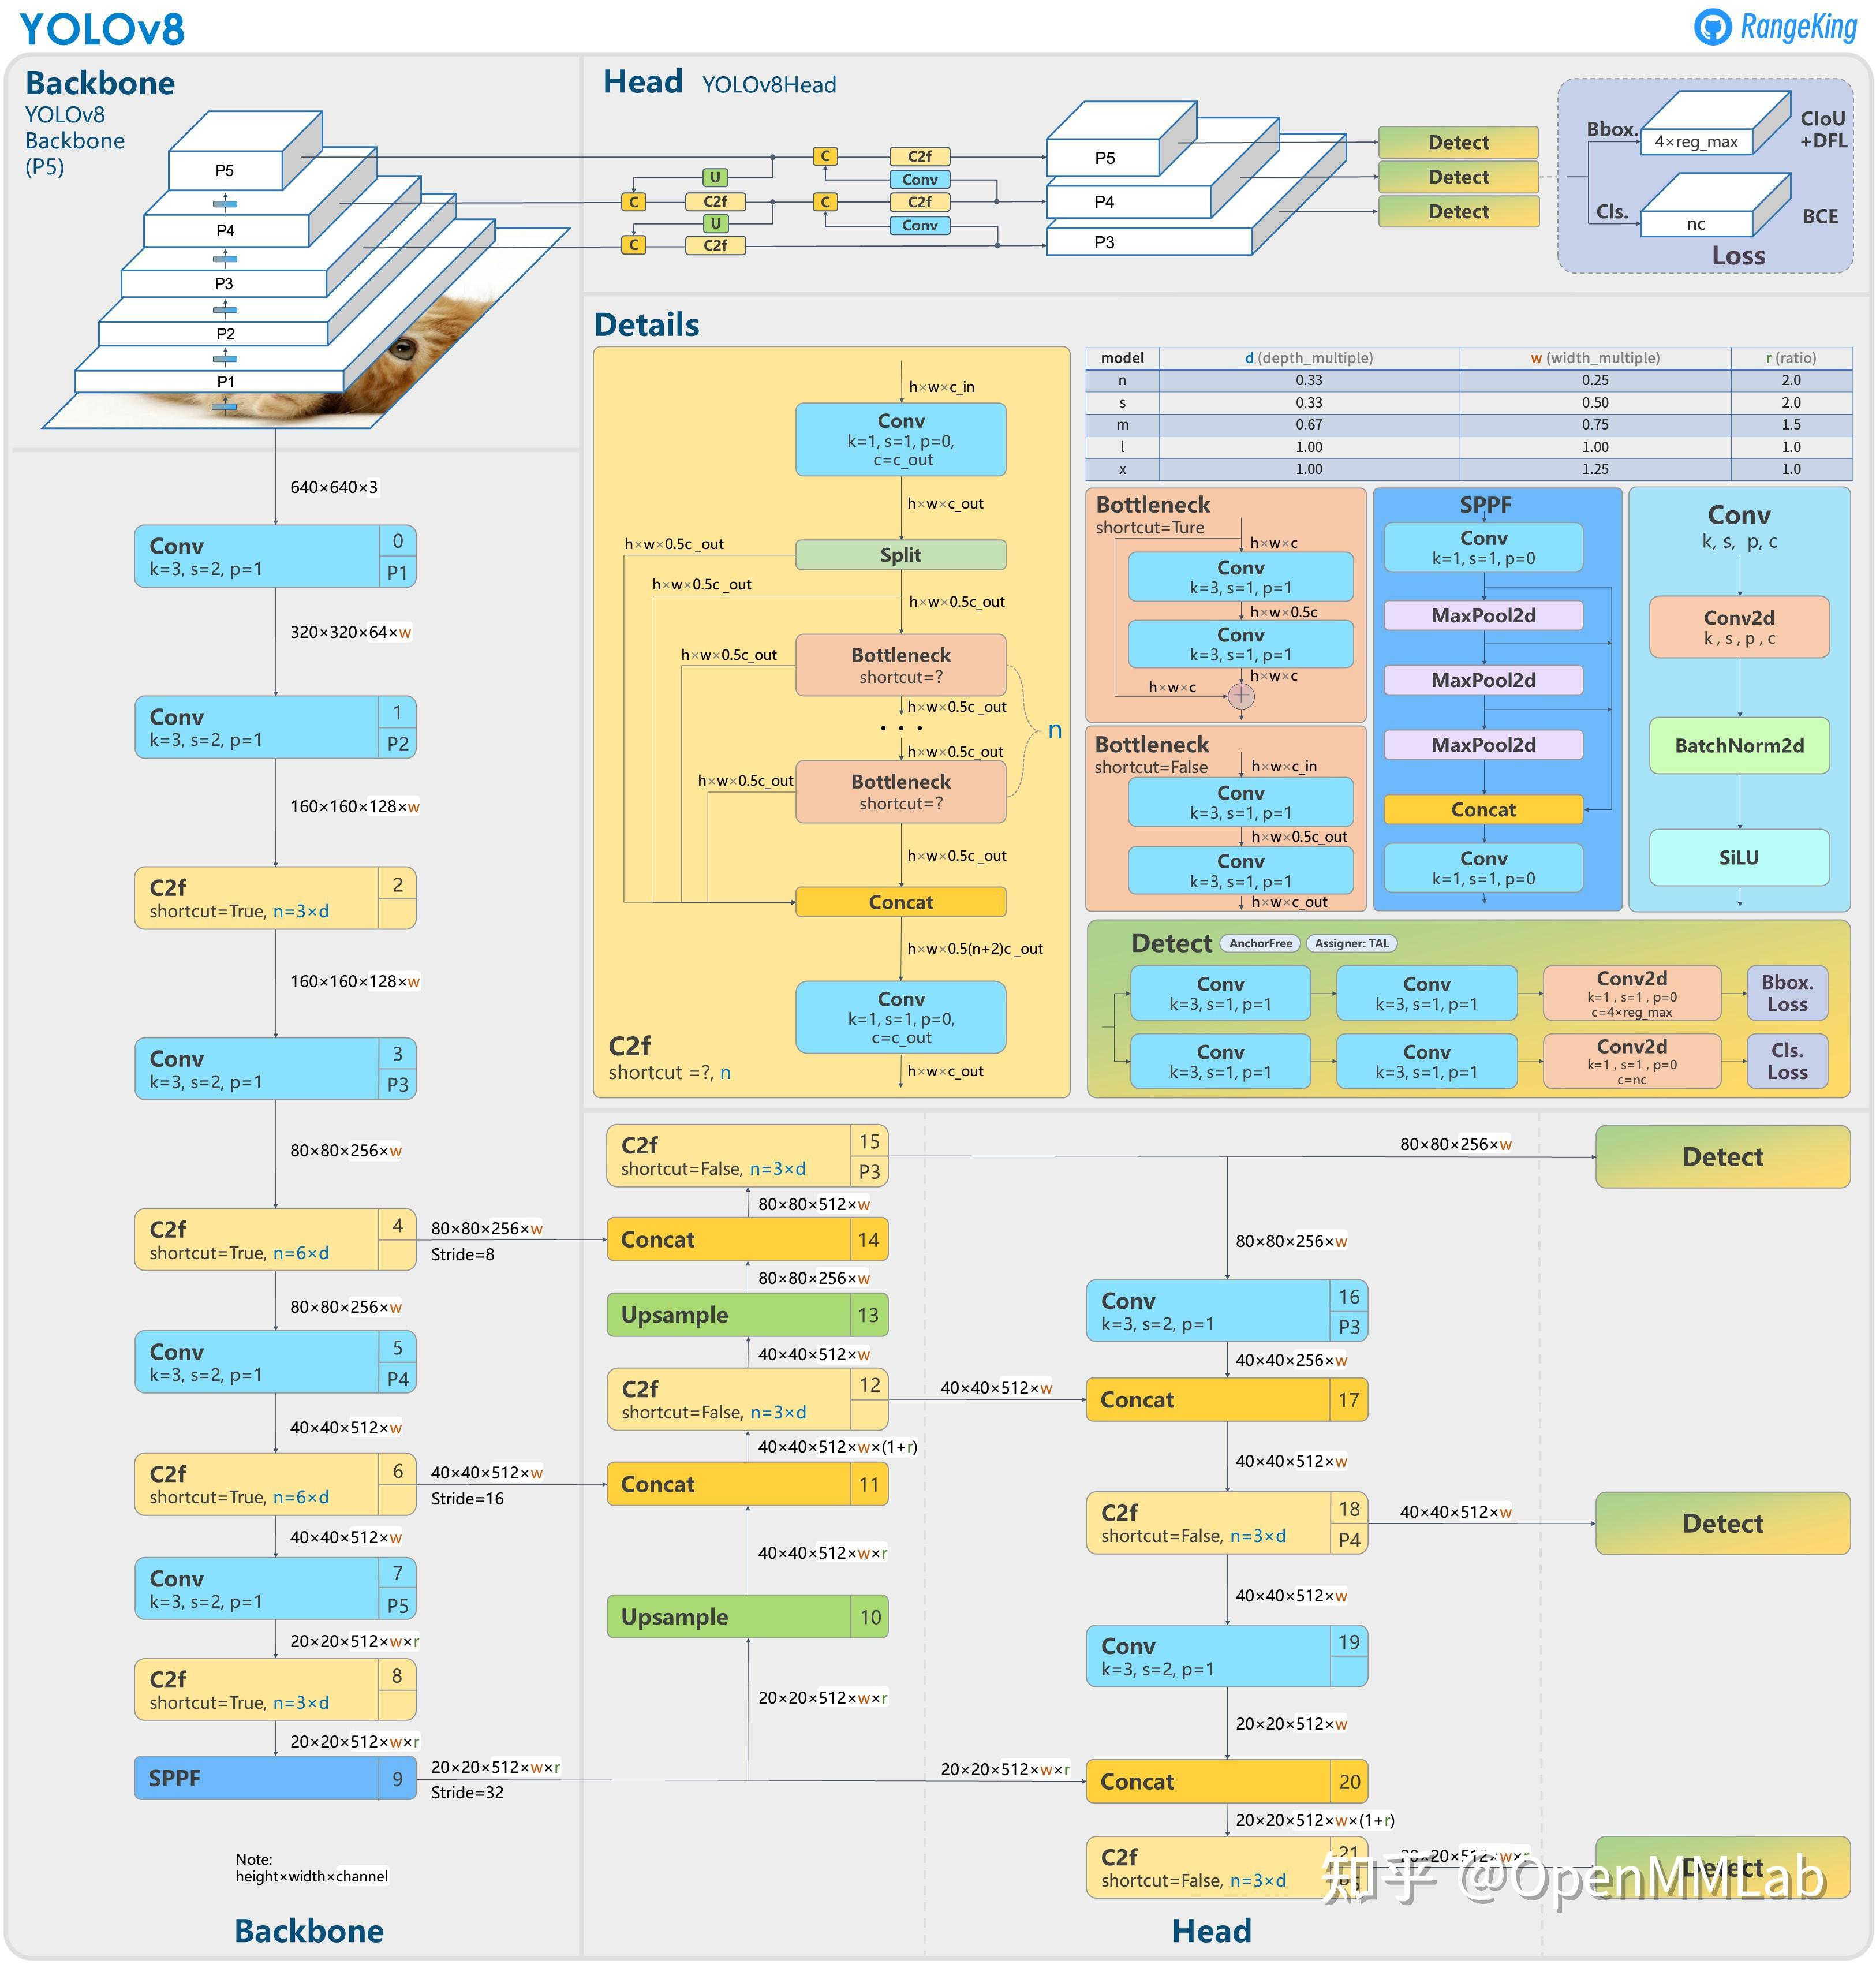
-
精度和速度
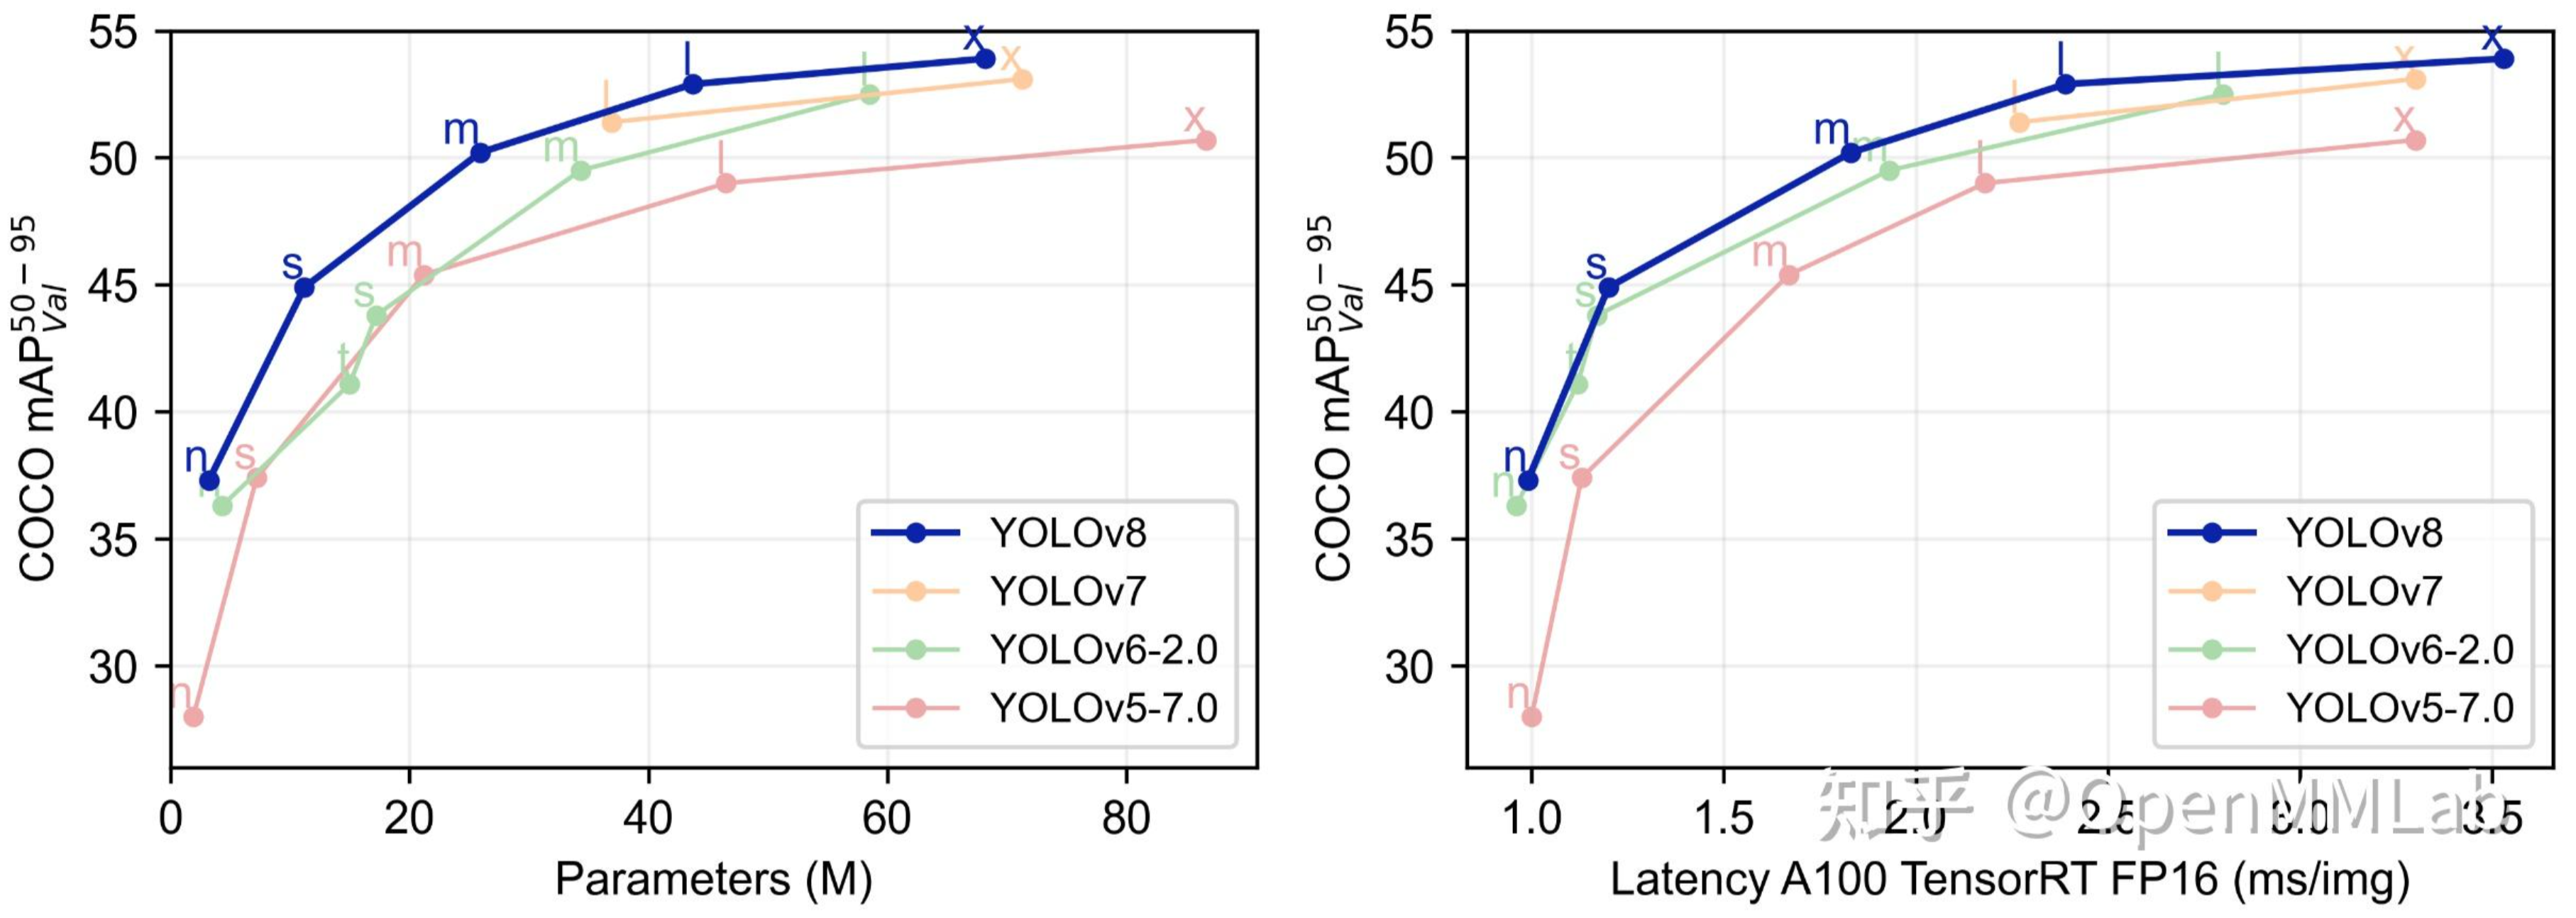
模型 YOLOv5 params(M) FLOPs@640 (B) YOLOv8 params(M) FLOPs@640 (B) n 28.0(300e) 1.9 4.5 37.3 (500e) 3.2 8.7 s 37.4 (300e) 7.2 16.5 44.9 (500e) 11.2 28.6 m 45.4 (300e) 21.2 49.0 50.2 (500e) 25.9 78.9 l 49.0 (300e) 46.5 109.1 52.9 (500e) 43.7 165.2 x 50.7 (300e) 86.7 205.7 53.9 (500e) 68.2 257.8
5.5.7. YOLOv9
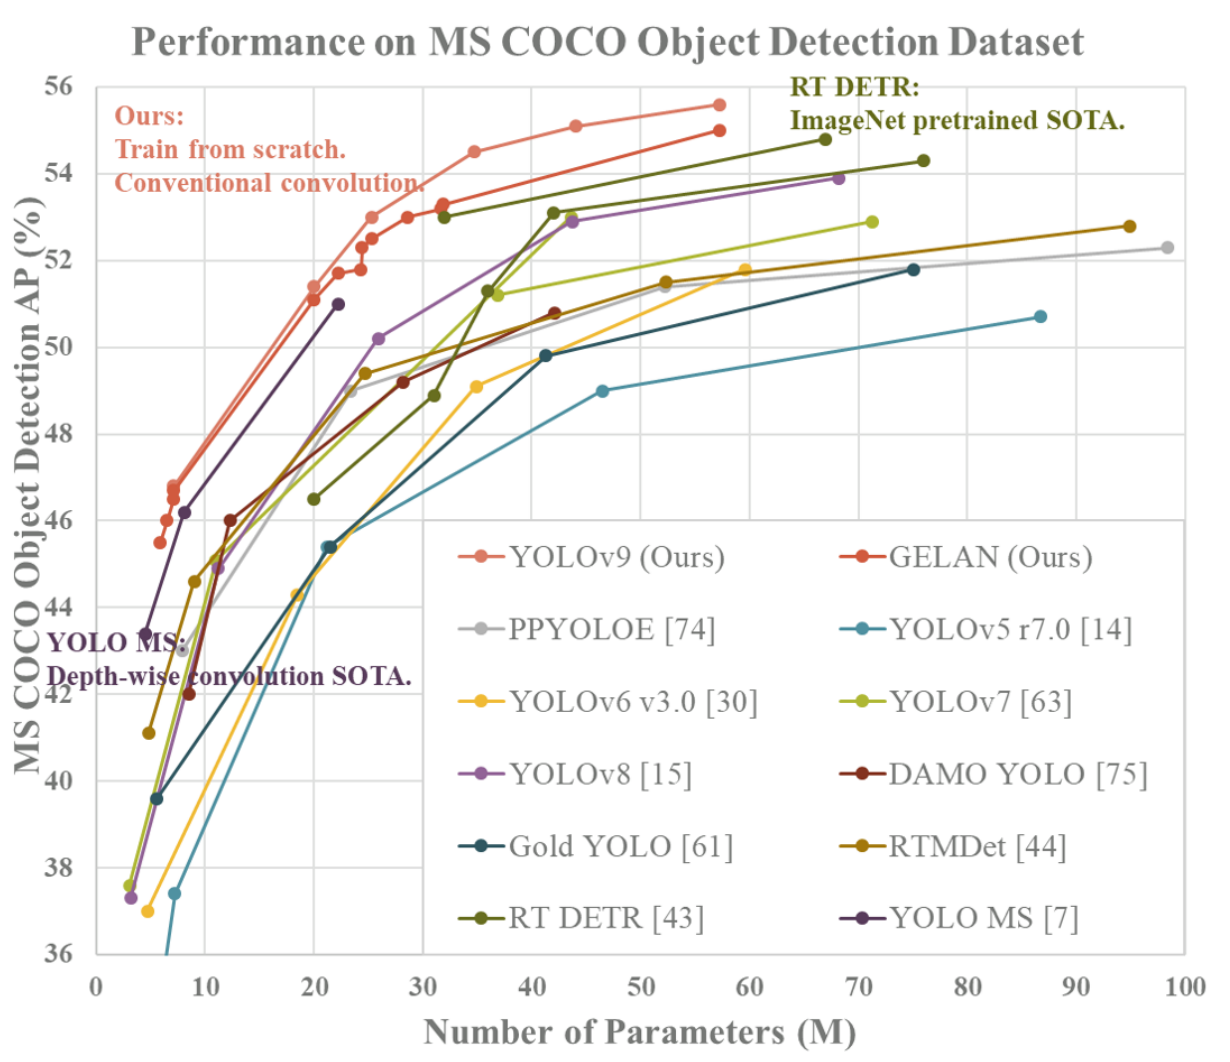
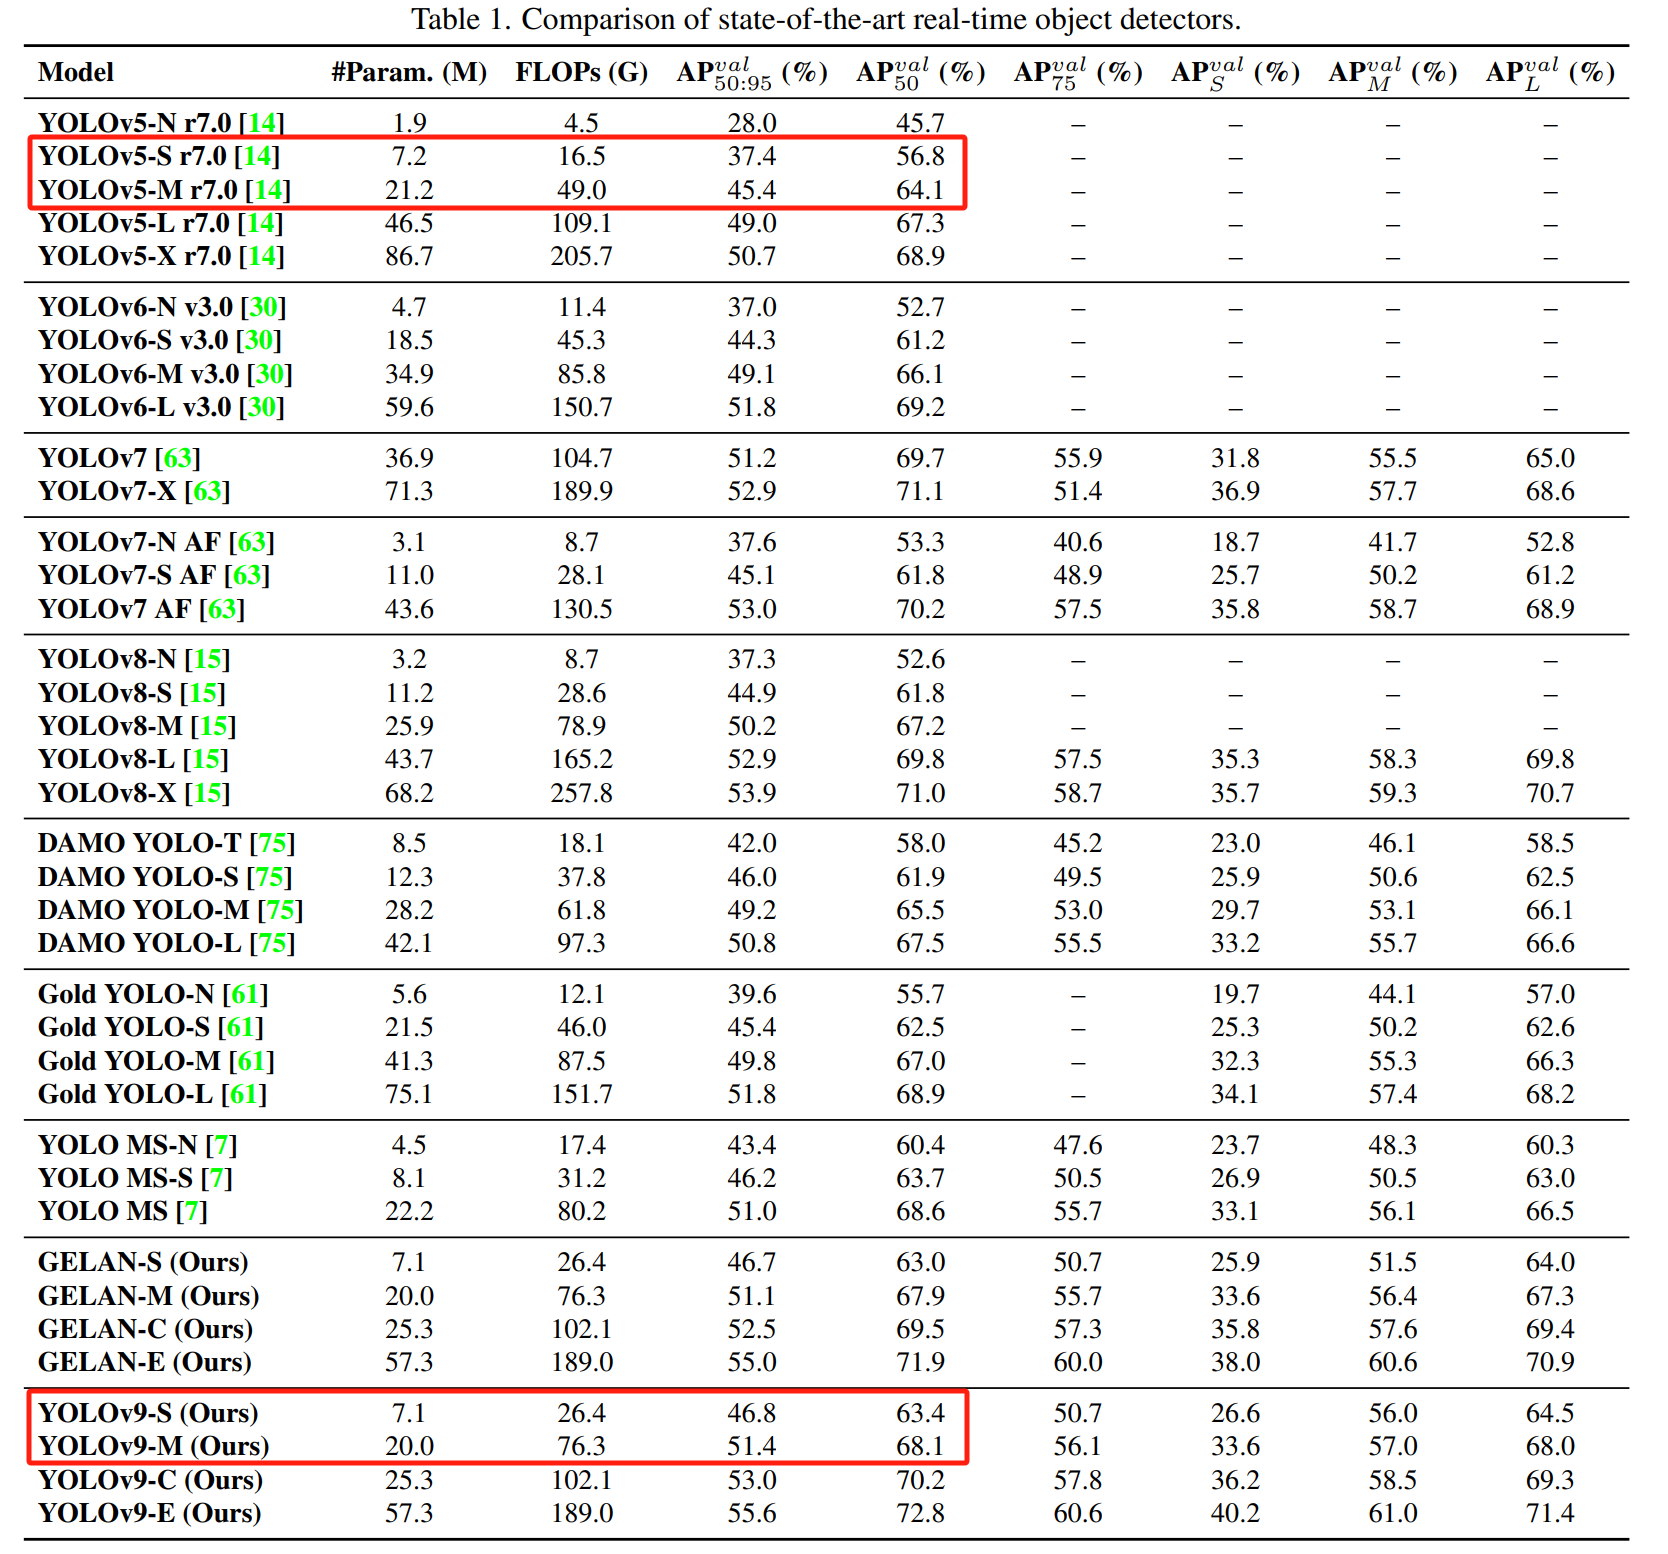
- 中小模型相对于YOLOv5 效率降低精度提高.
5.6. SSD (Single Shot MultiBox Detector)
5.7. Mask-RCNN
属于一个通用的可以实例分割的物体检测框架.
【物体检测实战】Mask-Rcnn图像实例分割被同济大佬给讲透了,原理+论文详细解读,带你快速入门!附配套资料_人工智能/深度学习/物体检测/yolo_哔哩哔哩_bilibili
mask-rcnn解读_maskrcnn模型的运行结果-CSDN博客
语义分割算法Mask RCNN论文解读_maskrcnn源论文名称-CSDN博客
Mask R-CNN 算法浅谈 - 乞力马扎罗的雪顶 - 博客园
-
Mask-RCNN 流程图
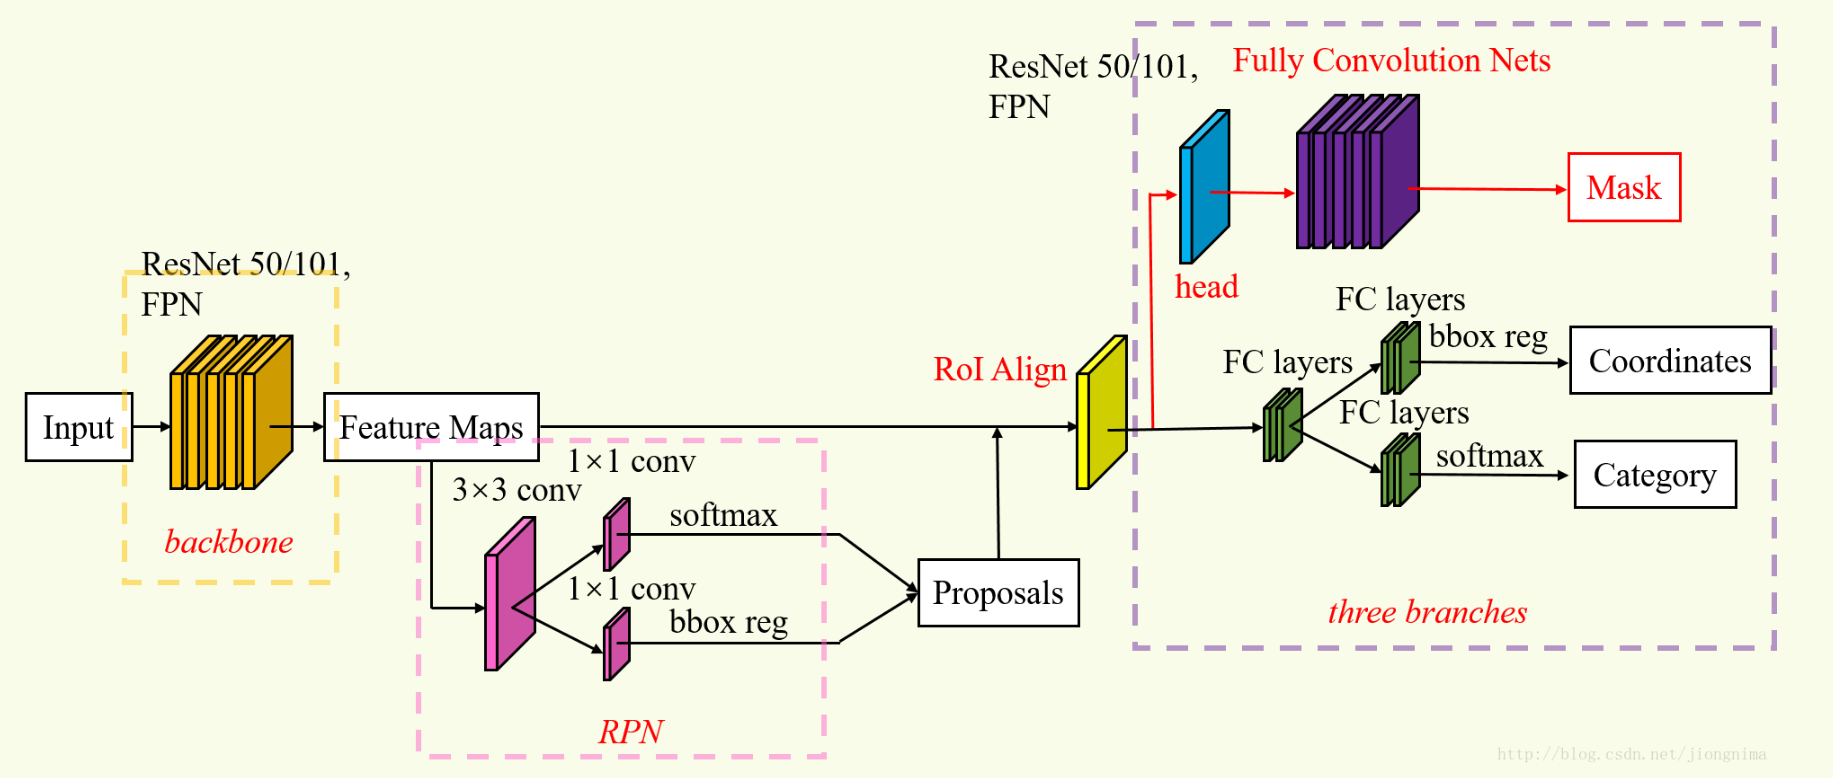
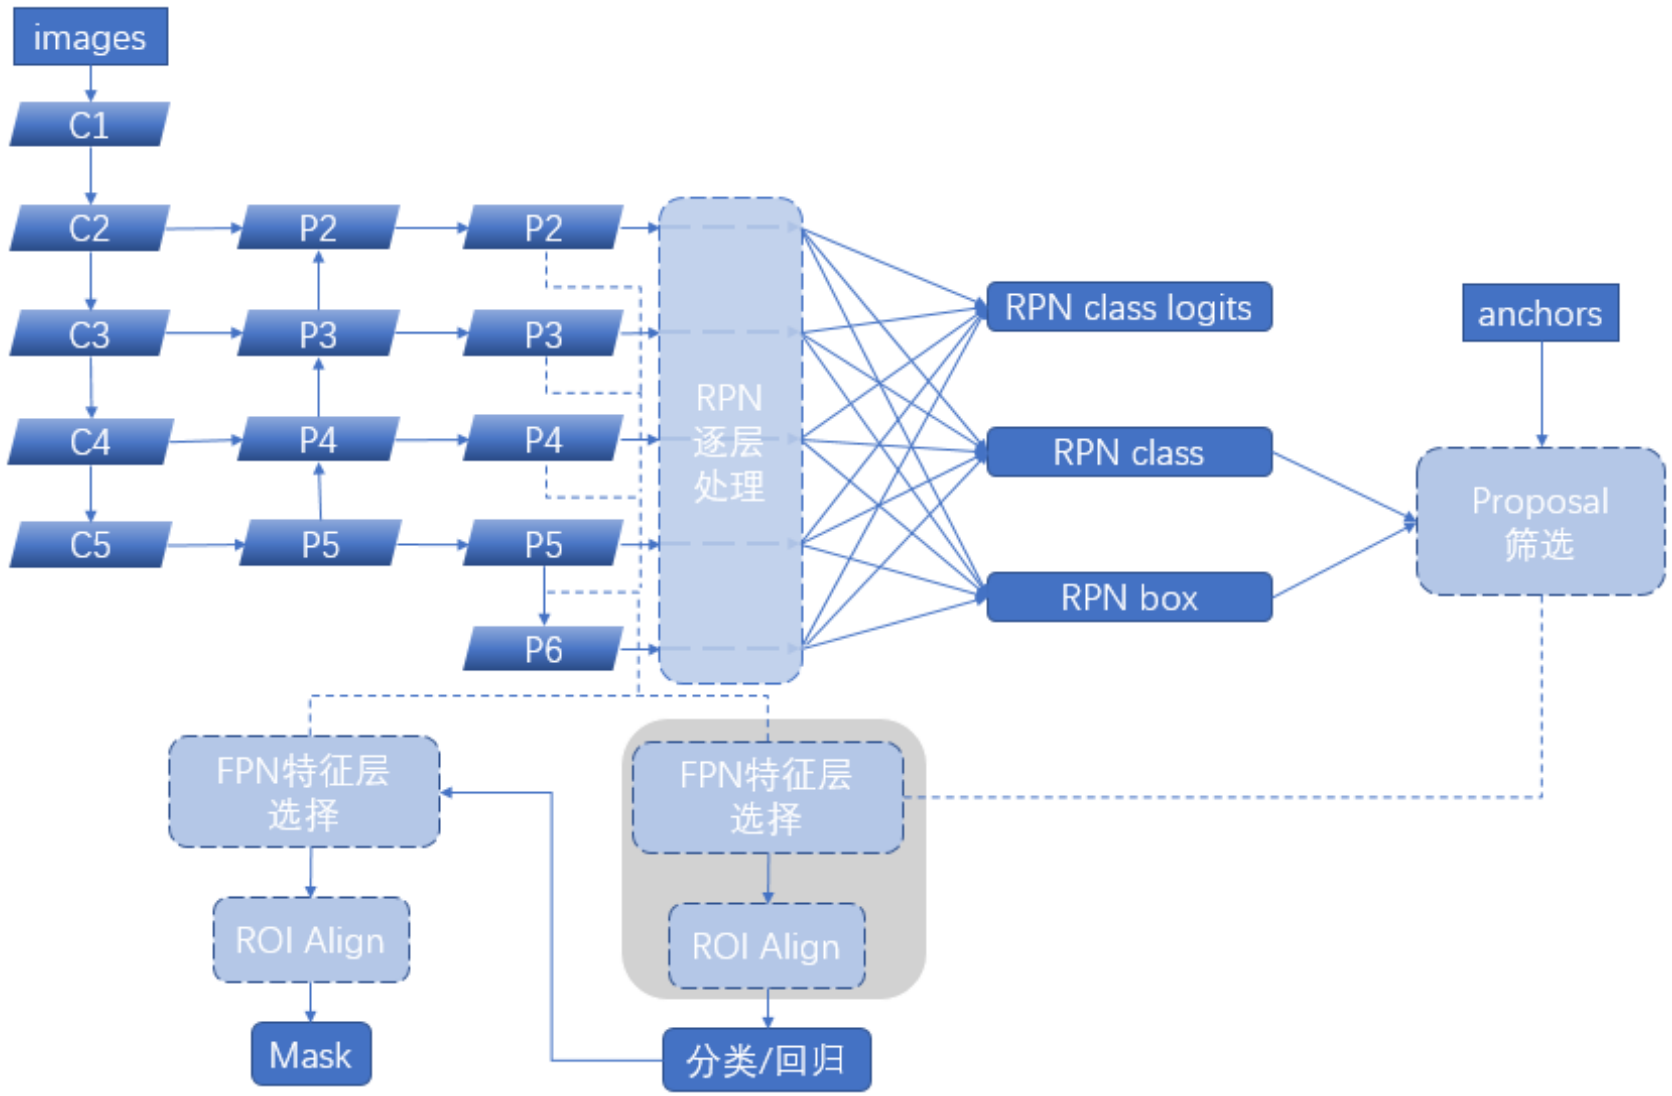
-
Mask-RCNN 文字解释流程图
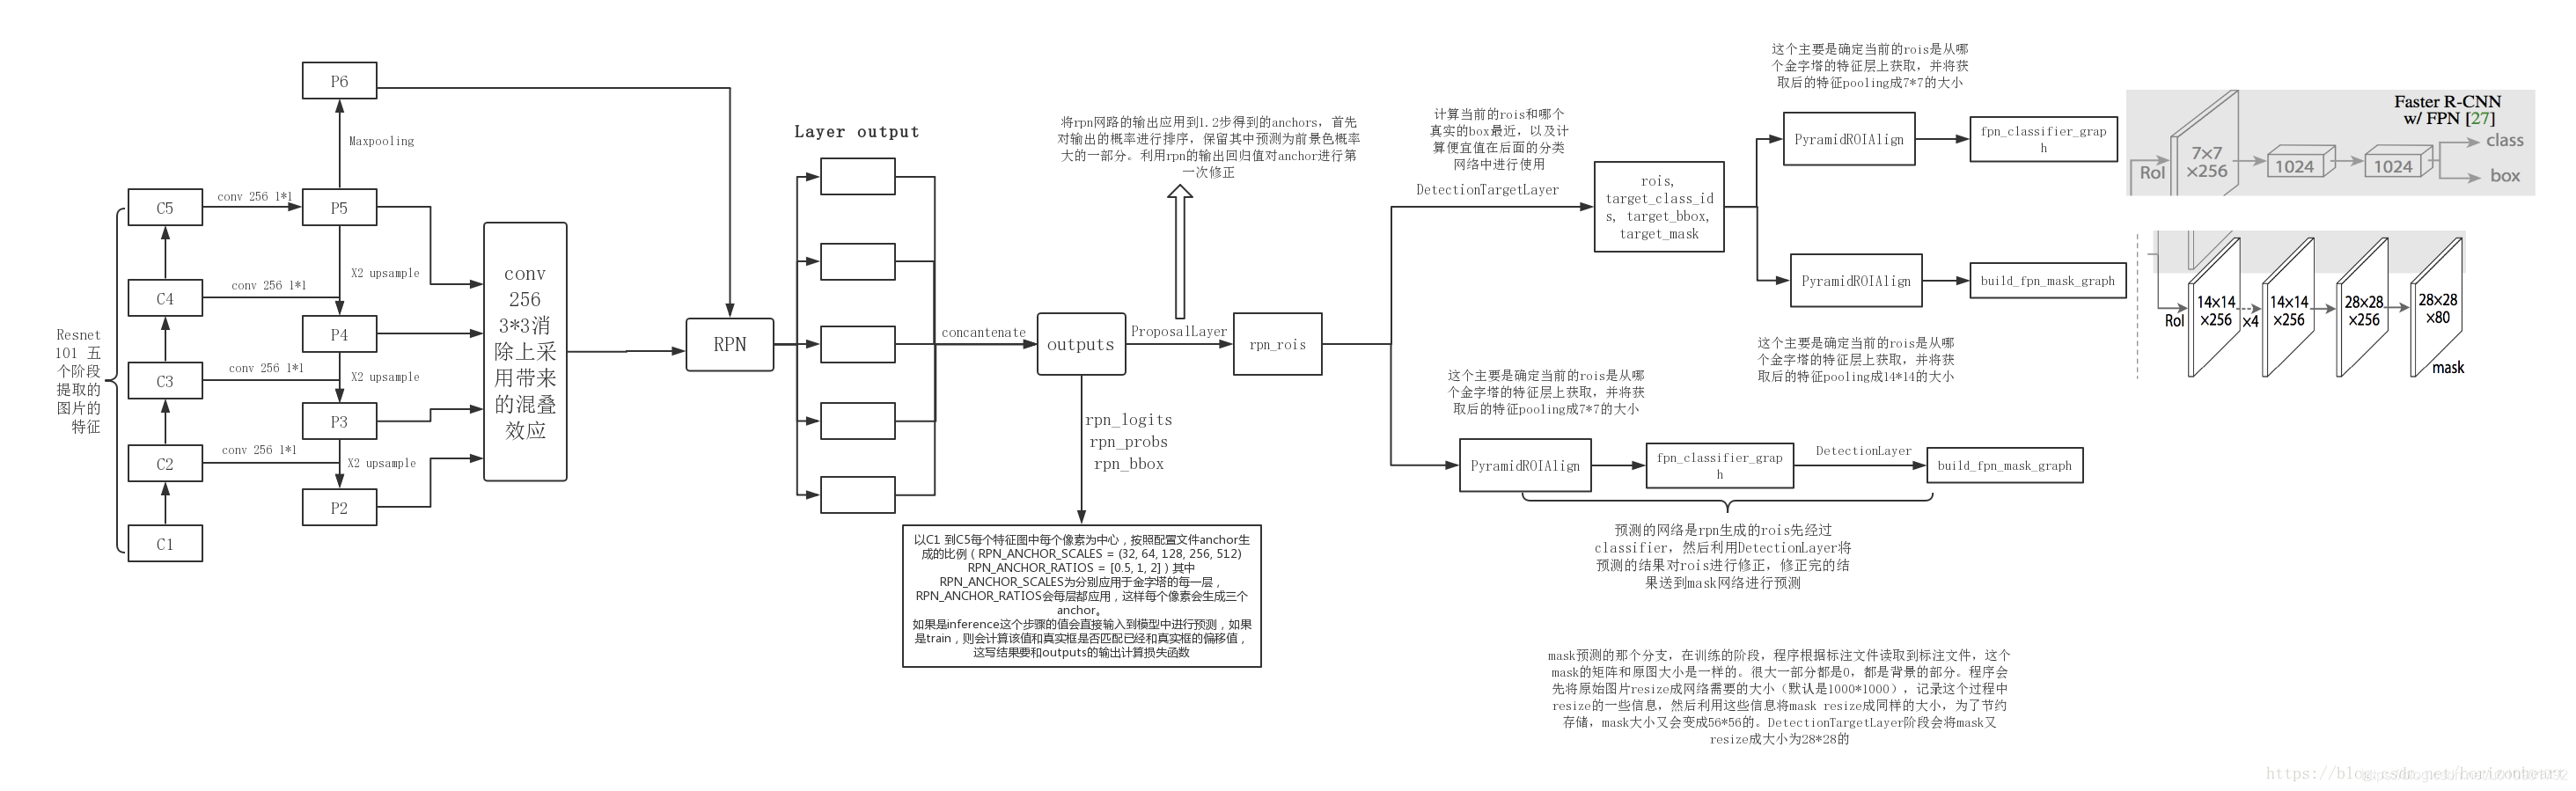
-
Mask-RCNN 与 Faster-RCNN 类似
- 第一阶段都是 卷积提取特征+RPN 生成候选框 (region proposal)和初步分类.
- 第二阶段中, Mask-RCNN 除了和 Faster-RCNN 相同的 ROI 池化, 分类和回归分支之外, 还添加了一个全卷积网络 (FCN) 的分支, 对每个 ROI 预测了对应的二值掩膜 (Binary Mask). 其中目标所在的像素为 1, 其他位置像素为 0.
-
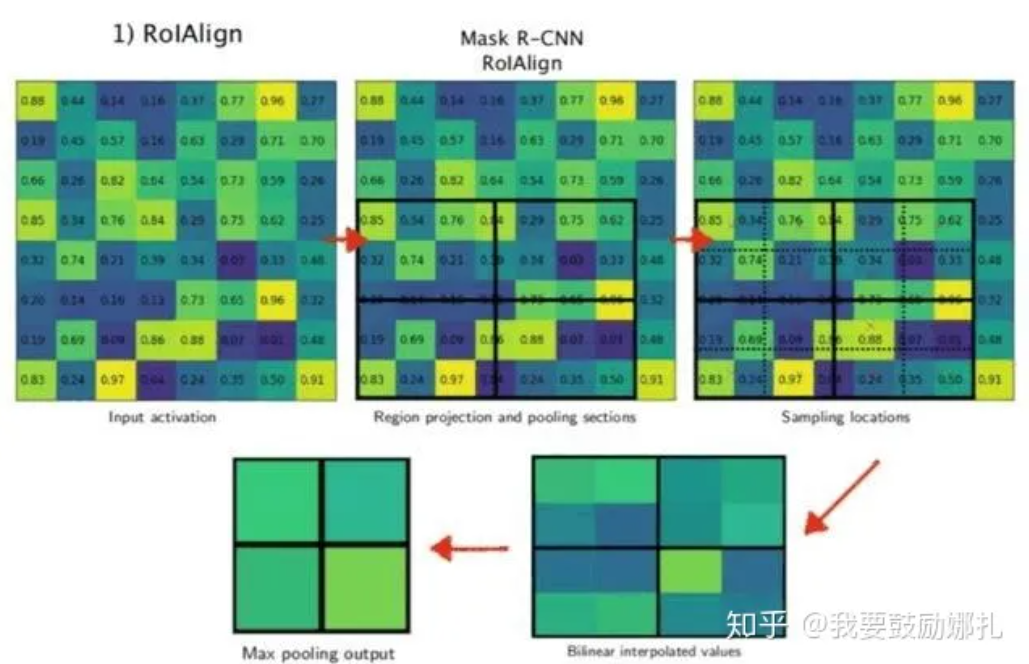
Mask-RCNN 对 ROI 池化做了改进, 使用 ROI Align.
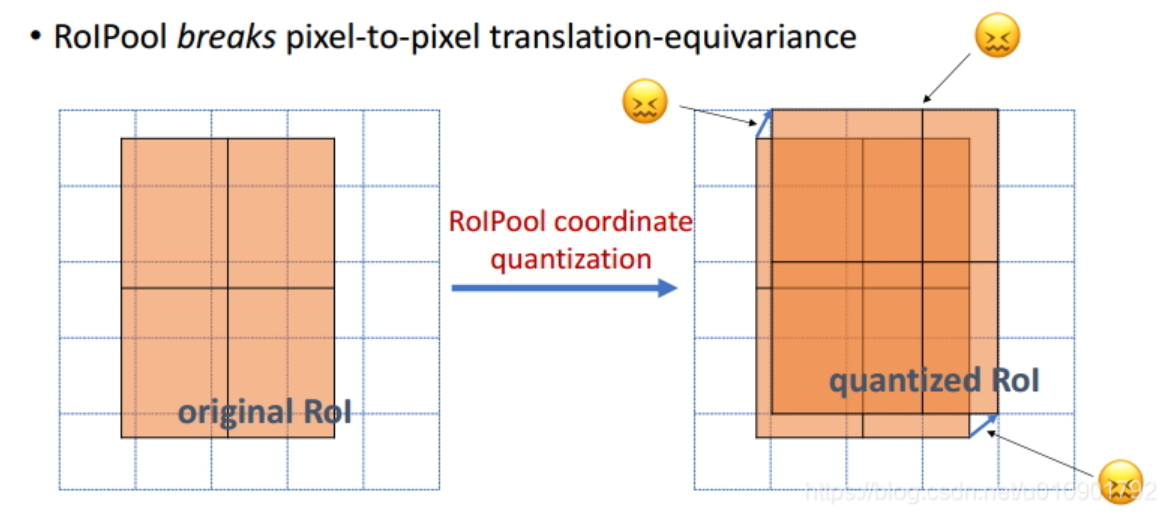
优化了ROI 池化的整数化 → 用双线性插值替代最近邻插值.
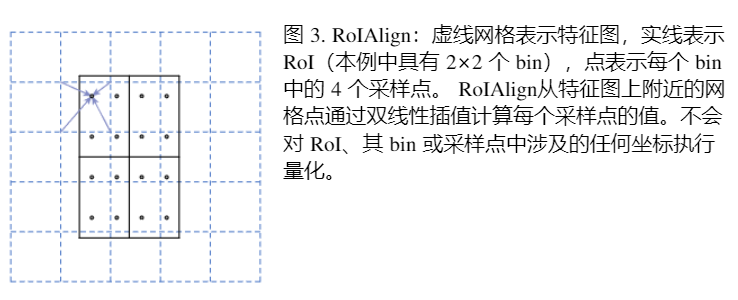
最后在每个大 bin 中对 4 个中心点进行 Max pooling.
-
FCN 是什么?
- 不含有 FC 层的卷积网络, 可以适合任意尺寸的输入.
- 增大特征尺寸的反卷积层 (deconv layer), 能够输出精细结果.
- 结果不同深度结果的跳级 (Skip) 结构, 能够同时确保鲁棒性和准确性.
- 优点
- 可以接受任意大小的输入图像 (因为没有全连接层).
- 更加高效, 避免了使用邻域带来的重复计算和空间浪费的问题.
- 缺点
- 得到的结果还不够精细.
- 没有充分考虑像素之间的关系, 缺乏空间一致性.
-
-
损失函数
-
计算每个 ROI 上的损失
$$ L_{ROI}=L_{cls}+L_{bbox}+L_{mask} $$
-
5.8. Vision Transformer 识别用
AN IMAGE IS WORTH 16X16 WORDS: TRANSFORMERS FOR IMAGE RECOGNITION AT SCALE
VIT (Vision Transformer) 模型论文+代码(源码)从零详细解读,看不懂来打我_哔哩哔哩_bilibili
Vision Transformer in Classification
-
预处理
对图片进行编码
前人研究中, 由于将图片每一个像素作为最细粒度进行 Embedding 的计算复杂度太高, 所以会使用特征图的每一个像素, 孤立自注意力 (只使用局部的小窗口, 通过控制窗口大小来调整计算复杂度) 或轴向注意力 (Axial Attention 将 2d 图片拆分为高度和宽度分别作为轴应用自注意力, 如以行为轴, 就是计算每一行与其他行之间的互相作用)
ViT 将图片划分为局部, 将局部像素变为一维作为一个元素输入 FC 层, 就可以获得 Linear embedding, 就可以传入 Transformer. 就和 NLP 的 Transformer 一样, 但是 ViT 是有监督的.
-
特性
-
ViT 在 ImageNet 这类中型数据库性能会低于 ResNet, 因为 transformer 对于卷积网络缺少了归纳偏置 (inductive biases), 这是获取先验信息的能力, 对卷积网络来说有两个归纳偏置:
- 空间局部性 (Locality) 由于卷积核的滑动, 相邻的区域会学习到相邻的特征 (共享权重)
- 平移等变性 (Translation equivariance) $f(g(x))=g(f(x))$, 不论先做哪个函数, 都是一样的结果. 可以将 $f$ 函数理解为卷积, $g$ 函数理解为平移操作. (因为卷积核是在图片中滑动的)
为了验证这个问题是由于缺少先验信息导致的, 使用大规模数据集预训练 ViT 后, ViT 的性能就获得了很大的提升.
-
在图片预处理之后, 直接使用标准的 Transformer 来做图片识别问题.
-
-
模型
-
模型结构图
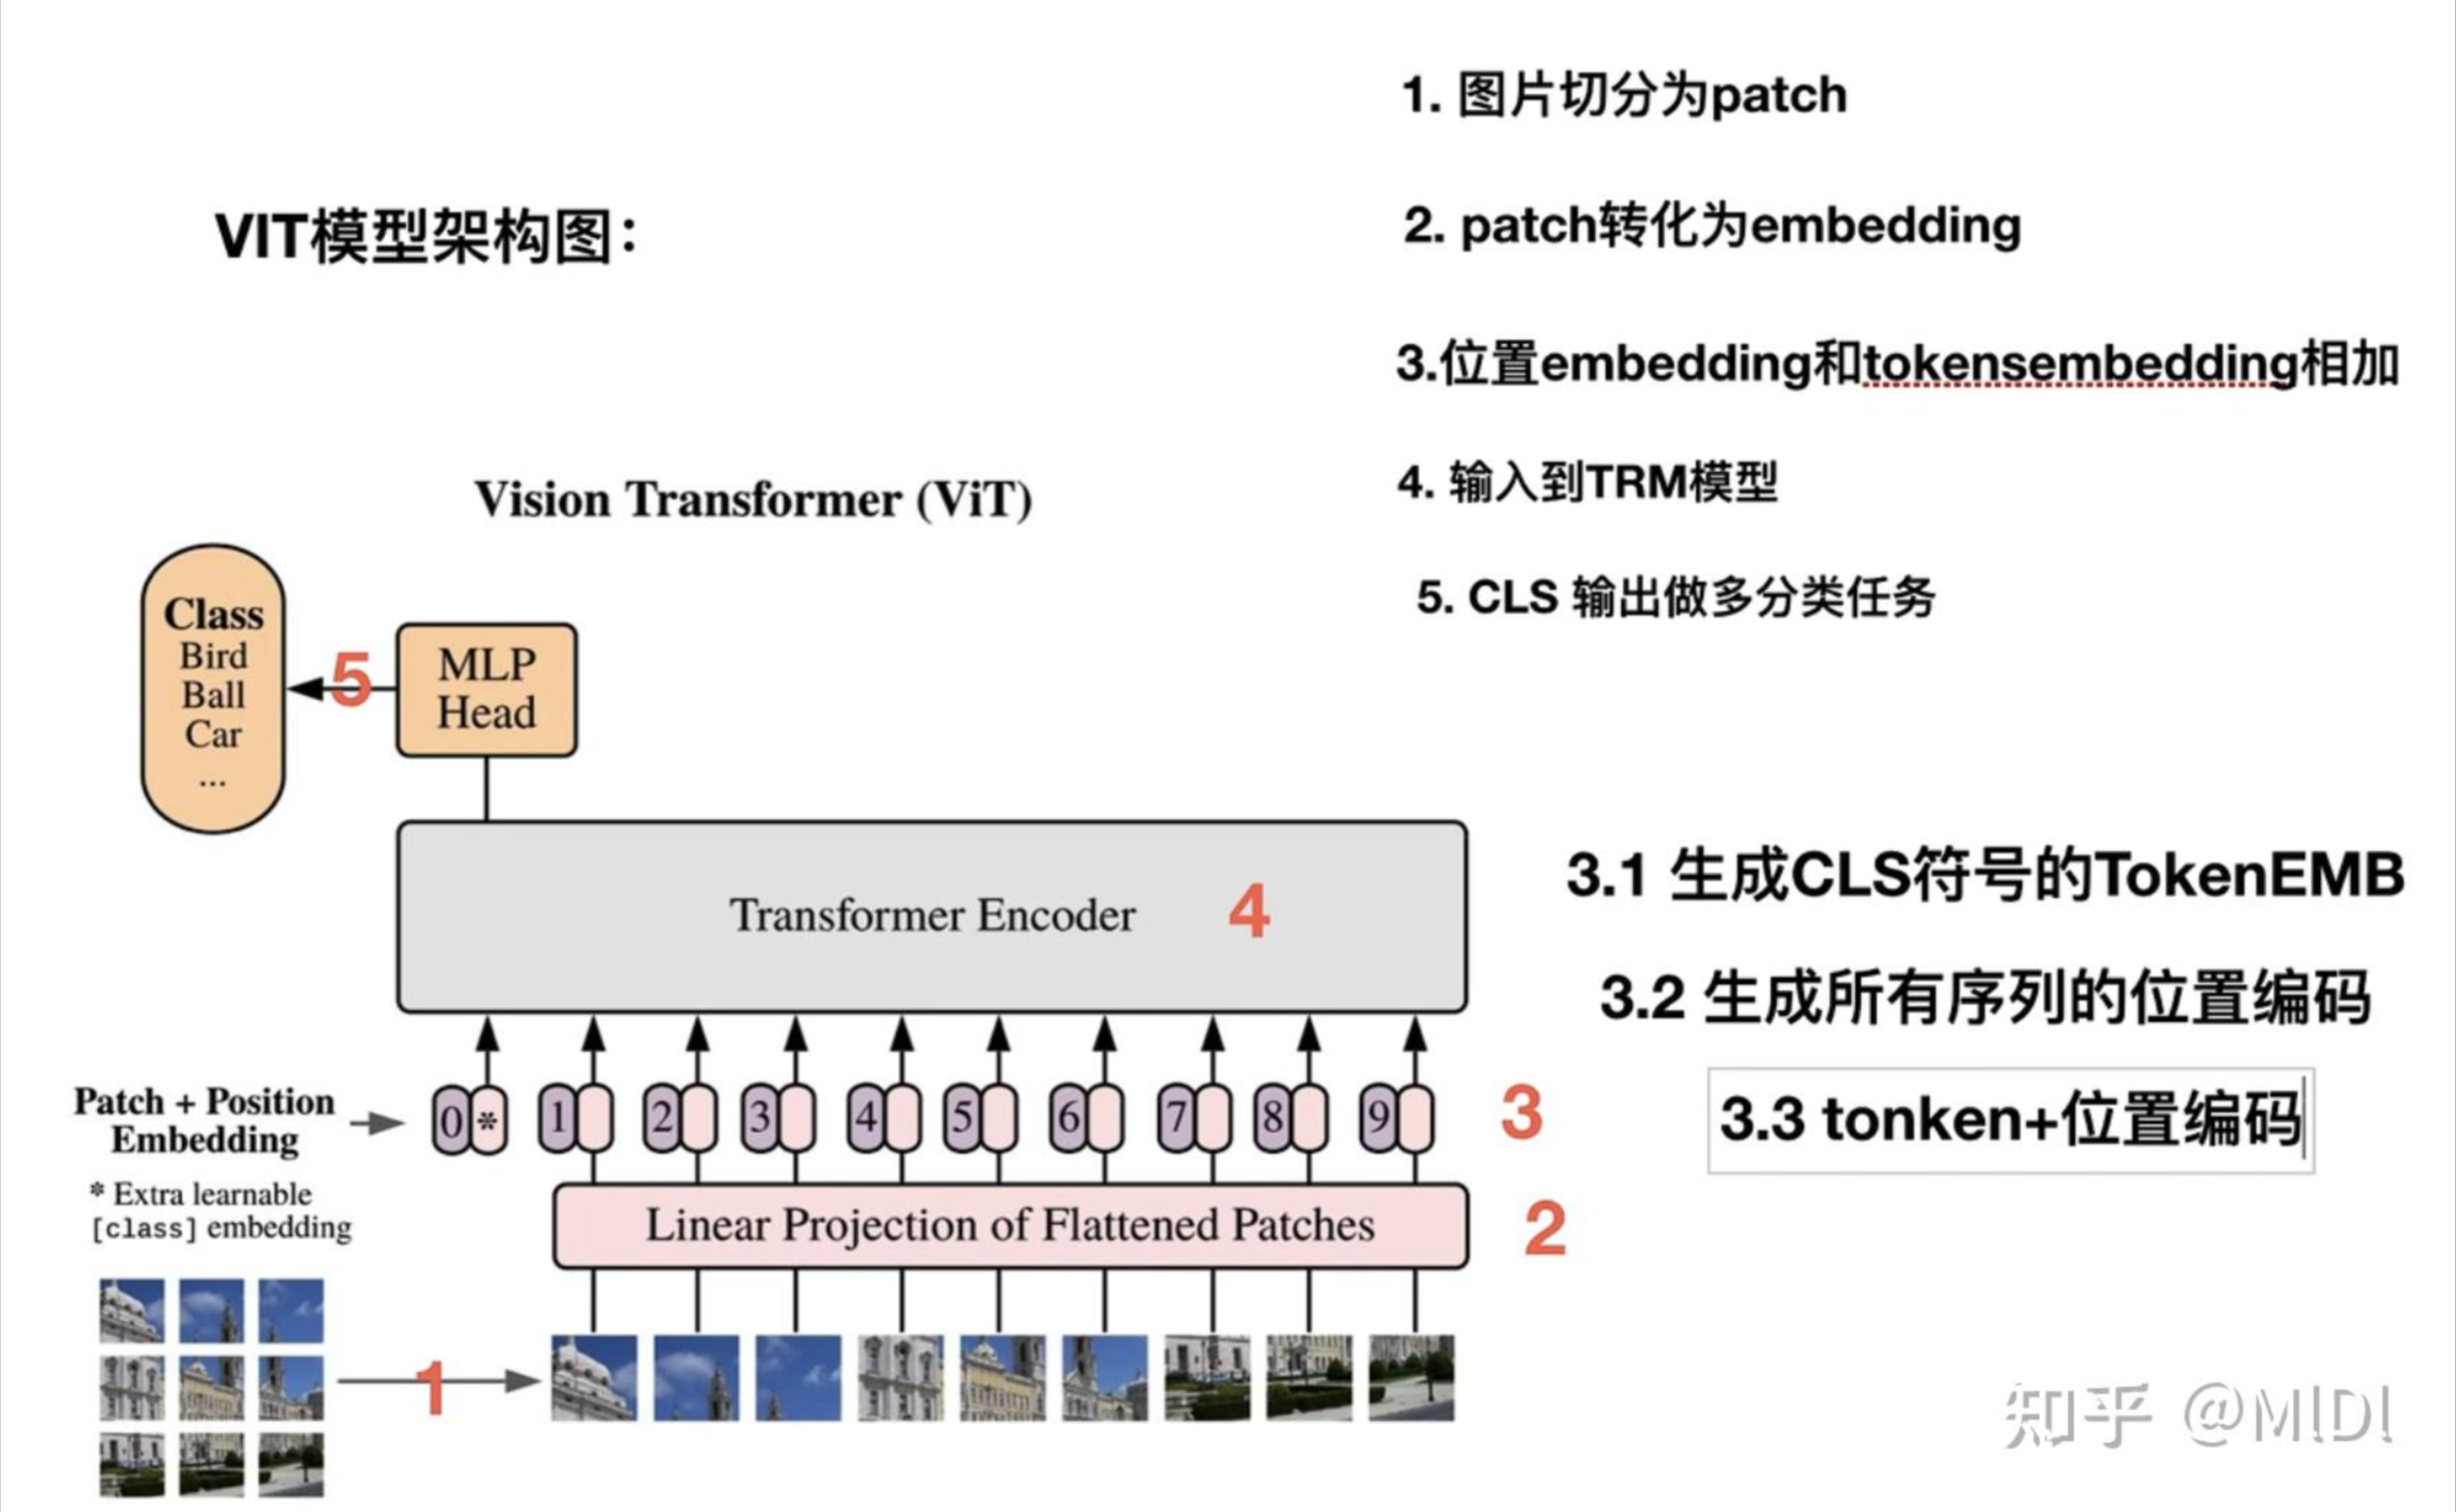
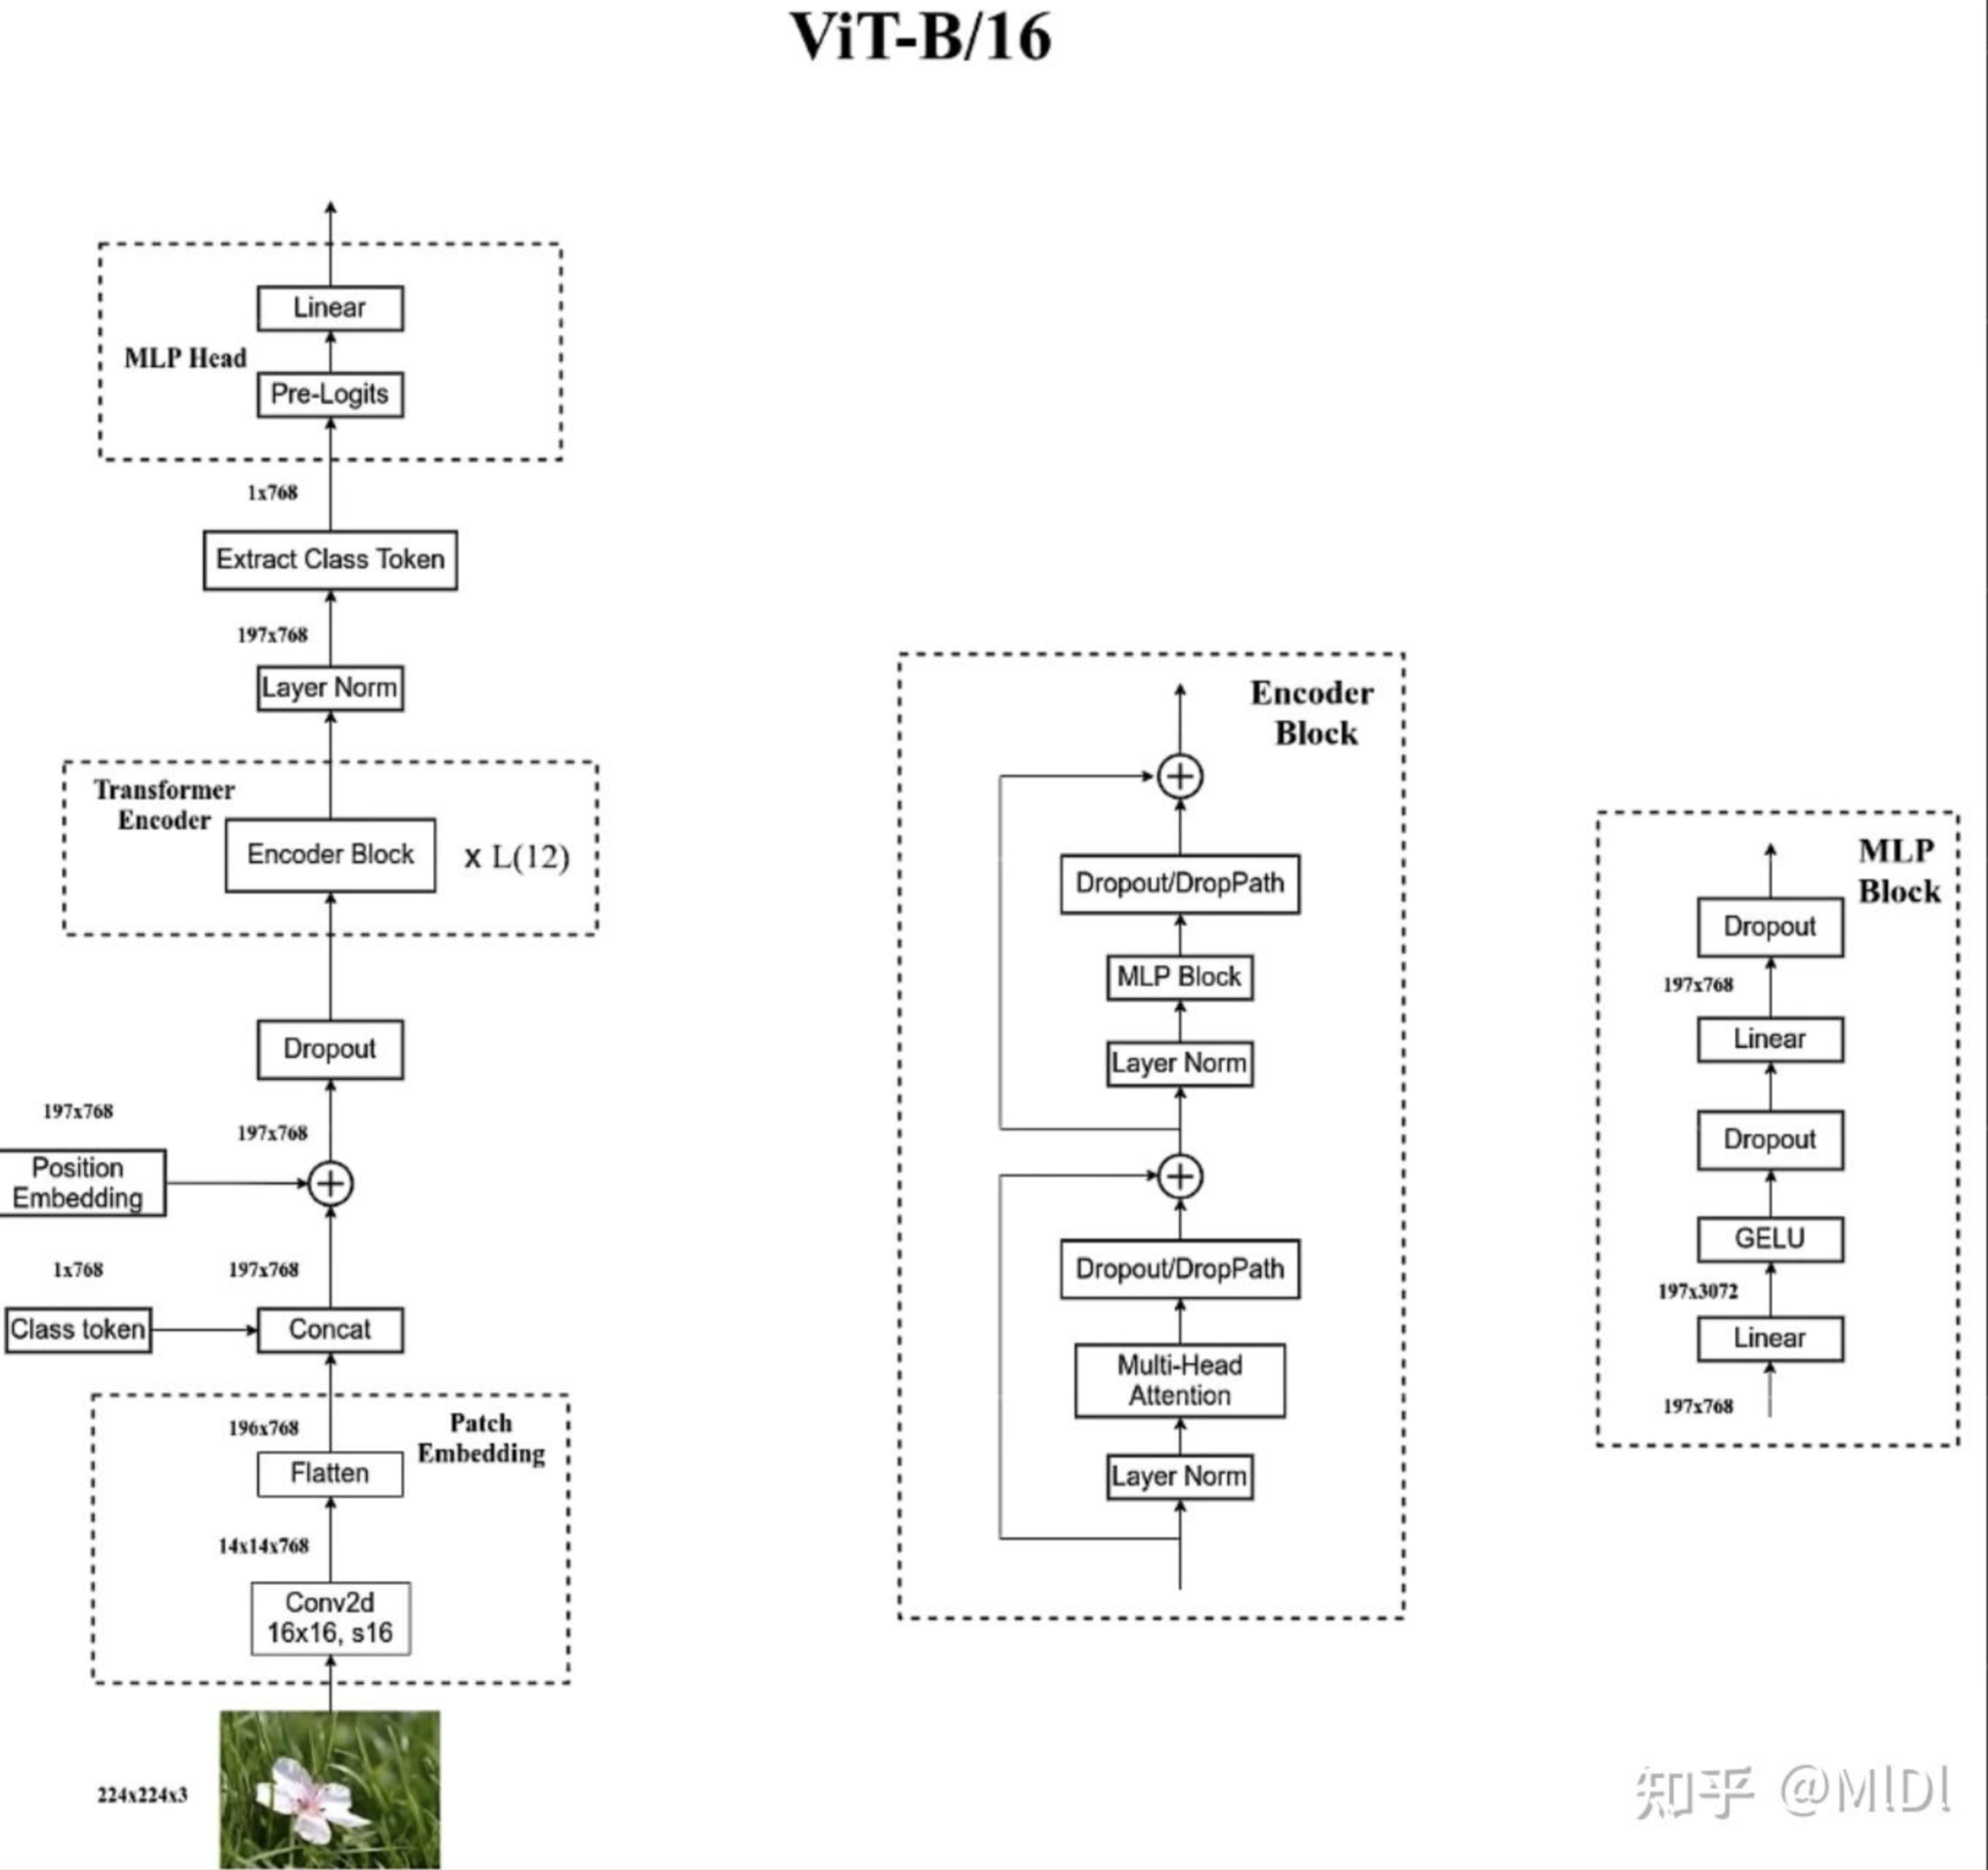
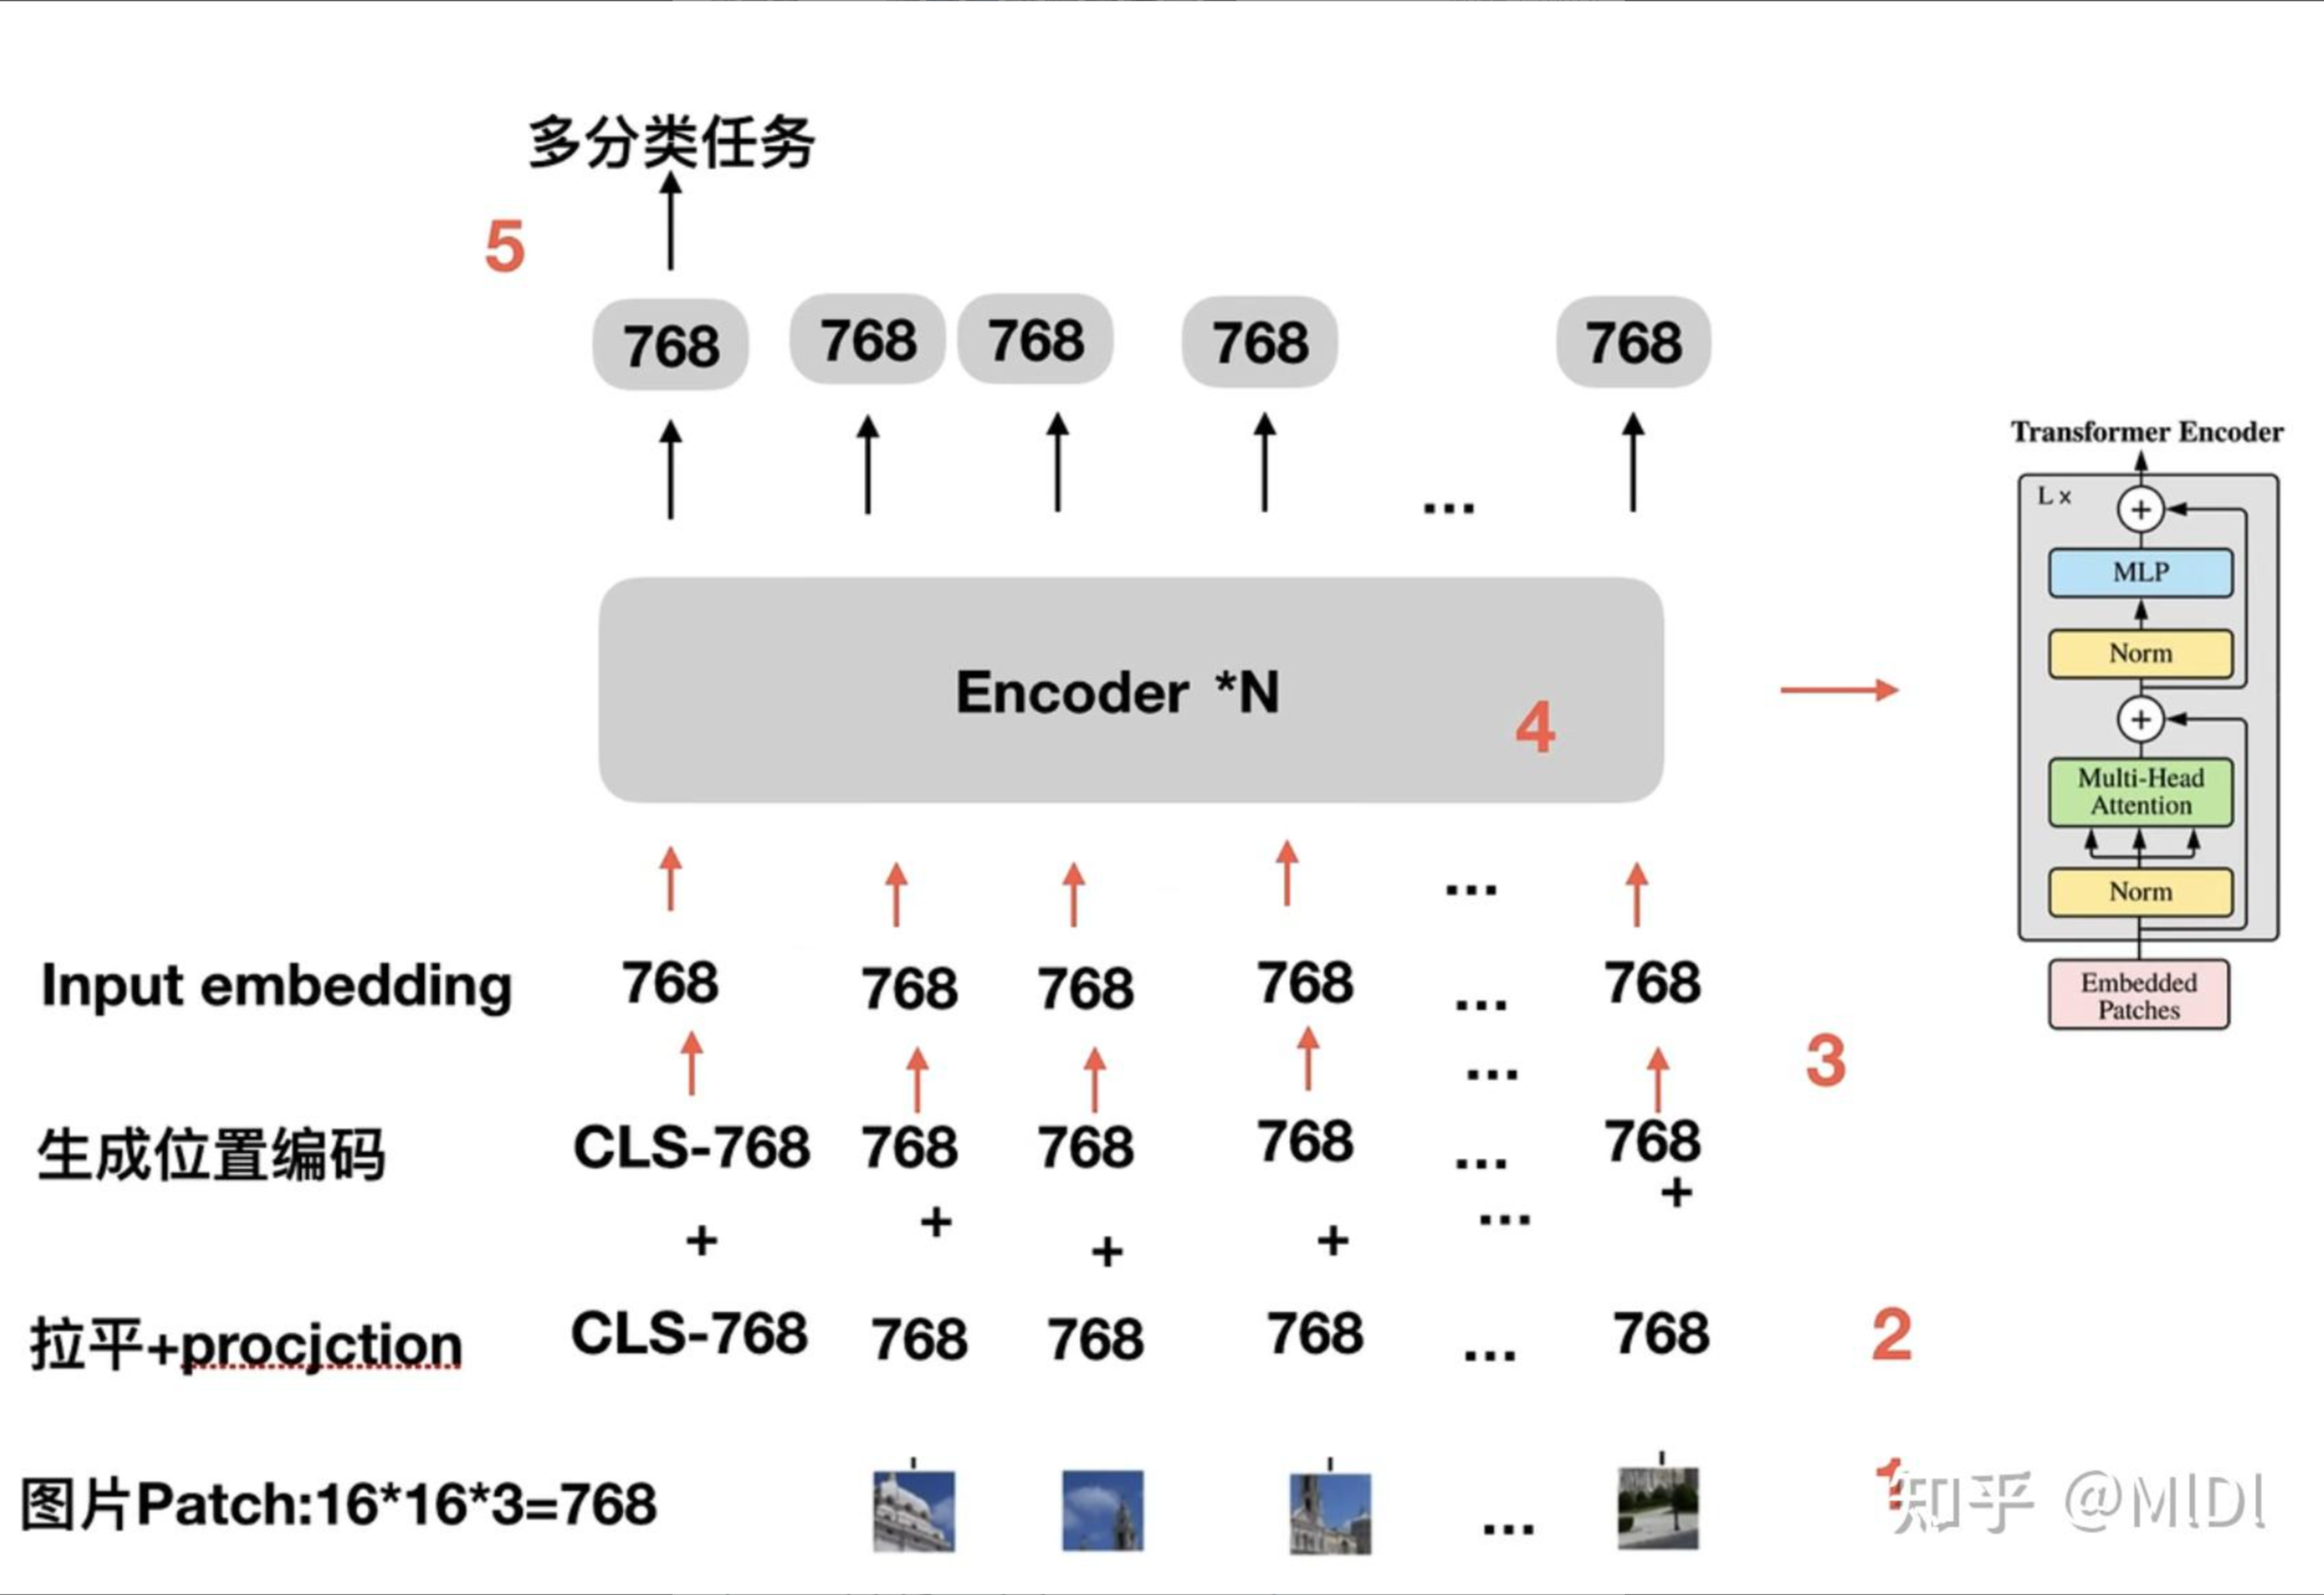
ViT 将图片划分为局部的块, 将块变为序列输入线性投射层 (FC). 这里图片既存在图片自身的信息, 又存在图片的位置信息 (Position embedding) 的, 就是上图的深色椭圆形数字. 位置信息可以让模型学到一般的情况下, 物体之间的位置关系.
假设输入图片尺寸为 $224\times224\times3$, patch_size=16 (切 $16\times16$ 块), 那么就可以获得 196 个图像块. 经过线性投射层的维度是 $768\times768$, 最终获得输出维度: $196\times768*768\times768=196\times768$ (矩阵运算), 这是图像本身的 token, 另外还需要加一个 spiecal token:
[class](是整个图片的分类 token, 实际上作用不大, 之后会说), 维度为 $1\times768$. 最终进入标准的 Transformer 的序列尺寸为: $197\times768$.这时候还需要加入位置编码信息. 建立一个表, 表的每一行代表一个序号 (位置信息), 每一行是一个向量, 维度是 $768$. 这样表的尺寸就是 $197\times768$. 将这个表与图像的 token + class 相加即可.
-
Transformer encoder
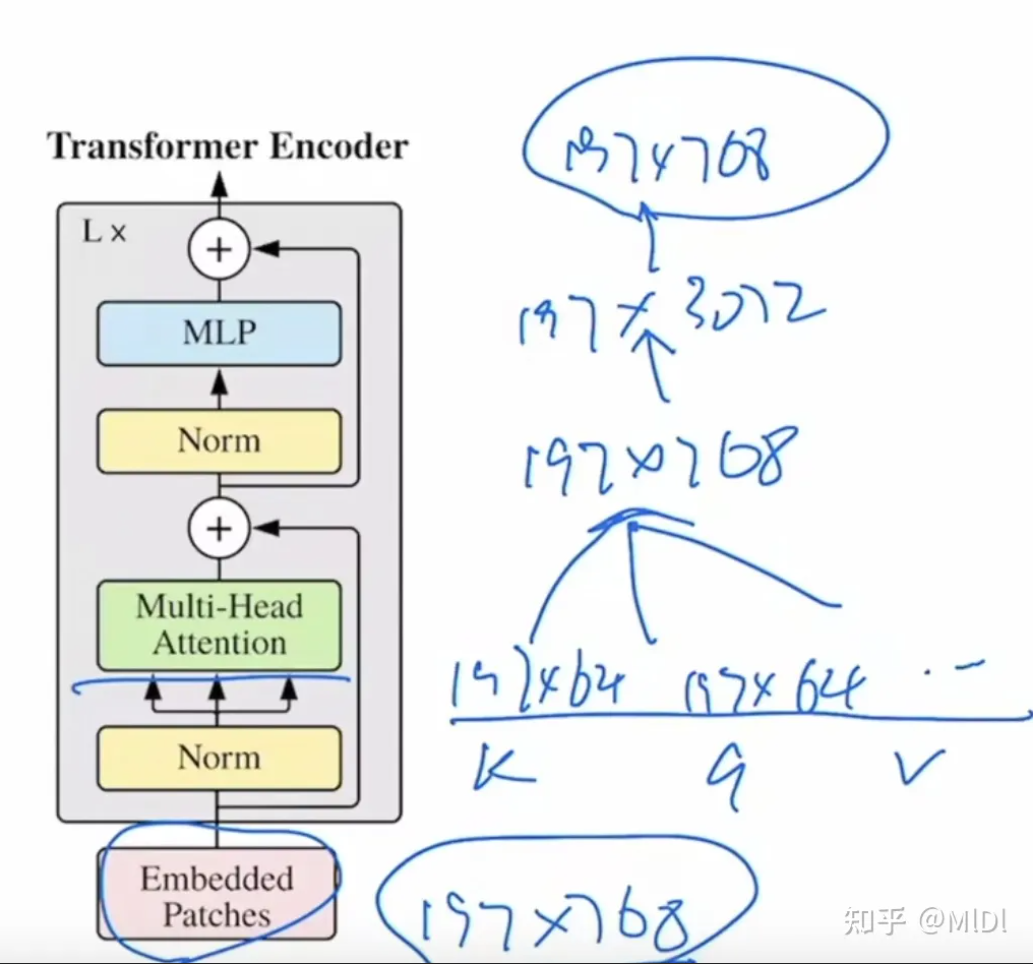
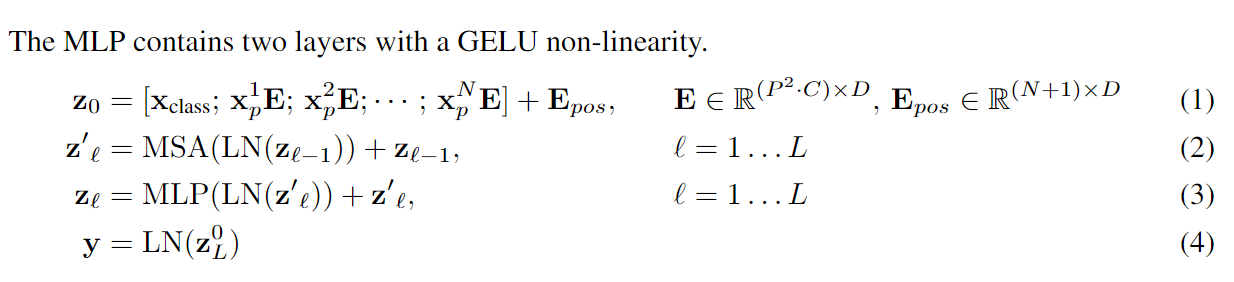
输入矩阵经过归一化层尺寸不变, 经过多头注意力层时, 假设有 12 个自注意力头, 每个头中的 $k,q,v$ 的维度都变为 $197\times(768/12)$, 将 12 个头拼接, 获得维度还是 $197\times768$ 的矩阵. 经过 MLP 层时, 维度会放大 $197\times3072$, 再缩小回 $197\times768.$ (MLP 是 Transformer 里的feed forward, 把 attention 抓取出来的序列信息映射成语义信息). 这里为了对应残差连接所以维度不变, 这样也可以叠更多个 Transformer Encoder.
-
-
监督学习
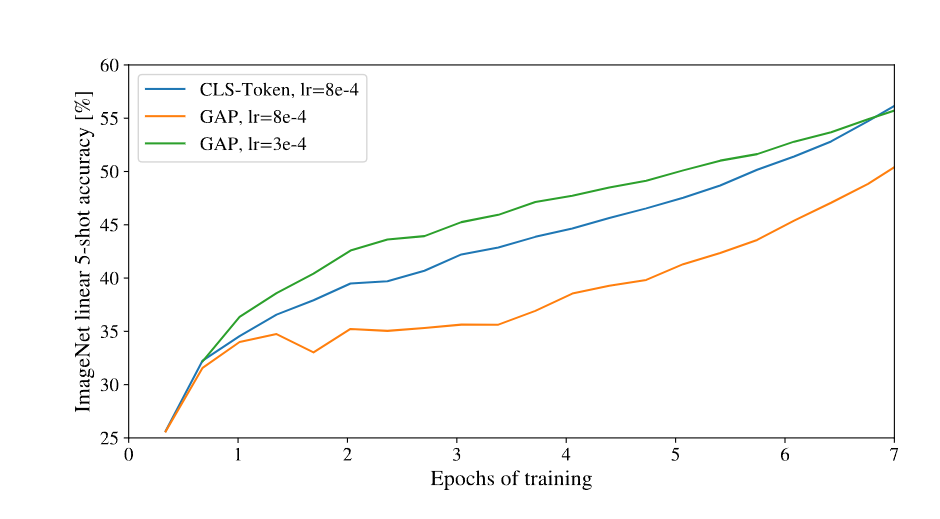
上面讲到 [class] token, 作者为了保持和原始的 transformer 保持一致, 所以也用了 [class] token, 在 NLP 是对句子做分类的时候用到的特征, 在 ViT [class] token 用于局部图像块的分类 (就是输出结果中提取 class token, 输入一个小型多层 MLP + tanh 激活函数做分类).
一般的图像识别网络, Backbone 后面可以接 GAP (全局平均池化), 池化后 + 单层 FC + Softmax. 好好调参的话, 效果和 MLP 差不多.
-
不同的位置编码
作者使用了 1-D 位置编码, 2-D 位置编码, 相对位置编码, 但是效果差异不大.
-
1-D 位置编码:
$$ 1\ 2\ 3\ \cdots\ 9 $$ -
2-D 位置编码:
-
相对位置编码:
同样是一维, 使用块之间的相对距离来编码, 而不是绝对位置.
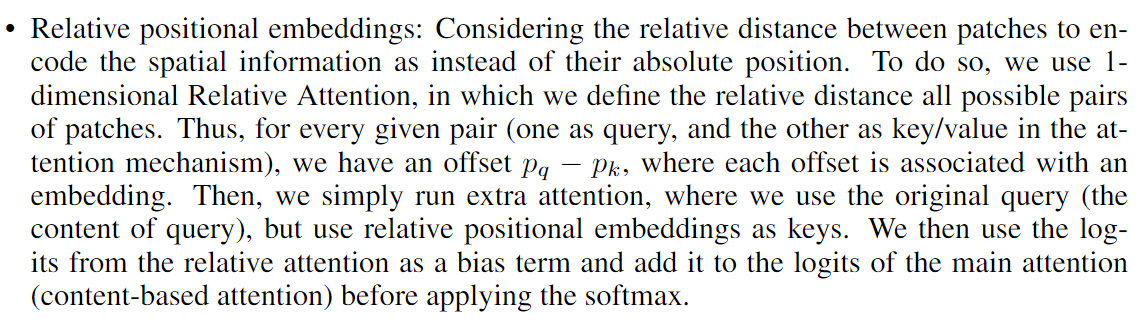
作者认为, 是因为分出来的块太少, 只有 16 块, 所以不管用那种方法位置信息都很明确, 所以性能没有差距.
-
-
对于大尺寸图片的微调
理论上来说, ViT 可以对应各种大小的图片, 保持 patch size 不变的情况下, token 的长度会边长, 只要显存够就能训练. 但是, 如果训练大尺寸图片, 那边原来的位置编码信息就没有用了, 因为token 长度对不上.
这时候, 需要对微调图片进行 2d 插值缩放图片到训练时用的图片大小, 但是这么做会影响性能.
-
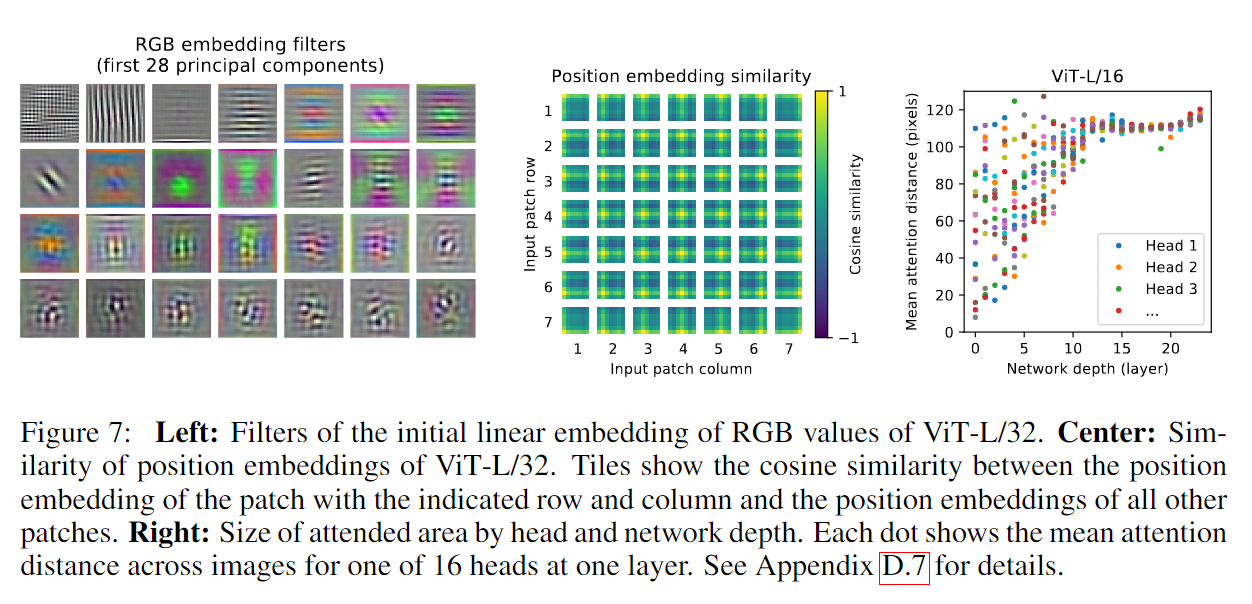
可视化实验
左图展示了 Linear projection layer 如何 embedding 图片的 RGB 值, 结果类似于特征图.
中图展示了 Position embeddingm, 显示的是位置之间的相似性, 结果可以看到同行同列和特殊比例位置相似性会更高.
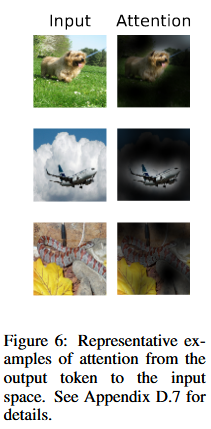
右图展示了图片中远距离像素点之间的关系是否会被自注意力观察到.
-
可以看到自注意力模块可以看到图像主体.
-
5.9. DETR 2020
End-to-End Object Detection with Transformers
https://github.com/facebookresearch/detr
目标检测(DEtection TRansformer)—DETR
-
过去的检测网络是从小到大, 从局部到全局 (FPN → PAN), 各个尺度集合到一起; DETR 是从大到小, 从全局到局部的方式.
- 简单来讲, DETR 找目标就像在地图上找目标一样, 先全局粗略搜索, 再精细搜索, 所以对小目标检测效果不是很好.
-
网络结构
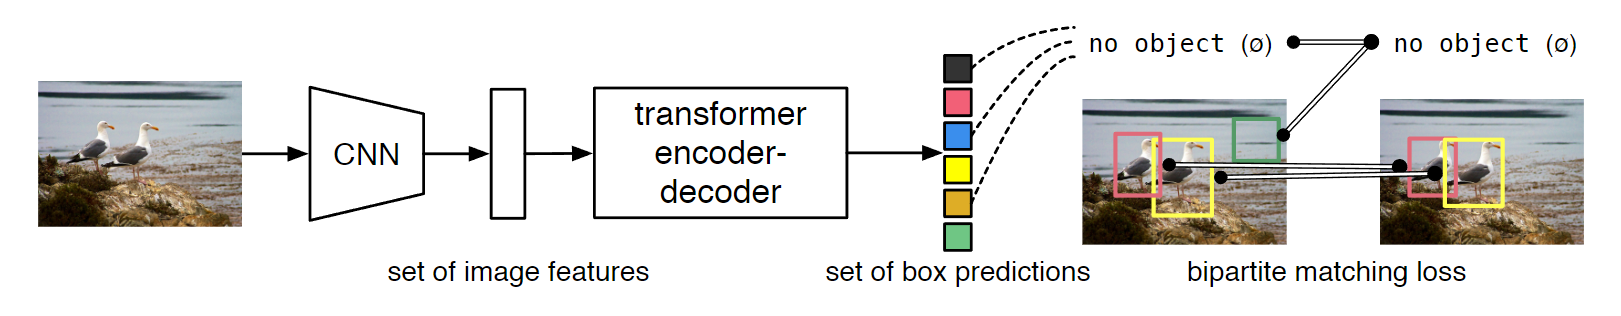
DETR 先使用卷积网络提取特征, 后接上 Transformer 编解码, 并行预测最终的检测结果.
Loss: 在训练过程中, 使用二分匹配将预测框与 GT 框进行匹配, 没有物体的框归为“无对象”分类. 预测框与 GT 框一对一匹配. 用的匹配算法是匈牙利算法.
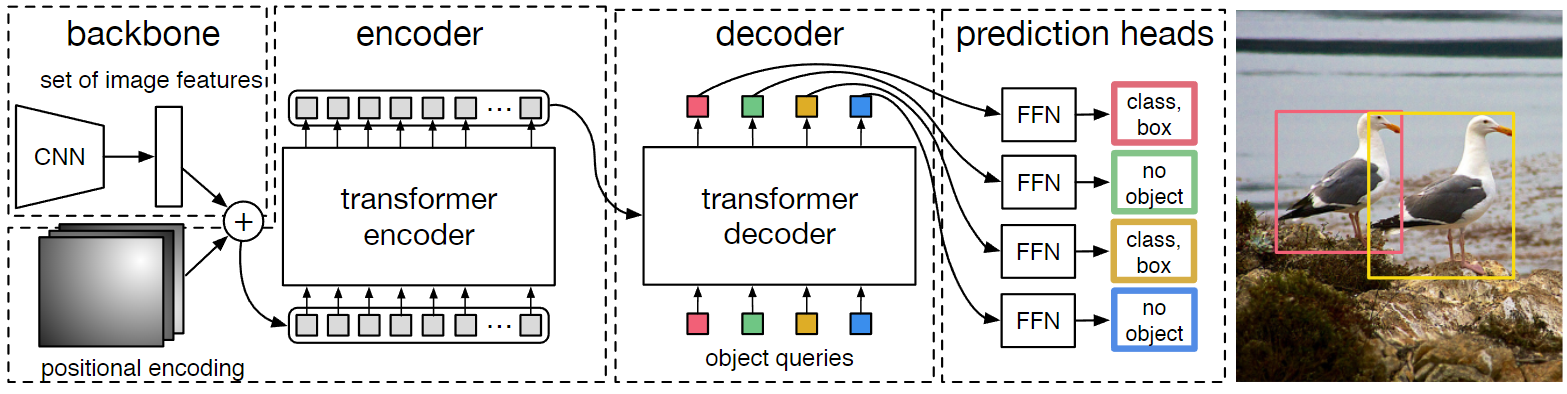
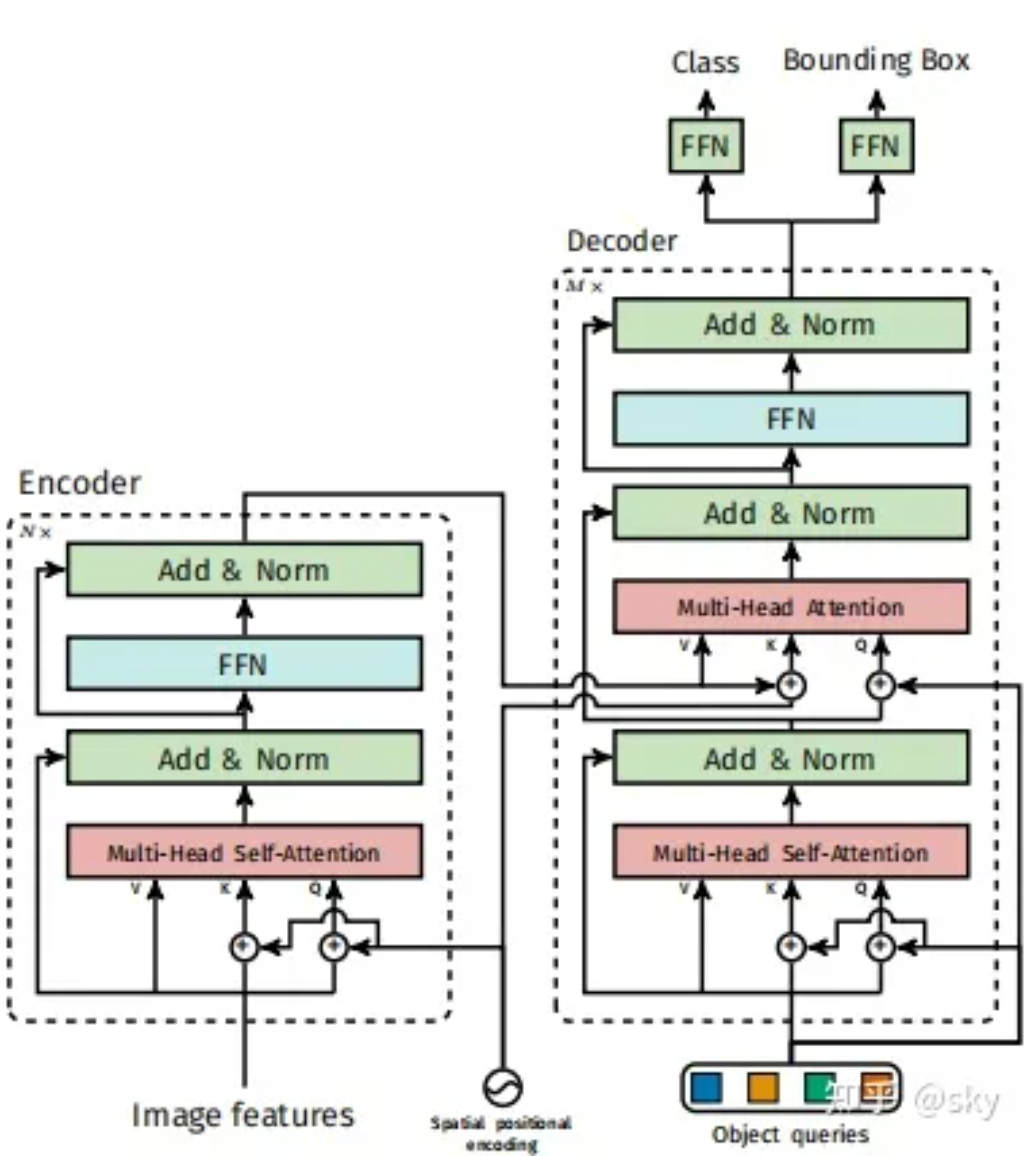
解码器解码之后, 将 embedding 出入共享前馈网络 (feed forward network FFN, 一般是 MLPs), 获得类和边界框结果.
-
编码器
-
不是必须的, 作用是特征加强.
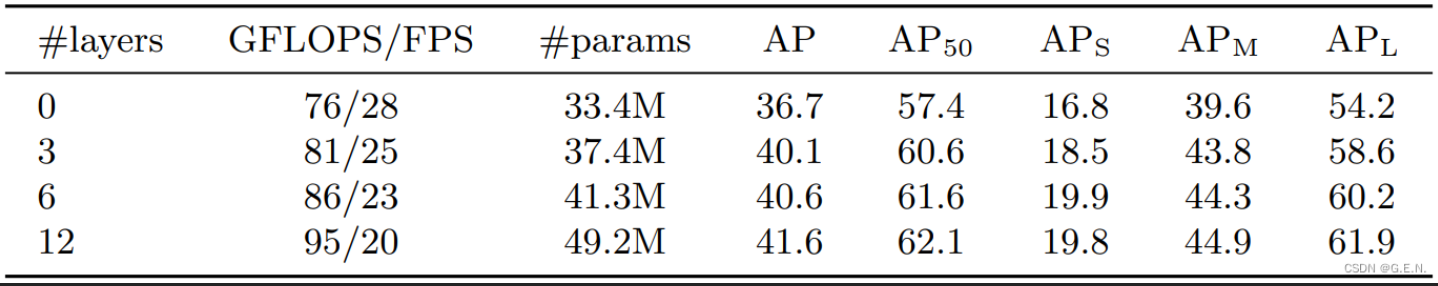
-
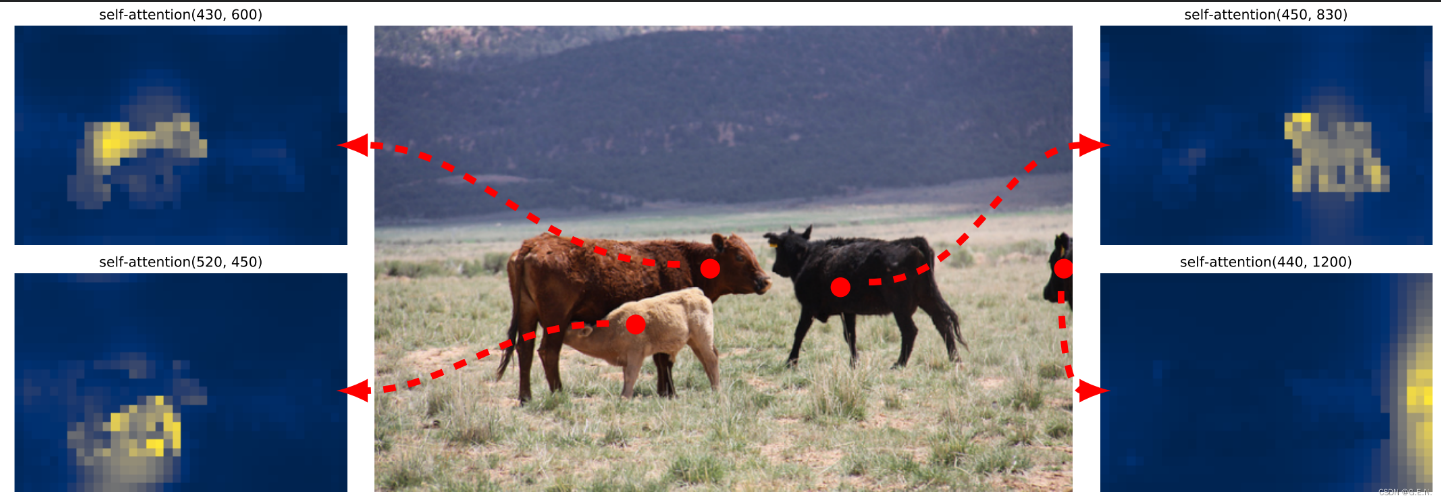
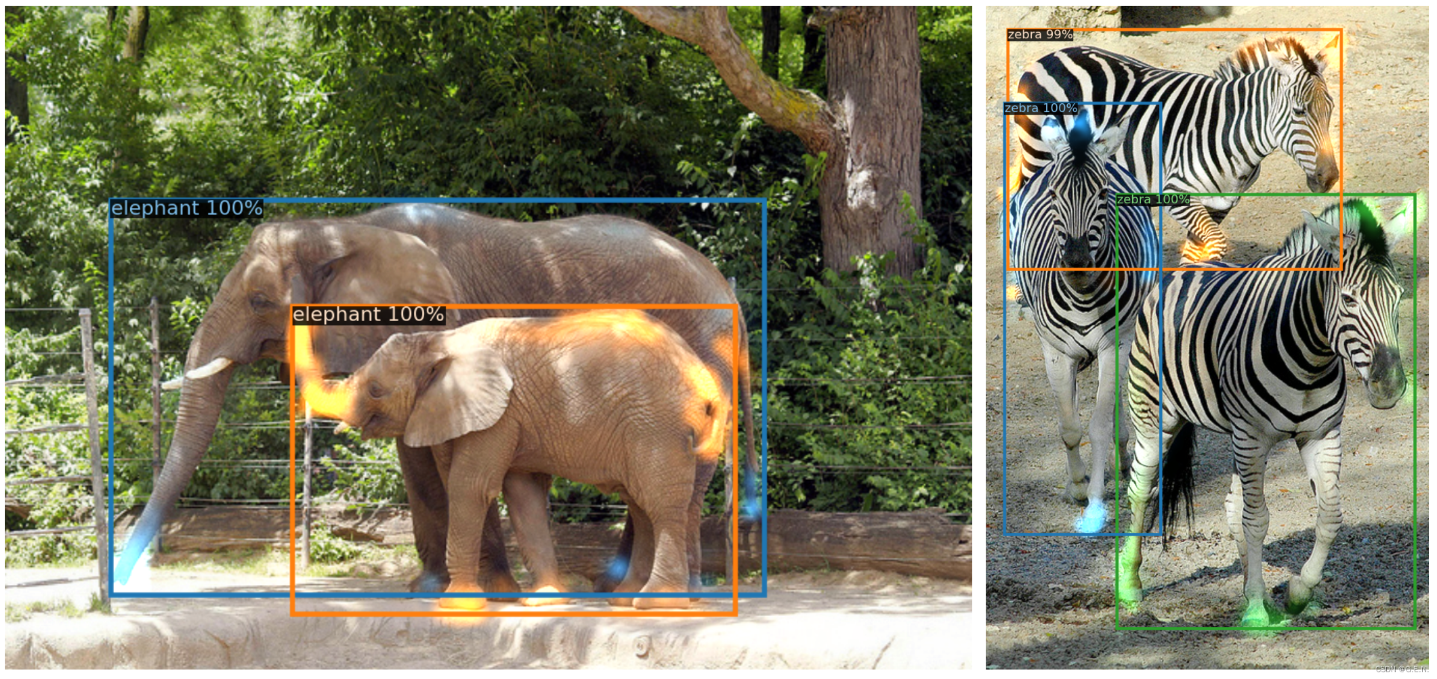
注意力可视化图中可以看出, Encoder 的注意力机制可以抠出目标, 即使遮挡严重
-
-
解码器
Decoder 的注意力集中在目标边缘, 说明 Decoder 学到了目标的边缘信息, 这有助于更加精确的定位目标.
-
-
网络优点:
- 简化了流程提升了效率, 消除了如 NMS, anchor.
- 提高了性能.
-
性能
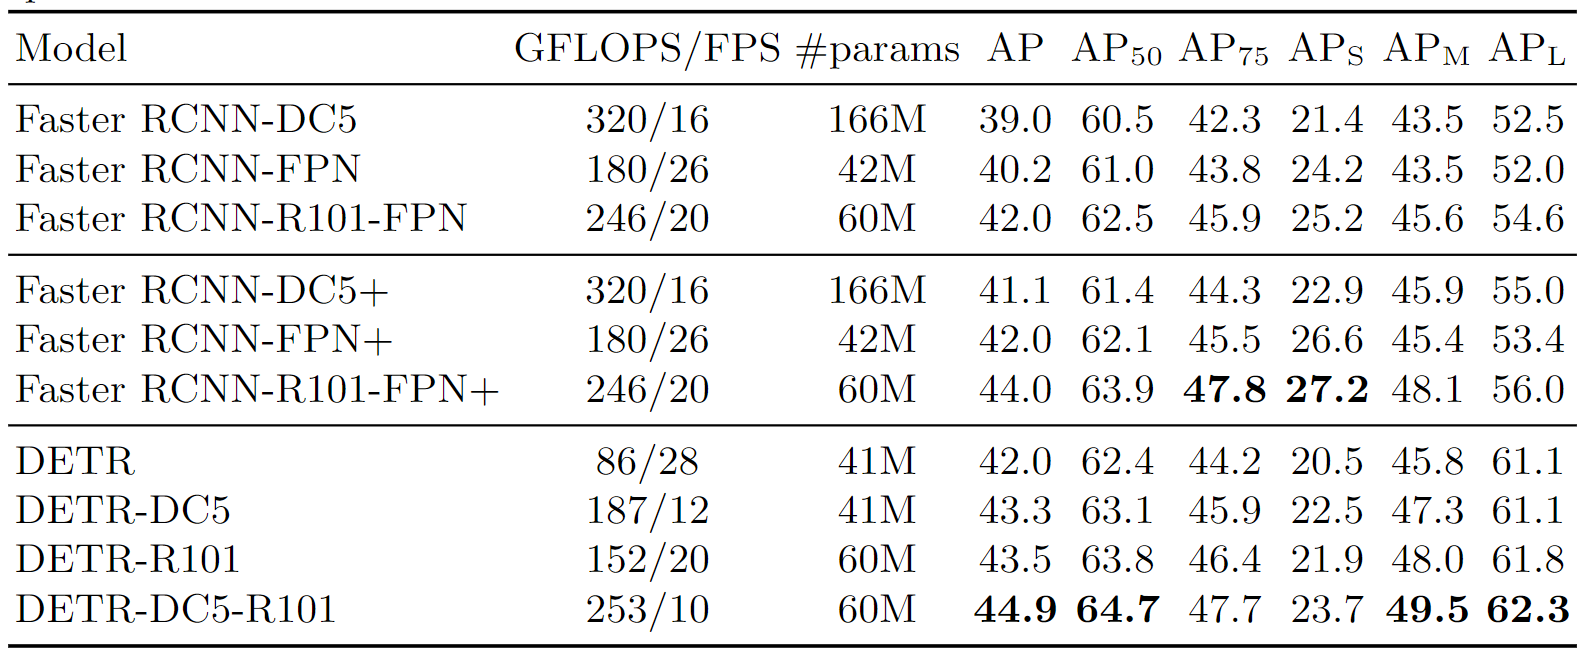
- R101 是用了 RESNET-101 作为 Backbone. 没有写 R101 的用了 RESNET-50.
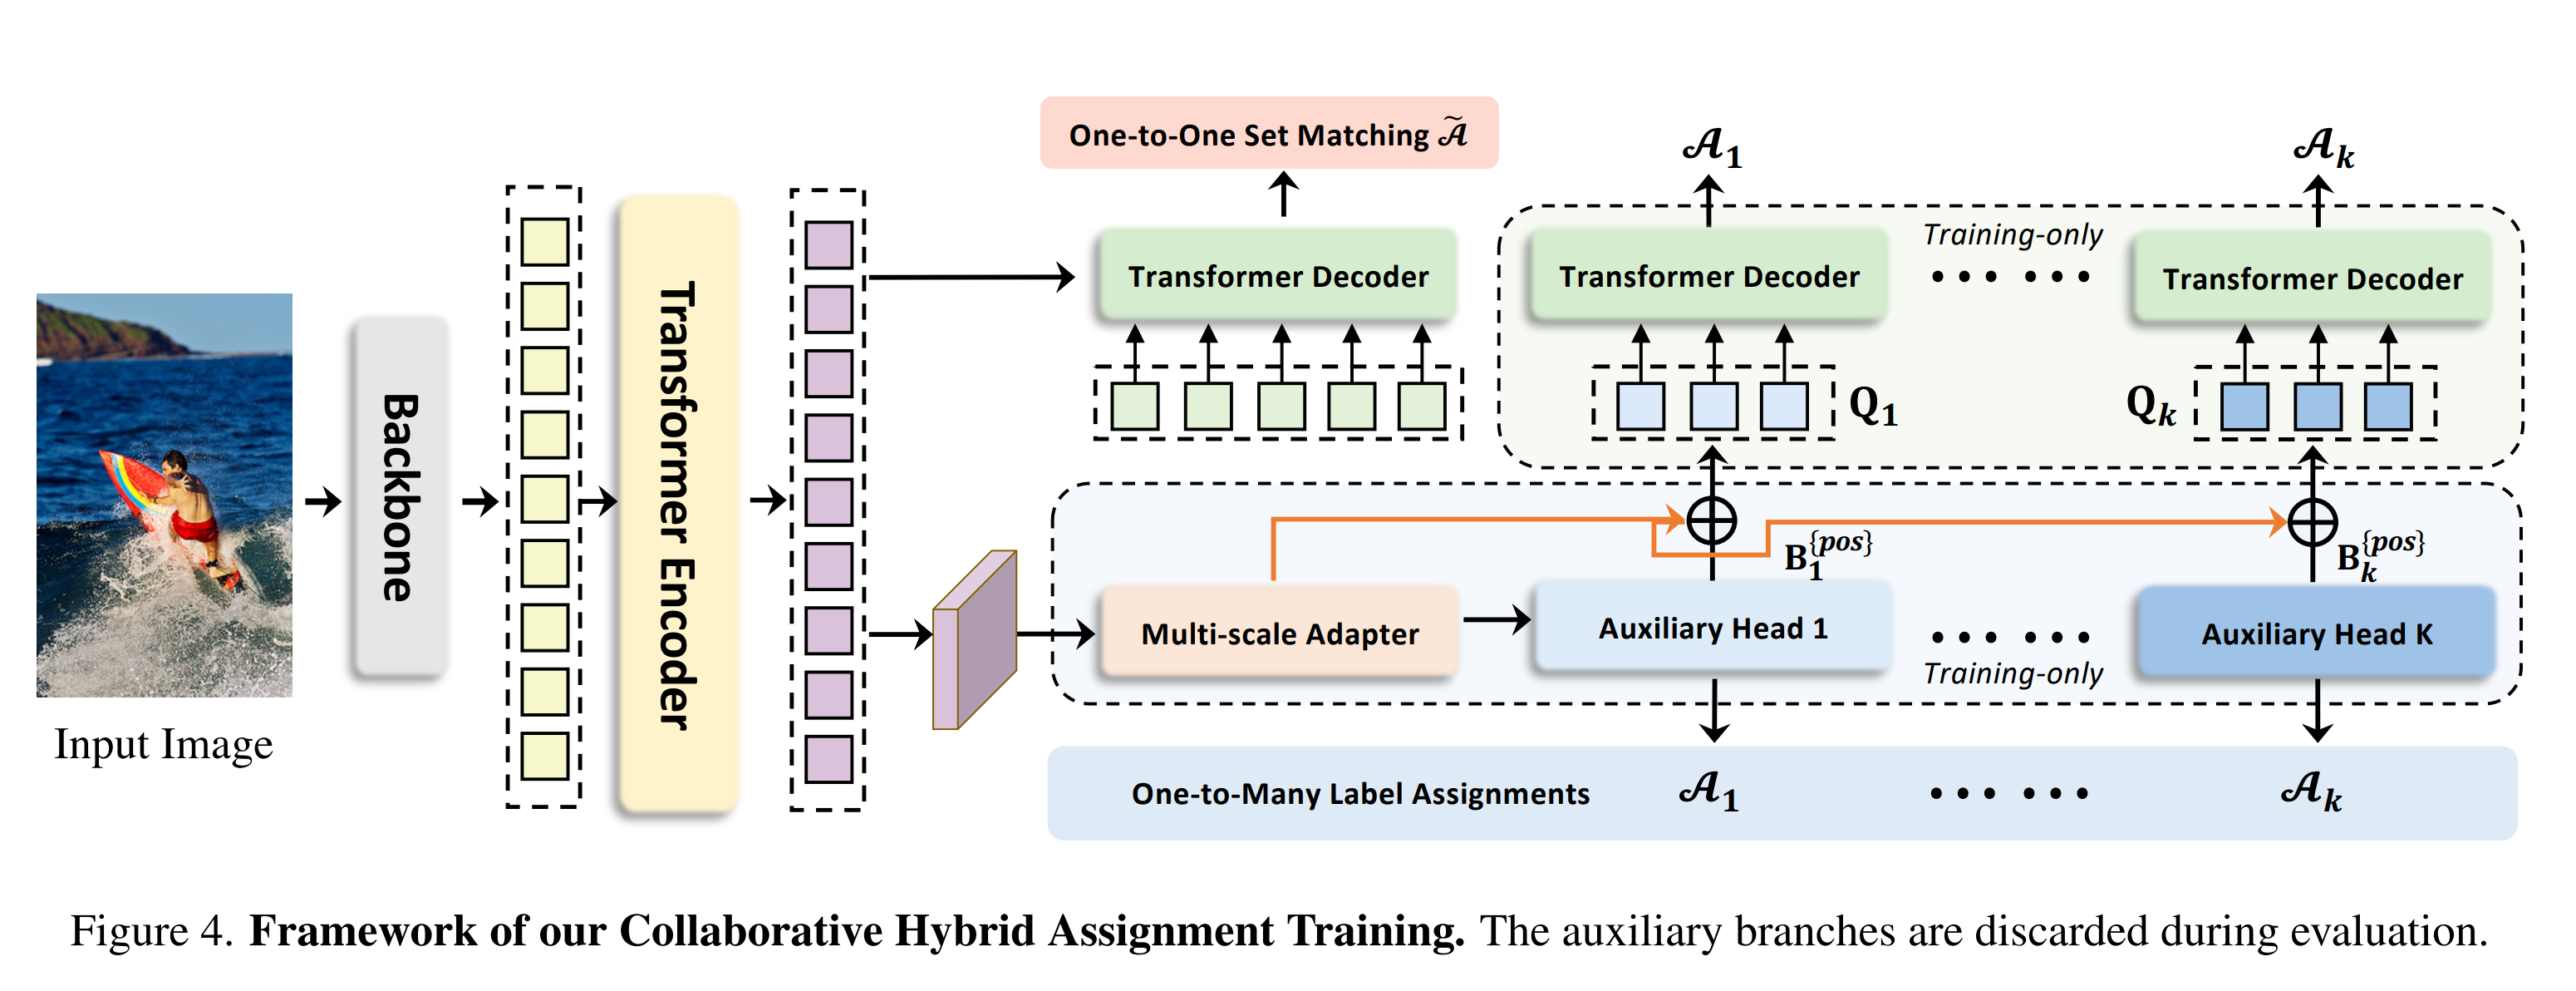
5.10. Co-DETR 2023
DETRs with Collaborative Hybrid Assignments Training
Co-DETR:DETRs与协同混合分配训练论文学习笔记_co-detr 环境配置-CSDN博客
-
网络结构图