1. 数据的预处理
- 对于缺失值
- 缺失量少,均值,中位数等填充;
- 缺失量多,离散化;
- 拟合模型填充.
- 对于异常值
- 基于统计的方法:3 sigma
- 聚类方法
- isolation forest 等算法.
2. 特征工程
-
连续特征, 离散特征
-
特征组合, 生成新的特征
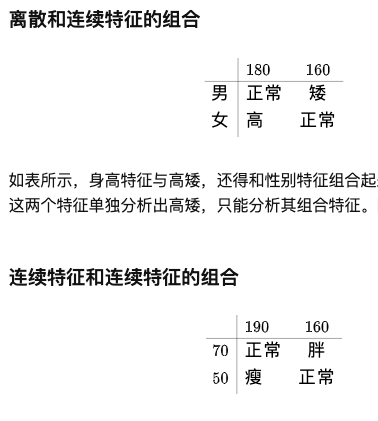
-
特征的归一化 (Normalization) 对于在一定范围内的特征
-
eg: 身高
-
线性函数归一化 (Min-Max Scaling)
$X_{norm}=\frac{X-X_{min}}{X_{max}-X_{min}}$
-
零均值归一化 (Z-Score Normalization) = 标准化 (Standardization)
$z=\frac{x-\mu}{\sigma}$
$\mu$: 均值. $\sigma$: 标准差
$\sigma = \sqrt{\frac{\sum (x_i-\mu)^2}{N}}$
-
优点:
- 在变量更新速度不一致的情况下, 归一化能更好的实现梯度下降
- 线性变换不会改变原始数据的数值排序
-
-
类别型特征 (Categorical Feature) 对于只在有限选项内取值的特征
- eg: 性别, 血型
-
特征的选择
- Filter(过滤法)
- 按照发散性或相关性对各个特征进行评分, 设定阈值或者待选择特征的个数进行筛选
- 就是, 算特征与特征之间的关系
- Pearson()皮尔森相关系数: 单个变量之间的线性相关性,结果的取值区间为[-1,1]
- from scipy.stats import pearsonr
- 优点: 速度快
- 缺点: 只对线性关系敏感
- 卡方验证
- 类别型变量对类别型变量的相关性
- 最大信息系数 maximal information coefficient (MIC)
- from minepy import MINE
- Pearson()皮尔森相关系数: 单个变量之间的线性相关性,结果的取值区间为[-1,1]
- Wrapper(包装法)
- 根据目标函数(往往是预测效果评分), 每次选择若干特征, 或者排除若干特征
- Embedded(嵌入法)
- 先使用某些机器学习的模型进行训练, 得到各个特征的权值系数, 根据系数从大到小选择特征(类似于Filter, 只不过系数是通过训练得来的) word2vec
- Filter(过滤法)
-
特征的降维