最小二乘问题的四种解法——牛顿法,梯度下降法,高斯牛顿法和列文伯格-马夸特法的区别和联系
1. 梯度下降
梯度下降法用来计算函数的最小值.
1.1. 二维函数梯度下降
比如需要计算函数 $f(x)=x^2$ 的最小值, 如果不从经验上获知其最小值, 如何通过迭代来计算呢?
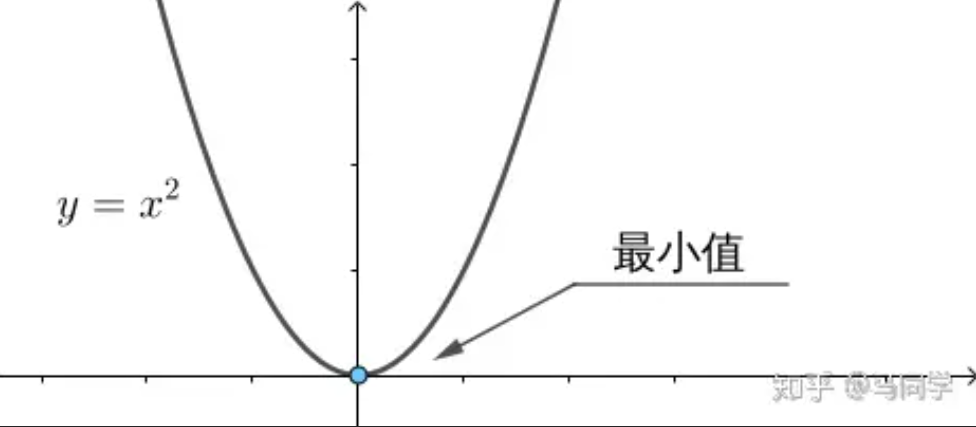
-
首先需要设置一个起点 $x_0$, 假设 $x_0=10$.
此时函数的梯度如下
$$ \nabla f(x_0)={f}'(x_0)=2x_0=20 $$由于这个梯度是一个一维向量, 并且在 $x$ 轴的向量指向函数增长最快的方向, 求梯度下降的目的是找到函数增长最慢的方向, 也就是反方向 $-\nabla f(x_0)$.
另外 $\nabla$ (Nabla算子) 是向量微分算子, 定义为 $\nabla_r=\frac{d}{dr}$.
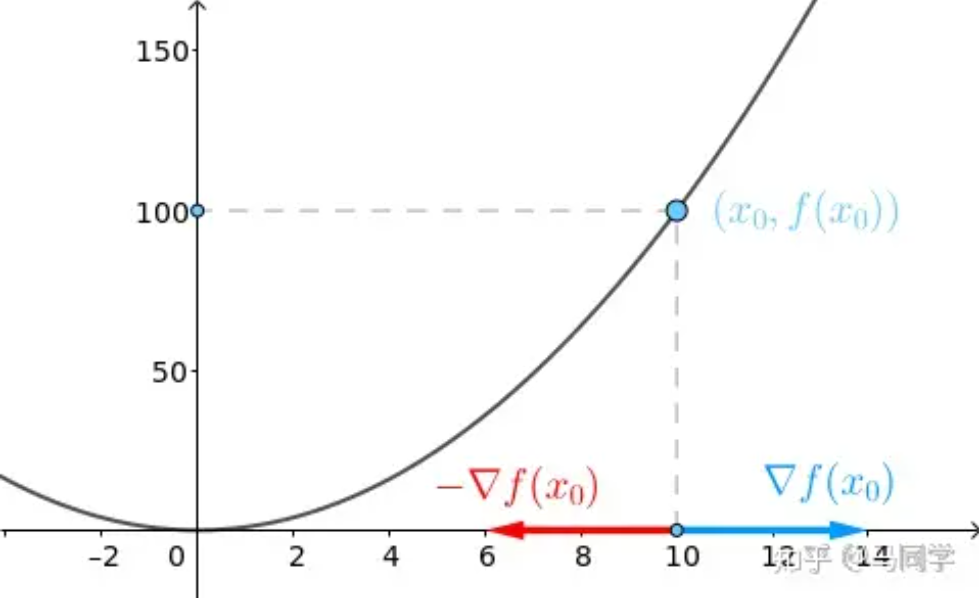
-
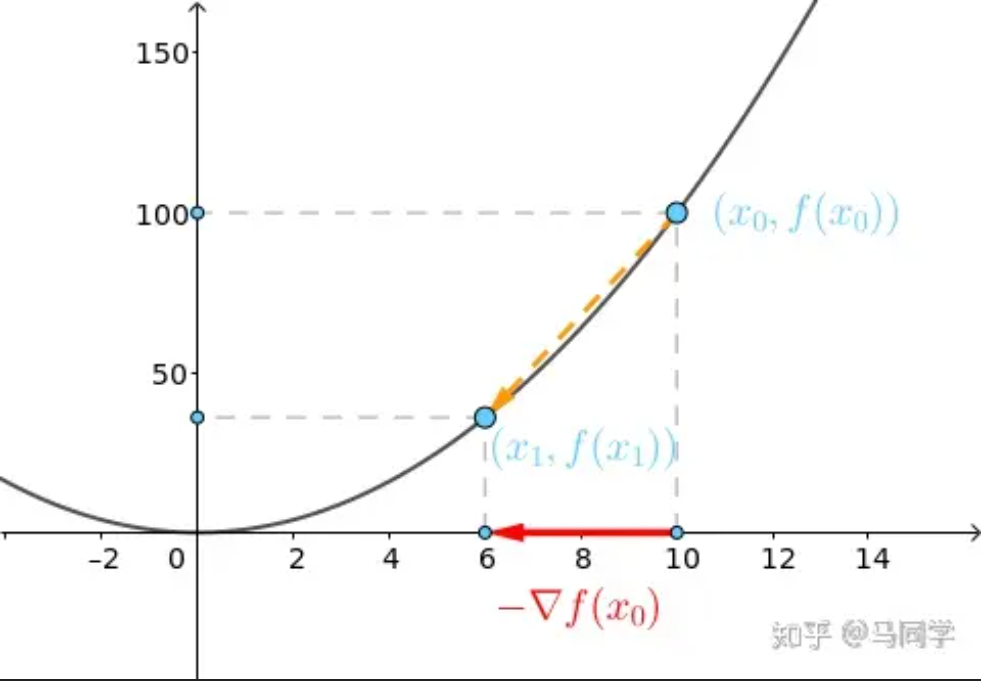
这时候将当前值 $x_0$, 将其看做向量, 与梯度的反方向相加, 就可以获得下一个值 $x_1$ 的位置.
$$ x_1=x_0-\gamma\nabla f(x_0) $$- 这里的 $\gamma$ 表示为步长 (学习率), 用来控制采样点移动距离. 步长的设定是凭借经验的, 过小收敛较慢, 过大会无法收敛. 这里设定 $\gamma = 0.2$.
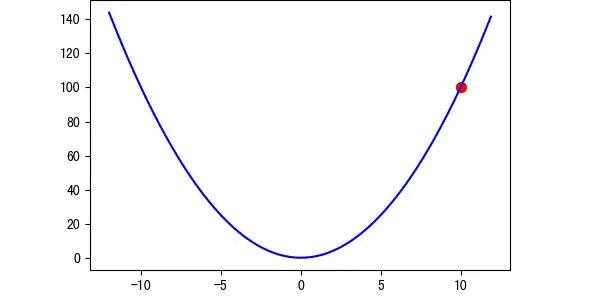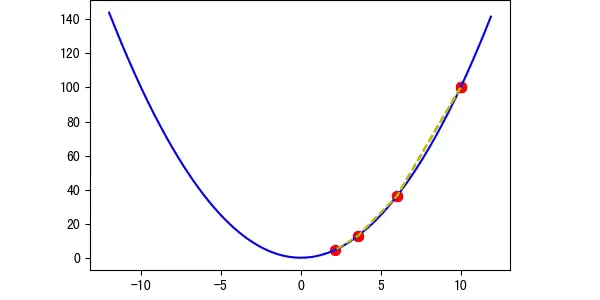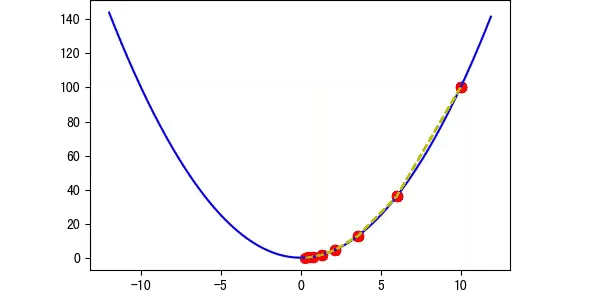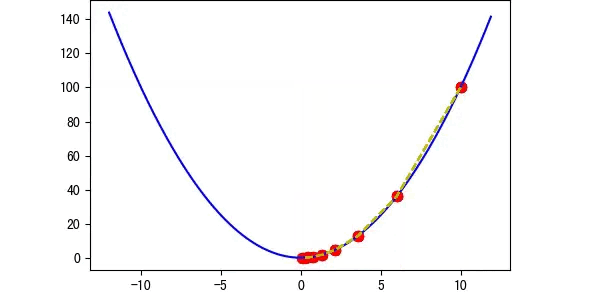
$$ x_1=10-0.2*20=6 $$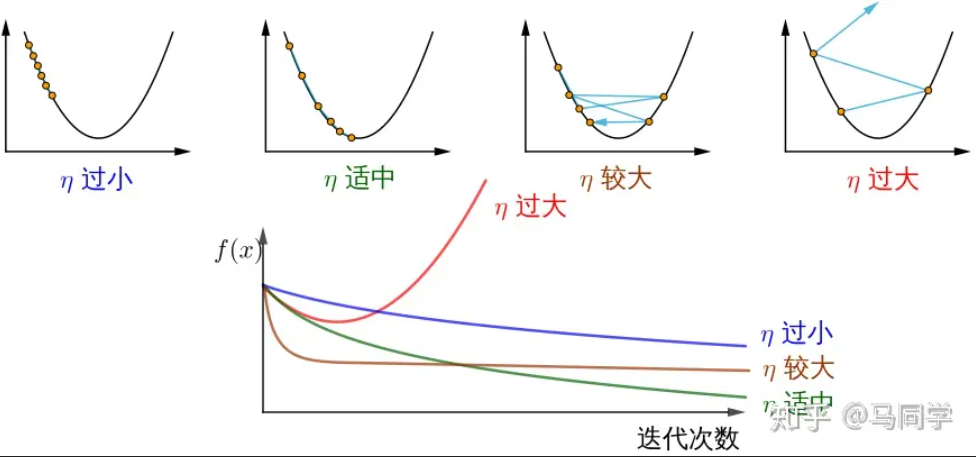
此时的采样点来到了 $x=6$ 的位置.
-
开始迭代
迭代方法同上
1.2. 三维函数梯度下降
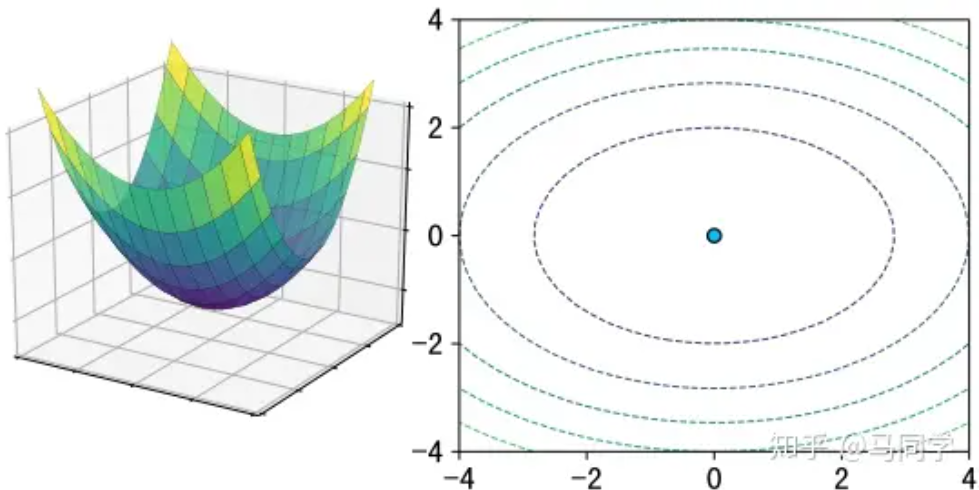
找到函数 $f(x)=x_a^2+2x_b^2$ 的最小值, 函数三维图和等高线如下.
-
设置初始点 $x_0=(-3.5,-3.5)$, 此时梯度为:
$$ \nabla f(x_0)=\left(\frac{\partial f\left(\boldsymbol{x}_0\right)}{\partial x_a}, \frac{\partial f\left(\boldsymbol{x}_0\right)}{\partial x_b}\right)=(-7,-14) $$ -
设置 $\gamma=0.1$, 可以计算出下一点 $x_1$ 的向量
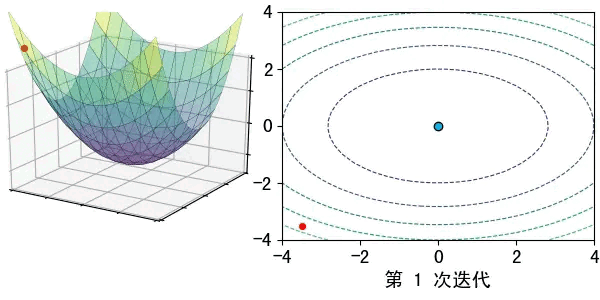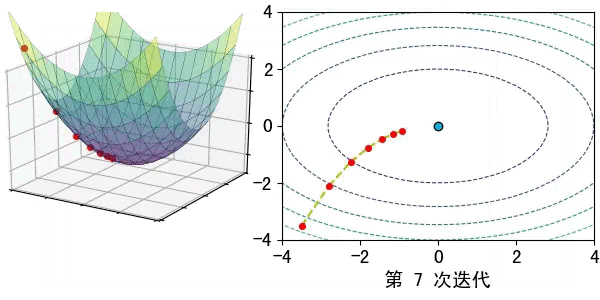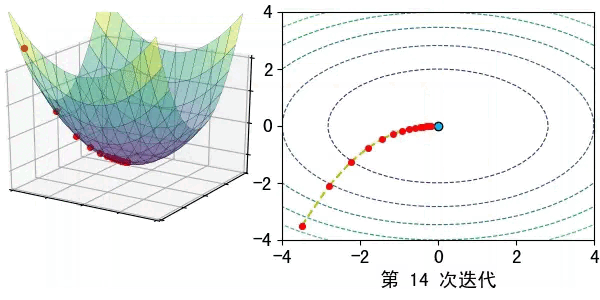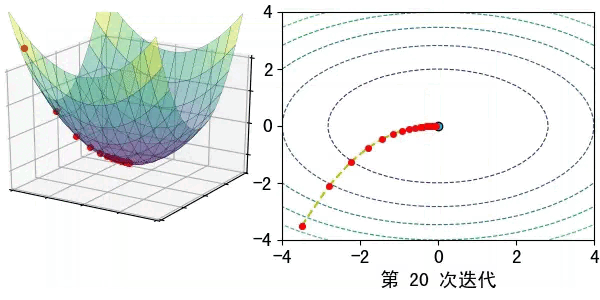
$$ x_1=x_0-\gamma \nabla f(x_0)=(-2.8,-2.1) $$ -
开始迭代
方法同上
1.3. 深度学习中的梯度下降
模型训练过程中, 需要计算的是损失函数的最小值
-
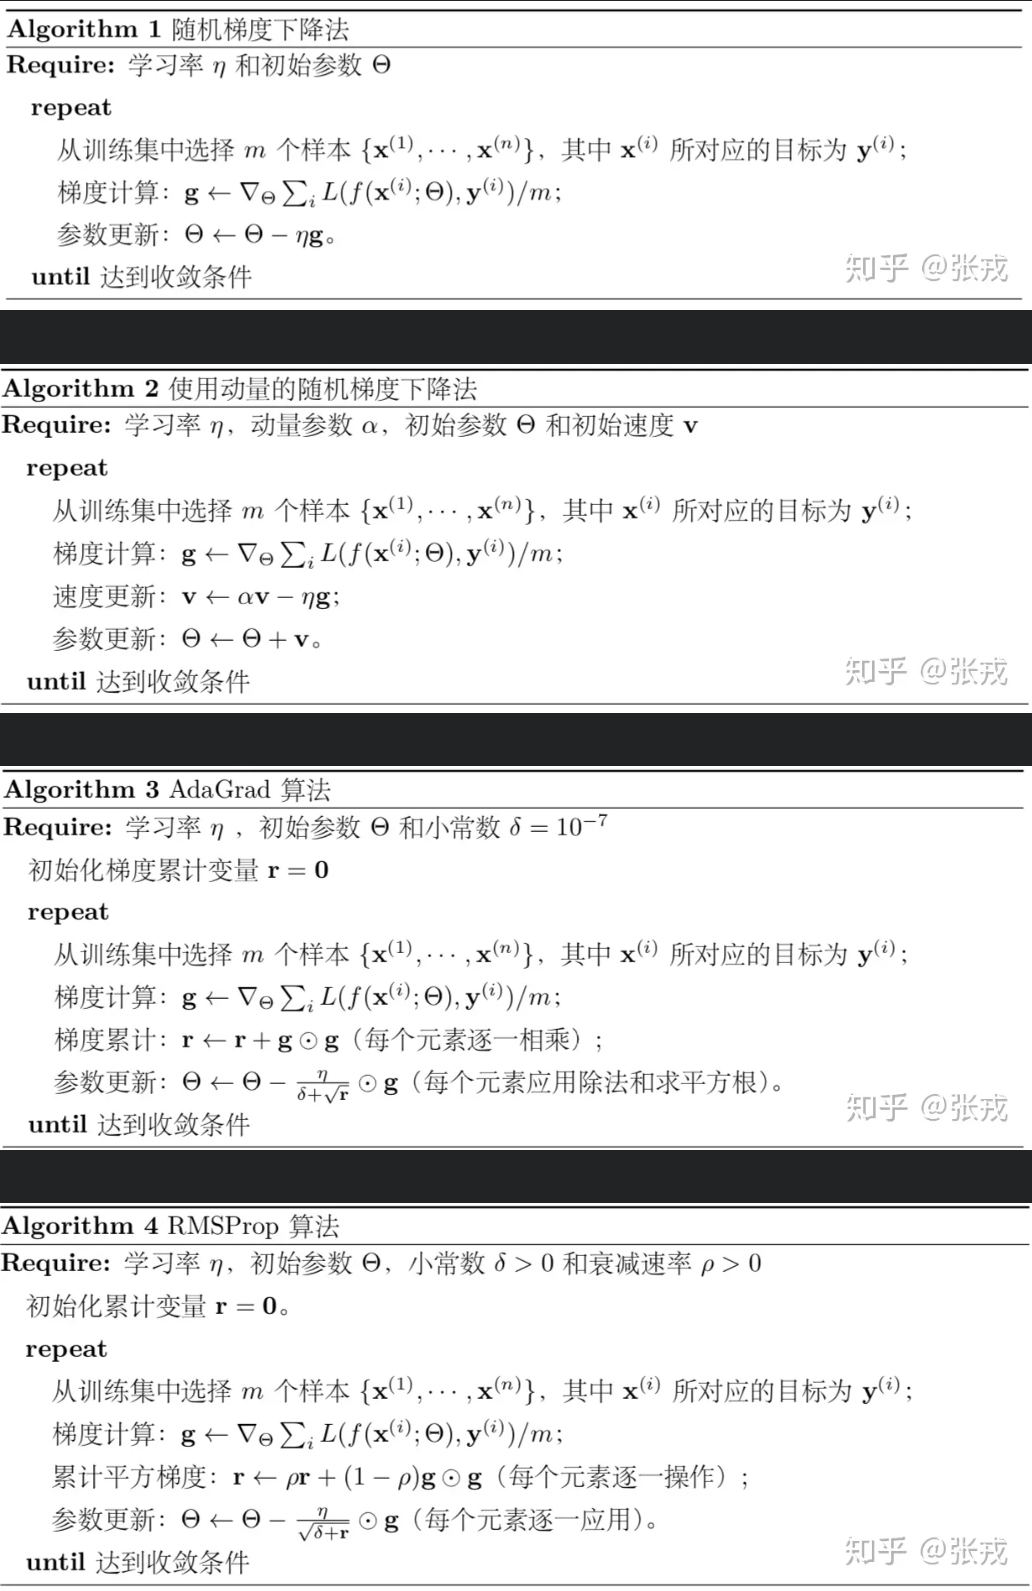
而在深度学习的优化算法中不同的梯度下降算法如下图所示
-
拿随机梯度下降算法举例, $L$ 是每个样本的损失函数, $f(x;\Theta)$ 表示一个输入为 $x$ 和 初始参数 $\Theta$ 的函数, $y$ 表示 GT 值.
其中的梯度计算是先计算样本数据的平均损失, 但是损失函数中有 $\Theta$ 作为优化参数, 也就是说函数变为了以 $\Theta$ 为未知数的函数, 对 $\Theta$ 求偏导, 之后带入 $\Theta_i$ 获得梯度参数 $g$.
之后更新 $\Theta_{i+1}=\Theta_i-\eta g$.