1. 梯度问题
-
梯度
梯度是一个向量, 表示某一函数在该点处的方向导数沿着该方向取得最大值.
即函数在该点处沿着该方向(此梯度的方向)变化最快, 变化率最大(为该梯度的模).
-
梯度下降
- 目的: 减小真实值(gt)和预测值的距离
- 批量梯度下降法(Batch Gradient Descent) batch_size=样本总数
- 小批量梯度下降法(Mini-Batch Gradient Descent) batch_size=x(16, 32, 64 …)
- 随机梯度下降(Stochastic Gradient Descent) batch_size=1
- 改进方法
-
Momentum (动量)
-
$v_t=\gamma v_{t-1}+\eta g_t$
-
$\theta_{t+1}=\theta_t-v_t$
$\gamma$: 阻力(衰减系数); $g_t$: 梯度; $v$: 前进步伐; $\eta$: 学习速率
-
-
Adam
-
惯性保持: 记录梯度的一阶矩
$m_t=\beta_1m_{t-1}+(1-\beta_1)g_t$
-
环境感知: 记录梯度的二阶矩
$v_t=\beta_2v_{t-1}+(1-\beta_2)g_t^2$
-
更新函数
$\theta_{t+1}=\theta_t-\frac{\eta\cdot \hat{m_t}}{\sqrt{\hat{v_t}+\epsilon}}$
$\hat{m_t}=\frac{m_t}{1-\beta_1^t}$; $\hat{v_t}=\frac{v_t}{1-\beta_2^t}$
-
-
AdaDelta和RMSProp
- 对AdaGrad的改进
- AdaGrad使用所有历史梯度的平方和的平方根做分母, 所以分母随时间单调递增.
- 这两个
采用指数衰退计算平均值的方法,用历史梯度的均值代替求和.
-
2. 神经网络 正向传播和反向传播
-
正反向传播举例推导图
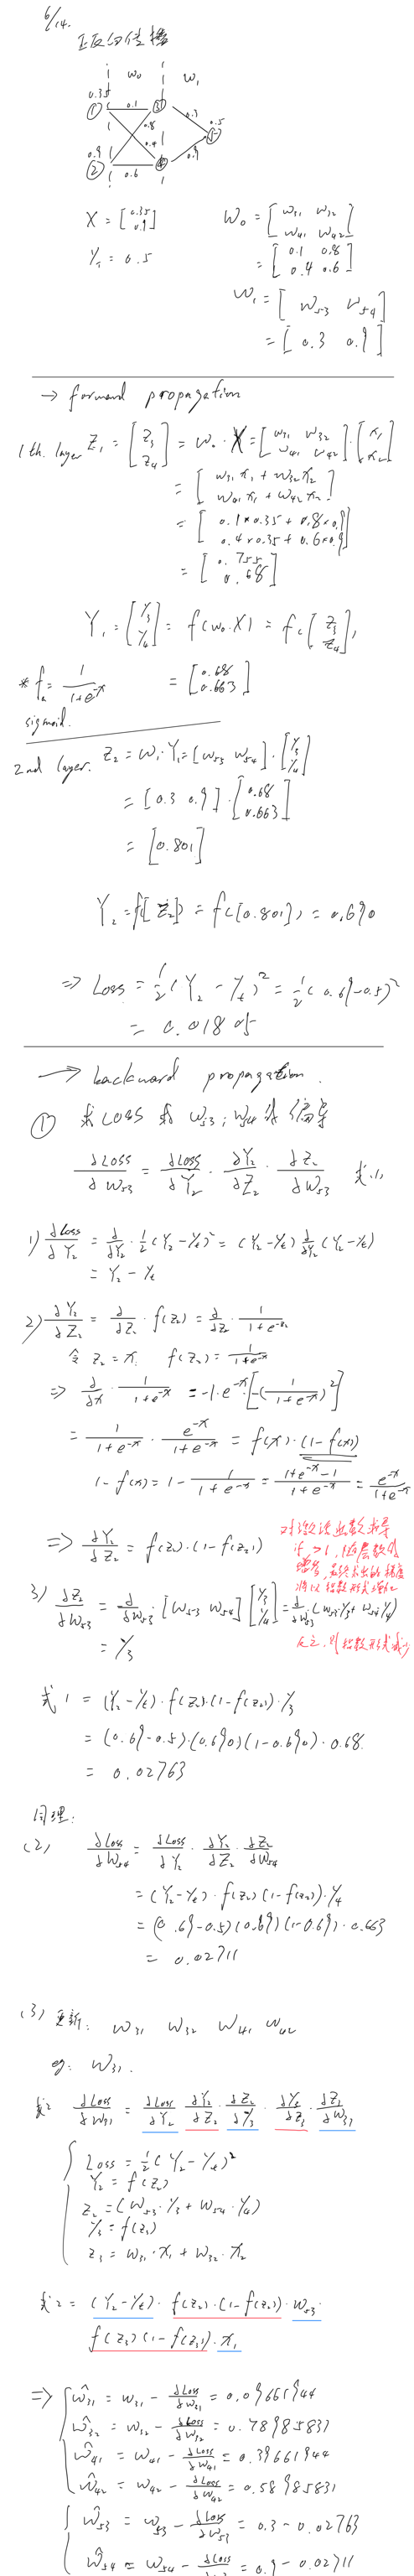
3. 梯度爆炸和梯度消失问题
$f_{i+1}=f\left(f_{i} * w_{i+1}+b_{i+1}\right)$
-
BP(反向传播算法)就是基于梯度下降策略,以目标的负梯度方向对参数进行调整,参数的更新为:
$w=w+\Delta w$,
学习率$\alpha$, 得出:
$\Delta w = -\alpha\frac{\partial Loss}{w}$,
如果更新第二层隐层的w的信息, 根据链式求导:
$\Delta w_{1}=\frac{\partial L o s s}{\partial w_{2}}=\frac{\partial L o s s}{\partial f_{4}} \cdot \frac{\partial f_{4}}{\partial f_{3}} \cdot \frac{\partial f_{3}}{\partial f_{2}} \cdot \frac{\partial f_{2}}{\partial w_{2}}$
-
$\frac{\partial f_{4}}{\partial f_{3}}$就是对激活函数进行求导
-
如果此部分大于1,那么层数增多,最终的求出的梯度更新将以指数形式增加,即发生梯度爆炸
-
如果此部分小于1,那么层数增多,梯度更新信息将会以指数形式衰减,即发生了梯度消失
-
如何解决
-
预训练加微调
-
提出采取无监督逐层训练方法.
每次训练一层隐节点,训练时将上一层隐节点的输出作为输入,而本层隐节点的输出作为下一层隐节点的输入,此过程是逐层“预训练”(pre-training)
在预训练完成后,再对整个网络进行“微调”(fine-tunning)
-
此思想相当于是先寻找局部最优,然后整合起来寻找全局最优,此方法有一定的好处,但是目前应用的不是很多了。
-
-
梯度剪切, 正则化
-
梯度剪切这个方案主要是针对梯度爆炸提出的
-
其思想是设置一个梯度剪切阈值,然后更新梯度的时候,如果梯度超过这个阈值,那么就将其强制限制在这个范围之内。这可以防止梯度爆炸。梯度是$\Delta W$.
-
另外一种解决梯度爆炸的手段是采用权重正则化 (weithts regularization), 通过对网络权重做正则限制过拟合。
$\text { Loss }=\left(y-W^{T} x\right)^{2}+\alpha\|W\|^{2}$
$\alpha$: 正则项系数. 如果梯度爆炸造成$||W||^2$很大, 用$\alpha$来调节, 部分限制梯度爆炸的发生.
-
比较常见的是l1正则,和l2正则.
$l_{1}: \Omega(w)=\|w\|_{1}=\sum_{i}\left|w_{i}\right|$
$l_{2}: \Omega(w)=\|w\|_{2}^{2}=\sum_{i} w_{i}^{2}$
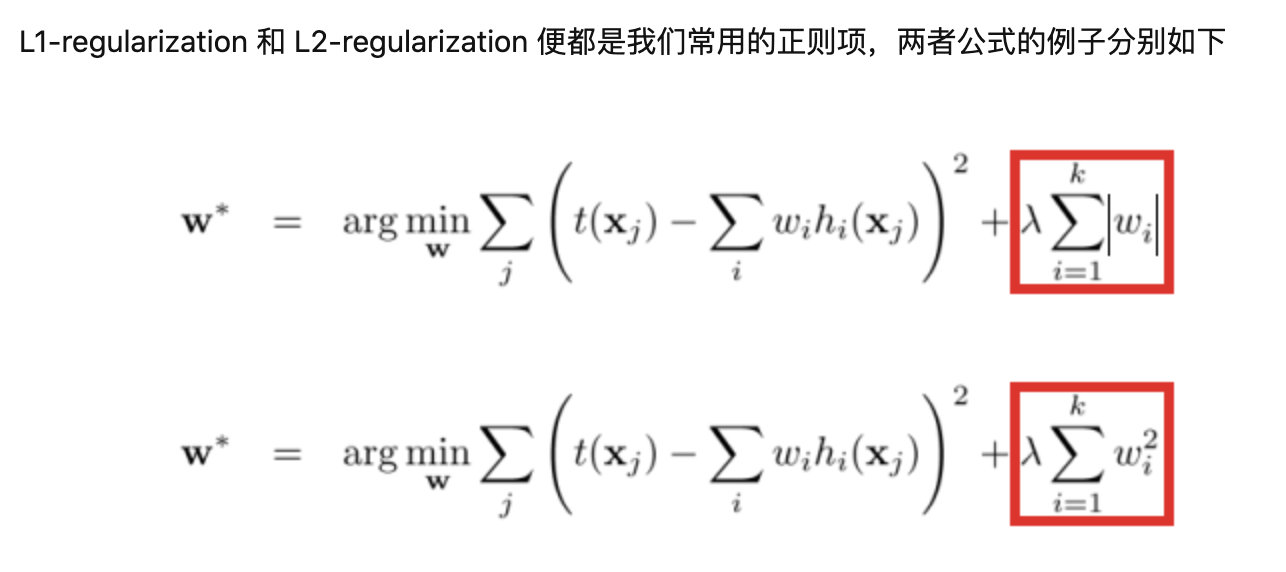
L2计算方便(求导直接就是2$w$, 而L1导数是一个常数), 对大数的惩罚更大, 防止过拟合
-
Tensorflow 搭建网络的时候已经设置了正则化参数,则调用以下代码可以直接计算出正则损失
regularization_loss = tf.add_n(tf.losses.get_regularization_losses(scope='my_resnet_50')) -
如果没有设置初始化参数,也可以使用以下代码计算$l_2$正则损失
l2_loss = tf.add_n([tf.nn.l2_loss(var) for var in tf.trainable_variables() if 'weights' in var.name])
-
-
-
Batch Normalization
-
Batchnorm本质上是解决反向传播过程中的梯度问题
-
因为深层神经网络在做非线性变换前的激活输入值(就是那个x=WU+B,U是输入)随着网络深度加深或者在训练过程中,其分布逐渐发生偏移或者变动,之所以训练收敛慢,一般是整体分布逐渐往非线性函数的取值区间的上下限两端靠近(对于Sigmoid函数来说,意味着激活输入值WU+B是大的负值或正值),所以这导致反向传播时低层神经网络的梯度消失,这是训练深层神经网络收敛越来越慢的本质原因,而BN就是通过一定的规范化手段,把每层神经网络任意神经元这个输入值的分布强行拉回到均值为0方差为1的标准正态分布,其实就是把越来越偏的分布强制拉回比较标准的分布,这样使得激活输入值落在非线性函数对输入比较敏感的区域,这样输入的小变化就会导致损失函数较大的变化,意思是这样让梯度变大,避免梯度消失问题产生,而且梯度变大意味着学习收敛速度快,能大大加快训练速度.
-
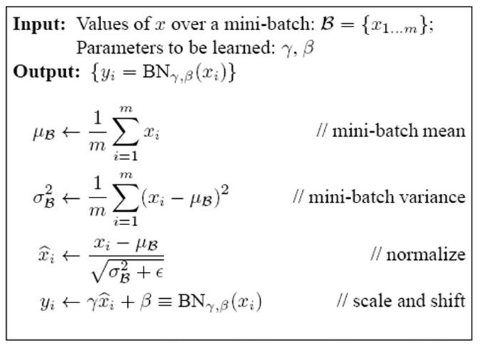
批规范化,通过规范化操作将每一层的输出信号x规范化到均值为0,方差为1保证网络的稳定性.
-
加速收敛
-
控制过拟合,可以少用或不用Dropout和正则 降低网络对初始化权重敏感
-
允许使用较大的学习率
-
举个简单例子: 正向传播中 $f_{3}=f_{2}\left(w^{T} * x+b\right)$,那么反向传播中, $\frac{\partial f_{2}}{\partial x}=\frac{\partial f_{2}}{\partial f_{1}} w$ 中有w的存在,所以$w$的大小影响了梯度的消失和爆炸,batchnorm就是通过对每一层的输出做scale和shift的方法,通过一定的规范化手段,把每层神经网络任意神经元这个输入值的分布强行拉回到接近均值为0方差为1的标准正太分布,即严重偏离的分布强制拉回比较标准的分布,这样使得激活输入值落在非线性函数对输入比较敏感的区域,这样输入的小变化就会导致损失函数较大的变化,使得让梯度变大,避免梯度消失问题产生,而且梯度变大意味着学习收敛速度快,能大大加快训练速度。
-
-
残差结构
-
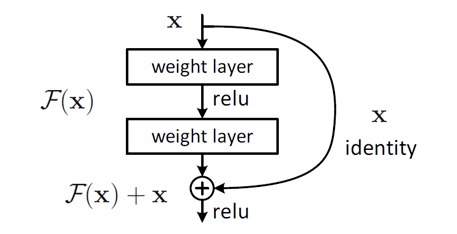
解决了梯度消失过快的问题. 因为残差的捷径(shortcut)部分的残差单元:
-
深度残差网络 (Deep residual network, ResNet)
-
深度网络的退化问题
-
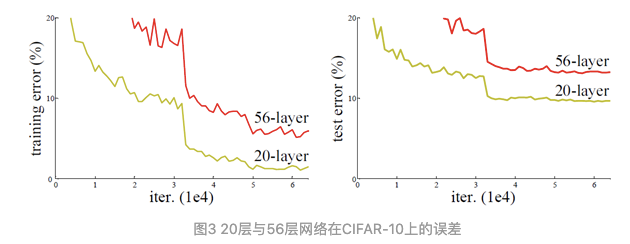
增加网络的深度可以使网络进行更加复杂的特征模式的提取, 可是加深网络层数会出现退化问题(Degradation problem).
-
极端情况: 这些增加的层什么也不学习,仅仅复制浅层网络的特征,即这样新层是恒等映射 (Identity mapping)
-
-
残差学习
-
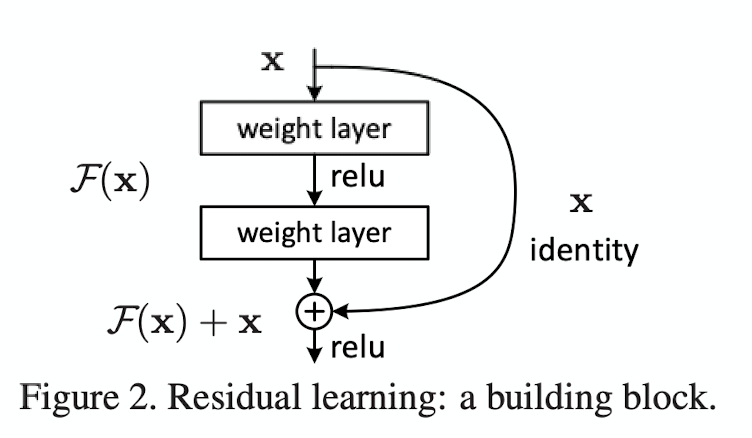
对于一个堆积层结构(几层堆积而成)当输入为 $x$ 时其学习到的特征记为 $H(x)$ ,现在我们希望其可以学习到残差 $F(x)=H(x)-x$,这样其实原始的学习特征是 $F(x)+x$ 。
-
之所以这样是因为残差学习相比原始特征直接学习更容易。当残差为0时,此时堆积层仅仅做了恒等映射,至少网络性能不会下降,实际上残差不会为0,这也会使得堆积层在输入特征基础上学习到新的特征,从而拥有更好的性能。
-
从数学的角度来分析, 残差单元可以表示为:
$y_l=h(x_l)+F(x_l,W_l)$
$x_{l+1}=f(y_l)$
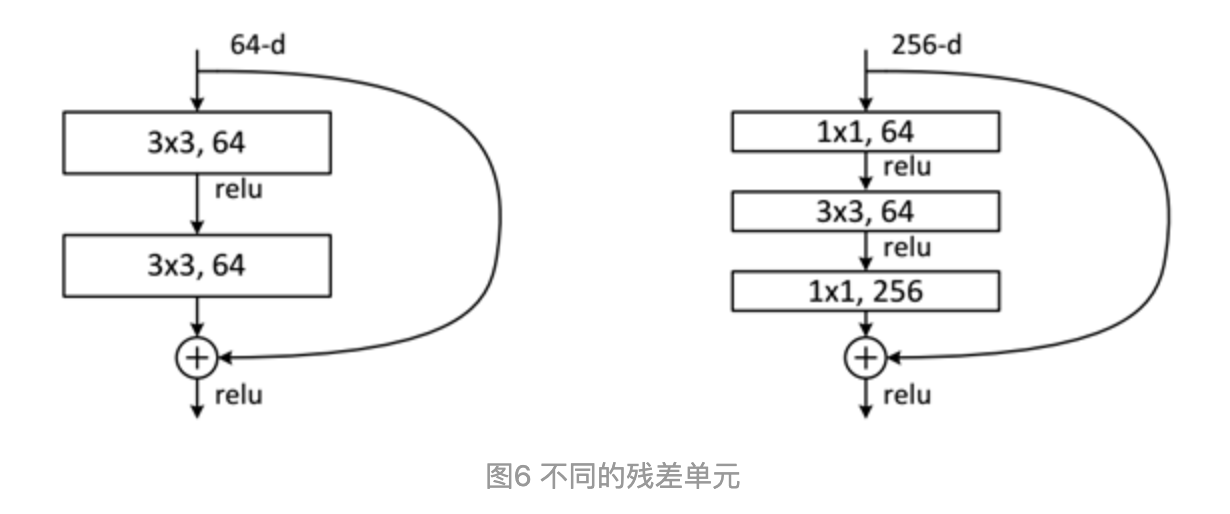
- $x_l$ 和 $x_{l+1}$ 分别表示的是第 $l$ 个残差单元的输入和输出(每个残差单元一般包含多层结构如图6).
- $F$是残差函数, 表示学习到的残差.
- $h(x_l)=x_l$表示恒等映射.
- $f$表示ReLU激活函数.
-
正向传播, 学习特征为:
$x_{L}=x_{l}+\sum_{i=l}^{L-1} F\left(x_{i}, W_{i}\right)$
-
反向过程的梯度:
$\frac{\partial \text { Loss }}{\partial x_{l}}=\frac{\partial Loss}{\partial x_{L}} \cdot \frac{\partial x_{L}}{\partial x_{l}}=\frac{\partial \operatorname{Loss}}{\partial x_{L}} \cdot\left(1+\frac{\partial}{\partial x_{l}} \sum_{i=l}^{L-1} F\left(x_{i}, W_{i}\right)\right)$
- 式子的第一个因子$\frac{\partial \text { loss }}{\partial x_{L}}$表示损失函数$Loss$到达$L$的梯度.
- 小括号中的1就是短路机制 (shortcut connection) 可以无损地传播梯度.
- 另外一项残差梯度则需要经过带有weights的层.
- 残差梯度不会那么巧全为-1, 而且有1所以不会梯度消失, 所以残差学习会更容易.
-
-
-
-
4. 梯度下降和梯度上升
- 都利用了BP算法
- 梯度下降
- 模型以参数化形式表示, 所以模型的更新等价于参数的更新
- 梯度上升
- 模型直接定义在函数空间中, 这就扩大了可以使用的模型种类
5. 神经网络参数初始化
-
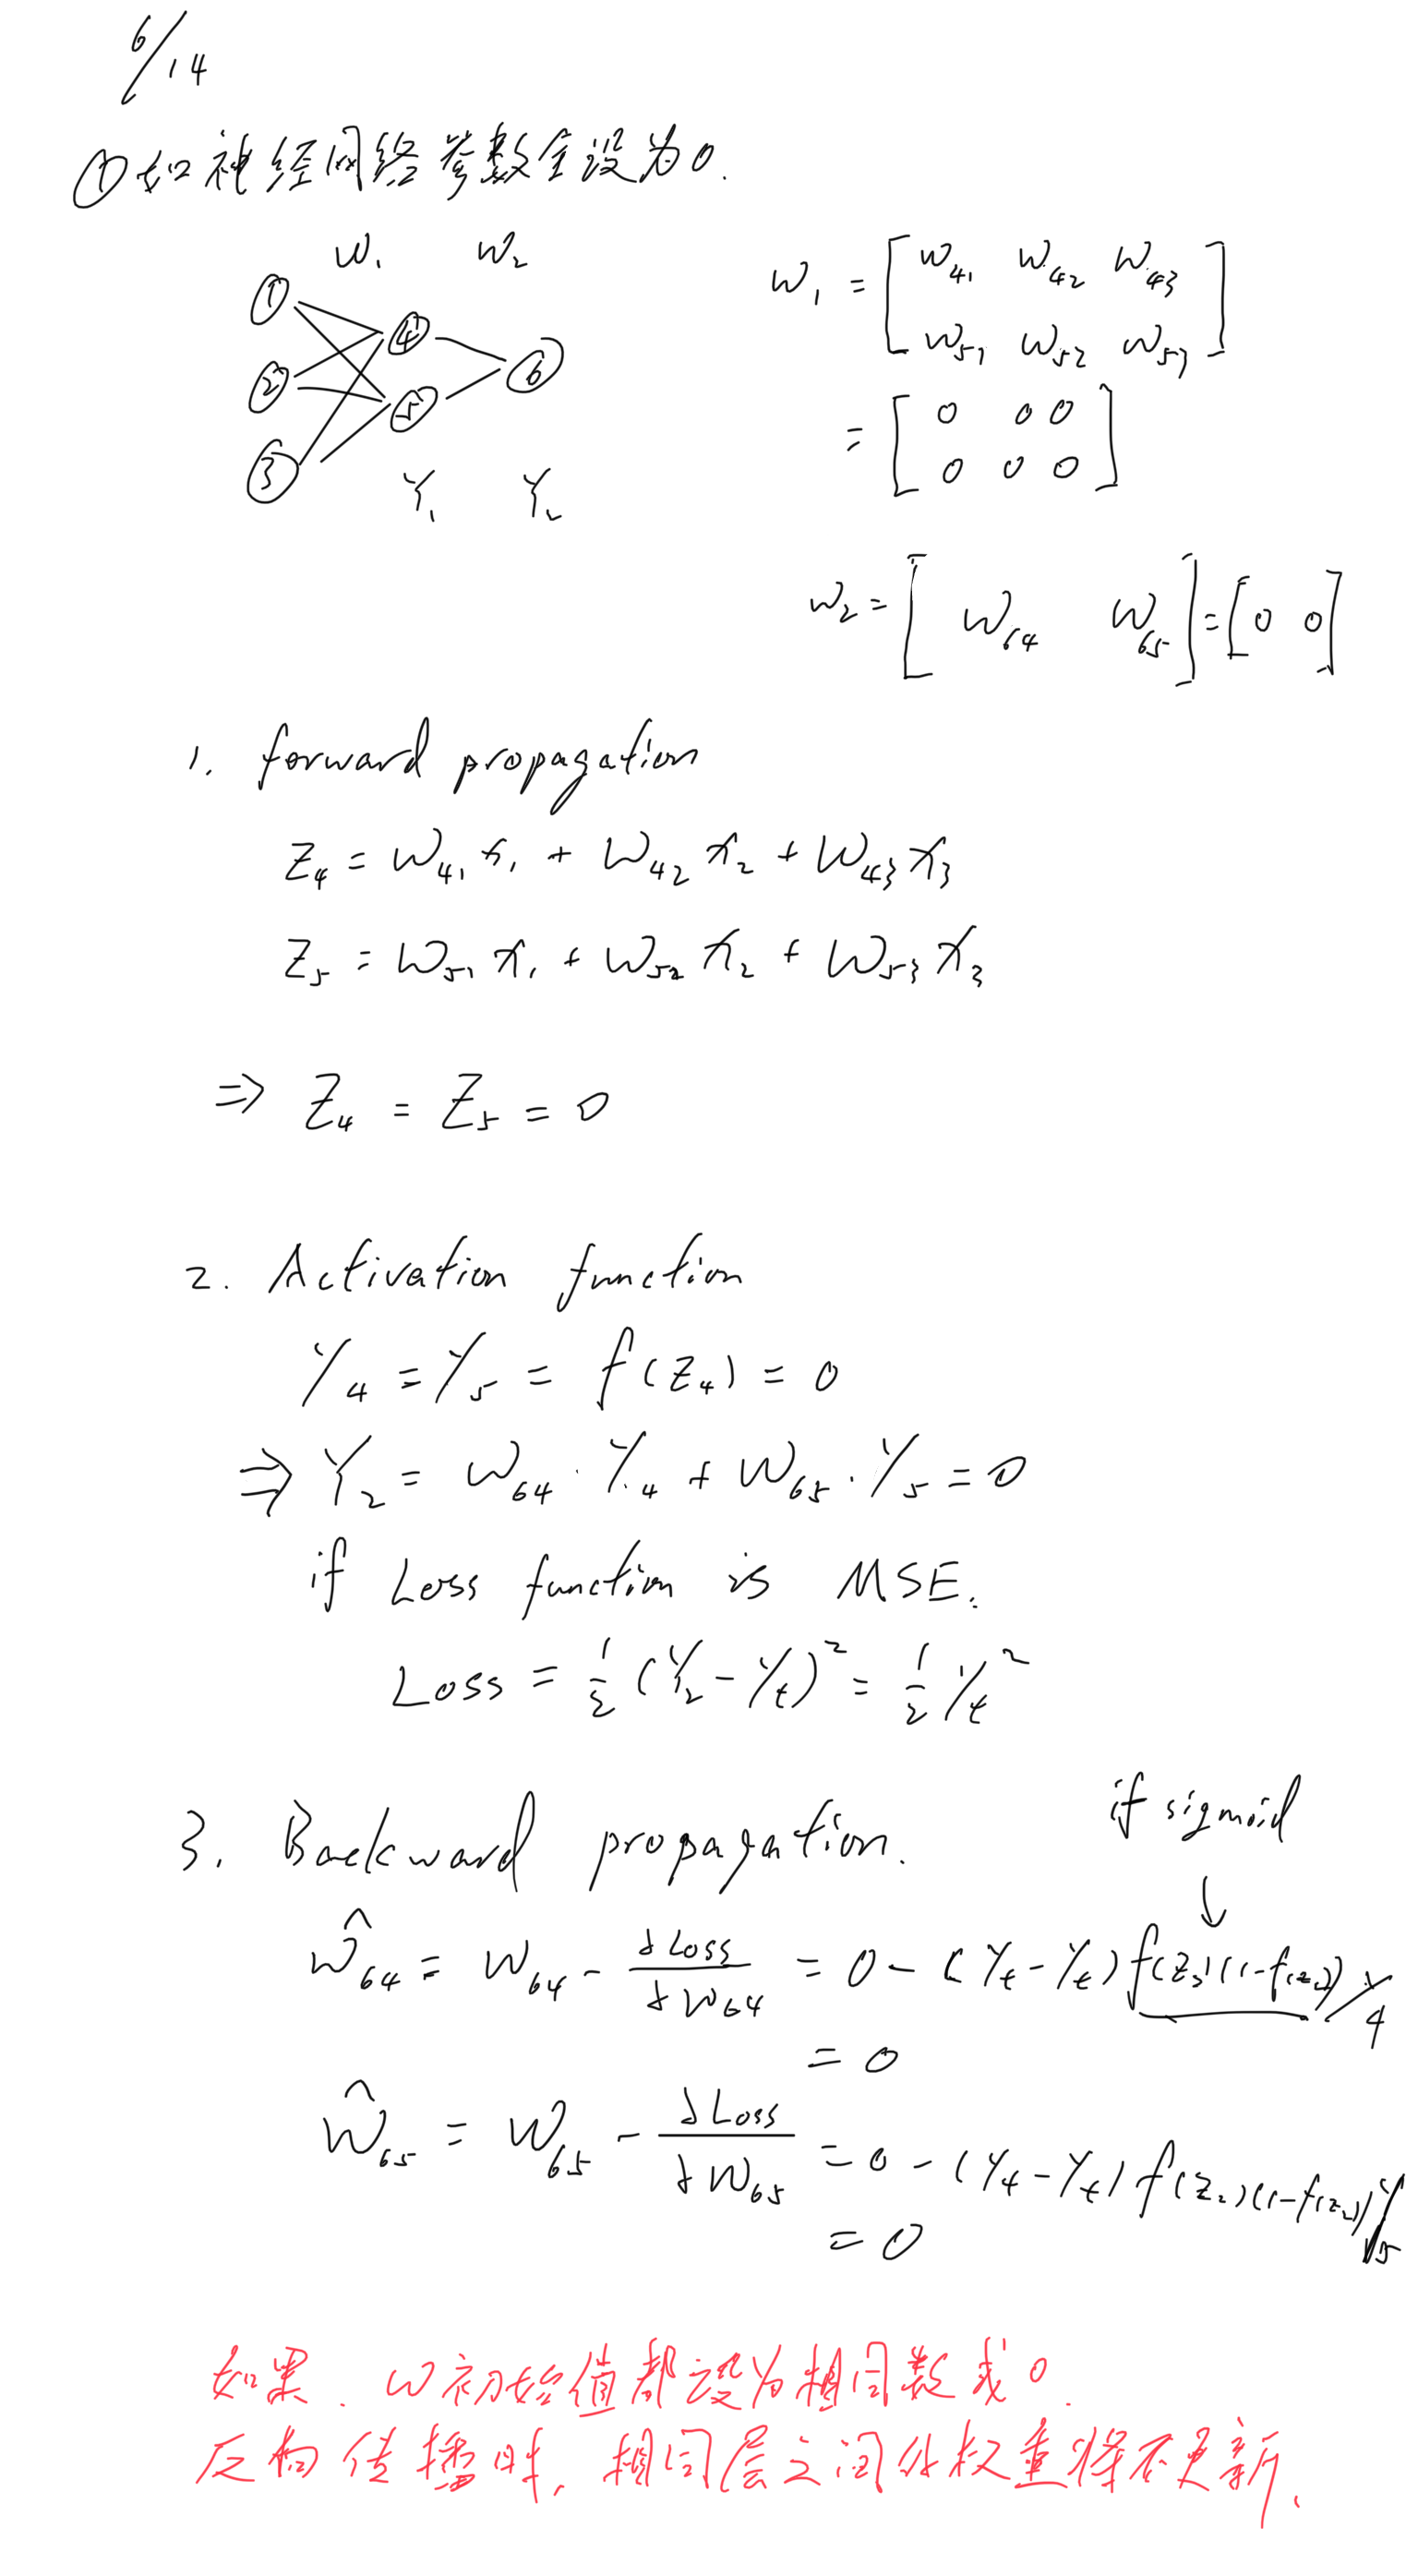
为什么神经网络参数不能全部初始化为全0?
-
第301页,深度学习,2016年(英文版)
也许唯一已知完全确定的属性是初始参数需要在不同单元之间“打破对称性”。如果具有相同激活函数的两个隐藏单元连接到相同的输入,则这些单元必须具有不同的初始参数。如果它们具有相同的初始参数,那么应用于确定性成本和模型的确定性学习算法将以相同的方式不断更新这两个单元。
-
6. 层数和神经元数量
如何确定神经网络的层数和隐藏层神经元数量?
-
隐藏层的层数
-
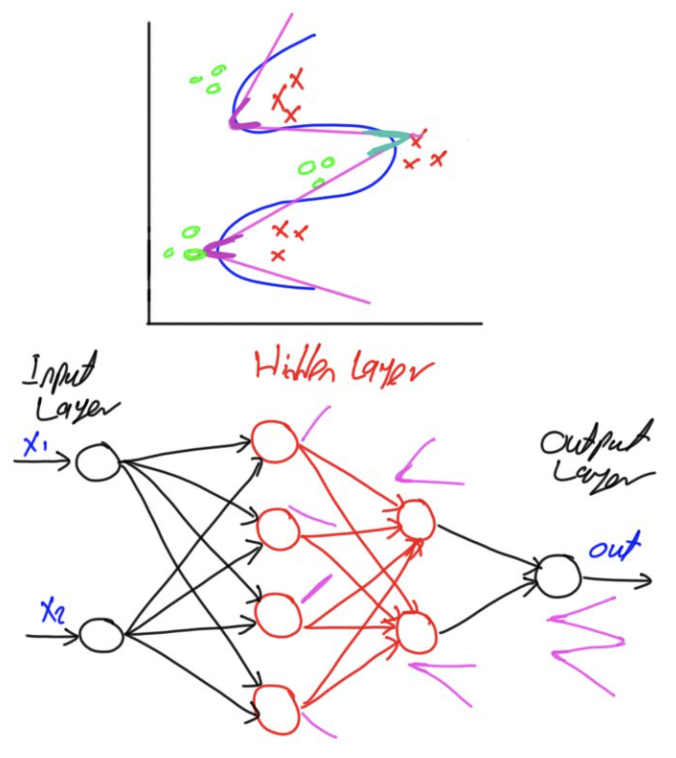
在神经网络中, 当且仅当数据非线性分离时才需要隐藏层.
- 对于简单的数据集, 一两层隐藏层通常就够了
- 对于设计时间序列或计算机视觉的复杂数据集, 需要额外增加层数.
- 二分类问题(如两个类可以用一条直线分开(先行分离函数))只需要使用单层神经网络就行.
-
没有隐藏层:仅能够表示线性可分函数或决策
-
隐藏层数=1:可以拟合任何“包含从一个有限空间到另一个有限空间的连续映射”的函数
-
隐藏层数=2:搭配适当的激活函数可以表示任意精度的任意决策边界,并且可以拟合任何精度的任何平滑映射
-
隐藏层数>2:多出来的隐藏层可以学习复杂的描述(某种自动特征工程)
-
层数越深,理论上拟合函数的能力增强,效果按理说会更好,但是实际上更深的层数可能会带来过拟合的问题,同时也会增加训练难度,使模型难以收敛
-
-
隐藏层中的神经元数量
-
在隐藏层中使用太少的神经元将导致:
- 欠拟合(underfitting)
-
隐藏层中的神经元过多(过多的信息处理能力)可能会导致:
- 训练集中包含的有限信息量不足以训练隐藏层中的所有神经元 → 过拟合(overfitting)
- 即使训练数据包含的信息量足够,隐藏层中过多的神经元会增加训练时间.
-
对所有隐藏层使用相同数量的神经元就足够了.
-
对于某些数据集,拥有较大的第一层并在其后跟随较小的层将导致更好的性能,因为第一层可以学习很多低阶的特征,这些较低层的特征可以馈入后续层中,提取出较高阶特征.
-
与在每一层中添加更多的神经元相比,添加层层数将获得更大的性能提升. 因此,不要在一个隐藏层中加入过多的神经元.
-
经验之谈:
$N_{h}=\frac{N_{s}}{\left(\alpha *\left(N_{i}+N_{o}\right)\right)}$
- $N_i$ 是输入层神经元个数; $N_o$ 是输出层神经元个数; $N_s$ 是训练集的样本数; $\alpha$ 是可以自取的任意值变量,通常范围可取 2-10.
-
经验之谈2:
- 隐藏神经元的数量应在输入层的大小和输出层的大小之间.
- 隐藏神经元的数量应为输入层大小的2/3加上输出层大小的2/3.
- 隐藏神经元的数量应小于输入层大小的两倍.
-
如果过拟合的话,采用early-stopping, Batch Normalization, Dropout, 添加正则化项的方式。
-