1. 文本检测难点
- 文本的多样性: 颜色, 大小, 字体, 形状, 方向, 语言, 文本长度…
- 复杂的背景干扰: 图像失真, 模糊, 低分辨率, 阴影, 亮度…
- 密集文本或重叠文本
- 文字存在局部一致性: 文本行的一部分也可以是为独立的文本
2. 场景文本检测方法分类
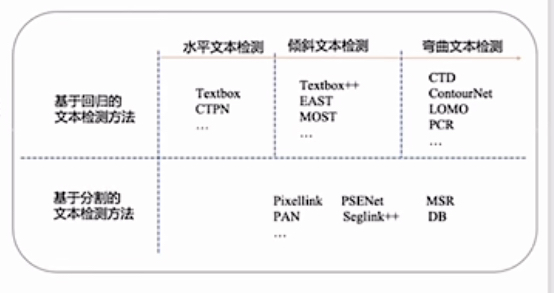
- 基于回归的方法(regression-based methods) 基于回归的方法是一系列直接回归文本实例的边界框的模型.
- 论文
- TextBoxes (Liao et al. 2017) 基于 SSD (Liu et al. 2016) 修改了锚点和卷积核的尺度来进行文本检测。
- TextBoxes++(Liao, Shi, and Bai 2018)和 DMPNet(Liu and Jin 2017)应用四边形回归来检测多方向文本。
- SSTD(He et al. 2017a)提出了一种注意力机制来粗略地识别文本区域。
- RRD(Liao et al. 2018)通过使用旋转不变特征进行分类和使用旋转敏感特征进行回归来解耦分类和回归,以更好地处理多向和长文本实例。
- EAST(Zhou et al. 2017)和 DeepReg(He et al. 2017b)是无锚方法, 它们对多方向文本实例应用像素级回归。
- SegLink(Shi, Bai, and Belongie 2017)对片段边界框进行回归并预测它们的链接,以处理长文本实例。
- DeRPN(Xie et al. 2019b)提出了一种维度分解区域提议网络来处理场景文本检测中的尺度问题。基于回归的方法通常采用简单的后处理算法(例如非极大值抑制).
- 论文中的大多数在表示不规则图形(如曲线图形)的精确边界框时都受到了限制.
- 论文
- 基于分割的方法(segmentation-based methods) 通常结合像素级预测和后处理算法来获取边界框.
- 论文
- (Zhang et al. 2016) 通过语义分割和基于 MSER 的算法检测多向文本.
- (Xue, Lu, and Zhan 2018) 使用文本边框来分割文本实例.
- Mask TextSpotter (Lyu et al. 2018a; Liao et al. 2019) 基于 Mask R-CNN 以实例分割方式检测任意形状的文本实例.
- PSENet(Wang et al. 2019a)提出了通过使用不同尺度内核分割文本实例来进行渐进尺度扩展.
- (Tian et al. 2019) 中提出了像素嵌入, 以对分割结果中的像素进行聚类.
- PSENet (Wang et al. 2019a) 和 SAE (Tian et al. 2019) 针对分割结果提出了新的后处理算法, 导致推理速度较低.
- 基于分割的方法有一些通病: 消耗性能更高(DBNet做到了优化), 一些文本在另一次文本中间的时候, 几乎所有分割方法都是无法区分的.
- 论文
- 快速场景文本检测方法(Fast scene text detection methods) 注重准确性和推理速度.
- TextBoxes (Liao et al. 2017)、TextBoxes++ (Liao, Shi, and Bai 2018)、SegLink (Shi, Bai, and Belongie 2017) 和 RRD (Liao et al. 2018) 通过使用SSD(Liu et al. 2016)检测架构实现了快速文本检测.
- EAST(Zhou et al. 2017)提出应用PVANet(Kim et al. 2016)来提高其速度。它们中的大多数不能处理不规则形状的文本实例,例如弯曲形状.
- 与之前的快速场景文本检测器相比,DBNet方法不仅运行速度更快,而且可以检测任意形状的文本实例.
- DBNet 是一种基于分割的方法, 分割的方法通常需要进行二值化, 而二值化是不可微分的. 不可微分就意味着不可以在网络中联合训练.
- DBNet 使用 DB (Differentiable Binarization) module.
- 这个方法替代标准的二值化函数, 可以自适应的学习每个像素点的二值化阈值.
- 使得二值化也加入网络一起训练, 来简化后处理的过程和提升模型推理性能.
3. DBNet模型
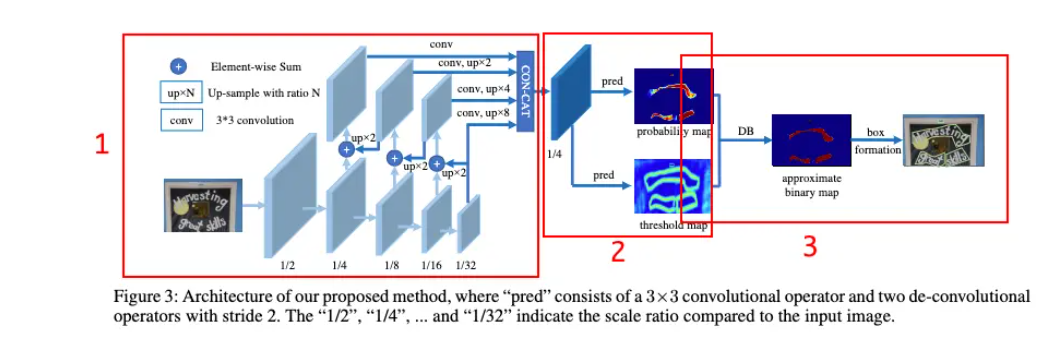
3.1. Backbone 骨干网络
模型的骨干网络使用FPN(CVPR2017), 也可以使用ResNet.
- FPN (Feature Pyramid Network): 在目标检测中融入了特征金字塔, 提高了目标检测的准确率, 尤其体现在小物体的检测上.
-
特征金字塔特性:
- 高层 (顶部 远离原图) 特征包含丰富的语义信息, 但是由于分辨率低, 很难保存准确的物体位置信息.
- 低层 (底部 接近原图) 特征语义信息少, 但是由于分辨率高, 能够保存准确的物体位置信息.
-
动机:
- 由于特征金字塔的特性, 将低层和高层特征融合, 就能得到一个识别和定位都准确的目标检测系统.
- 之前的多尺度融合方法一般都是将特征融合之后再做预测, 而FPN对不同的特征层都单独做了预测, 从而提高了准确率和性能.
-
结构:
-
目标检测算法中的常见结构介绍
获取特征的时候, 不同的卷积核(Kernel)获得的特征图(Feature Map)都不一样.
不同的卷积核的合集叫过滤器(Filter).
-
-
DBNet中的FPN网络中加入了可变形卷积(Deformable convolution)
Deformable Convolution 关于可变形卷积
-
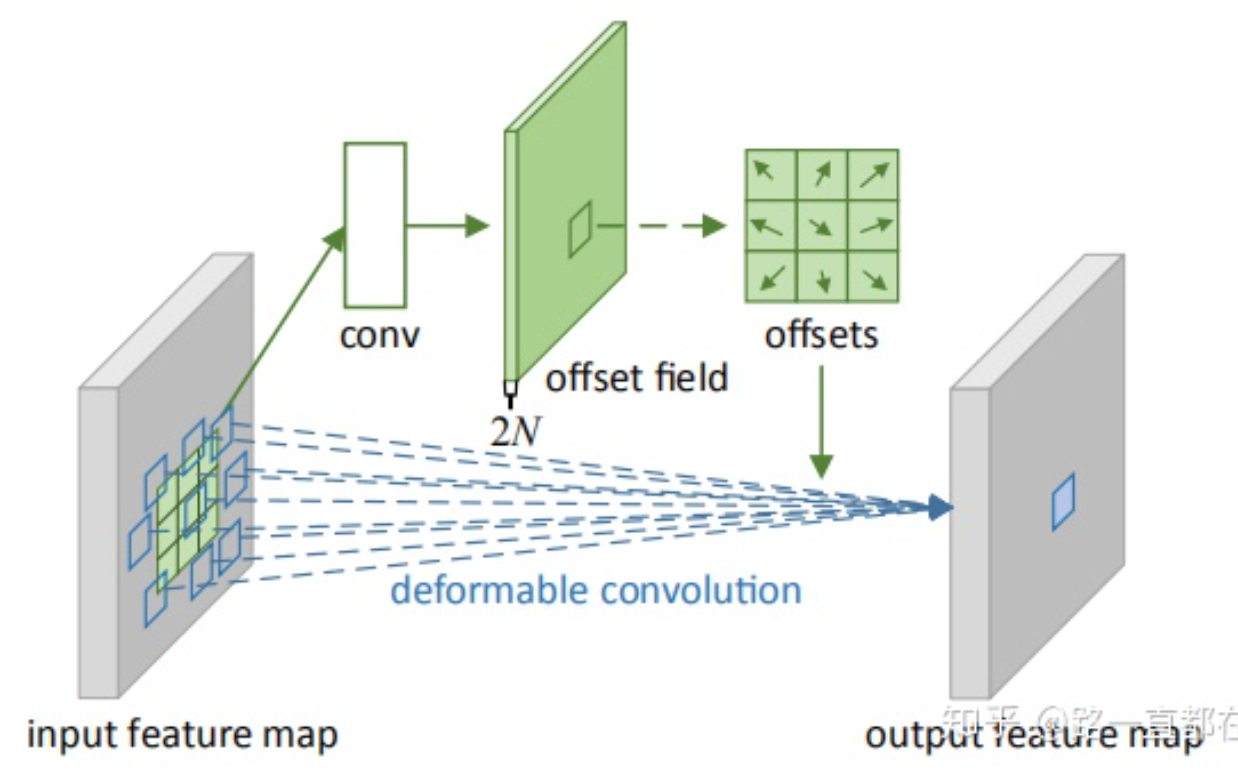
原始feature map上的每个像素点学习的不是自身的偏移, 而是以自身为中心, 周围k*k大小所有点的偏移. 这样加完 offset 再卷积的时候, 卷积核的中心滑动到某点时, 并不是和这个点周围的9个点进行卷积, 而是和这个点的18个通道对应的9个offset算出来的值进行卷积.
-
可以为模型提供灵活的感受野, 有利于长文本检测
-
可变形卷积被应用于ResNet-18和ResNet-50
-
可变形卷积的优势?
- 传统卷积的限制: 卷积核形状和位置固定, 所以在卷积过程中, 每个卷积核的每个位置上采样的是相同的输入数据, 而无法适应不同尺度或形变的结构.
- 可变形卷积: 在卷积过程中, 可以动态调整形状和位置.
-
可变形卷积详细介绍
-
-
3.2. Binarization Module 二值化模块
将1/4大小的特征图分别经过一系列的卷积和转置卷积获得概率图(Probability map, 分割图) P和阈值图(Threshold map) T, 目的是生成和原图一样大小的特征图 P 和 T.
-
概率图(Probability map, 分割图) P的获取方法
- 尽量完全在gt文字框内部
- 对于特征获得的分割结果做了腐蚀操作?
- 腐蚀后文本区域每个像素都为1, 外部区域都为0
-
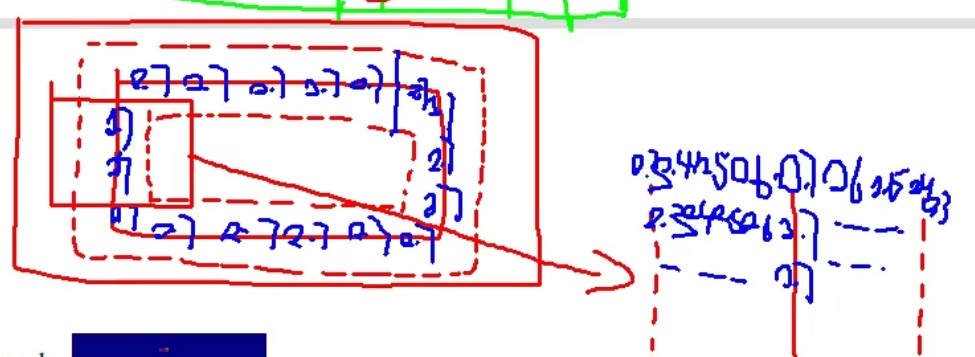
阈值图(Threshold map) T的获取方法
-
让模型理解文字的边缘
-
对于特征获得的分割结果各做了腐蚀和膨胀操作, 缩小和增大的距离相同
-
分割边缘阈值越大, 向周围扩散时阈值变小范围在 $(0, 1)$ 之间, 但取不到0和1.
-
-
所以, 之后P-T的时候内部的文字部分一定大于0, 外部区域一定小于0
-
之后的后处理会将结果再次扩大回原来的大小. 阈值图只在训练的时候有用.
-
这么做的好处
- 传统的二值化模块不能随着分割网络的训练进行更新, BD二值化模块可以.
- 类似于腐蚀膨胀操作, 可以防止两个单词被框到一起.
3.3. Post-processing 后处理
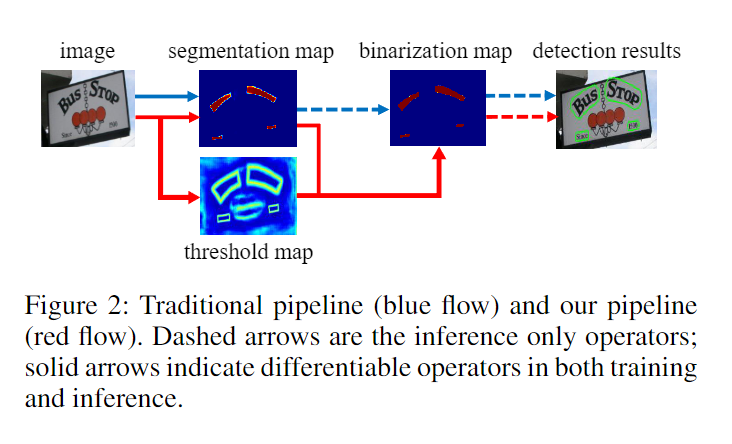
使用DB模块将 P 和 T 合并为近似二值图, 后处理获得文本的检测框
-
传统管线 (Standard binarization): 图片进行分割获得 segmentation map → 设定固定的阈值获得 binarization map → 得到结果
-
普通二值化方法公式:
$$ B_{i, j}= \begin{cases}1 & \text { if } P_{i, j}>=t \\ 0 & \text { otherwise }\end{cases} $$
-
-
BD module (Differentiable binarization): 使用threshold map获得在每个像素点上自适应的阈值
-
DB公式:
$$ \hat{B}_{i, j}=\cfrac{1}{1+e^{-k\left(P_{i, j}-T_{i, j}\right)}} $$k: 放大系数; P: 概率图; T: 阈值图
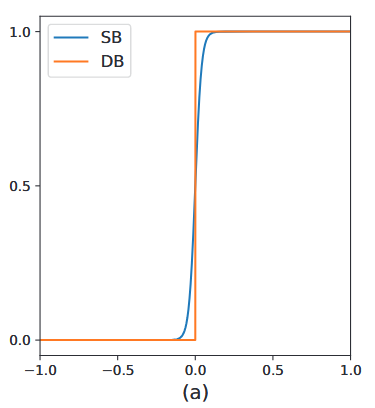
- 图中, 橙色线是标准二值化方法; 蓝色线是DB函数.
- 可以看到DB函数和标准的二值化方法达到的效果是相似的.
-
DB模块还可以改善网络性能, 可以从反向传播梯度的角度来解释. 令 $P_{i,j}-T_{i,j}=x$:
$$ f(x)=\cfrac{1}{1+e^{-kx}} $$-
使用二元交叉熵来作为loss的情况下, 对于正样本的loss: $l_{+}$ 计算和负样本的loss: $l_{-}$ 计算可以表示成下两式:
$$ l_{+}=-\log \cfrac{1}{1+e^{-kx}} $$$$ l_{-}=-\log \left(1-\cfrac{1}{1+e^{-kx}}\right) $$- 负号是为了让结果为正(log的真数为 $(0,1)$ 之间时, 结果为负), 看着方便.
-
**loss对于 $x$ 求偏导
$$ \cfrac{\partial l_{+}}{\partial x}=-kf(x) e^{-kx} $$$$ \cfrac{\partial l_{-}}{\partial x}=kf(x) $$ -
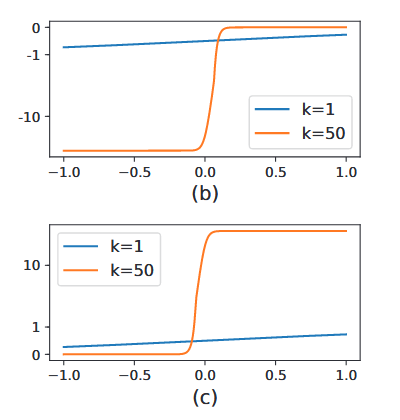
上述两函数如下图中的 (b) 和 (c) 图所示, (b) 图表示 $\frac{\partial l_{+}}{\partial x}$, (c) 图表示 $\frac{\partial l_{-}}{\partial x}$. 从微分公式可以看出:
- $k$ 是梯度的增益因子
- 梯度因子对于错误预测的增益幅度很大, 可以看到正样本当 $x<0$ 的时候和负样本 $x>0$ 的时候, $k=50$ 的绝对值是很大的(正负只影响梯度的方向), 说明 $k=50$ 相对于 $k=1$ , 更加放大了错误时的梯度(梯度变大, 神经元的权重参数的更新幅度变大), 有利于模型的学习.
-
-
3.4. 损失函数
DBNet论文中的Loss是三个loss的加权平均.
$$ L=L_s+\alpha \times L_b+\beta \times L_t $$$L_s$是概率图的loss; $L_b$是二值图的loss; $L_t$是阈值图的loss.
其中$L_s$和$L_b$是带OHEM的BCE loss; $L_t$是$L_1$ loss.
$$ L_s=L_b=\sum_{i \in S_l} y_i \log x_i+\left(1-y_i\right) \log \left(1-x_i\right) $$-
PaddleOCR中$L_b$使用Dice Loss; $L_s$使用带OHEM (arxiv PDF: Online Hard Example Mining) 的Dice loss; $L_t$是$L_1$ loss.
Dice Loss 是比较预测结果跟标签之间的相似度, 常用于二值图像分割.
$$ > \text{dice\_loss} = 1-\cfrac{2 \times \text { intersection\_area }}{\text { total\_area }} > $$MaskL1 Loss 是计算预测值和标签间的 $L_1$ 距离.
Balance Loss 是带OHEM的Dice Loss, 目的是为了改善正负样本不均衡的问题. OHEM 为一种特殊的自动采样方式, 可以自动的选择难样本进行Loss的计算, 从而提升模型的训练效果.
-
$L_1$和$L_2$距离
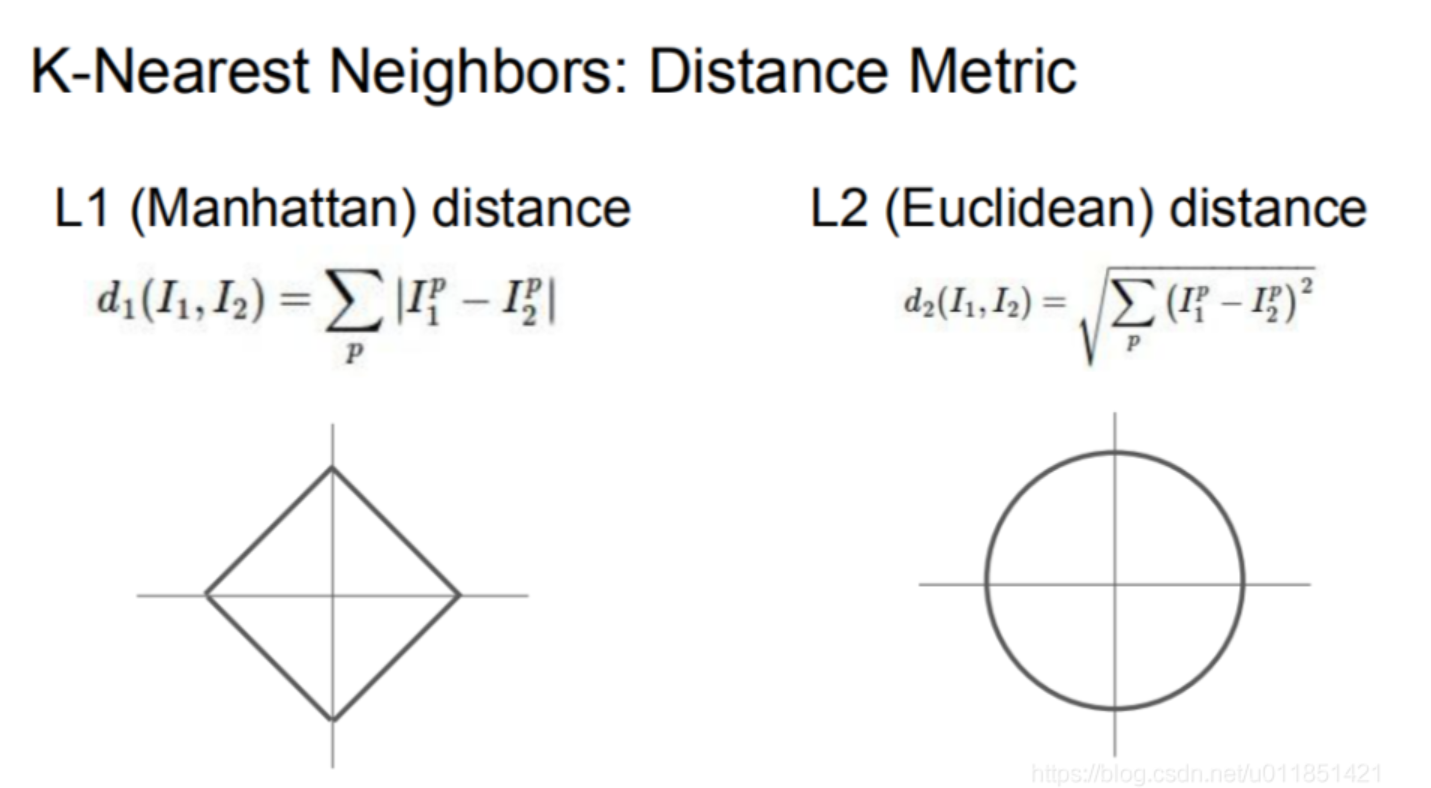
其中I1和I2是p维向量.
-
带OHEM的loss计算
- 对于每个训练迭代, 模型在所有样本上进行前向传播, 计算loss.
- 根据每个样本的loss值, 选择一部分损失最大的样本作为困难样本.
- 仅使用这些困难样本的loss来计算总损失.
- 执行反向传播和参数更新, 以改善模型性能.
3.5. 推理加速
- 在推理的阶段, 使用概率图或近似二值图都可以获得文本检测框(text bounding boxes). 所以可以直接使用概率图.
- 检测框形成步骤:
-
使用常数阈值对概率图进行二值化
-
从二值图获得连通区域(缩小文本区域)
-
收缩区域通过Vatti裁剪算法以一个偏移量进行膨胀
$$ D=\cfrac{A\left(1-r^2\right)}{L} $$$A$ 是原始多边形的面积; $L$ 是原始多边形周长; $r$ 默认 0.4.
-
4. DBNet++
DBNet++在DBNet的基础上增加了ASF(Adaptive Scale Fusion 自适应尺度融合)模块. 不同尺度的特征通过ASF模块处理, 可以得到更佳的融合不同尺度的特征图.
-
DBNet++模型图
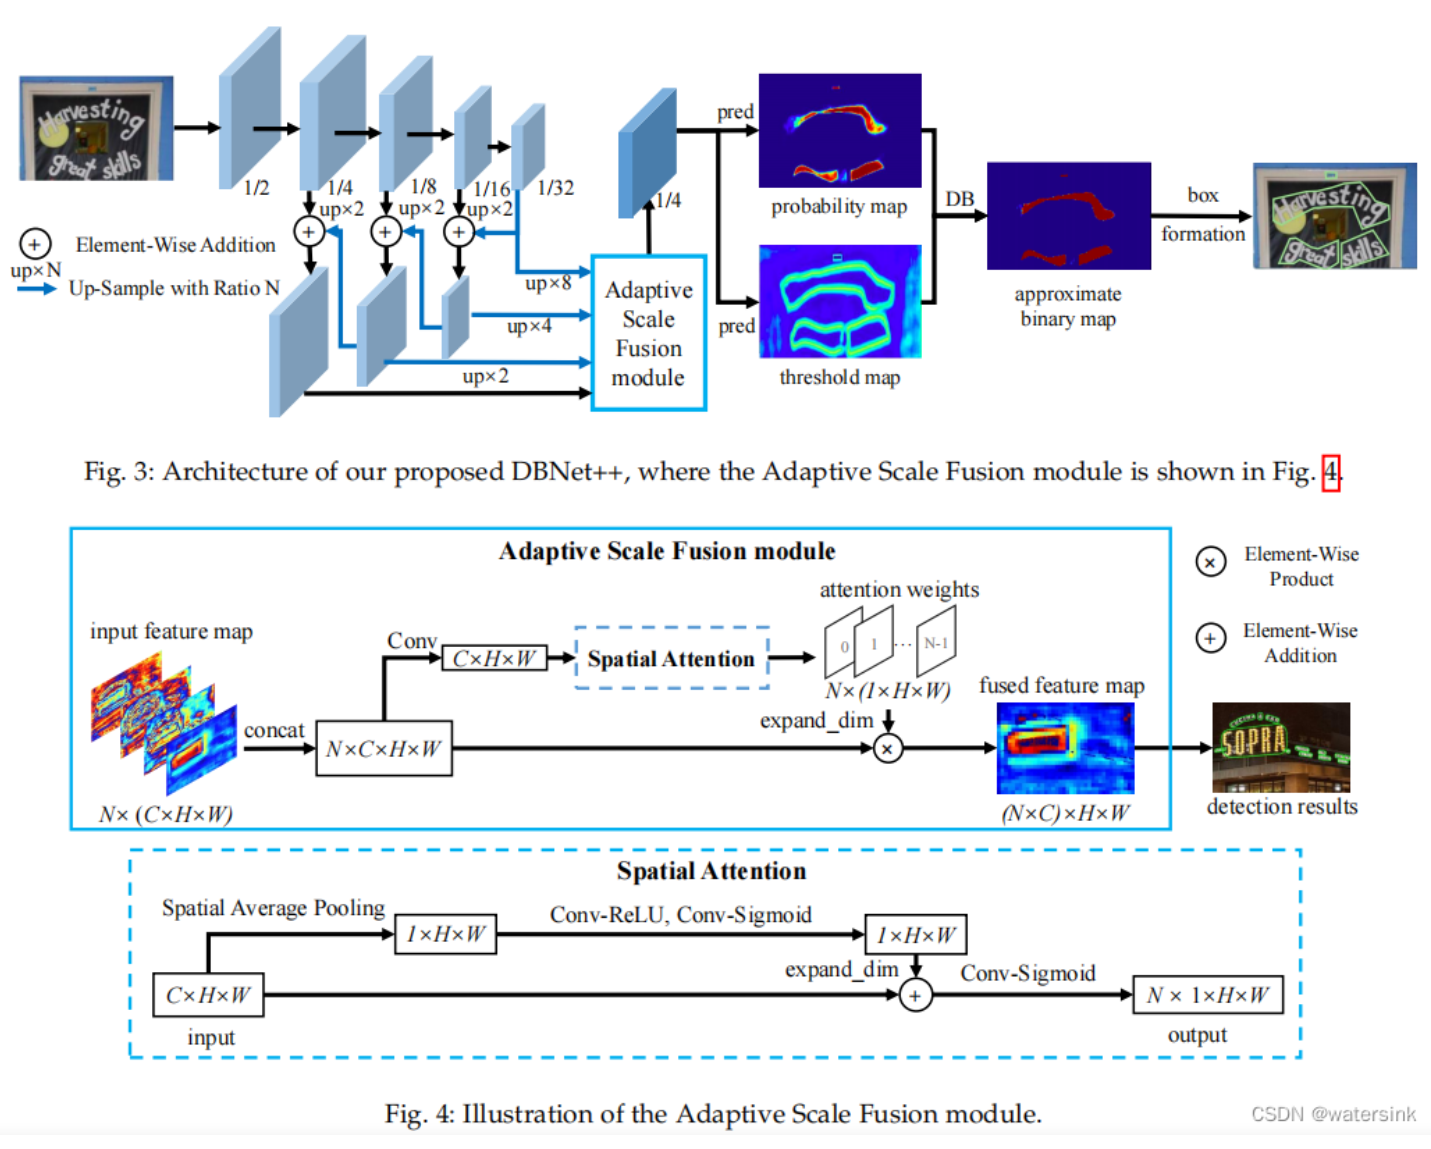
ASF模块通过引入空间attention机制, 使得融合后的特征更加鲁棒.
其中N表示要融合的特征数, 这里N=4, 表示从4个不同的分支引出的特征.
-
对比DBNet模型图