Deep Learning With PyTorch - Full Course
1. Installation
2. Tensor Basics
import torch
torch.zeros()
torch.ones()
torch.rand() # 正数随机(0, 1)
torch.randn() # 带负数的随机(-1, 1)
torch.tensor([[1, 1], [2, 3]])

torch.add(a, b)
torch.mul(a, b) # 哈德马积
torch.mm(a, b) # 矩阵相乘
a.t() # 转置
a.add_(1) # 矩阵内数值全部+1
# 也可以直接 a+=1, 在numpy中也可以用

a = torch.rand(2, 4)
a.view(-1, 2) #使矩阵从(2, 4)->(4, 2), -1是缺省值自动计算

torch.xxxx(xxxxx ,dtype=float (int32)) # 可以定义数据类型

import numpy as np
a = np.ones()
b = torch.from_numpy(a) # np.ndarray -> tensor
c = b.numpy() # tensor -> np.ndarray

# 书中的一些其他基础函数
a = torch.arange(12) # 新定义1-12个元素张量
# tensor([ 0,  1,  2,  3,  4,  5,  6,  7,  8,  9, 10, 11])
x.shape # 显示张量的形状
# torch.Size([12])
x.numel() # 只显示张量的元素数量
# 12
- tensor格式是专门为cuda准备的
- tensor和np.ndarray 相互转换时, 变量的内存共享, eg: 使用add_, 都会变.
if torch.cuda.is_available():
    device = torch.device("cuda")
    x = torch.ones(5, device=device) # 写入显存
    y = torch.ones(5)
    y = y.to(device) # 写入显存2
    z = x + y
    print(z)
		# z = z.to("cpu") # 只有参数放回内存之后才可以改为numpy格式
    z.numpy() # 报错, 显存中的tensor参数不能变成numpy格式
-
numpy格式无法放入显存
-
选定显卡
import os
os.environ["CUDA_VISIBLE_DEVICES"] = "0"

# or
# when loading model
model.load_state_dict(torch.load(PATH, map_location="cuda:0"))
model.to(device)
# or when initing the model
model_load = NeuralNetMultiClass(input_size, hidden_size, num_classes).to(device)
3. Autograd
- 注意, loss必须是标量, 才能进行反向传播. 所以如果loss是向量, 需要用sum或mean将loss转换为标量.
x = torch.randn(3, requires_grad=True) # requires_grad 使矩阵支持求导
print(x)

y = x + 2 # grad_fn=<AddBackward0>
print(y)
z = y * y * 2 # grad_fn=<MulBackward0>
z = z.mean() # grad_fn=<MeanBackward0>
print(z)
# v = torch.tensor([0.1, 0.1, 0.1], dtype=torch.float32)
# z.backward(v)  #

z.backward() # dz/dx, 只会对标量输出来计算梯度, 向量的话用mean, sum函数转换为标量.
# 或者直接 v = torch.tensor([1, 0]) 只计算向量中第一项.
# 或者v = torch.tensor([0.1, 0.1, 0.1], dtype=torch.float32), torch.ones_like(z)
# 使v和输出一致.
print(x.grad)
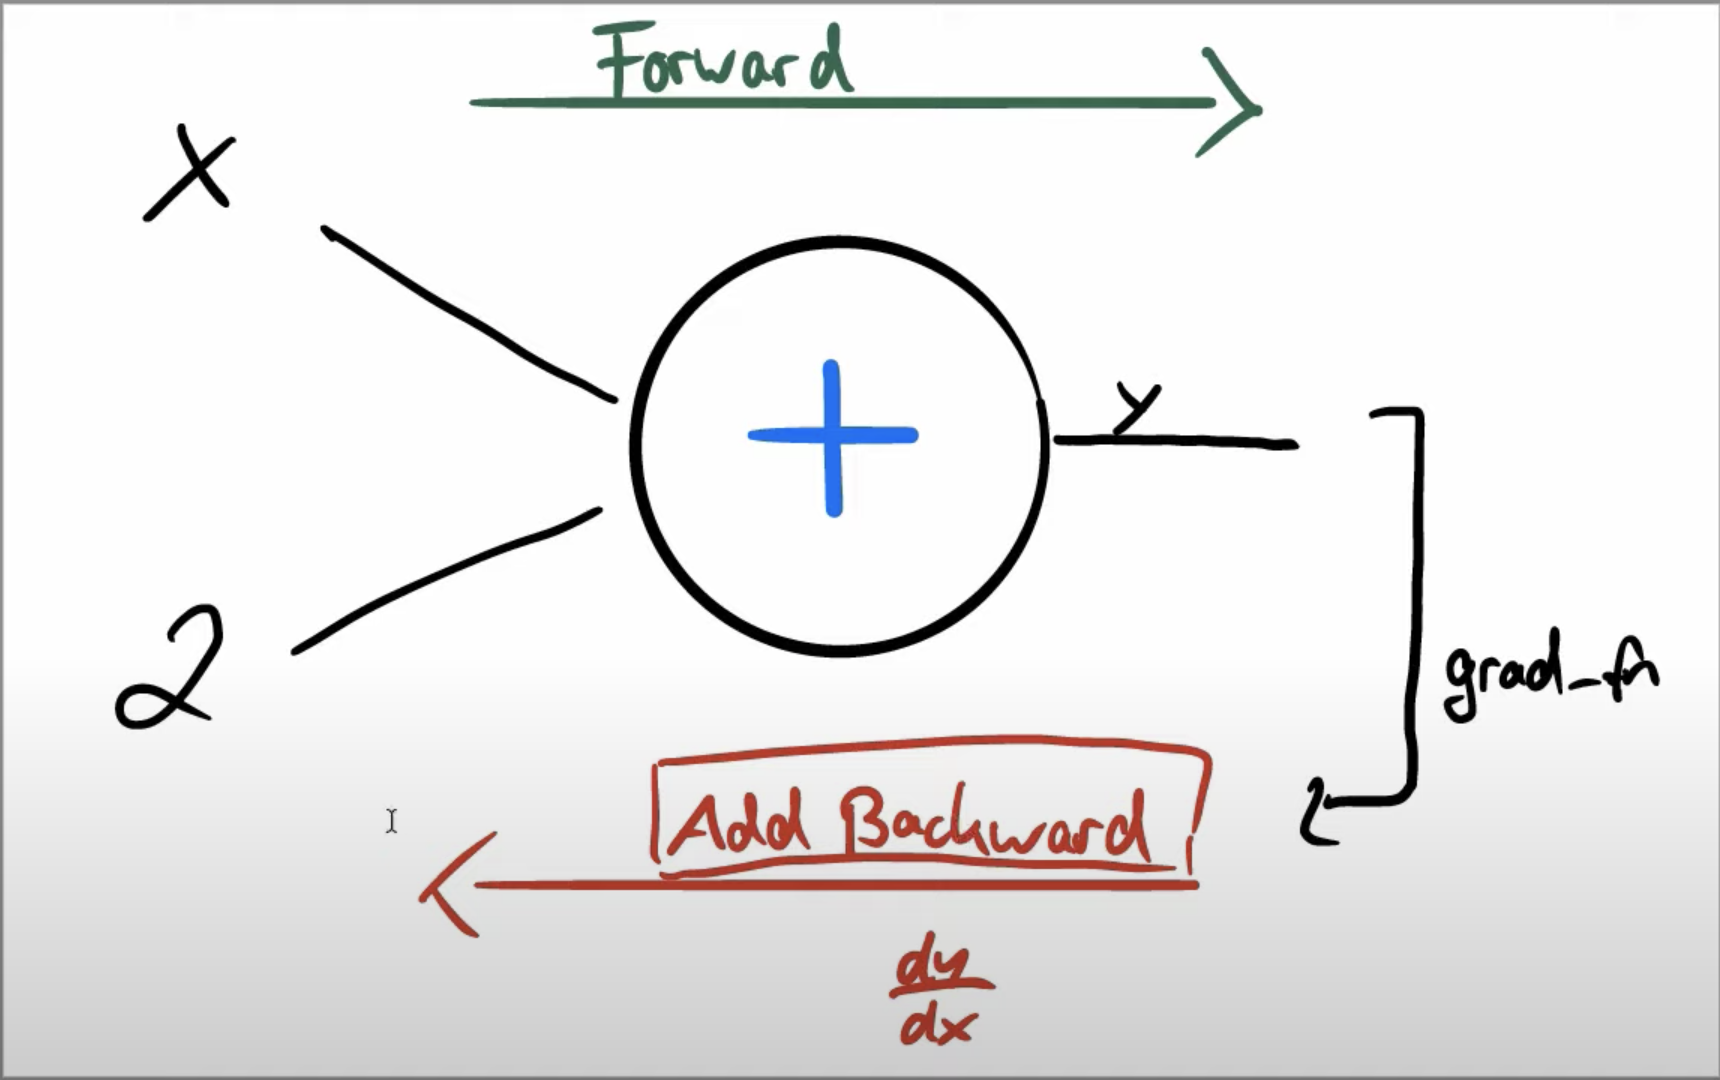
#小技巧
1. x.requires_grad_(False) # 可以把requires_grad项改为False, x变
2. y = x.detach() # requires_grad -> False, x不变
3. with torch.no_grad():
   y = x + 1 # requires_grad -> False, x不变, 但是y不能直接等于x
直接y = x + 1 # y就带上了gradien function, grad_fn=<AddBackward0>
- 每个epoch训练之后都要使w的grad清零:
weights = torch.ones(4, requires_grad=True)

for epoch in range(3):
    model_output = (weights*3).sum()
    model_output.backward()

    print(weights.grad)
    **weights.grad.zero_()**
4. Backpropagation
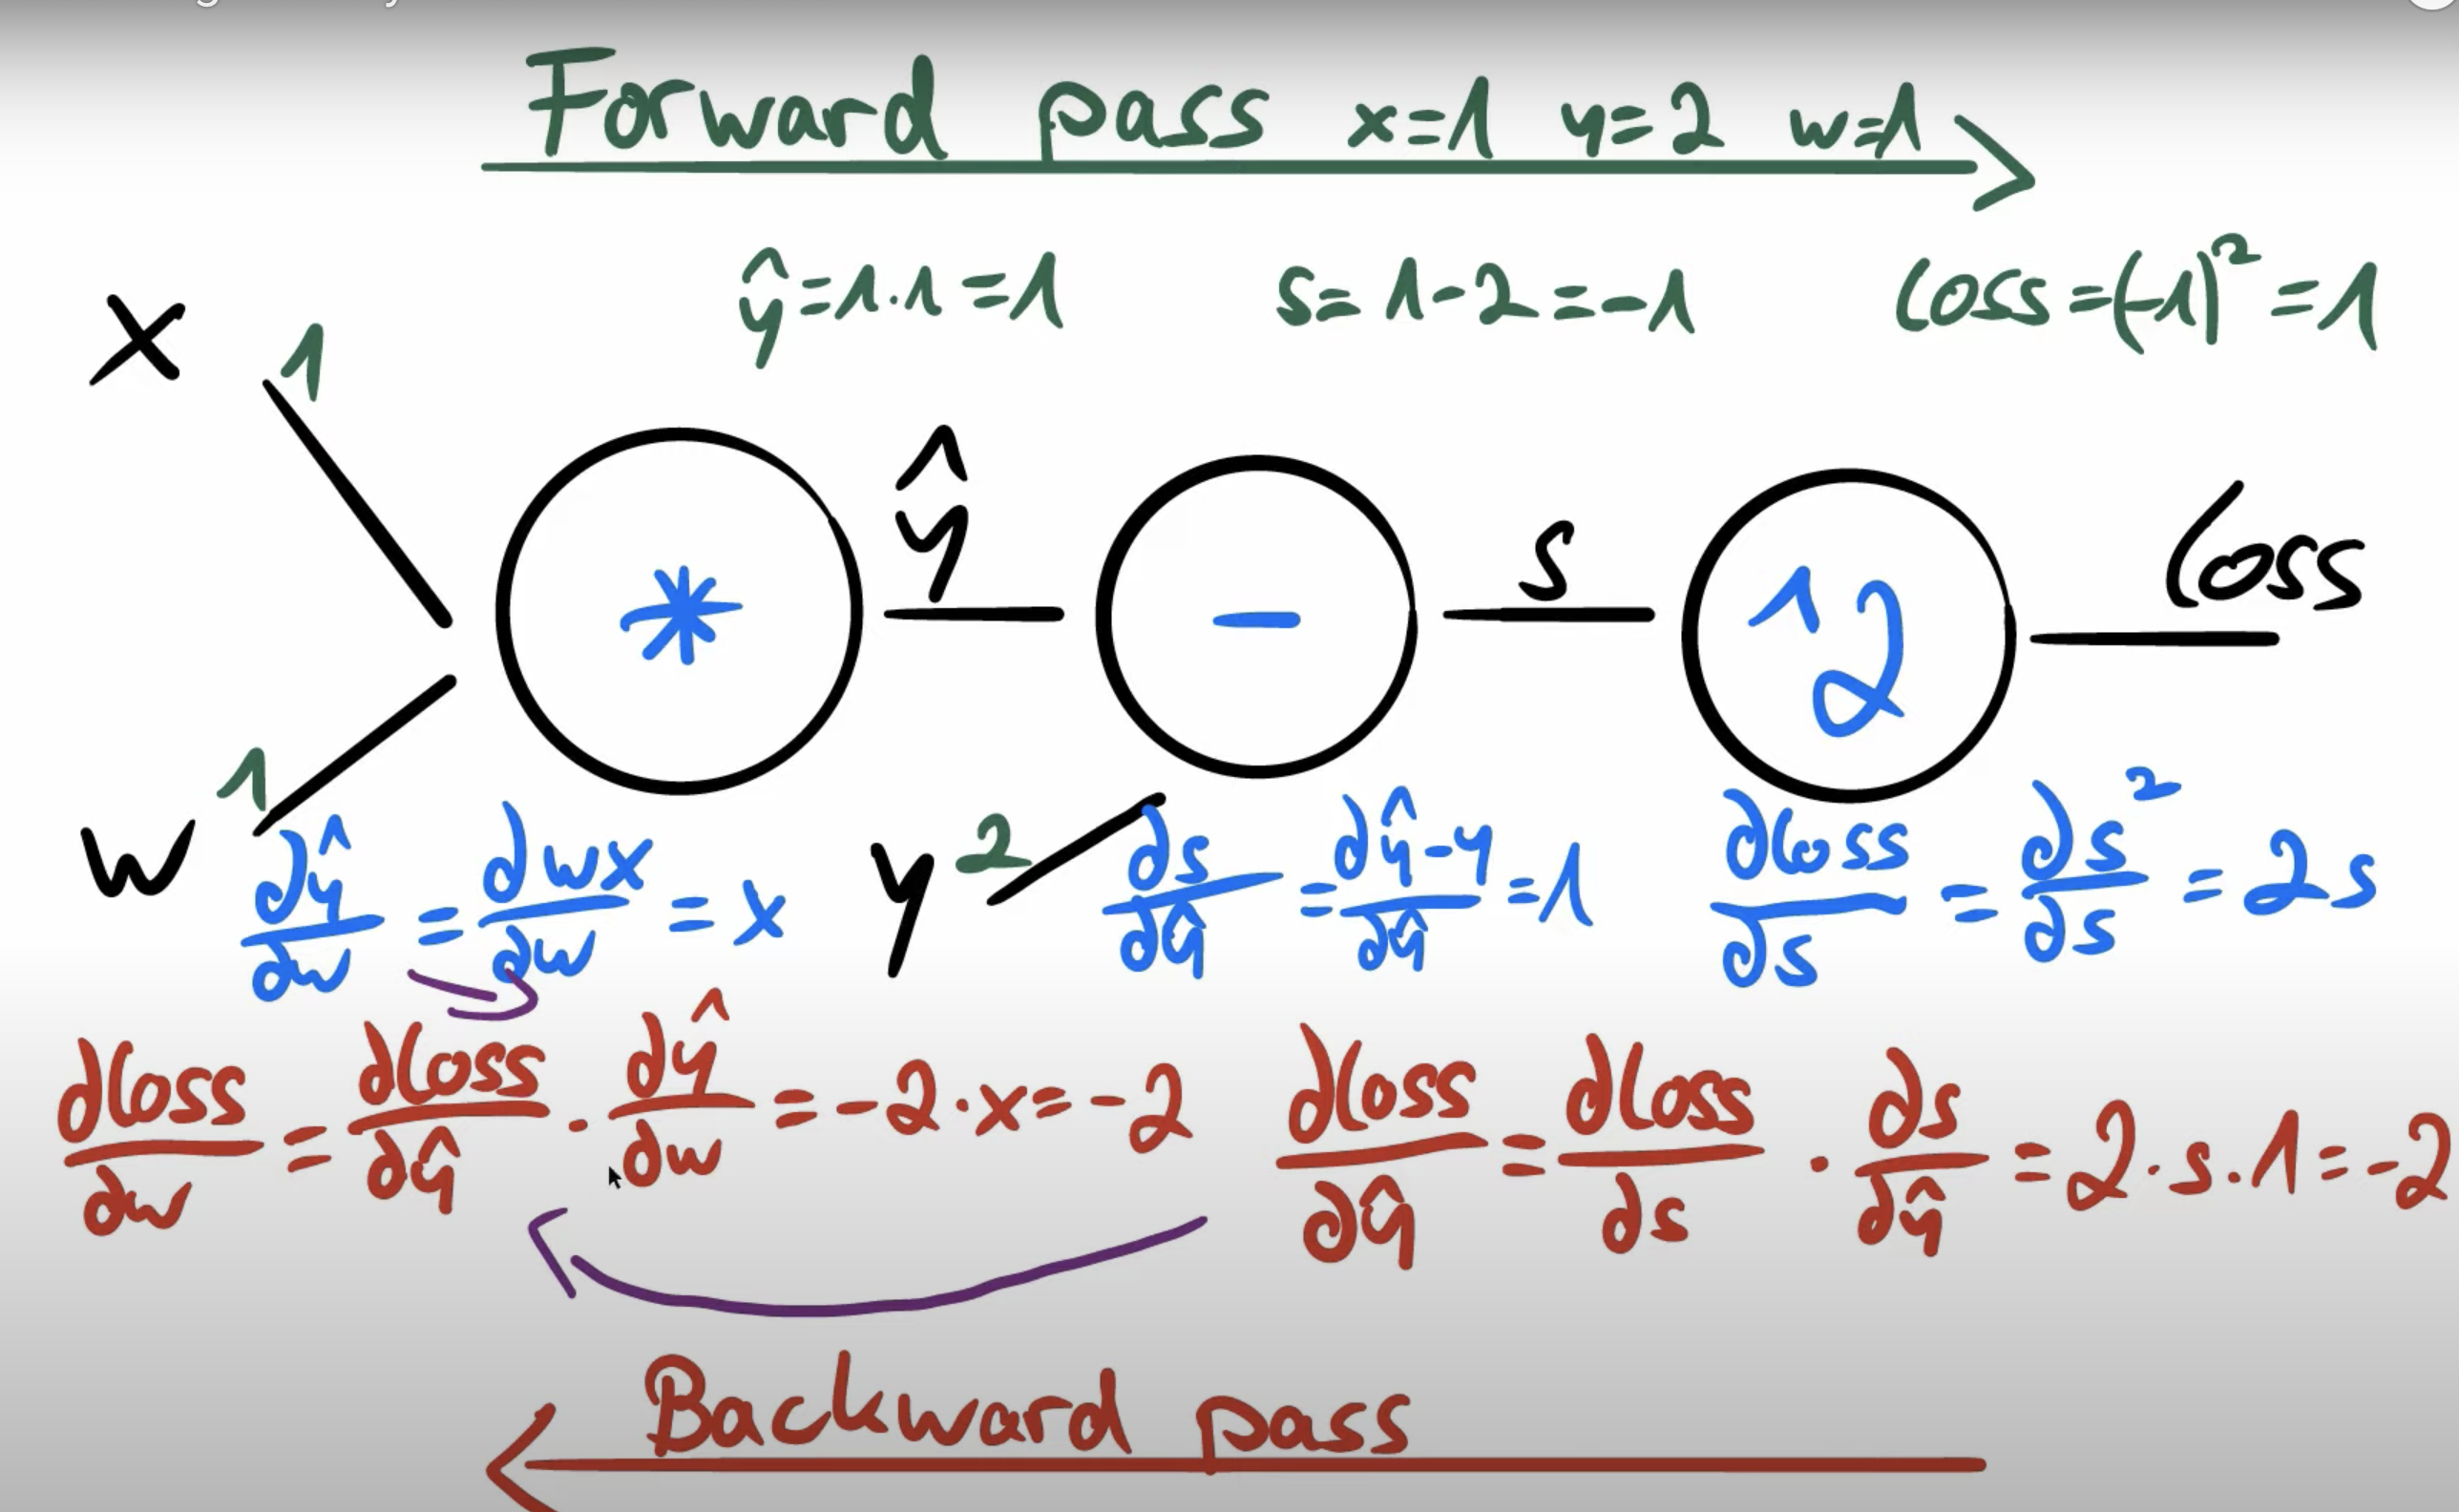
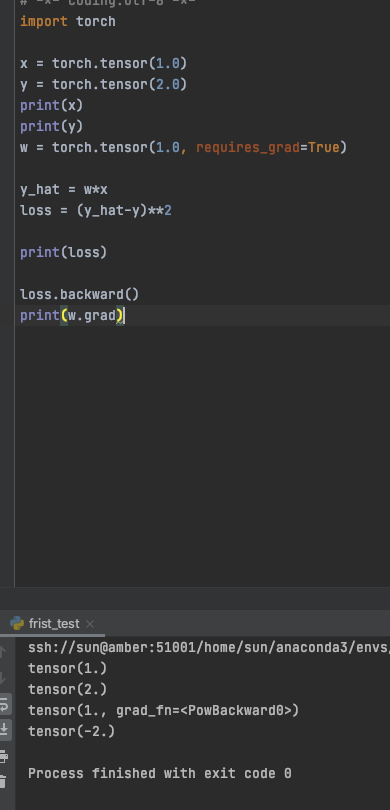
5. Gradient Descent With Autograd and Backpropagation
Training Pipeline: Model, Loss, and Optimizer
# -*- coding:utf-8 -*-
import numpy as np
import torch
from torch import nn

# f = w*x
# f = 2*x

x = torch.tensor([[1], [2], [3], [4]], dtype=torch.float32)
y = torch.tensor([[2], [4], [6], [8]], dtype=torch.float32)

x_test = torch.tensor([5], dtype=torch.float32)
# w = torch.tensor(0, dtype=torch.float32, requires_grad=True)

n_samples, n_features = x.shape
print(n_samples, n_features)

input_size = n_features
output_size = n_features

# model = nn.Linear(input_size, output_size)

class LinearRegression(nn.Module):
    def __init__(self, input_dim, output_dim):
        super(LinearRegression, self).__init__()
        self.lin = nn.Linear(input_dim, output_dim)
    def forward(self, x):
        return self.lin(x)

model = LinearRegression(input_size, output_size)

# def forward(x):
#     return w * x

print(f"prediction before training: f(5) = {model(x_test).item():.3f}")

# training
learning_rate = 0.01
n_iters = 100

loss = nn.MSELoss()
optimizer = torch.optim.SGD((model.parameters()), lr=learning_rate)

if torch.cuda.is_available():
    device = torch.device('cpu')
    x.to(device)
    y.to(device)
    # w.to(device)
    for epoch in range(n_iters):
        y_pred = model(x)
        l = loss(y, y_pred)
        # 反向传播
        l.backward()
        # with torch.no_grad():
        #     w -= learning_rate * w.grad

        # 大部分的优化器都内置了step函数, 用于在反向传播之后更新内部的参数
        optimizer.step()
        # 重置梯度
        optimizer.zero_grad()

        if epoch % 10 == 0:
            [w, b] = model.parameters()
            print(f'epoch {epoch + 1}: w = {w[0][0]: .3f}, b = {b[0]: .3f} loss = {l:.8f}')

print(f"prediction after training: f(5) = {model(x_test).item():.3f}")
4 1
prediction before training: f(5) = 1.611
epoch 1: w =  0.468, b =  0.562 loss = 19.56327057
epoch 11: w =  1.486, b =  0.876 loss = 0.65111023
epoch 21: w =  1.658, b =  0.903 loss = 0.15336990
epoch 31: w =  1.693, b =  0.885 loss = 0.13254575
epoch 41: w =  1.706, b =  0.861 loss = 0.12452319
epoch 51: w =  1.716, b =  0.835 loss = 0.11726725
epoch 61: w =  1.724, b =  0.811 loss = 0.11044146
epoch 71: w =  1.732, b =  0.787 loss = 0.10401321
epoch 81: w =  1.740, b =  0.764 loss = 0.09795904
epoch 91: w =  1.748, b =  0.741 loss = 0.09225740
prediction after training: f(5) = 9.495
- 类里的super是干嘛的?
-
可以调用基类里的方法, 如果调用C类的话, 会再super处自动调用A类
class A():
    def __init__(self):
        print('Call class A')
        print('Leave class A')
class C(A):
    def __init__(self):
        print('Call class C')
        super(C, self).__init__()
        print('Leave class C')
#################
Call class C
Call class A
Leave class A
Leave class C
-
6. Linear Regression
# -*- coding:utf-8 -*-

"""
1. Design model (input, output size, forward pass)
2. construct loss and optimizer
3. Training loop
    - forward pass: compute prediction and loss
    - backward pass: gradients
    - update weights
"""

import matplotlib.pyplot as plt
import numpy as np
import torch
import torch.nn as nn
from sklearn import datasets

if torch.cuda.is_available():
    device = torch.device("cuda")
else:
    device = torch.device("cpu")

X_np, y_np = datasets.make_regression(n_samples=100, n_features=1, noise=20, random_state=1)

X = torch.from_numpy(X_np.astype(np.float32))
y = torch.from_numpy(y_np.astype(np.float32))
y = y.view(y.shape[0], 1)
X = X.to(device)
y = y.to(device)
# print(X.shape)
# print(y.shape)

n_samples, n_features = X.shape

# model
input_size = n_features
output_size = 1
model = nn.Linear(input_size, output_size)
model.to(device)

# loss and optimizer
learning_rate = 0.01
loss = nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=learning_rate)

# training loop
epochs = 1000
for epoch in range(epochs):
    # forward pass and loss
    y_pre = model(X)
    loss_ = loss(y_pre, y)

    # backward pass
    loss_.backward()

    # update
    optimizer.step()
    optimizer.zero_grad()

    if (epoch + 1) % 10 == 0:
        print(f"epoch: {epoch + 1}, loss: {loss_:.4f}")

# 这里使用了分离函数detach使predict没有require_grad,
# 有require_grad或在显存中都无法转换为numpy的类型
# 如果不使用detach(), 可以使用with torch.no_grad():
predict = model(X).cpu().detach().numpy()
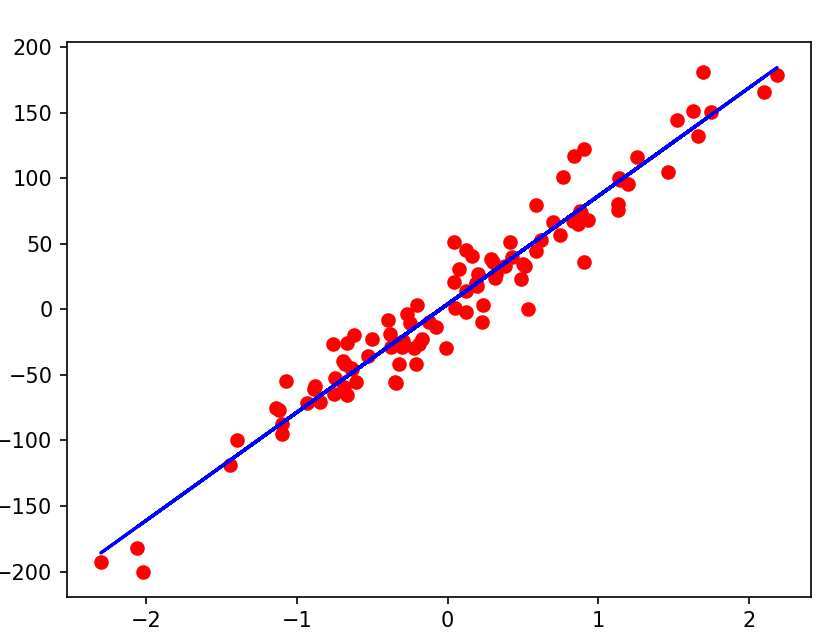
plt.plot(X_np, y_np, 'ro')
plt.plot(X_np, predict, 'b')
plt.savefig('linear_regression_result.png')
epoch: 10, loss: 4351.0640
epoch: 20, loss: 3248.5317
epoch: 30, loss: 2450.2957
epoch: 40, loss: 1871.7806
epoch: 50, loss: 1452.1096
epoch: 60, loss: 1147.4028
epoch: 70, loss: 925.9892
epoch: 80, loss: 764.9808
epoch: 90, loss: 647.8183
epoch: 100, loss: 562.5082

Process finished with exit code 0
7. Logistic Regression
# -*- coding:utf-8 -*-
"""
1. Design model (input, output size, forward pass)
2. construct loss and optimizer
3. Training loop
    - forward pass: compute prediction and loss
    - backward pass: gradients
    - update weights
"""
import numpy as np
import torch
import torch.nn as nn
from sklearn import datasets
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler

# 0. prepare data
bc = datasets.load_breast_cancer()
X, y = bc.data, bc.target

n_samples, n_features = X.shape

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=1)

# 建立一个实施标准化的实例
sc = StandardScaler()
# fit_transform用于获得训练集各个特征的均值和方差.
X_train = sc.fit_transform(X_train)
# 测试集用上面获得的均值和方差对各个特征的数据进行转换, 这样模型推理测试集的时候结果更会准确
X_test = sc.transform(X_test)

X_train = torch.from_numpy(X_train.astype(np.float32))
X_test = torch.from_numpy(X_test.astype(np.float32))
y_train = torch.from_numpy(y_train.astype(np.float32))
y_test = torch.from_numpy(y_test.astype(np.float32))

# 矩阵转置 view(矩阵第一维(行数), 矩阵第二维(列数))
y_train = y_train.view(y_train.shape[0], 1)
y_test = y_test.view(y_test.shape[0], 1)

class LogisticRegression(nn.Module):
    def __init__(self, input):
        super(LogisticRegression, self).__init__()
        self.linear = nn.Linear(input, 1)

    def forward(self, x):
        y_p = torch.sigmoid(self.linear(x))
        return y_p

model = LogisticRegression(n_features)

# loss and optimizer
lr = 0.01
loss = nn.BCELoss()
opt = torch.optim.SGD(model.parameters(), lr=lr)

# training
epochs = 6000
for epoch in range(epochs):
    y_p = model(X_train)
    loss_ = loss(y_p, y_train)

    loss_.backward()

    opt.step()
    opt.zero_grad()

    if epoch % 10 == 0:
        print(f"epoch {epoch}, loss {loss_.item():.4f}")

with torch.no_grad():
    y_p = model(X_test)
    y_p_cls = y_p.round()  # tensor round函数可以将浮点数四舍五入到最近的整数
    acc = y_p_cls.eq(y_test).sum() / float(y_test.shape[0])
    print(f"acc {acc:.4f}")
epoch 5920, loss 0.0665
epoch 5930, loss 0.0665
epoch 5940, loss 0.0664
epoch 5950, loss 0.0664
epoch 5960, loss 0.0664
epoch 5970, loss 0.0664
epoch 5980, loss 0.0663
epoch 5990, loss 0.0663
acc 0.9737
8. Dataset
8.1. DataLoader
- 使用
torch.utils.data.DataLoader()调用数据- DataLoader方法结合了数据集和取样器, 可以自动对数据进行shuffle, mini_batch, 多线程, 自定义预处理方法等功能, 非常方便.
# -*- coding:utf-8 -*-
import math

import numpy as np
import torch
from torch.utils.data import DataLoader

class WineDataset():
    def __init__(self):
        xy = np.loadtxt('./pytorchTutorial/data/wine/wine.csv', delimiter=',', dtype=np.float32, skiprows=1)
        self.x = torch.from_numpy(xy[:, 1:])
        self.y = torch.from_numpy(xy[:, [0]])
        self.n_samples = xy.shape[0]

    def __getitem__(self, item):
        # 特殊函数__getitem__可以使这个类实例像调用列表一样,
        # 调用类的属性变量
        return self.x[item], self.y[item]

    def __len__(self):
        return self.n_samples

dataset = WineDataset()
# first_data = dataset[0]
# features, labels = first_data
# print(features)
# print(labels)
dataloader = DataLoader(dataset=dataset, batch_size=4, shuffle=True, num_workers=2)

# dataiter = iter(dataloader)
# data = dataiter.next()
# features, labels = data
# print(features)
# print(labels)

# training loop
num_epochs = 2
total_sample = len(dataset)
n_iterations = math.ceil(total_sample / 4)
print(total_sample, n_iterations)

for epoch in range(num_epochs):
    for i, (inputs, labels) in enumerate(dataloader):
        # forward backward, update
        if (i + 1) % 5 == 0:
            print(f"epoch: {epoch + 1}/{num_epochs}, step {i + 1}/{n_iterations}, inputs {inputs.shape}")
178 45
epoch: 1/2, step 5/45, inputs torch.Size([4, 13])
epoch: 1/2, step 10/45, inputs torch.Size([4, 13])
epoch: 1/2, step 15/45, inputs torch.Size([4, 13])
epoch: 1/2, step 20/45, inputs torch.Size([4, 13])
epoch: 1/2, step 25/45, inputs torch.Size([4, 13])
epoch: 1/2, step 30/45, inputs torch.Size([4, 13])
epoch: 1/2, step 35/45, inputs torch.Size([4, 13])
epoch: 1/2, step 40/45, inputs torch.Size([4, 13])
epoch: 1/2, step 45/45, inputs torch.Size([2, 13])
epoch: 2/2, step 5/45, inputs torch.Size([4, 13])
epoch: 2/2, step 10/45, inputs torch.Size([4, 13])
epoch: 2/2, step 15/45, inputs torch.Size([4, 13])
epoch: 2/2, step 20/45, inputs torch.Size([4, 13])
epoch: 2/2, step 25/45, inputs torch.Size([4, 13])
epoch: 2/2, step 30/45, inputs torch.Size([4, 13])
epoch: 2/2, step 35/45, inputs torch.Size([4, 13])
epoch: 2/2, step 40/45, inputs torch.Size([4, 13])
epoch: 2/2, step 45/45, inputs torch.Size([2, 13])

Process finished with exit code 0
8.2. Dataset Transforms
- 对数据进行预处理的时候该怎么做?
# -*- coding:utf-8 -*-
import math

import numpy as np
import torch, torchvision
from torch.utils.data import DataLoader, Dataset

class WineDataset(Dataset):
    def __init__(self, transform=None):
        xy = np.loadtxt('./pytorchTutorial/data/wine/wine.csv', delimiter=',', dtype=np.float32, skiprows=1)
        self.x = xy[:, 1:]
        self.y = xy[:, [0]]
        self.n_samples = xy.shape[0]

        self.transform = transform

    def __getitem__(self, item):
        sample = self.x[item], self.y[item]
        if self.transform:
            sample = self.transform(sample)
        return sample

    def __len__(self):
        return self.n_samples

class ToTensor:
    def __call__(self, sample):
        inputs, labels = sample
        return torch.from_numpy(inputs), torch.from_numpy(labels)

class MulTransform:
    def __init__(self, factor):
        self.factor = factor

    def __call__(self, sample):
        inputs, labels = sample
        inputs += self.factor
        return inputs, labels

# dataset = WineDataset(transform=ToTensor())
dataset = WineDataset(transform=None)
first_data = dataset[0]
features, labels = first_data
print(features)
print(labels)

# torchvision.transforms.Compose集合所有指定的预处理类
composed = torchvision.transforms.Compose([ToTensor(), MulTransform(4)])
dataset = WineDataset(transform=composed)
first_data = dataset[0]
features, labels = first_data
print(features)
print(labels)

# dataloader = DataLoader(dataset=dataset, batch_size=4, shuffle=True, num_workers=2)
#
# # dataiter = iter(dataloader)
# # data = dataiter.next()
# # features, labels = data
# # print(features)
# # print(labels)
#
# # training loop
# num_epochs = 2
# total_sample = len(dataset)
# n_iterations = math.ceil(total_sample / 4)
# print(total_sample, n_iterations)
#
# for epoch in range(num_epochs):
#     for i, (inputs, labels) in enumerate(dataloader):
#         # forward backward, update
#         if (i + 1) % 5 == 0:
#             print(f"epoch: {epoch + 1}/{num_epochs}, step {i + 1}/{n_iterations}, inputs {inputs.shape}")
-
特殊函数 call__和__init 类似, 不同之处:
- 在创建实例的时候__init__会被调用, __call__不会.
- 对实例进行输入的时候, __call__才会被调用.
class A():
    def __init__(self):
        print('init函数')
    def __call__(self, param):
        print('call 函数', param)

a = A()  # print: init函数
a(1)  # print: call 函数
9. 激活函数
9.1. Sigmoid
二分类问题可以用sigmoid函数(又称Logistic函数). 可以将$(-\infty , +\infty)$范围的数值映射到$(0,1)$之间. 所以可以表示为概率. 公示如下:
$$ g(z)=\frac{1}{1+e^{-z}} $$9.2. Softmax
多分类问题可以使用Softmax, 公示如下:
$$ S(y_i)=\frac{e^{y_i}}{\sum e^{y_j}} $$import torch
import torch.nn as nn
import numpy as np
def softmax(x):
return np.exp(x) / np.sum(np.exp(x), axis=0)
x = np.array([2.0, 1.0, 0.1])
outputs = softmax(x)
print('softmax numpy:', outputs)
x = torch.tensor([2.0, 1.0, 0.1])
outputs = torch.softmax(x, dim=0)
print('softmax numpy:', outputs)
softmax numpy: [0.65900114 0.24243297 0.09856589]
softmax numpy: tensor([0.6590, 0.2424, 0.0986])

Process finished with exit code 0
9.4. Activation Functions
常见的激活函数
- step function
- sigmoid
- tanh
- ReLU
- Leaky ReLU
- softmax
10. Loss 损失函数
10.1. Cross Entropy
-
通常分类问题使用Softmax或Sigmoid函数获得每一个分类的可能的概率.
$$ D(\hat{Y}, Y)=-\frac{1}{N} \cdot \sum Y_{i} \cdot \log \left(\hat{Y}_{i}\right) $$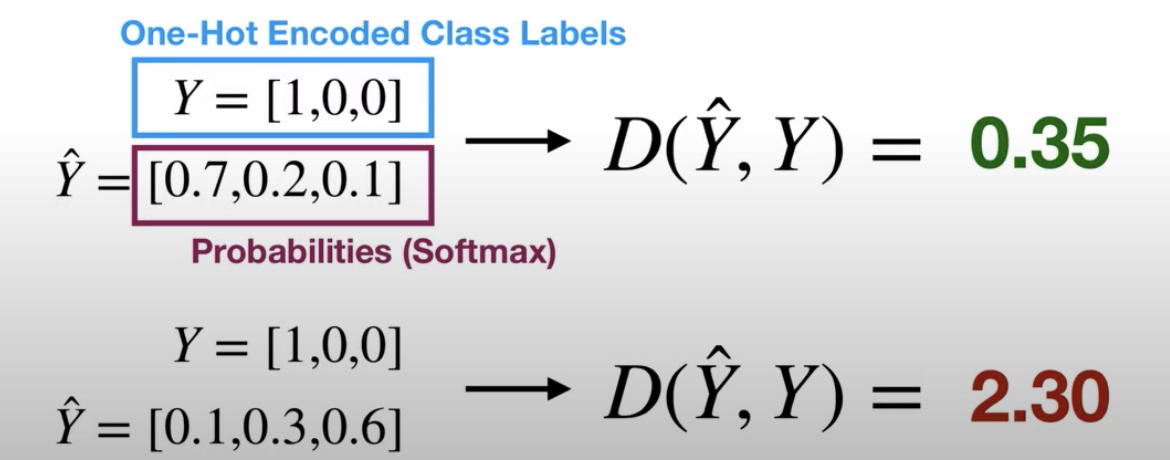
-
公式推导过程
$$ \begin{aligned}\operatorname{argmax} \log \prod_{\mathrm{n}} \prod_{\mathrm{i}} \hat{Y}_{i}^{Y_{i}}&=\operatorname{argmax} \sum_{n} \sum_{i} Y_{i} \log \hat{Y}_{i}\\&=\operatorname{argmin}-\sum_{n} \sum_{i} Y_{i} \log \hat{Y}_{i}\end{aligned} $$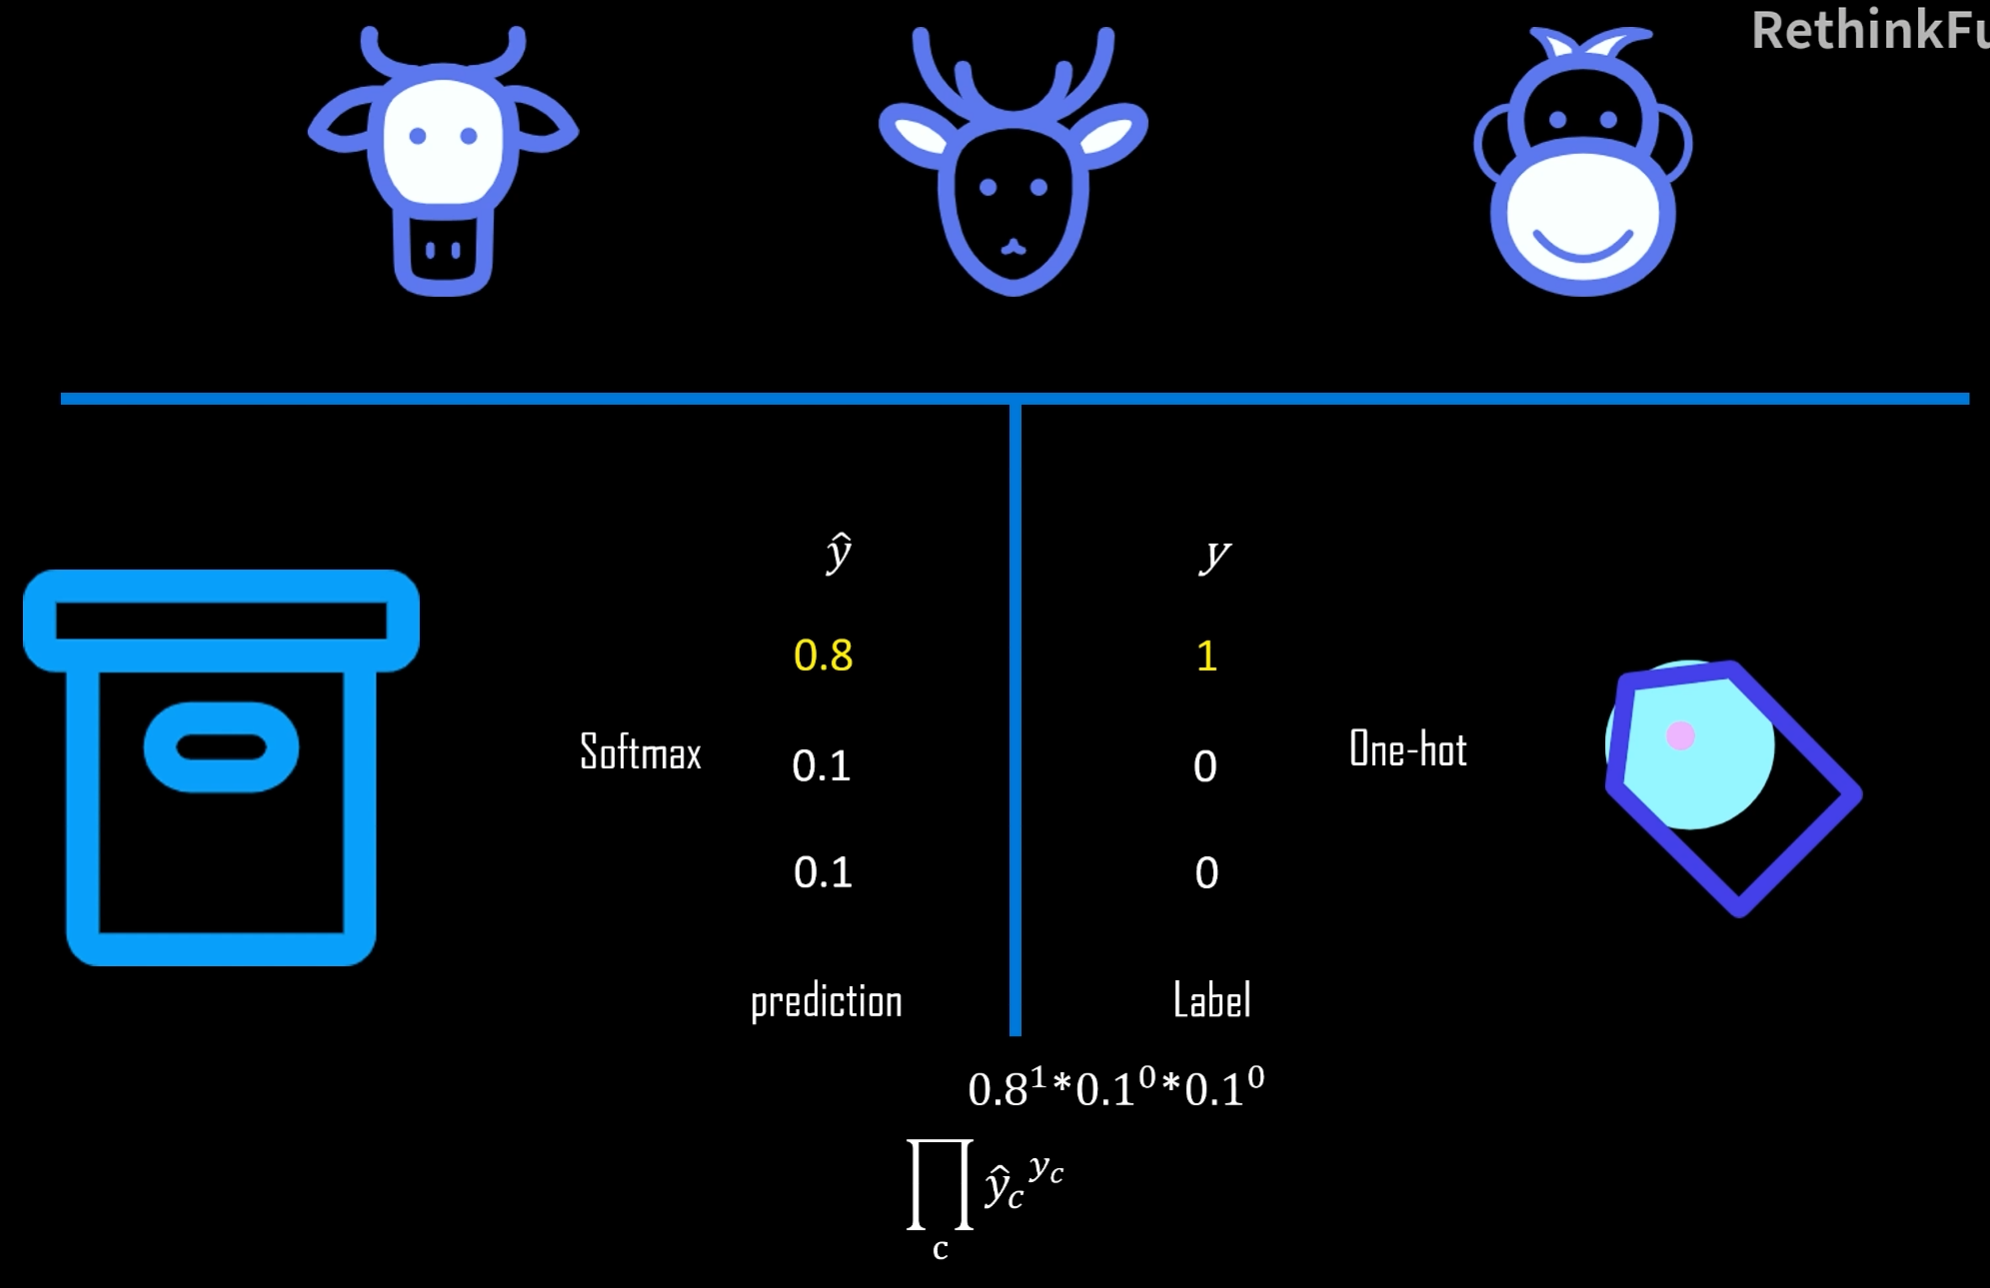
- $n$表示训练样本数; $i$表示分类数量. 因为只要找到最值就可以了, 所有这里是额外加一个$log$的. 利用$log$似然函数的特性, 把连乘提到$log$左边变成连加; 加上负号求最小值.
# -*- coding:utf-8 -*-

import numpy as np
import torch
import torch.nn as nn

def cross_entropy(actual, predicted):
    loss = -np.sum(actual * np.log(predicted))
    return loss

Y = np.array([1, 0, 0])

y_pred_good = np.array([0.7, 0.2, 0.1])
y_pred_bad = np.array([0.1, 0.3, 0.6])
l1 = cross_entropy(Y, y_pred_good)
l2 = cross_entropy(Y, y_pred_bad)
print(f'Loss1 numpy: {l1:.4f}')
print(f'Loss2 numpy: {l2:.4f}')

"""
xxxxxxxxxxxxxxxxxxxxxx
"""
loss = nn.CrossEntropyLoss()

Y = torch.tensor([2, 0, 1])
Y_pred_good = torch.tensor([[0.1, 1.0, 2.1], [2.0, 1.0, 0.1], [0.1, 3.0, 0.1]])
Y_pred_bad = torch.tensor([[2.1, 1.0, 0.1], [0.1, 1.0, 2.1], [0.1, 3.0, 0.1]])

l1 = loss(Y_pred_good, Y)
l2 = loss(Y_pred_bad, Y)

print(l1.item())
print(l2.item())

_, predictions1 = torch.max(Y_pred_good, 1)
_, predictions2 = torch.max(Y_pred_bad, 1)
print(predictions1)
print(predictions2)
Loss1 numpy: 0.3567
Loss2 numpy: 2.3026
xxxxxxxxxxxxxxxxxxxxxxxxx
0.3018244206905365
1.6241613626480103
tensor([2, 0, 1])
tensor([0, 2, 1])
-
如果使用
nn.CrossEntropyLoss()就不要再网络最后加Softmax层, 但是如果使用nn.BCELoss(),网络最后要加上Sigmoid层.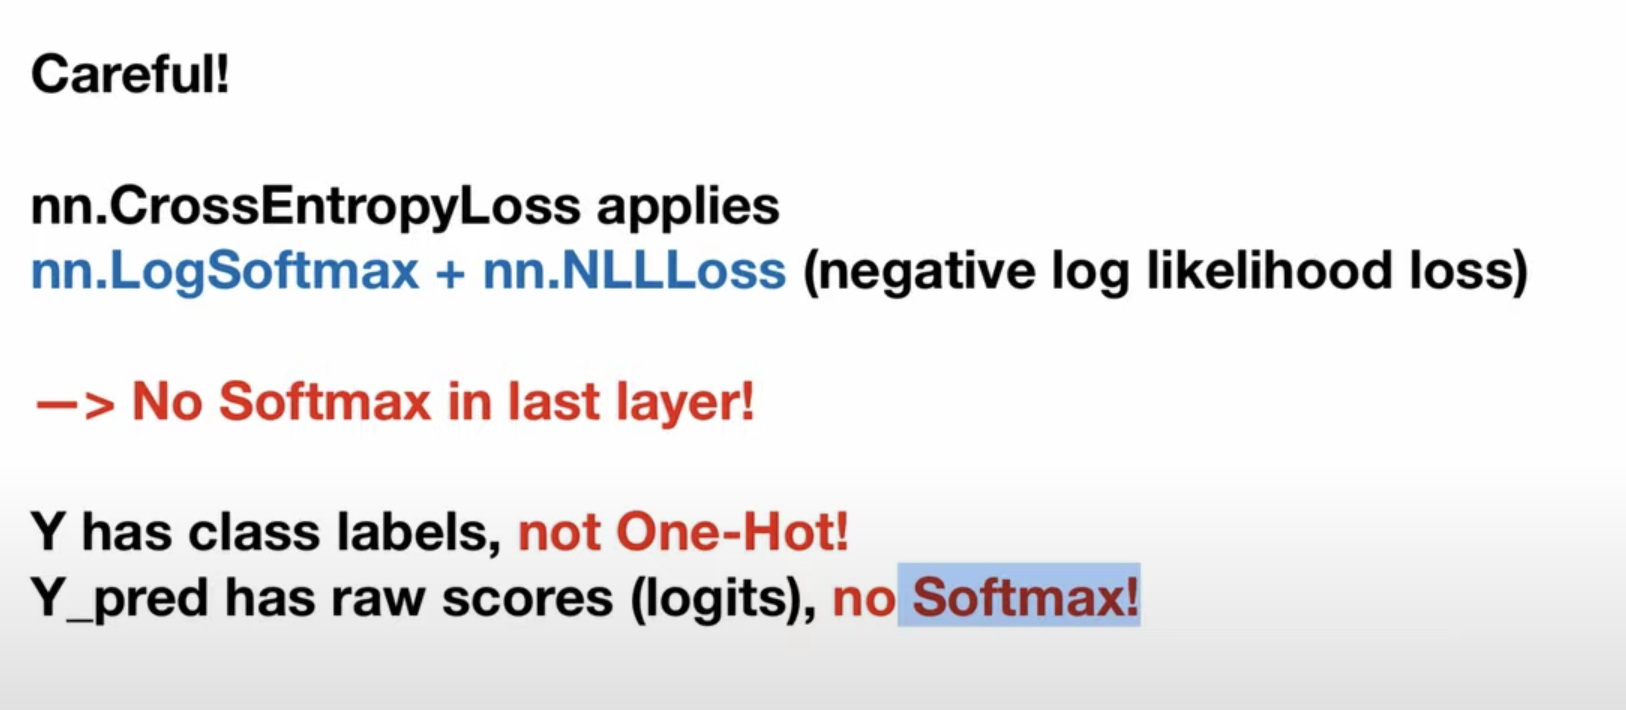
-
如果网络是多分类问题, 就是用
nn.CrossEntropyLoss()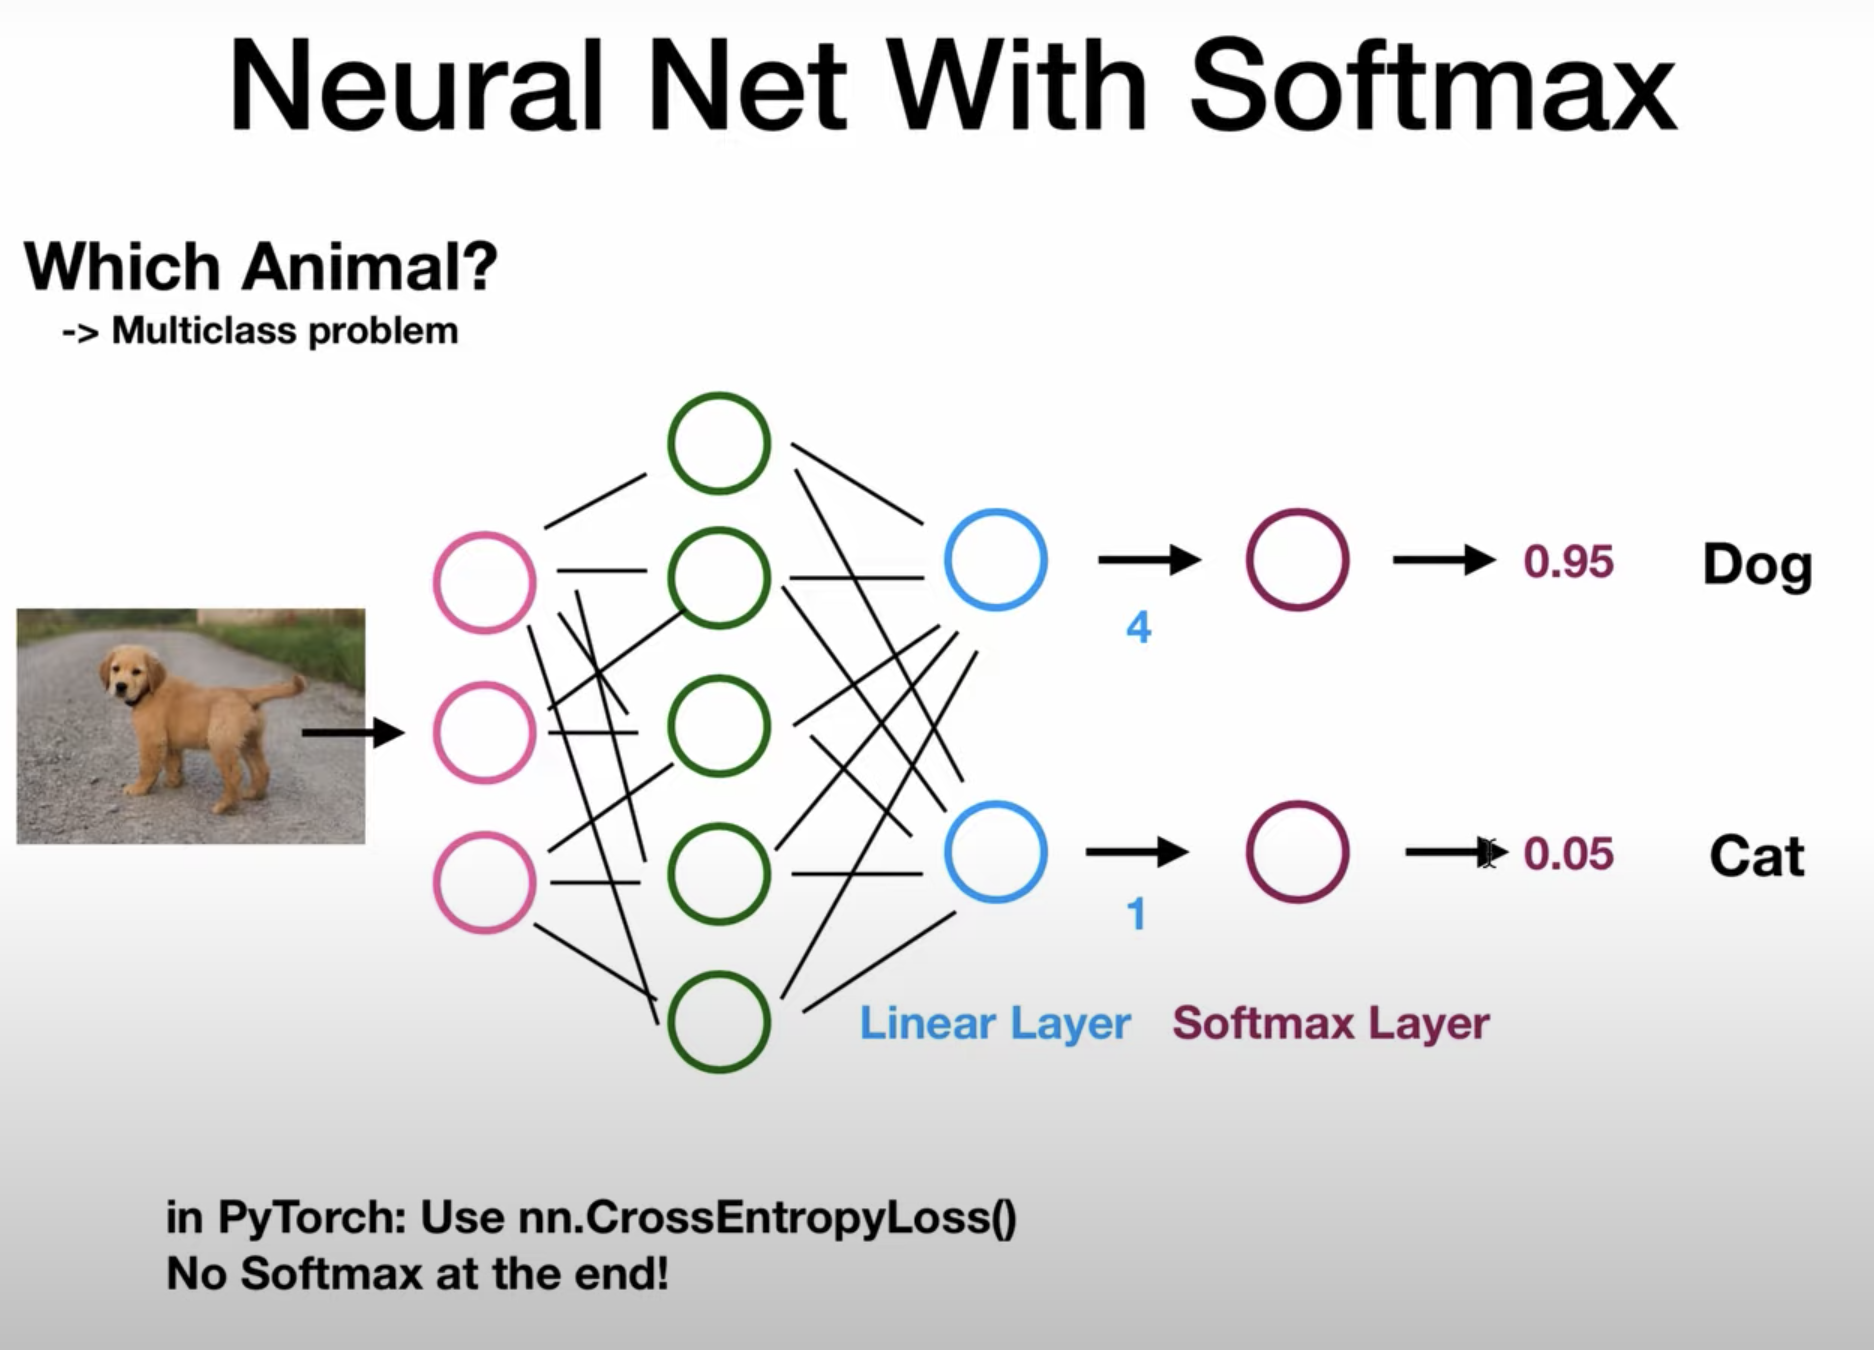
class NeuralNetMultiClass(nn.Module): def __init__(self, input_size, hidden_size, num_classes): super(NeuralNetMultiClass, self).__init__() self.linear1 = nn.Linear(input_size, hidden_size) # nn.Linear(in_features, out_features) self.relu = nn.ReLU() self.linear2 = nn.Linear(hidden_size, num_classes) def forward(self, x): out = self.linear1(x) out = self.relu(out) out = self.linear2(out) return out model = NeuralNetMultiClass(input_size=28*28, hidden_size=5, num_classes=3) criterion = nn.CrossEntropyLoss() -
如果网络是二分类问题, 就是用
nn.BCELoss(), 网络最后需要使用sigmoid函数.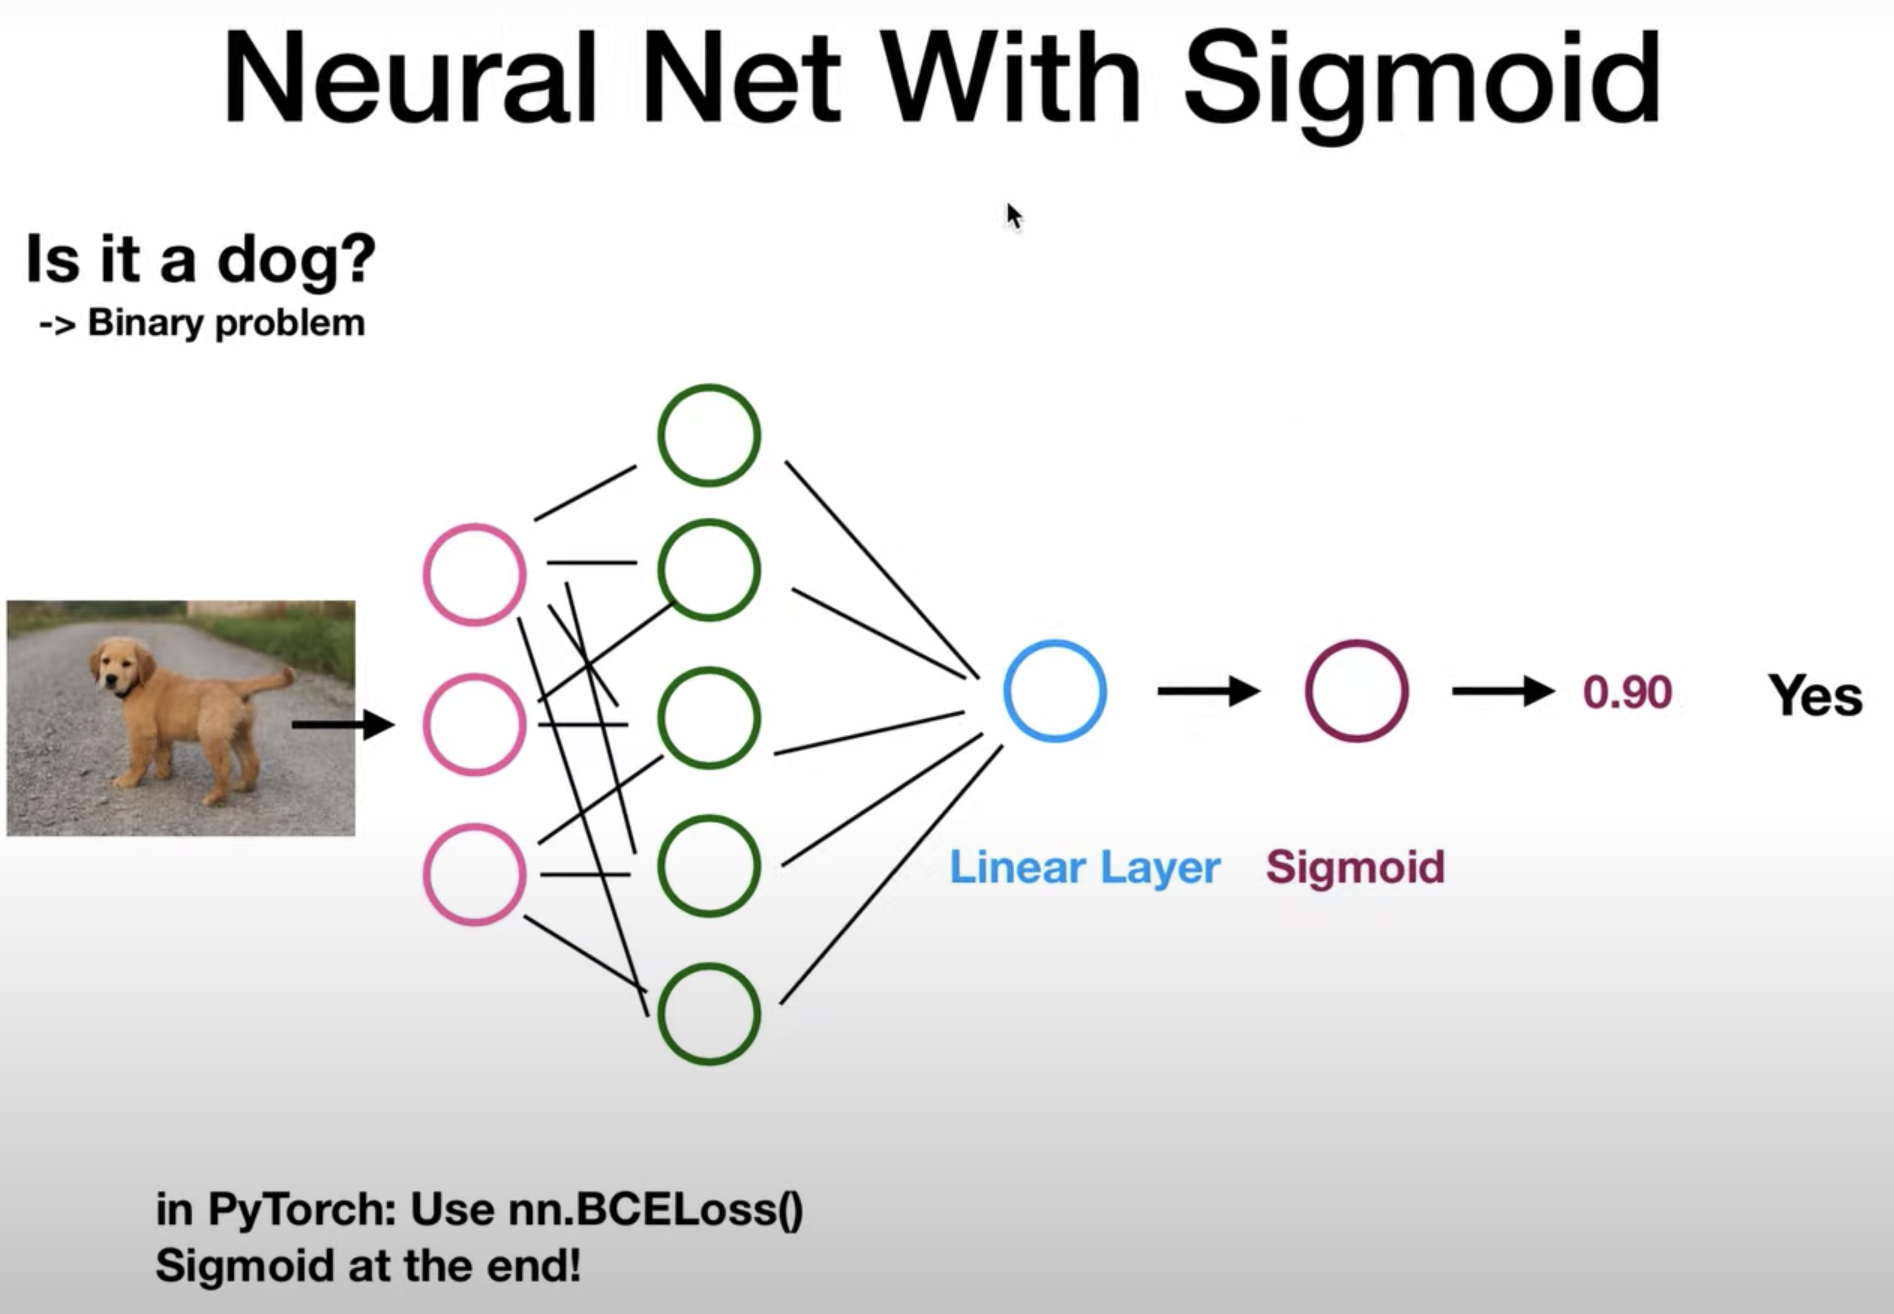
class NeuralNetSingleClass(nn.Module):
    def __init__(self, input_size, hidden_size):
        super(NeuralNetSingleClass, self).__init__()
        self.linear1 = nn.Linear(input_size, hidden_size)  # nn.Linear(in_features, out_features)
        self.relu = nn.ReLU()
        self.linear2 = nn.Linear(hidden_size, 1)

    def forward(self, x):
        out = self.linear1(x)
        out = self.relu(out)
        out = self.linear2(out)
        y_pred = torch.sigmoid(out)
        return y_pred

model = NeuralNetSingleClass(input_size=28*28, hidden_size=5)
criterion = nn.BCELoss()
11. Feed-Forward Neural Net
# -*- coding:utf-8 -*-
import matplotlib.pyplot as plt
import torch
import torch.nn as nn
import torchvision
import torchvision.transforms as transforms

device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
print(f'Training on the {device}...')
input_size = 784
hidden_size = 100
num_classes = 10
num_epochs = 15
batch_size = 128
lr = 0.001

train_dataset = torchvision.datasets.MNIST(root='./pytorchTutorial/data/', train=True, transform=transforms.ToTensor(),
                                           download=True)
test_dataset = torchvision.datasets.MNIST(root='./pytorchTutorial/data/', train=False, transform=transforms.ToTensor())
train_len = int(train_dataset.data.shape[0] * 0.9)
val_len = train_dataset.data.shape[0] - train_len
torch.manual_seed(0)
train_set, val_set = torch.utils.data.random_split(dataset=train_dataset, lengths=[train_len, val_len])
train_loader = torch.utils.data.DataLoader(dataset=train_set, batch_size=batch_size, shuffle=True)
val_loader = torch.utils.data.DataLoader(dataset=val_set, batch_size=batch_size, shuffle=True)
test_loader = torch.utils.data.DataLoader(dataset=test_dataset, batch_size=batch_size, shuffle=False)

examples = iter(train_loader)
samples, labels = examples.next()
print(samples.shape, labels.shape)

# for i in range(6):
#     plt.subplot(2, 3, i+1)
#     plt.imshow(samples[i][0], cmap='gray')
# plt.savefig('feed_forward.png')

class NeuralNetMultiClass(nn.Module):
    def __init__(self, input_size, hidden_size, num_classes):
        super(NeuralNetMultiClass, self).__init__()
        self.l1 = nn.Linear(input_size, hidden_size)
        self.relu = nn.ReLU()
        self.l2 = nn.Linear(hidden_size, num_classes)

    def forward(self, x):
        out = self.l1(x)
        out = self.relu(out)
        out = self.l2(out)
        return out

def validation_test(loaders, val_or_test, model_cur):
    """
    :param loaders:
    :param val_or_test: validation: 0; test: 1
    :return:
    """
    with torch.no_grad():
        n_correct = 0
        n_samples = 0
        for images, labels in loaders:
            images = images.reshape(-1, 28 * 28).to(device)
            labels = labels.to(device)
            outputs = model_cur(images)

            # value, index
            _, predictions = torch.max(outputs, 1)
            n_samples += labels.shape[0]
            if val_or_test == 0:
                n_correct += (predictions != labels).sum().item()
            else:
                n_correct += (predictions == labels).sum().item()
            # print(f'predictions: {predictions}; labels: {labels}')

        res = 100.0 * n_correct / n_samples
        # print(f'n_correct: {n_correct}; n_samples: {n_samples}')
        return res

model = NeuralNetMultiClass(input_size, hidden_size, num_classes).to(device)

# loss and optimizer
criterion = nn.CrossEntropyLoss()
optimizer = torch.optim.Adam(model.parameters(), lr=lr)

# training loop
n_total_steps = len(train_loader)
loss_list = []
val_loss_list = []
epoch_list = []
tmp_min_val_loss = 999
for epoch in range(num_epochs):
    for i, (images, labels) in enumerate(train_loader):
        # 100, 1, 28, 28
        # 100, 784
        images = images.reshape(-1, 28 * 28).to(device)
        labels = labels.to(device)

        # forward
        outputs = model(images)
        loss = criterion(outputs, labels)

        # backwards
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

        if (i + 1) % 100 == 0:
            val_loss = validation_test(val_loader, 0, model)

            # print(f'epoch {epoch + 1}/{num_epochs}, step {i + 1}/{n_total_steps}, loss {loss.item():.4f}')
            loss_list.append(loss.item())
            val_loss_list.append(val_loss)
            if tmp_min_val_loss > val_loss:
                tmp_min_val_loss = val_loss
                torch.save(model.state_dict(), 'feed_forward_model_weights.pt')
                print(
                    f'epoch {epoch + 1}/{num_epochs}, step {i + 1}/{n_total_steps}, loss {loss.item():.4f}, val_loss {val_loss:.4f}')
for i in range(int(num_epochs * (n_total_steps // 100))):
    epoch_list.append(i + 1)

del model

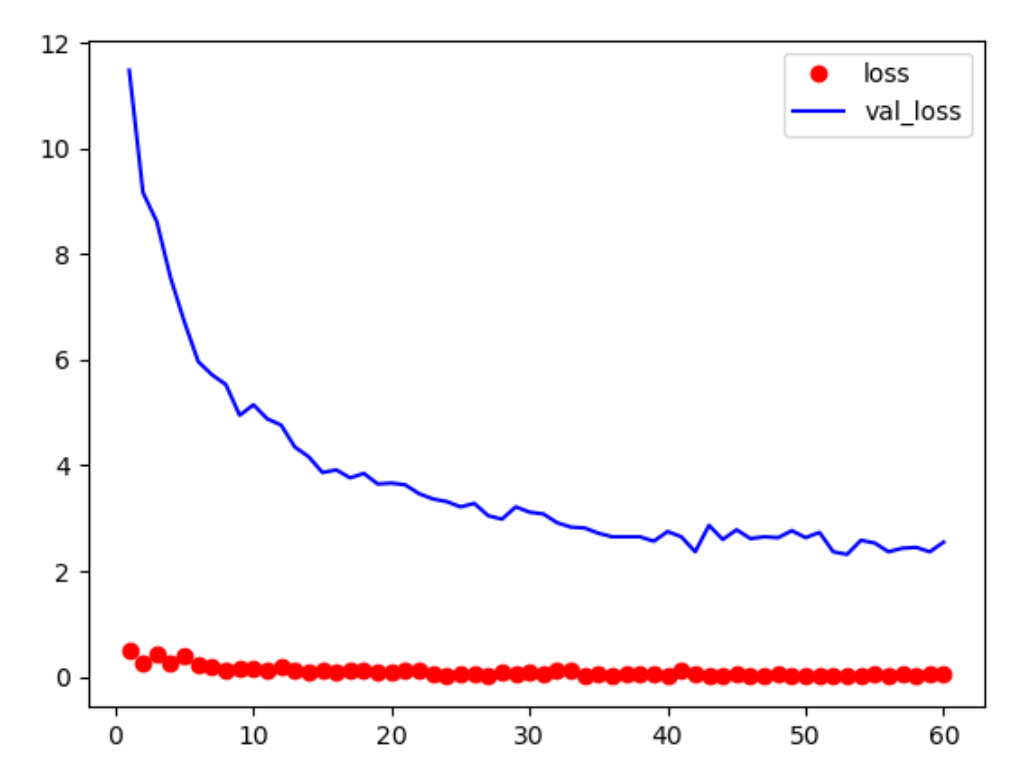
plt.plot(epoch_list, loss_list, 'ro', label='loss')
plt.plot(epoch_list, val_loss_list, 'b-', label='val_loss')
plt.legend()
plt.savefig('feed_forward_loss_val.png')

# test
model_load = NeuralNetMultiClass(input_size, hidden_size, num_classes).to(device)
model_load.load_state_dict(torch.load('feed_forward_model_weights.pt'))

acc = validation_test(test_loader, 1, model_load)
print(f'accuracy: {acc:.4f}')
Training on the cuda...
torch.Size([128, 1, 28, 28]) torch.Size([128])
epoch 1/15, step 100/422, loss 0.4841, val_loss 11.4833
epoch 1/15, step 200/422, loss 0.2547, val_loss 9.1667
epoch 1/15, step 300/422, loss 0.4167, val_loss 8.6167
epoch 1/15, step 400/422, loss 0.2693, val_loss 7.5500
epoch 2/15, step 100/422, loss 0.4004, val_loss 6.7167
...
epoch 10/15, step 300/422, loss 0.0457, val_loss 2.5667
epoch 11/15, step 200/422, loss 0.0541, val_loss 2.3667
epoch 14/15, step 100/422, loss 0.0326, val_loss 2.3167
accuracy: 97.7200

Process finished with exit code 0
12. Convolutional Neural Net (CNN)
# -*- coding:utf-8 -*-

import torch
import torch.nn as nn
import torch.nn.functional as F
import torchvision
import torchvision.transforms as transforms
import matplotlib.pyplot as plt
import numpy as np

# Device configuration
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')

# Hyper-parameters
num_epochs = 5
batch_size = 4
learning_rate = 0.001

# dataset has PILImage images of range [0, 1].
# We transform them to Tensors of normalized range [-1, 1]
transform = transforms.Compose([transforms.ToTensor(), transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))])

# CIFAR10: 60000 32x32 color images in 10 classes, with 6000 images per class
train_dataset = torchvision.datasets.CIFAR10(root='./data', train=True, download=True, transform=transform)
test_dataset = torchvision.datasets.CIFAR10(root='./data', train=False, download=True, transform=transform)
train_loader = torch.utils.data.DataLoader(train_dataset, batch_size=batch_size, shuffle=True)
test_loader = torch.utils.data.DataLoader(test_dataset, batch_size=batch_size, shuffle=False)

classes = ('plane', 'car', 'bird', 'cat', 'deer', 'dog', 'frog', 'horse', 'ship', 'truck')

# def imshow(img):
#     img = img / 2 + 0.5  # unnormalize
#     npimg = img.numpy()
#     plt.imshow(np.transpose(npimg, (1, 2, 0)))
#     plt.show()
#
#
# # get some random training images
# dataiter = iter(train_loader)
# images, labels = dataiter.next()
#
# # show images
# imshow(torchvision.utils.make_grid(images))

class ConvNet(nn.Module):
    def __init__(self):
        super(ConvNet, self).__init__()
        self.conv1 = nn.Conv2d(3, 6, 5)
        self.pool = nn.MaxPool2d(2, 2)
        self.conv2 = nn.Conv2d(6, 16, 5)
        self.fc1 = nn.Linear(16 * 5 * 5, 120)
        self.fc2 = nn.Linear(120, 84)
        self.fc3 = nn.Linear(84, 10)

    def forward(self, x):
        # -> n, 3, 32, 32
        x = self.pool(F.relu(self.conv1(x)))  # -> n, 6, 14, 14
        x = self.pool(F.relu(self.conv2(x)))  # -> n, 16, 5, 5
        x = x.view(-1, 16 * 5 * 5)  # -> n, 400
        x = F.relu(self.fc1(x))  # -> n, 120
        x = F.relu(self.fc2(x))  # -> n, 84
        x = self.fc3(x)  # -> n, 10
        return x

model = ConvNet().to(device)

criterion = nn.CrossEntropyLoss()
optimizer = torch.optim.SGD(model.parameters(), lr=learning_rate)

n_total_steps = len(train_loader)
for epoch in range(num_epochs):
    for i, (images, labels) in enumerate(train_loader):
        # origin shape: [4, 3, 32, 32] = 4, 3, 1024
        # input_layer: 3 input channels, 6 output channels, 5 kernel size
        images = images.to(device)
        labels = labels.to(device)

        # Forward pass
        outputs = model(images)
        loss = criterion(outputs, labels)

        # Backward and optimize
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

        if (i + 1) % 2000 == 0:
            print(f'Epoch [{epoch + 1}/{num_epochs}], Step [{i + 1}/{n_total_steps}], Loss: {loss.item():.4f}')

print('Finished Training')
PATH = './cnn.pth'
torch.save(model.state_dict(), PATH)

with torch.no_grad():
    n_correct = 0
    n_samples = 0
    n_class_correct = [0 for i in range(10)]
    n_class_samples = [0 for i in range(10)]
    for images, labels in test_loader:
        images = images.to(device)
        labels = labels.to(device)
        outputs = model(images)
        # max returns (value ,index)
        _, predicted = torch.max(outputs, 1)
        n_samples += labels.size(0)
        n_correct += (predicted == labels).sum().item()

        for i in range(batch_size):
            label = labels[i]
            pred = predicted[i]
            if (label == pred):
                n_class_correct[label] += 1
            n_class_samples[label] += 1

    acc = 100.0 * n_correct / n_samples
    print(f'Accuracy of the network: {acc} %')

    for i in range(10):
        acc = 100.0 * n_class_correct[i] / n_class_samples[i]
        print(f'Accuracy of {classes[i]}: {acc} %')
13. Transfer Learning
# -*- coding:utf-8 -*-
import torch
import torch.nn as nn
import torch.optim as optim
from torch.optim import lr_scheduler
import numpy as np
import torchvision
from torchvision import datasets, models, transforms
import matplotlib.pyplot as plt
import time
import os
import copy

mean = np.array([0.5, 0.5, 0.5])
std = np.array([0.25, 0.25, 0.25])

data_transforms = {
    'train': transforms.Compose([
        transforms.RandomResizedCrop(224),
        transforms.RandomHorizontalFlip(),
        transforms.ToTensor(),
        transforms.Normalize(mean, std)
    ]),
    'val': transforms.Compose([
        transforms.Resize(256),
        transforms.CenterCrop(224),
        transforms.ToTensor(),
        transforms.Normalize(mean, std)
    ]),
}

data_dir = 'data/hymenoptera_data'
image_datasets = {x: datasets.ImageFolder(os.path.join(data_dir, x),
                                          data_transforms[x])
                  for x in ['train', 'val']}
dataloaders = {x: torch.utils.data.DataLoader(image_datasets[x], batch_size=4,
                                             shuffle=True, num_workers=0)
              for x in ['train', 'val']}
dataset_sizes = {x: len(image_datasets[x]) for x in ['train', 'val']}
class_names = image_datasets['train'].classes

device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
print(class_names)

def imshow(inp, title):
    """Imshow for Tensor."""
    inp = inp.numpy().transpose((1, 2, 0))
    inp = std * inp + mean
    inp = np.clip(inp, 0, 1)
    plt.imshow(inp)
    plt.title(title)
    plt.show()

# Get a batch of training data
inputs, classes = next(iter(dataloaders['train']))

# Make a grid from batch
out = torchvision.utils.make_grid(inputs)

imshow(out, title=[class_names[x] for x in classes])

def train_model(model, criterion, optimizer, scheduler, num_epochs=25):
    since = time.time()

    best_model_wts = copy.deepcopy(model.state_dict())
    best_acc = 0.0

    for epoch in range(num_epochs):
        print('Epoch {}/{}'.format(epoch, num_epochs - 1))
        print('-' * 10)

        # Each epoch has a training and validation phase
        for phase in ['train', 'val']:
            if phase == 'train':
                model.train()  # Set model to training mode
            else:
                model.eval()   # Set model to evaluate mode

            running_loss = 0.0
            running_corrects = 0

            # Iterate over data.
            for inputs, labels in dataloaders[phase]:
                inputs = inputs.to(device)
                labels = labels.to(device)

                # forward
                # track history if only in train
                with torch.set_grad_enabled(phase == 'train'):
                    outputs = model(inputs)
                    _, preds = torch.max(outputs, 1)
                    loss = criterion(outputs, labels)

                    # backward + optimize only if in training phase
                    if phase == 'train':
                        optimizer.zero_grad()
                        loss.backward()
                        optimizer.step()

                # statistics
                running_loss += loss.item() * inputs.size(0)
                running_corrects += torch.sum(preds == labels.data)

            if phase == 'train':
                scheduler.step()

            epoch_loss = running_loss / dataset_sizes[phase]
            epoch_acc = running_corrects.double() / dataset_sizes[phase]

            print('{} Loss: {:.4f} Acc: {:.4f}'.format(
                phase, epoch_loss, epoch_acc))

            # deep copy the model
            if phase == 'val' and epoch_acc > best_acc:
                best_acc = epoch_acc
                best_model_wts = copy.deepcopy(model.state_dict())

        print()

    time_elapsed = time.time() - since
    print('Training complete in {:.0f}m {:.0f}s'.format(
        time_elapsed // 60, time_elapsed % 60))
    print('Best val Acc: {:4f}'.format(best_acc))

    # load best model weights
    model.load_state_dict(best_model_wts)
    return model

#### Finetuning the convnet ####
# Load a pretrained model and reset final fully connected layer.

model = models.resnet18(pretrained=True)
num_ftrs = model.fc.in_features
# Here the size of each output sample is set to 2.
# Alternatively, it can be generalized to nn.Linear(num_ftrs, len(class_names)).
model.fc = nn.Linear(num_ftrs, 2)

model = model.to(device)

criterion = nn.CrossEntropyLoss()

# Observe that all parameters are being optimized
optimizer = optim.SGD(model.parameters(), lr=0.001)

# StepLR Decays the learning rate of each parameter group by gamma every step_size epochs
# Decay LR by a factor of 0.1 every 7 epochs
# Learning rate scheduling should be applied after optimizer’s update
# e.g., you should write your code this way:
# for epoch in range(100):
#     train(...)
#     validate(...)
#     scheduler.step()

step_lr_scheduler = lr_scheduler.StepLR(optimizer, step_size=7, gamma=0.1)

model = train_model(model, criterion, optimizer, step_lr_scheduler, num_epochs=25)

#### ConvNet as fixed feature extractor ####
# Here, we need to freeze all the network except the final layer.
# We need to set requires_grad == False to freeze the parameters so that the gradients are not computed in backward()
model_conv = torchvision.models.resnet18(pretrained=True)
for param in model_conv.parameters():
    param.requires_grad = False

# Parameters of newly constructed modules have requires_grad=True by default
num_ftrs = model_conv.fc.in_features
model_conv.fc = nn.Linear(num_ftrs, 2)

model_conv = model_conv.to(device)

criterion = nn.CrossEntropyLoss()

# Observe that only parameters of final layer are being optimized as
# opposed to before.
optimizer_conv = optim.SGD(model_conv.fc.parameters(), lr=0.001, momentum=0.9)

# Decay LR by a factor of 0.1 every 7 epochs
exp_lr_scheduler = lr_scheduler.StepLR(optimizer_conv, step_size=7, gamma=0.1)

model_conv = train_model(model_conv, criterion, optimizer_conv,
                         exp_lr_scheduler, num_epochs=25)
14. Tensorboard
-
启动tensorboard
MAC终端连接ssh,将服务器的6006端口(或者其他没有被占用的端口都行,比如6007…)重定向到自己机器上来,在本地终端,输入以下命令:
ssh -L 16006:127.0.0.1:6006 username@remote_server_ip说明:16006:127.0.0.1代表自己机器上的16006号端口(这个端口号应该也是自己改的,只要是本地没有被占用的就可以),6006(或者其他服务器上没有被占用)是服务器上tensorboard使用的端口。username指的是服务器的用户名;remote_server_ip指的是服务器的IP。
在服务器终端输入以下命令: 需要在工程文件夹下执行
tensorboard --logdir=runs --port=6006 --load_fast=false在本地浏览器输入以下地址便可访问: 127.0.0.1:16006/
-
code
-
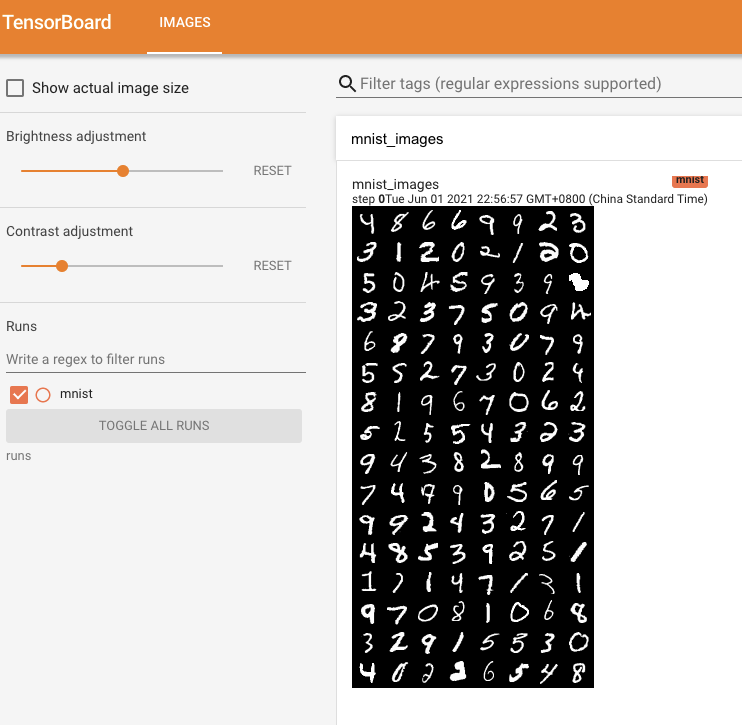
show image
from torch.utils.tensorboard import SummaryWriter
writer = SummaryWriter('runs/mnist')
...
examples = iter(train_loader)
samples, labels = examples.next()
print(samples.shape, labels.shape)

for i in range(6):
    plt.subplot(2, 3, i+1)
    plt.imshow(samples[i][0], cmap='gray')
# plt.savefig('feed_forward.png')
img_grid = torchvision.utils.make_grid(samples)
writer.add_image("mnist_images", img_grid)
writer.close()
sys.exit()
...
-
show model graph
model = NeuralNetMultiClass(input_size, hidden_size, num_classes).to(device)

# loss and optimizer
criterion = nn.CrossEntropyLoss()
optimizer = torch.optim.Adam(model.parameters(), lr=lr)

**writer.add_graph(model, samples.reshape(-1, 28*28).to(device))**
writer.close()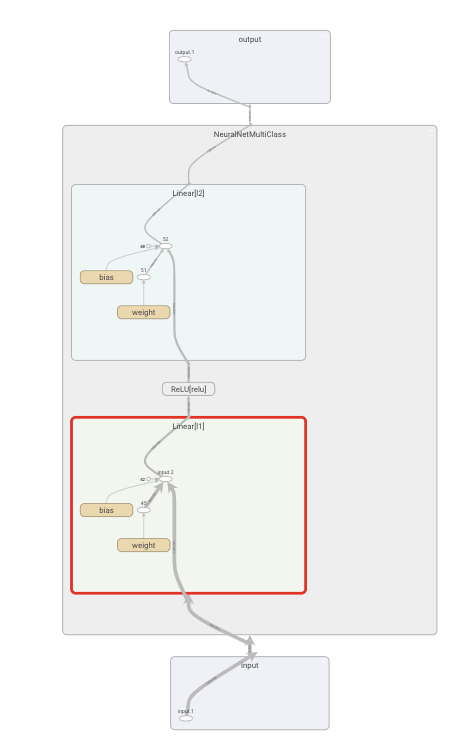
-
show loss
running_loss = 0.0
running_correct = 0

for epoch in range(num_epochs):
    for i, (images, labels) in enumerate(train_loader):
        # 100, 1, 28, 28
        # 100, 784
        images = images.reshape(-1, 28 * 28).to(device)
        labels = labels.to(device)

        # forward
        outputs = model(images)
        loss = criterion(outputs, labels)

        # backwards
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

        # tensorboard show loss
        running_loss += loss.item()
        _, predicted = torch.max(outputs.data, 1)
        running_correct += (predicted == labels).sum().item()

        if (i + 1) % 100 == 0:
            val_loss = validation_test(val_loader, 0, model)

            # print(f'epoch {epoch + 1}/{num_epochs}, step {i + 1}/{n_total_steps}, loss {loss.item():.4f}')
            loss_list.append(loss.item())
            val_loss_list.append(val_loss)
            if tmp_min_val_loss > val_loss:
                tmp_min_val_loss = val_loss
                torch.save(model.state_dict(), 'feed_forward_model_weights.pt')
                print(
                    f'epoch {epoch + 1}/{num_epochs}, step {i + 1}/{n_total_steps}, loss {loss.item():.4f}, val_loss {val_loss:.4f}')

            writer.add_scalar('training loss', running_loss/100, epoch*n_total_steps+i)
            writer.add_scalar('acc', running_correct / 100, epoch * n_total_steps + i)
            running_loss = 0.0
            running_correct = 0
-
15. Save and Load Models
# save
torch.save(model.state_dict(), 'model.pt')
# del model
...
#load
model_load = NeuralNetMultiClass(input_size, hidden_size, num_classes).to(device)
model_load.load_state_dict(torch.load('model.pt'))
model_load.eval()

# test
acc = validation_test(test_loader, 1, model_load)
print(f'accuracy: {acc:.4f}')
-
model.eval()的作用
-
有些model中存在dropout layers或BatchNorm layers, 这些layers在evaluation的时候是不使用的, eval()函数可以关闭这些layers.
-
eval()在validation和test时都不会进行梯度下降.(无需使用torch.no_grad())
-
如果之后还需要训练, 使用train()函数.
# training step
...
model.train()
...
-
-
查看model权重
# model = torch.save(FILE)
# model = torch.load(FILE)  使用state_dict() load_state_dict()显示更详细
# model.eval()
for param in model_load.parameters():
    print(param)