可行性分析
-
根据需求和调研,目前最佳的的方案的研究方向为:使用多个单目相机拍摄的照片实时获取3D人体姿态估计结果(multi-view 3D HPE)。不过,多视角的3D HPE可能无法达到50fps的效果。
-
其他可行的方案是单一单目相机拍摄的照片进行多人3D HPE(single-view 3D MHPE),并使用bottom-up方法(预测耗时更少)或top-down方法(精度更高),相对于前者,可能遇到人体遮挡问题,但是对于数据的要求更低、消耗的计算资源更低。
-
可使用的数据集,所有数据集整理在:https://github.com/zczcwh/DL-HPE
-
可使用的模型
-
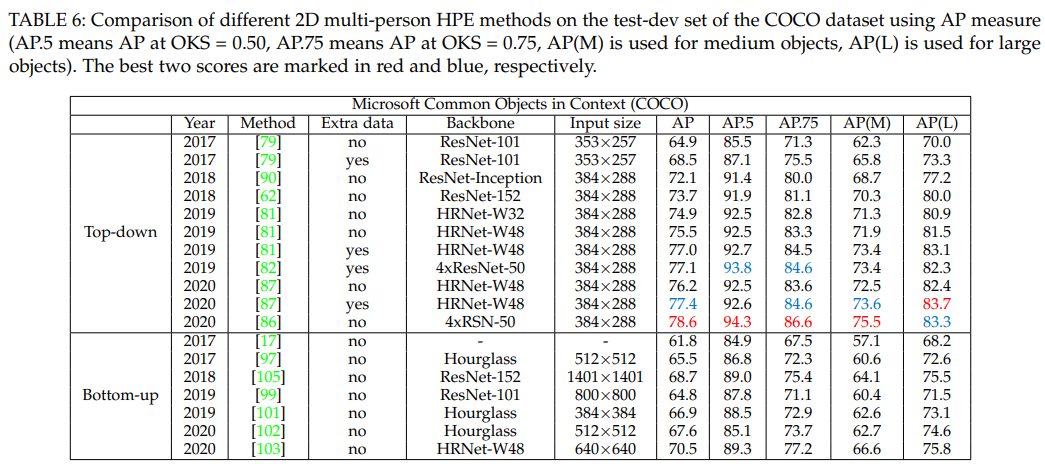
模型精度和选用的数据集
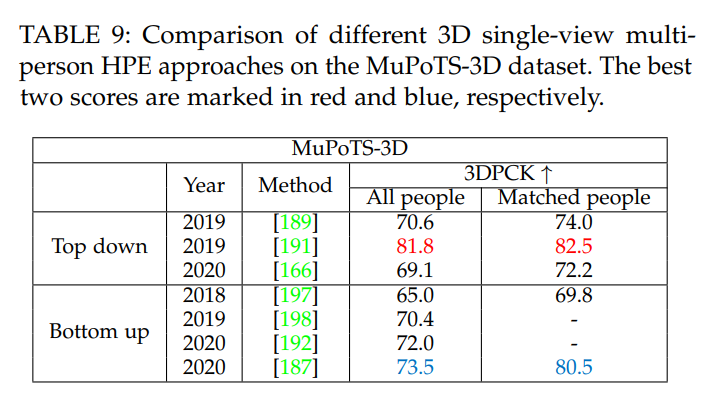
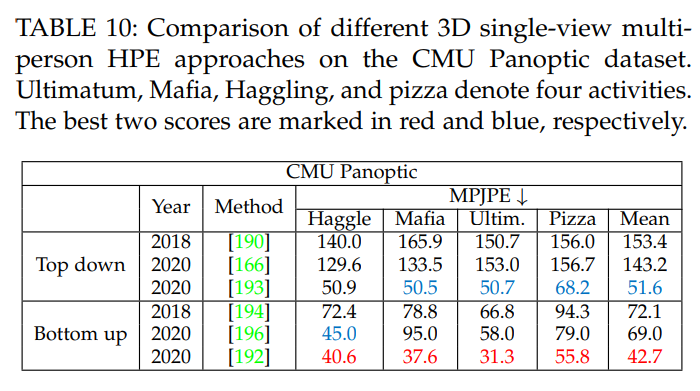
-
-
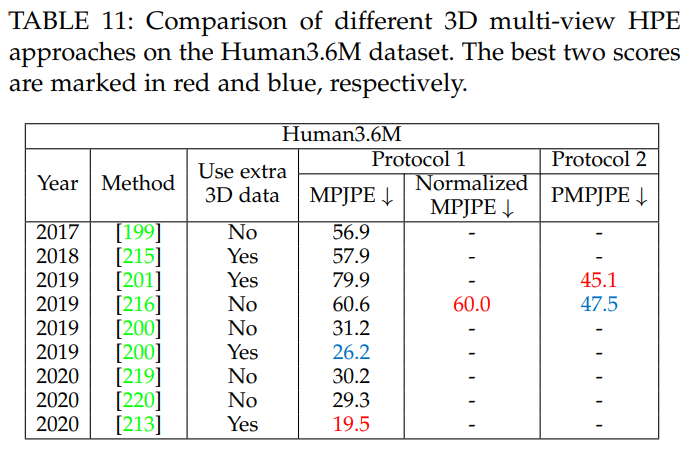
人体姿态估计研究调研
人体模型(Human Body Modaling)
-
人体模型被用来表现从图片或视频中抽出的关键点(keypoints)和特征(features)。
-
主要的人体模型有3种:
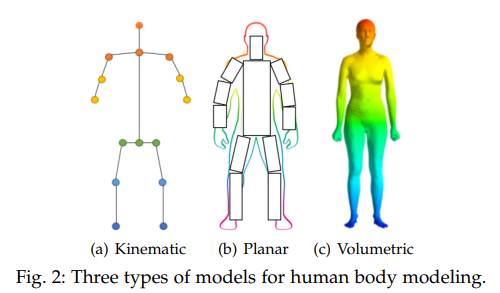
- 运动学模型(Kinematic model;用于2D/3D HPE)
- 用一组关节位置和四肢方向来表示人体结构
- 用于捕捉不同身体部位之间的关系
- 缺点是无法表现人体材质和形状
- 平面模型(Planar model;用于2D HPE)
- 用于近似表示人体的外观和形状
- 无法表现材质
- 体积模型(Volumetric model;用于3D HPE)
- 存在多种流行的 3D 人体模型
- 可表现人体材质和形状
- 运动学模型(Kinematic model;用于2D/3D HPE)
人体姿态估计(Human Pose Estimation)
看完这篇AI算法和笔记,跟面试官扯皮没问题了 | 基于深度学习和传统算法的人体姿态估计-CSDN博客
目前的人体姿态估计(HPE)研究分为两种:
-
2D HPE:从RGB图像估计每个关节的2D Pose(x,y)坐标。
- 优点:
- 精确度相对于3D HPE更高
- 更容易实现并且不需要特殊设备
- 缺点:只能表现人体在一个平面上的姿势,没有前后的位置信息
- 难点:
- 数据量不足
- 深度模糊性问题
- 人体被遮挡问题
- 研究分支:
-
单人姿态估计,有两种基于深度学习的方法
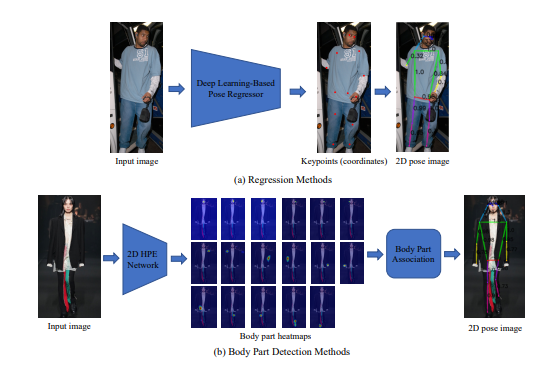
- regession methods:通过使用基于深度学习的回归器直接构建从输入图像到身体关节坐标的映射。
- body part detection methods:分两步
- 为身体部位定位生成关键点(即关节)的热图(heat map)
- 将这些检测到的关键点组装成人体姿态或骨架
-
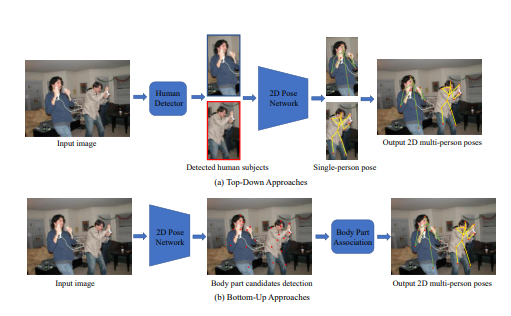
多人姿态估计,也有两种基于深度学习的方法
-
top-down methods:
-
检测人体,将多人图片分成单人图片
-
为每个人使用单人姿态估计预测每个人的关键点(keypoints)
-
精度比bottom-up methods更高
被遮挡的人体无法被检测
-
-
bottom-up methods:
- 检测所有人体的关键点
- 将关键点组成每一个人体的姿势
- 速度比top-down methods更快, 检测时间不会随着人数的增加而增加
网络结构
对于一张输入图像,深度神经网络同时预测出每个骨点的热力图S=(S1,S2,…,SJ)和骨点之间的亲和区域L=(L1,L2,…,LC) 。
热力图的峰值为骨点的位置,骨点相互连接构成二分图,亲和区域对图的连接进行稀疏,最后对二分图进行最优化实现多人姿态估计。
MMPose
hrnet识别
- 这种架构相对于其他架构的一个优点是, 神经网络在估计姿势时保持高分辨率表示.
-
用一个并行卷积流的方法, 从第一阶段开始逐步逐个添加高分辨率到低分辨率的流.
-
后一个阶段的并行流的分辨率由前一个阶段的分辨率和更低分辨率组成
-
最后将所有的特征图上采样到对应64*48的尺寸, 相加融合
-
网络的输出尺寸是 $64*48*n_{keypoint}$
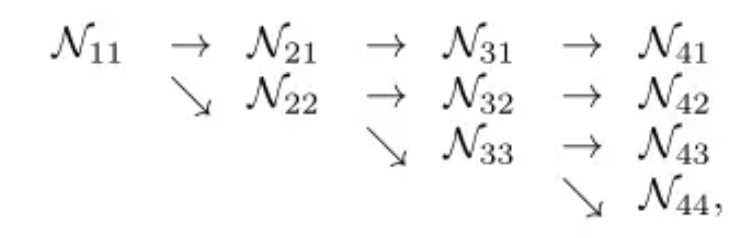
-
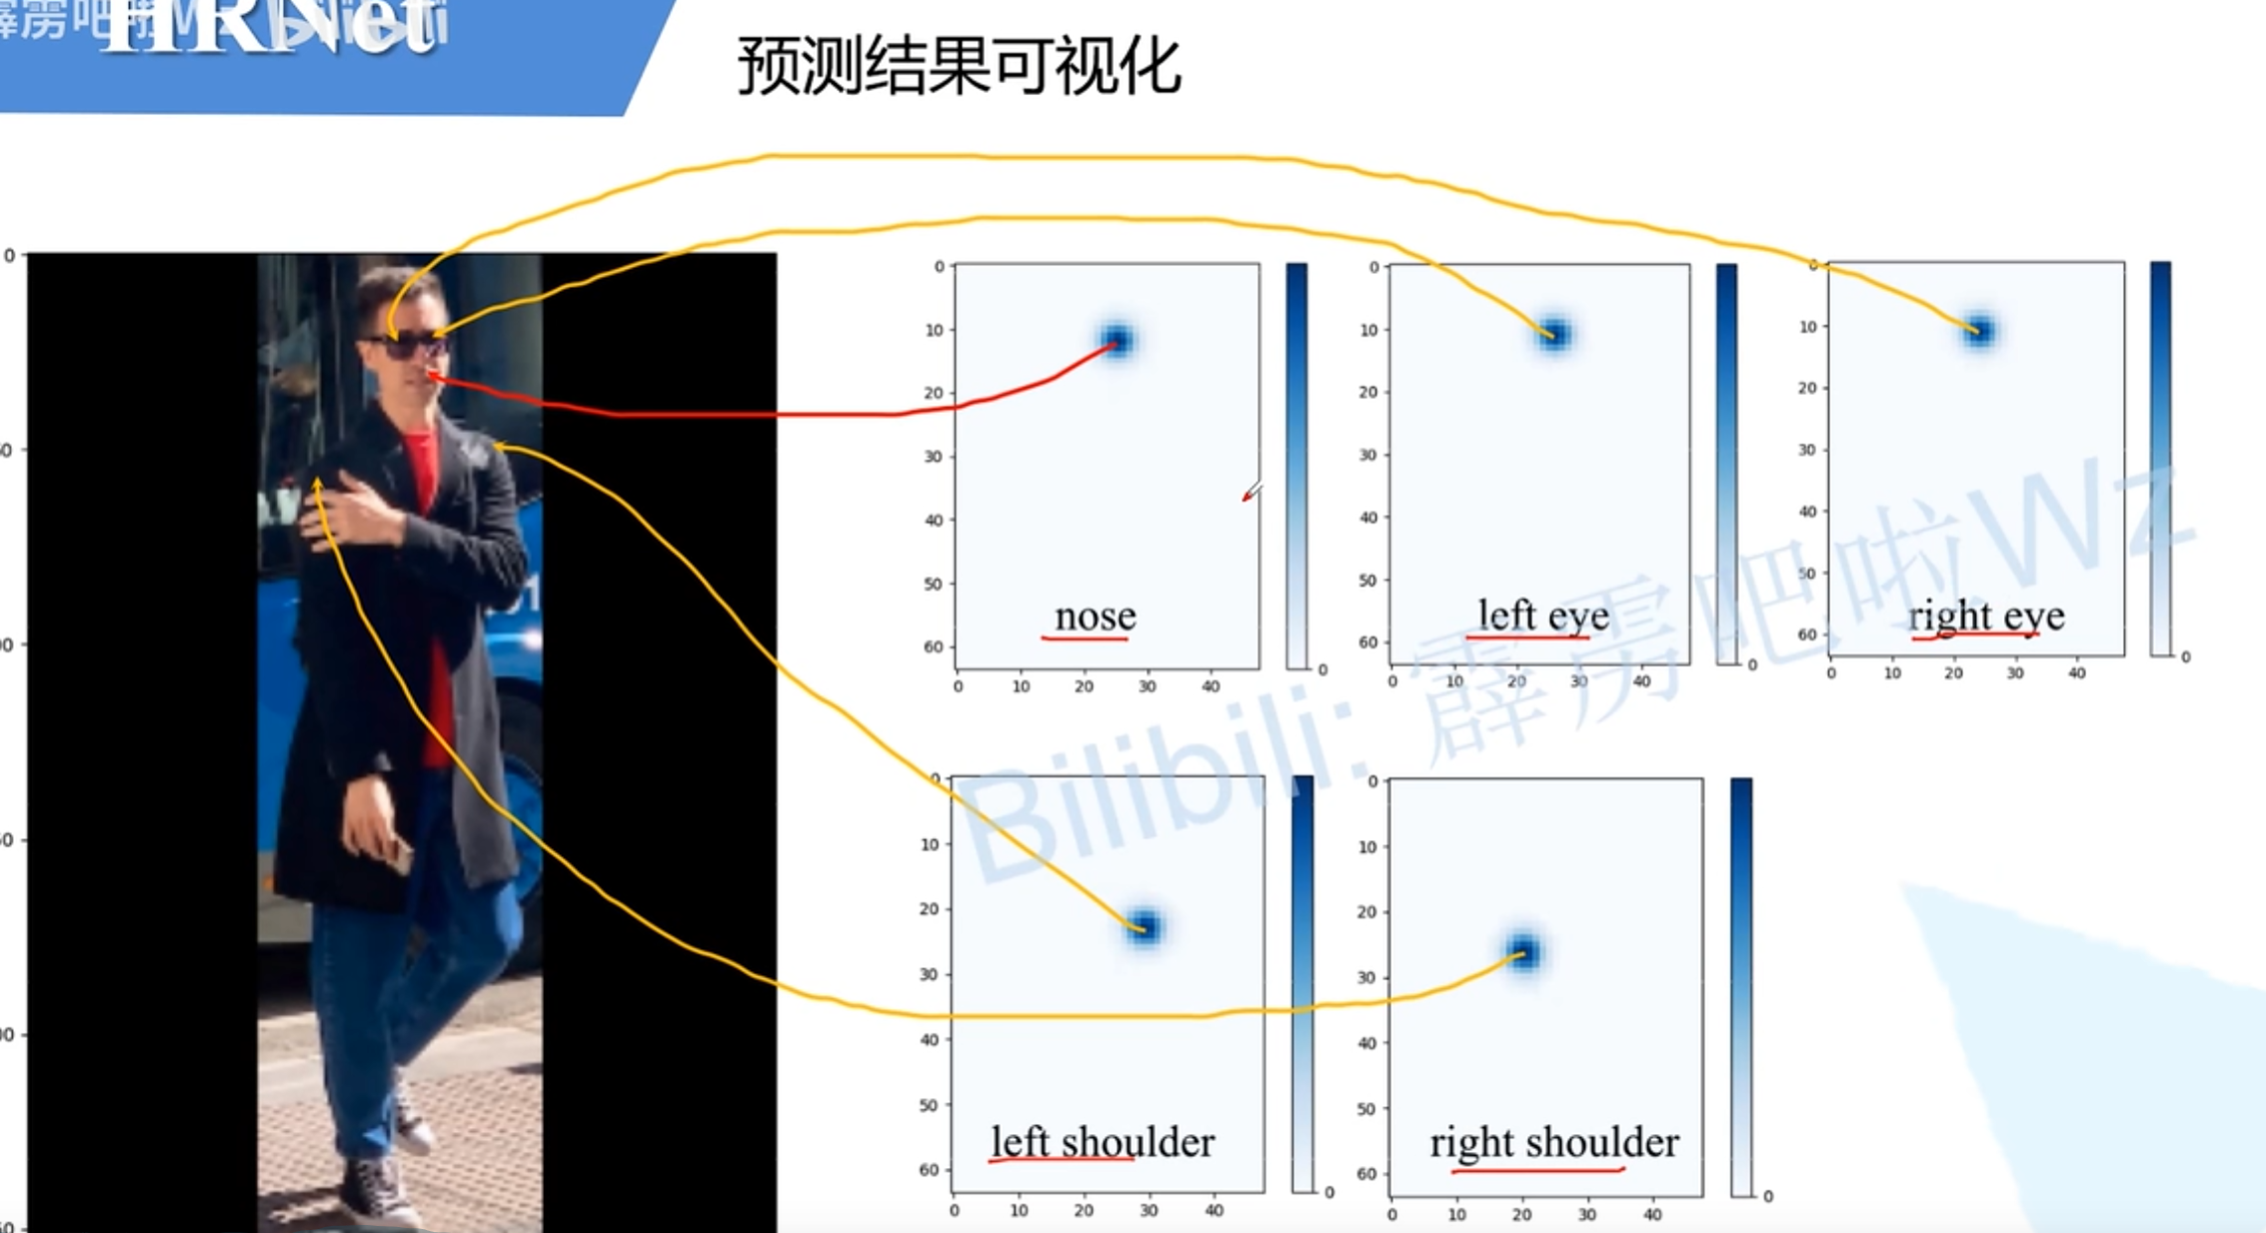
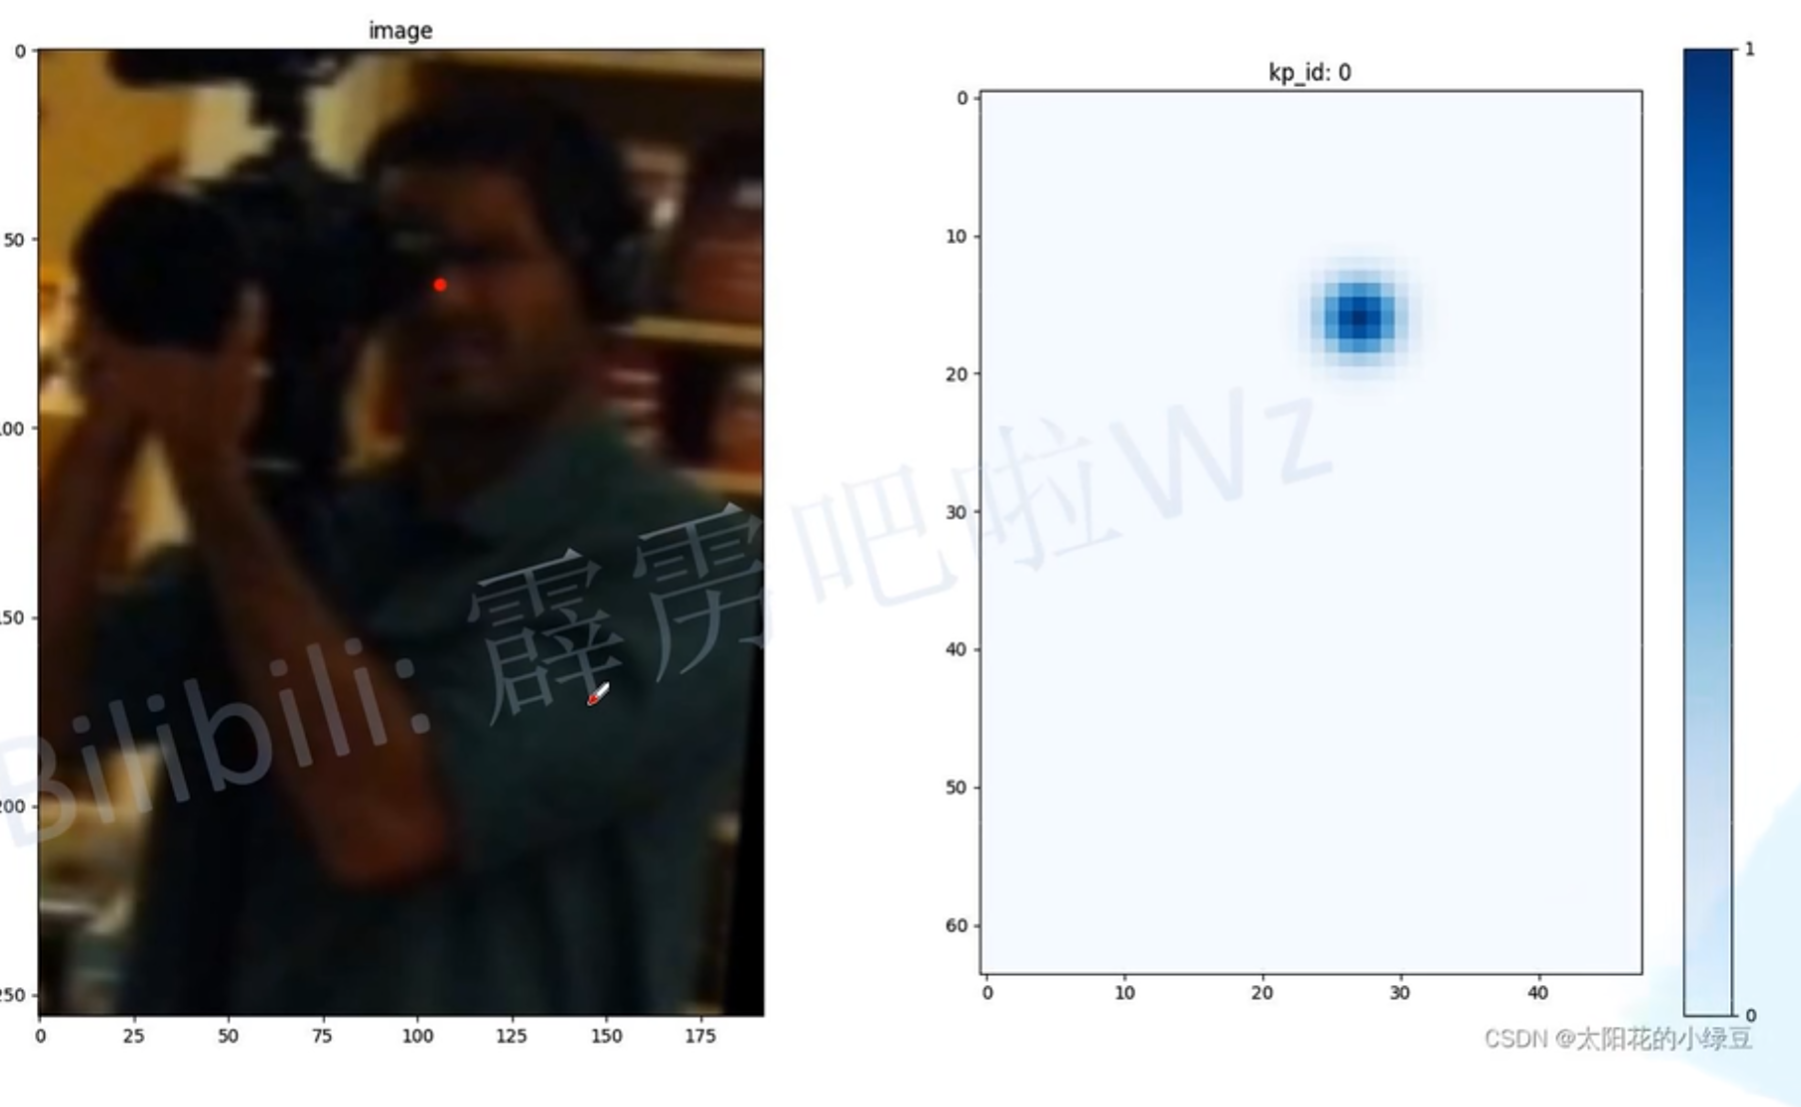
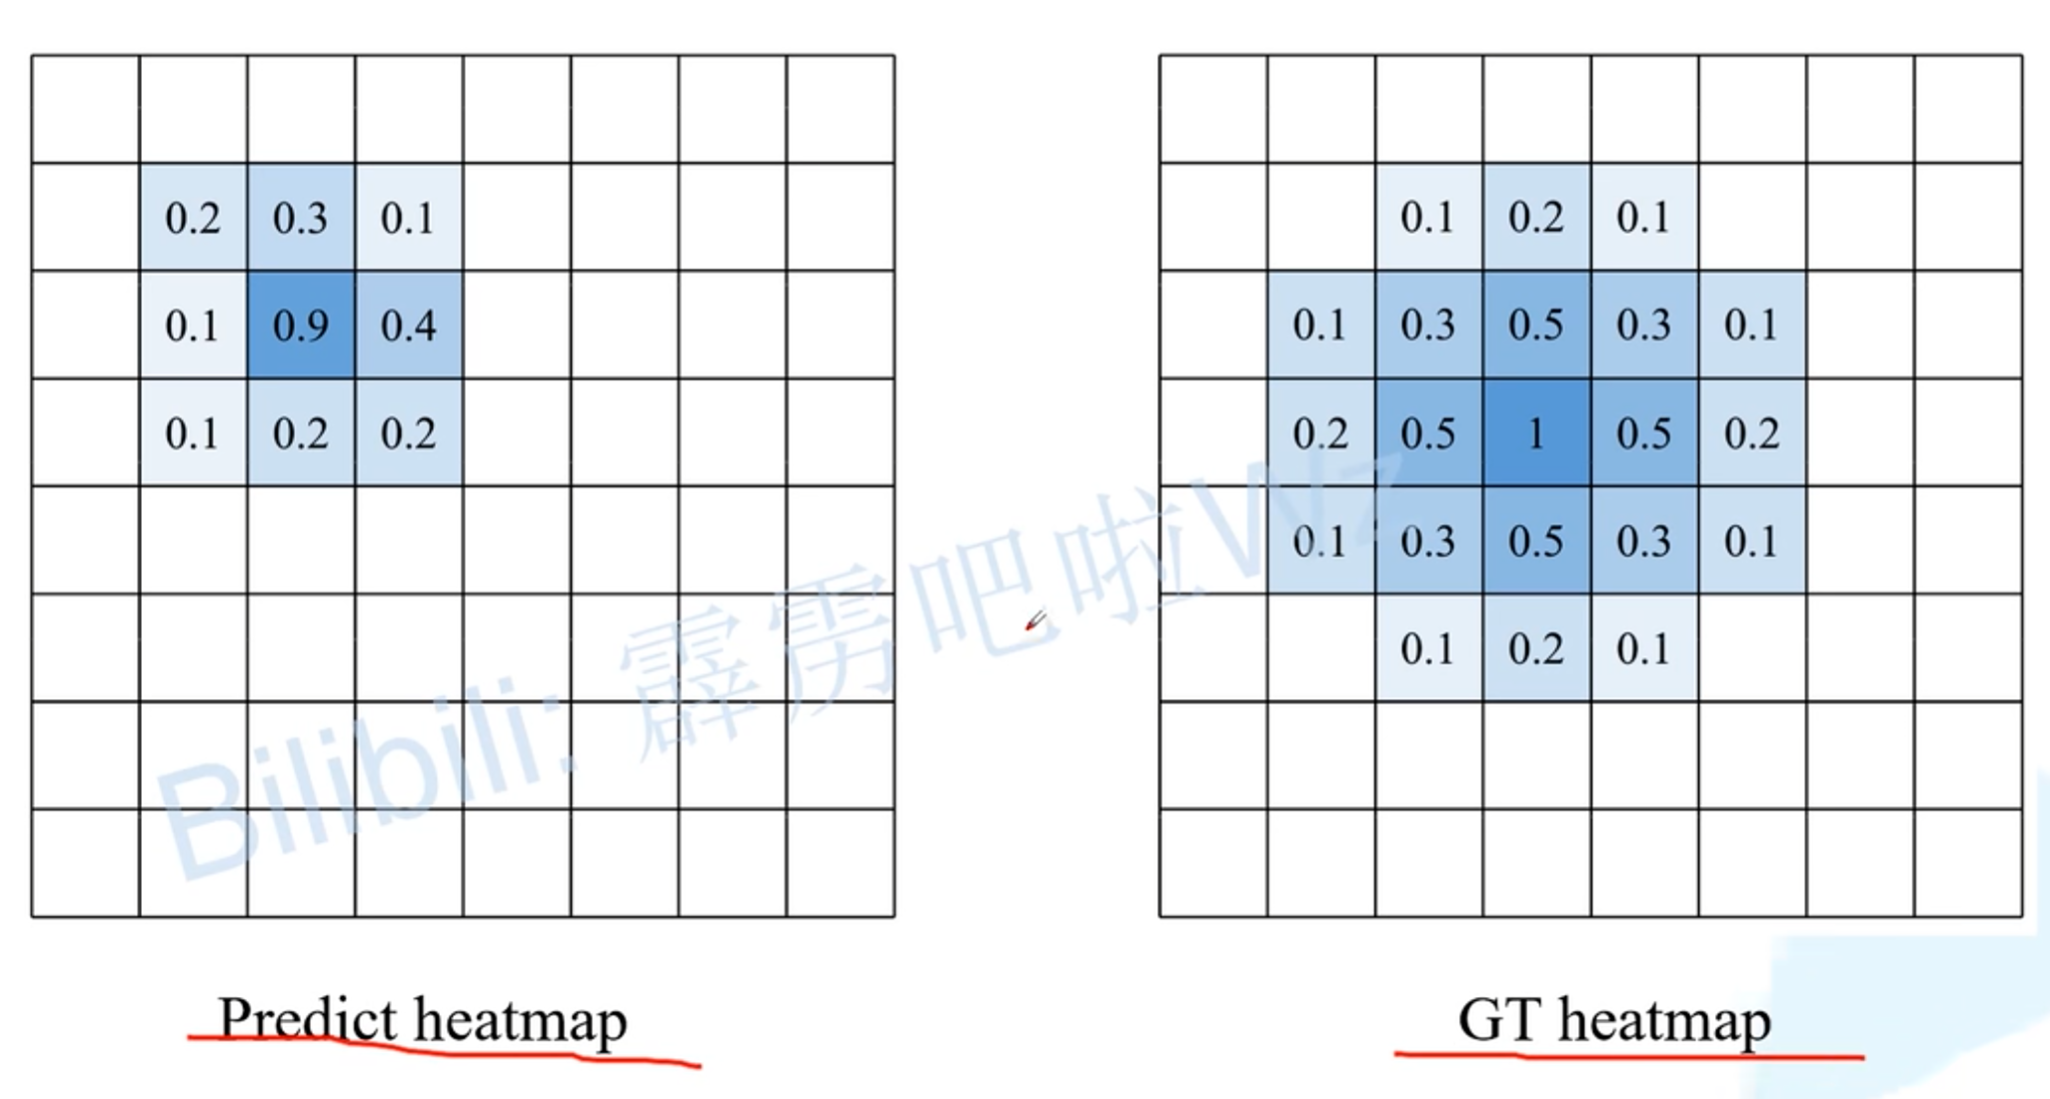
获得热力图, 因为gt点只有一个像素, 但是网络输出尺寸是64*48, 原图上的人的检测框缩小, 热力图表示关键点的位置
-
以gt点为中心做高斯分布, 和预测点相比较
-
-
损失计算
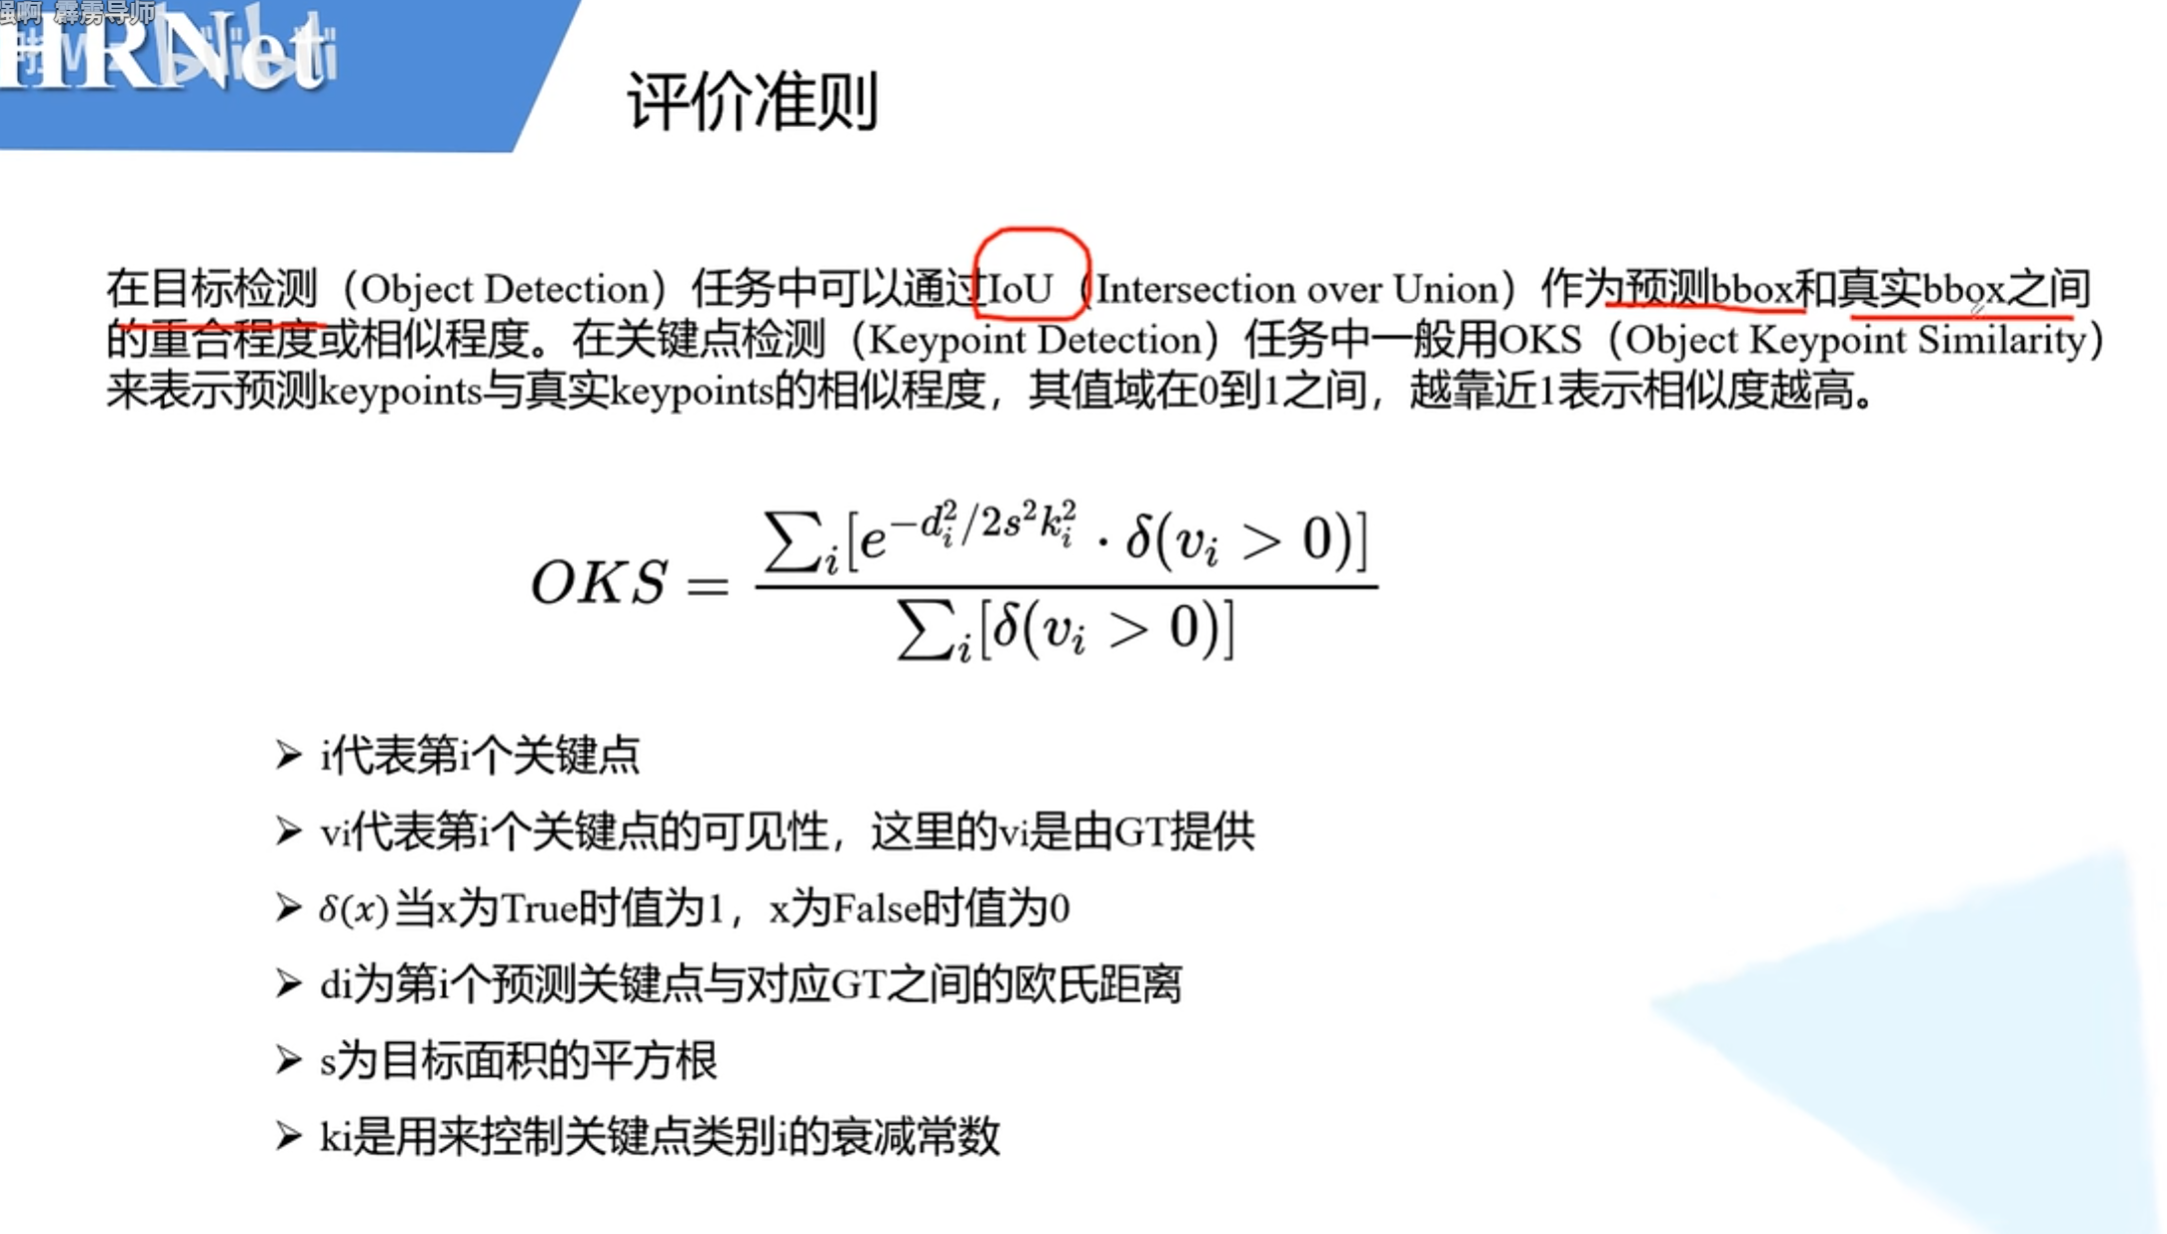
- OKS
- 相关性
- 人的检测框面积
- 预测点到gt的距离
- 相关性
- OKS
-
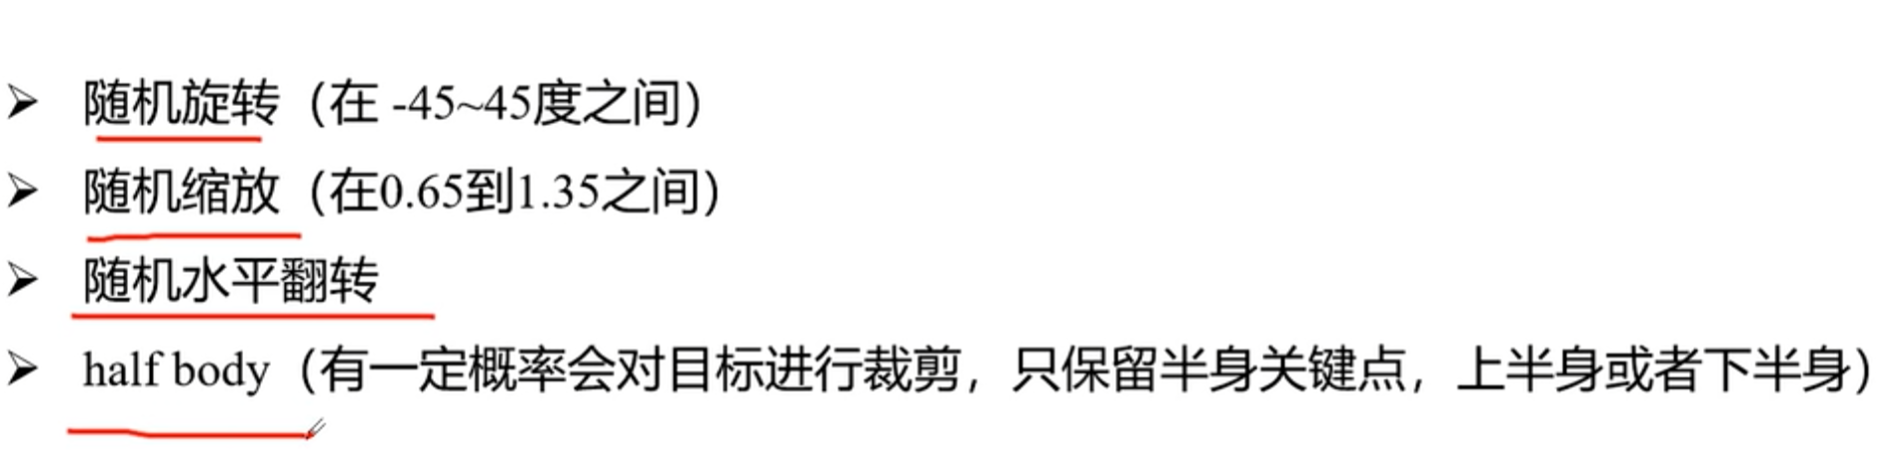
数据增强
-
fastrcnn检测人体
-
-
- 优点:
-
3D HPE:从RGBD图像中估计每个关节的3D Pose(x,y,z)坐标。
- 优点:能够捕捉到人体在一个空间中的位置和姿势。
- 缺点:
- 需要如单目相机、惯性测量单元(IMUs)、射频装置等特殊设备,成本较高。
- 2D HPE遇到的难点问题在3D HPE中依旧需要解决。
- 研究分支:
- 使用单目相机拍摄的RGBD图片或视频
-
目前主流研究
单一视角3D存在2D HPE所存在的问题,并且多人HPE比单人HPE更复杂。
- single-view 3D HPE
-
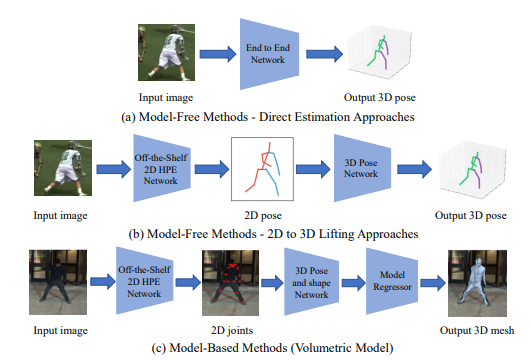
single-person 3D HPE
-
model-free methods
不采用人体模型
- direct estimation approaches:直接预测3D HPE。
- 2D to 3D lifting approaches:先预测2D HPE,再使用2D HPE预测3D HPE。
-
model-based methods:预测人体关节点,再预测形体。
-
-
multiple-person 3D HPE
采用与2D HPE相同的方法
- top-down methods
- bottom-up methods
-
- multi-view 3D HPE
- 主要用于multiple-person HPE
-
优点:能解决单一视角时的人体遮挡问题
-
缺点:
- 需要大量数据含3D标注
- 使用encoder-decoder框架可使用不含标注数据,不过需要多视角图片和背景分割
- 强化学习,可使用更少的视点
以上方案的计算耗时会随相机数量的增加线性增加, 并且消耗大量内存。
-
存在加速方案 (remelli et al.)
-
存在更高效的相机添加方案 (Xie et al.)
-
- 主要用于multiple-person HPE
- single-view 3D HPE
-
- 使用其他传感器,比如惯性测量单元
- 非主流研究
- 使用单目相机拍摄的RGBD图片或视频
数据集
-
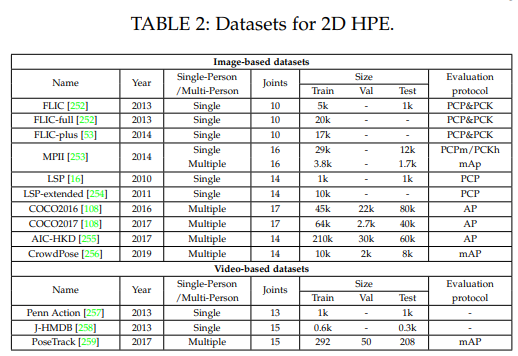
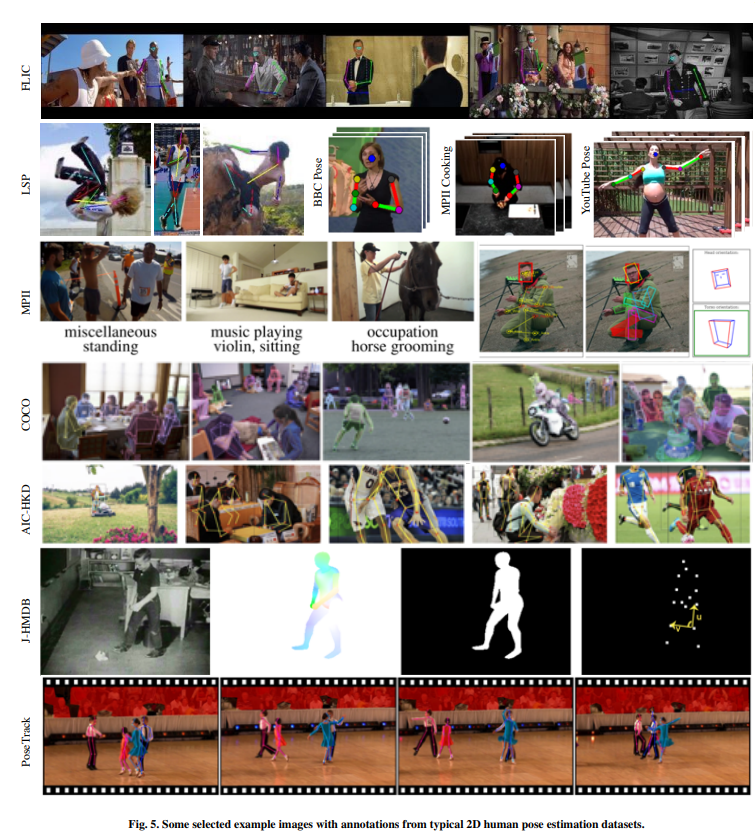
2D HPE 数据集
-
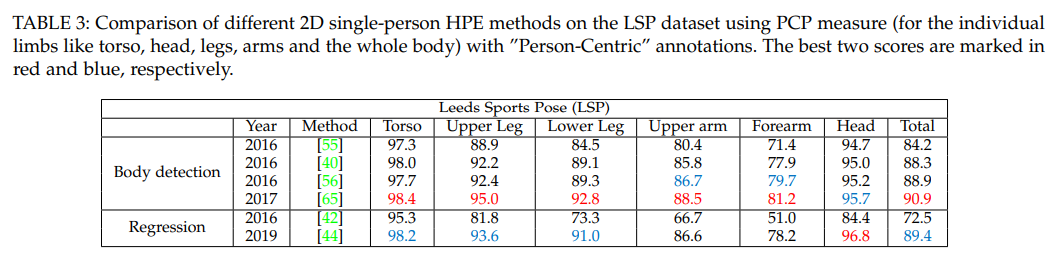
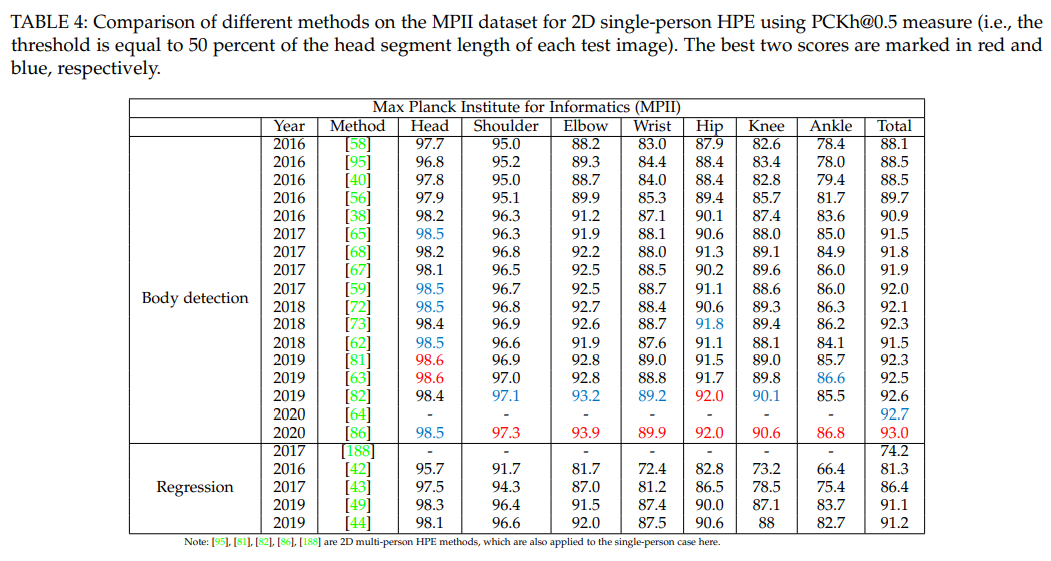
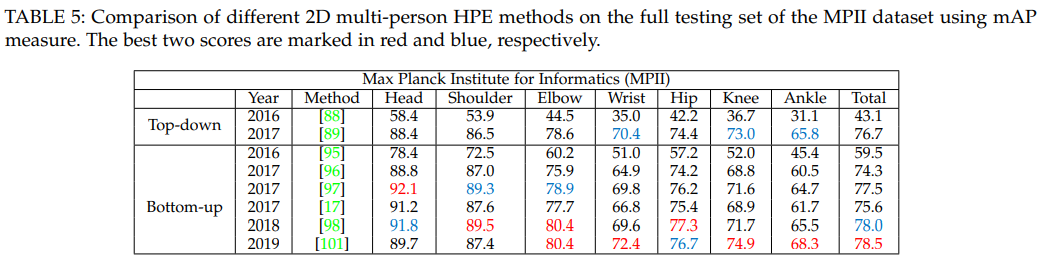
2D HPE论文精度
-
-
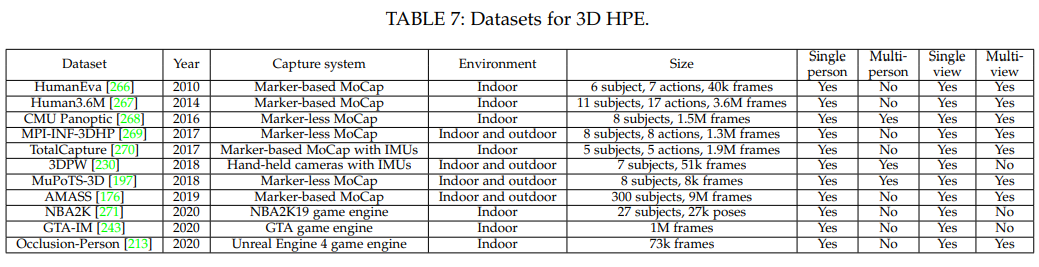
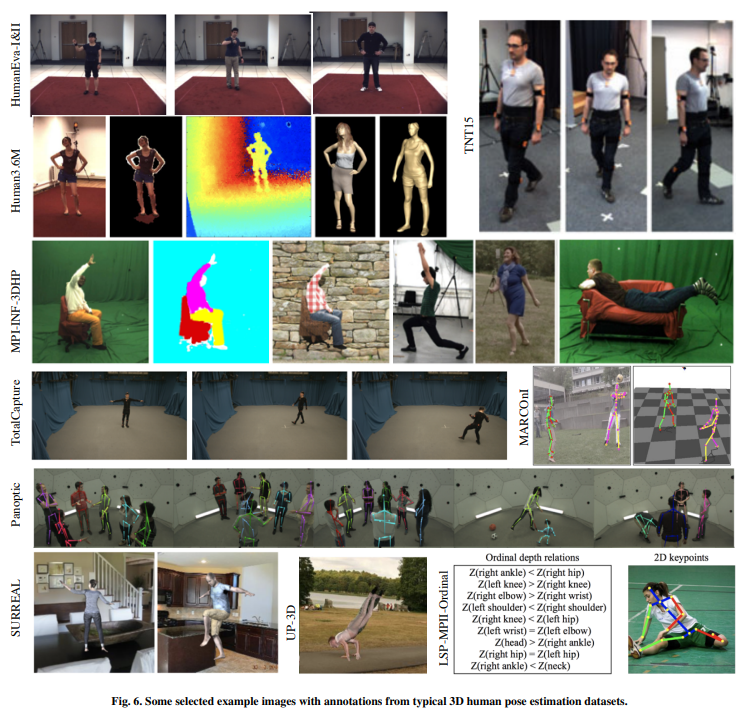
3D HPE 数据集
-
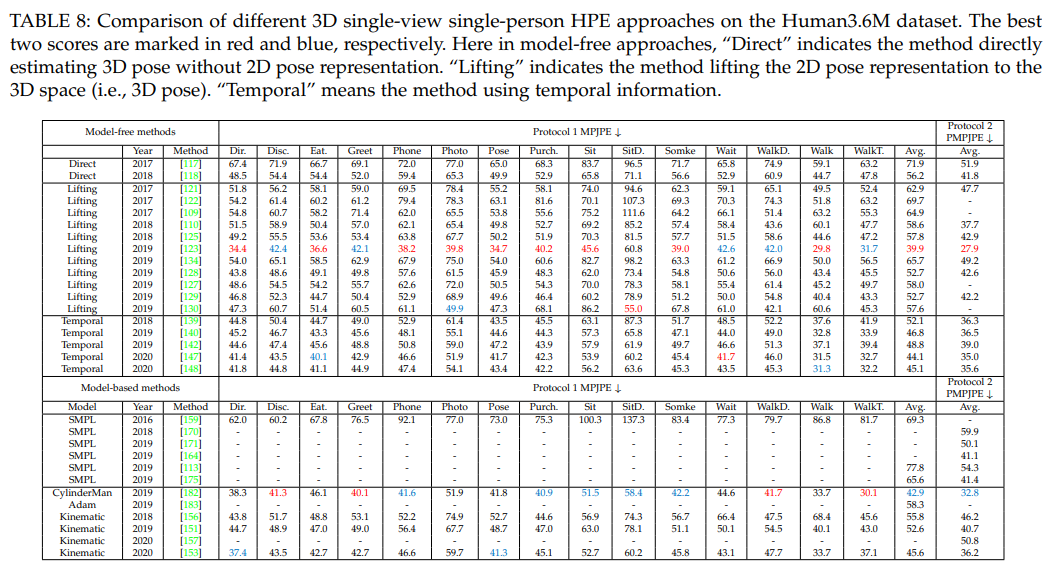
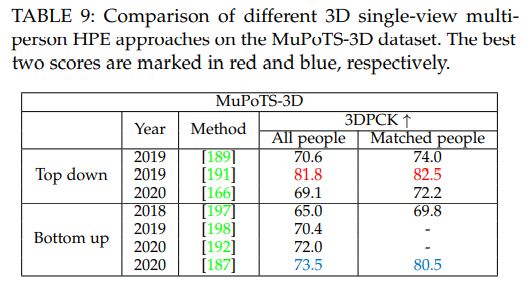
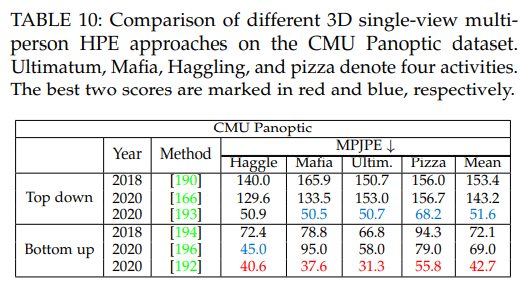
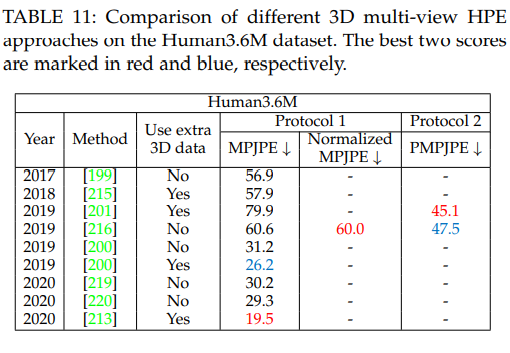
3D HPE论文精度
- extra 3D data指的是在3D HPE之前,先使用有标注的额外数据集训练出一个2D HPE模型。
-
References
- Zheng C, Wu W, Yang T, et al. Deep learning-based human pose estimation: A survey[J]. arXiv preprint arXiv:2012.13392, 2020.
- Chen Y, Tian Y, He M. Monocular human pose estimation: A survey of deep learning-based methods[J]. Computer Vision and Image Understanding, 2020, 192: 102897.
- 深度学习和目标检测系列教程 22-300:关于人体姿态常见的估计方法. https://bbs.huaweicloud.com/blogs/297702, Oct, 2021.