1. 大语言模型的推理加速方案
1.1. 为什么KV Cache不在training中使用只在inference中使用
回答:因为训练(Training)和推理(Inference)的计算方式完全不同。
解释:
-
训练 (Training) 是“并行”的: 为了高效利用 GPU,我们一次性将整个完整序列(例如,一个完整的句子)输入模型,并使用 Causal Mask (注意力掩码) 来防止位置 i 的 token “偷看” 到位置 j > i 的 token。
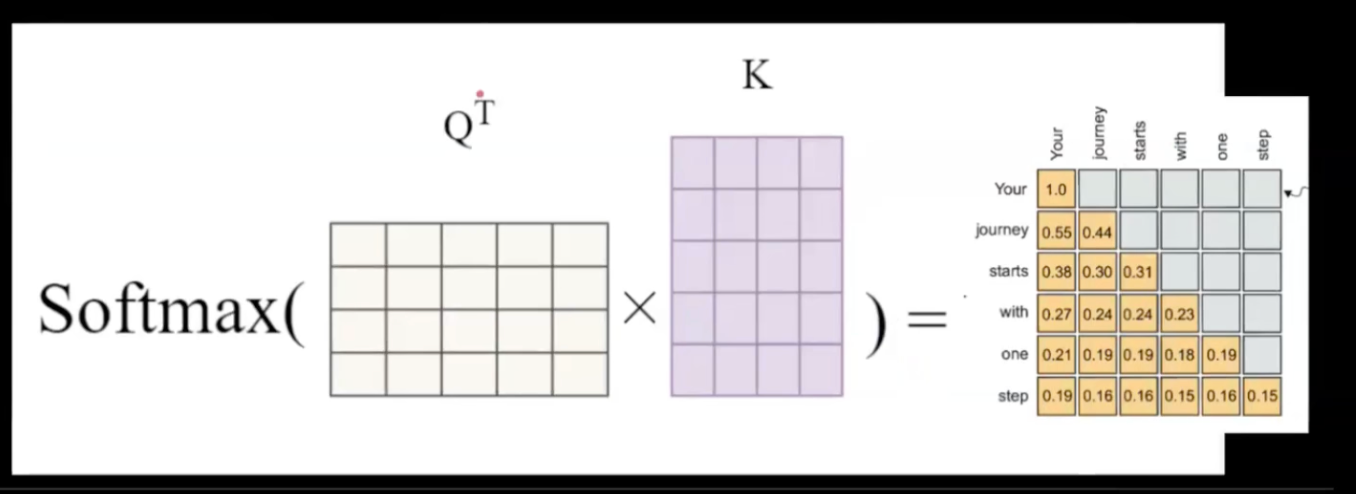
-
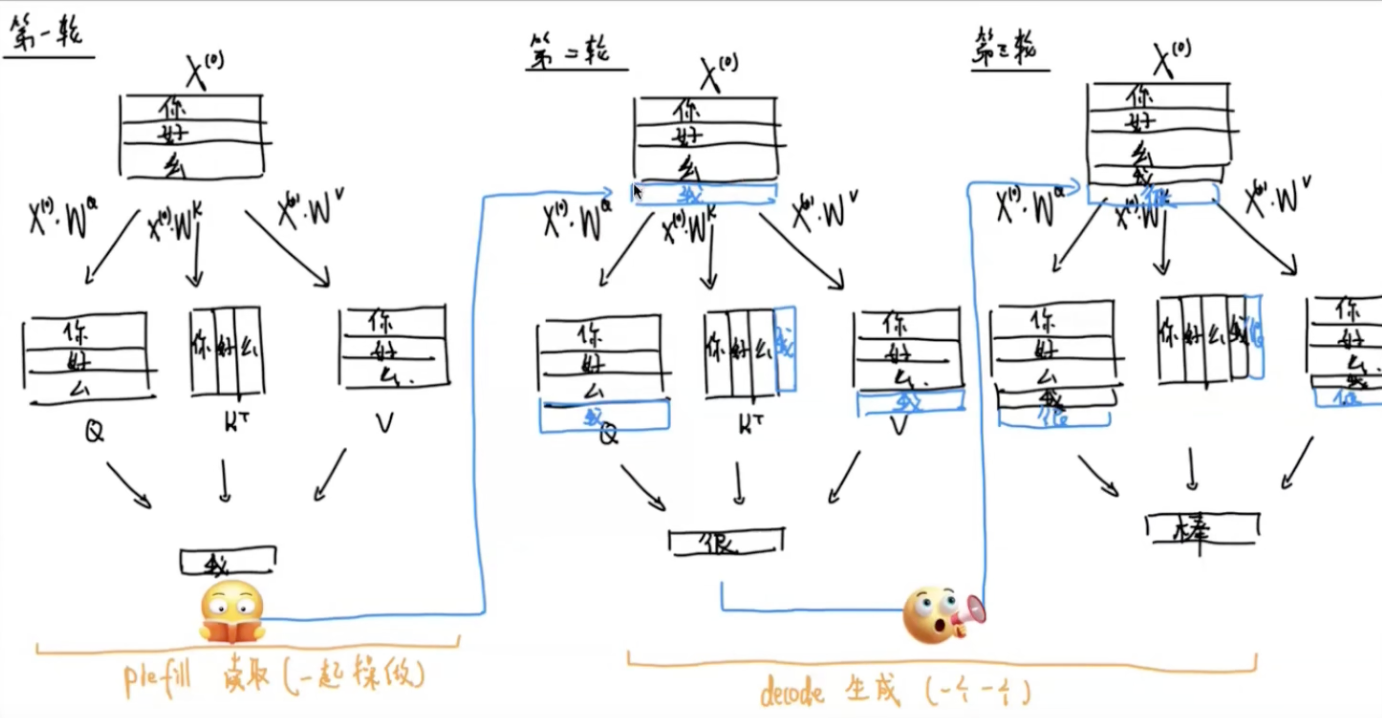
推理 (Inference) 是“串行”的: 我们一次只生成一个新 token,然后把它添加到输入序列中,再生成下一个。
KV Cache 正是为了优化这种“串行”的、逐字生成的推理过程而设计的。
KV Cache的存储方式
两个不同的句子是否需要重新计算所有的k和v的矩阵?
新的句子中相同的字符是否需要重新计算QKV?
回答:是的,必须重新计算。因为同一个词在句中的位置(Positional encoding)和上下文表示(Contextual representation)可能不同。
换一种说法:
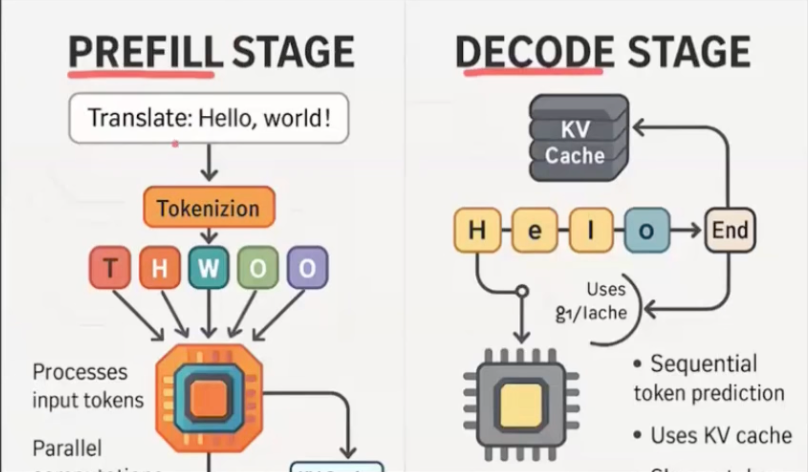
p1: what are the two steps in LLM inference?
prefill and decode 预填充和解码
由于self-attention, 多个token输入的时候,可以做成keys Matrix x Queries Matrix进行并行计算,
- Prefill (预填充) 阶段:负责创建和填充初始的 KV Cache。
- Decode (解码) 阶段:负责使用和扩展这个 KV Cache。
怎么加速推理?
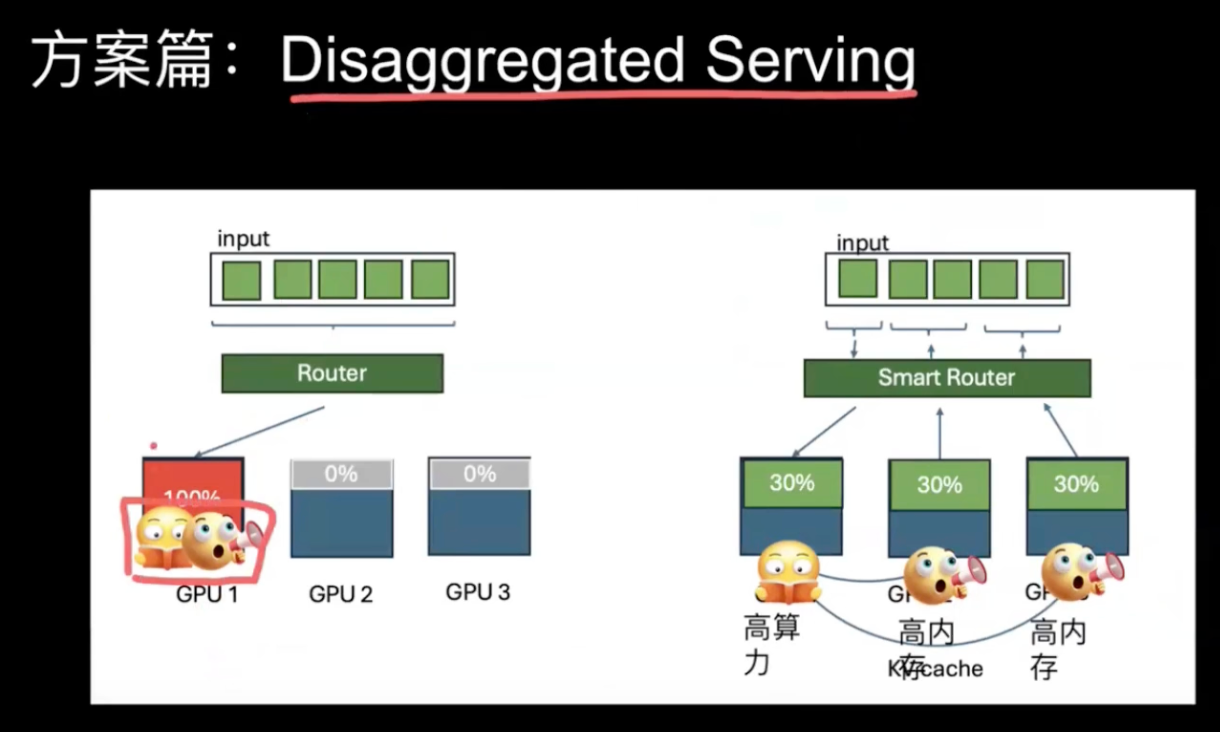
关键在于延迟和吞吐量。
Latency (延迟) 和 Throughput (吞吐量) 是衡量系统性能的两个关键指标,它们描述的是不同的东西:
- Latency关注的是响应时间。
- Througtput关注的是单位时间内系统能处理的操作数量(流量)。
提问:
- Why multi-head attention?
- 多角度看问题。multi-head attention是设置多个注意力机制,详见子空间。
- Theory: subspace 子空间
- 每个注意力头都有自己的QKV矩阵
- 由于初始化矩阵不同,所以训练后会学到不同的投影方式。(如一个学会动词和主语之间关系,一个学会同义词之间的关联性)
- 多个注意力头在各自的小空间里独立学习,最后拼起来。怎么拼起来看下面。
- Compute: parallel 并行计算多注意力头
- gpu可以同时计算所有头,不是使用loop。而是批处理矩阵(batched matrix multiply, BMM)。比如原本要输入[BatchSize=2(两句句子), SeqLen(每句10个词), 512(模型维度)] [2,10,512]。
- Reshape(逻辑拆分)。将维度拆分成多个头[2,10,8,64]。
- Transpose(转置)。$QKV$ 都这么转 [2,8,10,64]。
- 矩阵乘法。 $Q\cdot K^T$ 中的 $K^T$ [2,8,64,10]。相乘的时候pytorch会自动识别后两维是批次维度,并行处理完结果就是注意力分数矩阵 [2,8,10,10]。
- gpu可以同时计算所有头,不是使用loop。而是批处理矩阵(batched matrix multiply, BMM)。比如原本要输入[BatchSize=2(两句句子), SeqLen(每句10个词), 512(模型维度)] [2,10,512]。
- How to use CUDA to optimized multi-head attention
- 由于MHA只有在计算 $Q\cdot K^T$ 的时候是在显存里,读结果的scale, mask,softmax都是在内存,所以有优化空间。
- FlashAttention 是 MHA 优化技术。
- 内核融合,将各步骤都融合到一个 CUDA 内核里完成。
- 分块(Tiling):在计算 $Q\cdot K^T$ 的时候,是一个大矩阵,可能放不进片上内存(SRAM,计算速度快)。将这个矩阵分成小块(Tiles),在SRAM上计算每个结果的Softmax,然后累加起来。
1.2. tensor parallelism和pipeline parallelism(并行)
这两个并行策略的作用:解决大模型过大一张显卡的显存装不下的问题。通过切分模型,分别在不同显卡中运算。
- Pipeline parallelism(流水线并行):
- 模型纵向切分
- 不同GPU处理不同层(GPU1: 1-10Layers, GPU2: 11-20Layers, …)。显卡之间是串行的,一个处理完传输结果到下一个,最后出结果。
- 优点:这样所有模型利用率拉满,在训练的时候用效果好。
- 缺点:推理的时候延迟很大 $T=T_1+T_2+T_3...$。
- Tensor parallelism(张量并行):
- 模型横向切分
- 所有GPU同时在一个Layer上工作,最后拼成结果。
- 就是利用了 BMM 的原理,把不同的头分出来,然后装到不同显卡里计算。
- 优点:延迟很低 $T=T_1$
- 缺点:每一层处理的结果都必须共享并求和(All-Reduce),才能进行下一层计算,所以受通信速度的影响(需要NVLink的高速网络进行数据通信)
| 特性 | Tensor Parallelism (TP, 张量并行) | Pipeline Parallelism (PP, 流水线并行) |
|---|---|---|
| 核心思想 | 层内并行 (Intra-layer Parallelism) | 层间并行 (Inter-layer Parallelism) |
| 切分方式 | 横向切分:把单层的权重矩阵(如 W_Q, W_K, W_V)“切碎” | 纵向切分:把多层(Layers)“切断”成不同的“阶段” (Stage) |
| 通信开销 | 极高且频繁。每计算完一层,GPU 间都需通信 (All-Reduce) | 低且不频繁。只在两个“阶段”的边界处通信 (Point-to-Point) |
| 带宽依赖 | 极高。必须使用 NVLink 这样的高速总线,基本限于单机 | 较低。可以使用 InfiniBand/Ethernet,可以跨服务器(节点) |
| 主要优点 | 低延迟。所有 GPU 同时计算,响应快。 | 高吞吐 (训练时)。可跨节点扩展,装下超大模型。 |
| 主要缺点 | 扩展性差。受限于单机 GPU 数量 (如 8 卡) | 延迟极高。串行计算,总延迟是所有阶段之和。 |
| 关键问题 | 通信是瓶颈。 | “流水线气泡” (Bubble):大量 GPU 处于空闲等待状态。 |
| 设备 | 最好是同一个host,多张显卡 | 可以是不同host |
- Sequence parallelism(序列并行):(最新方案,可输入超长tokens)
- 前面介绍的两种策略TP和PP,在每块GPU中都需要存储和处理完整序列长度(Full Sequence Length)的激活值(在训练反向传播时,模型必须在显存里保留所有中间计算结果(Attention layer, FFN layer的输出等),这就是激活值)。而激活值的显存占用量与序列长度 $S$ (输入的tokens长度)和批次大小 $B$ (一个GPU同时并行处理的独立样本数量)成正比。所以,当 $S$ 很长时,激活值会比模型权重还大,成为新的显存瓶颈。导致就算TP和PP把权重分得再碎,激活值都有可能让显存爆。
- 解决方法:既然 $S$ 很长,那把 $S$ 也切了。
- 问题是,self-attention对于上下文有依赖,切开会破坏这种依赖。
- self-attention有依赖,但是FFM/MLP(前馈网络)的序列没有依赖,对每个token都是独立计算的。
- SP和TP需要一起用。
- FFN/MLP layer
-
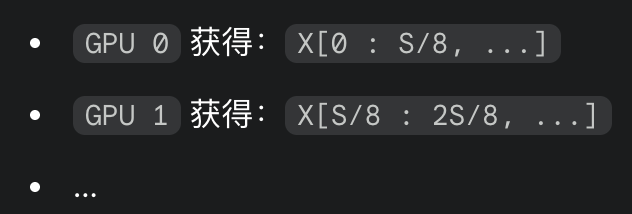
输入:[S, B, H]
-
切分:在输入FFN前,先把输入切成8份。
-
每个GPU独立计算。
-
- Attention layer
- 将所有GPU的FFN结果拼回完整序列,并共享到所有GPU(All-Gather)。
- 使用TP策略。
- 通信(Reduce-Scatter):
- 所有GPU执行一次 Reduce-Scatter(求和-分散)。就是所有TP结果相加,然后做切分(第1步的切分成8份)。输入下一个FFN。
1.2.1. FFN
FFN 通常是一个非常简单的两层全连接神经网络 (MLP):
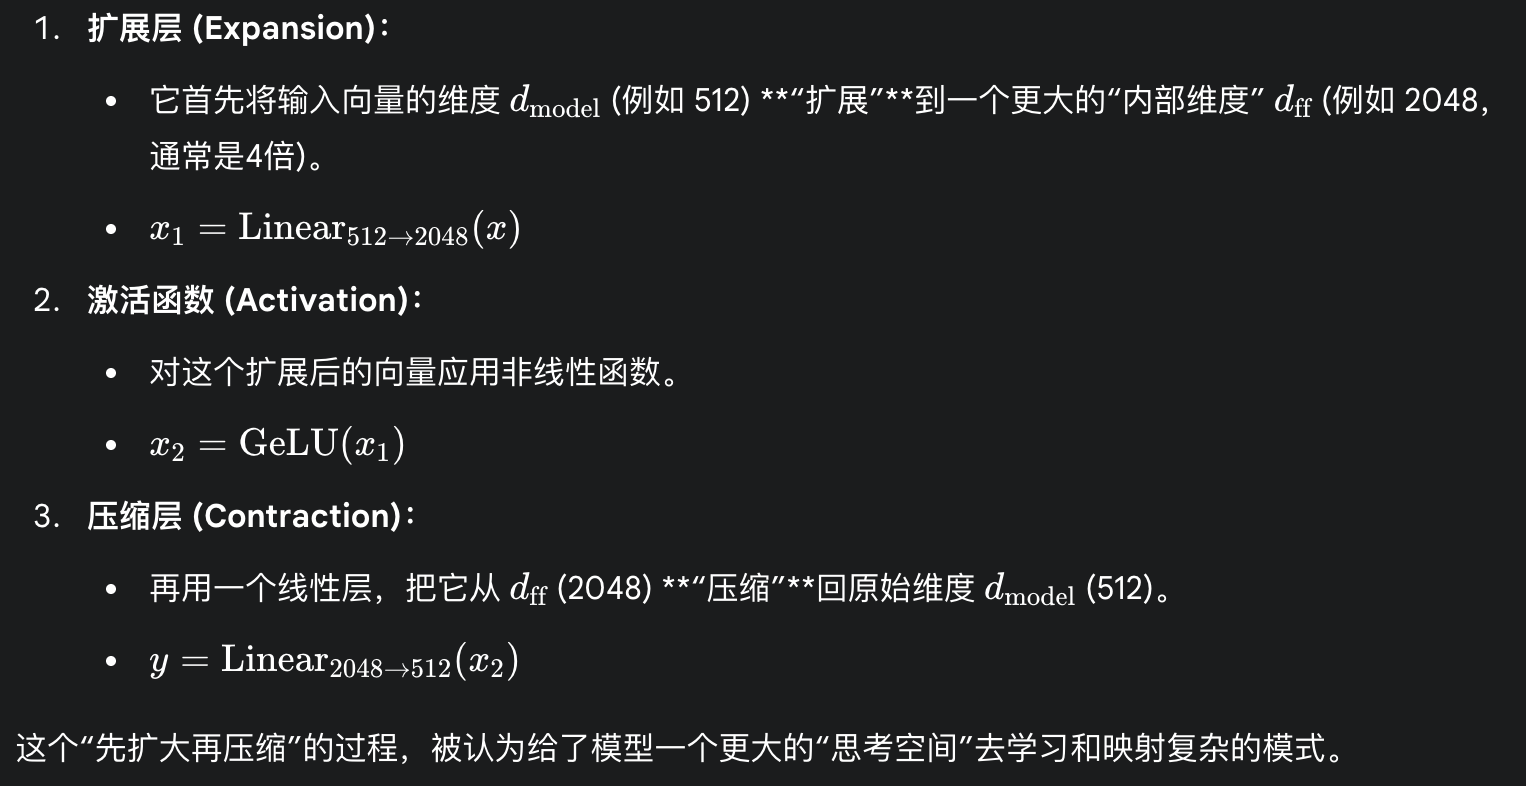
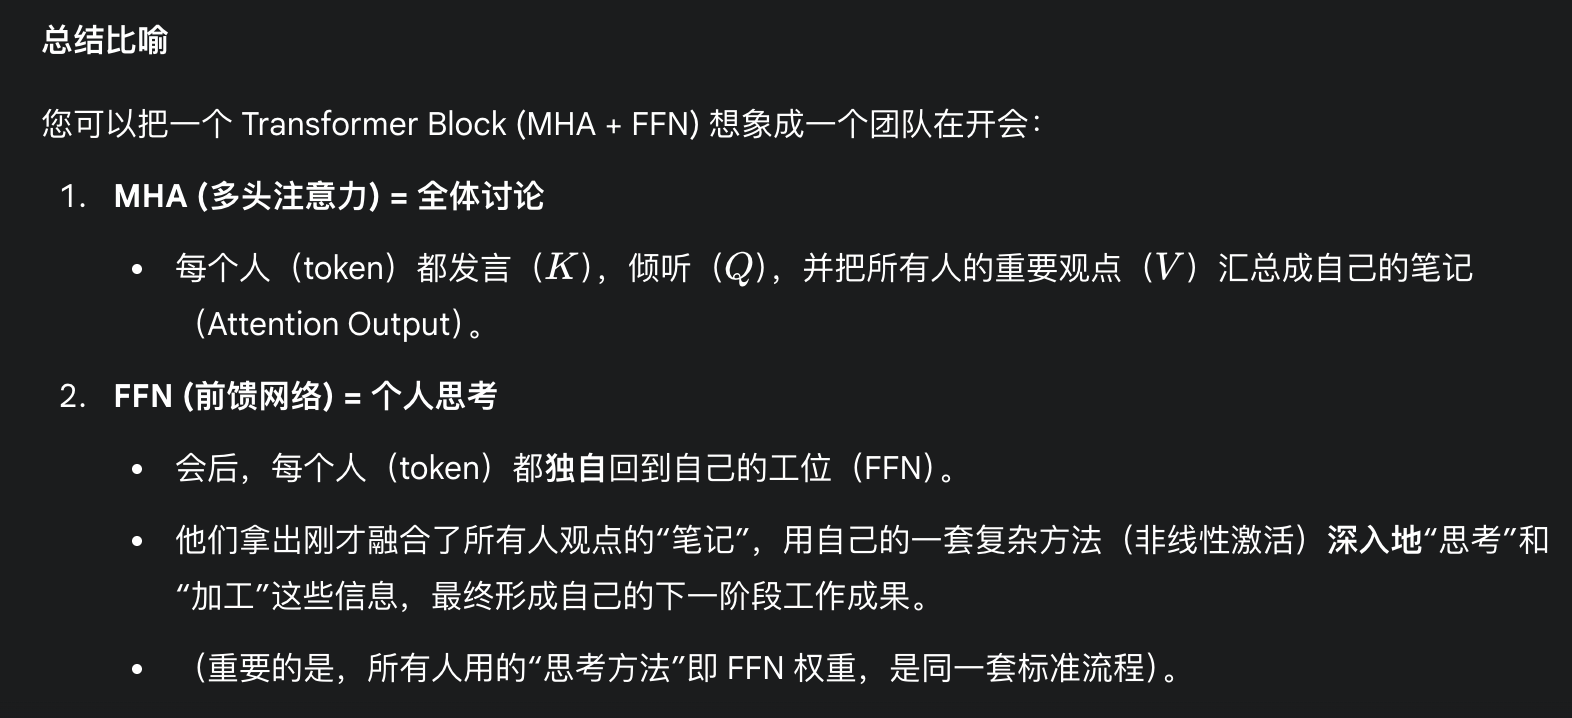
1.3. Quantization
FP32 → FP4 大幅减少模型参数量来做到加速。
FP32: -128~+127 (256)
FP4: -8~+7 (16)
操作步骤:
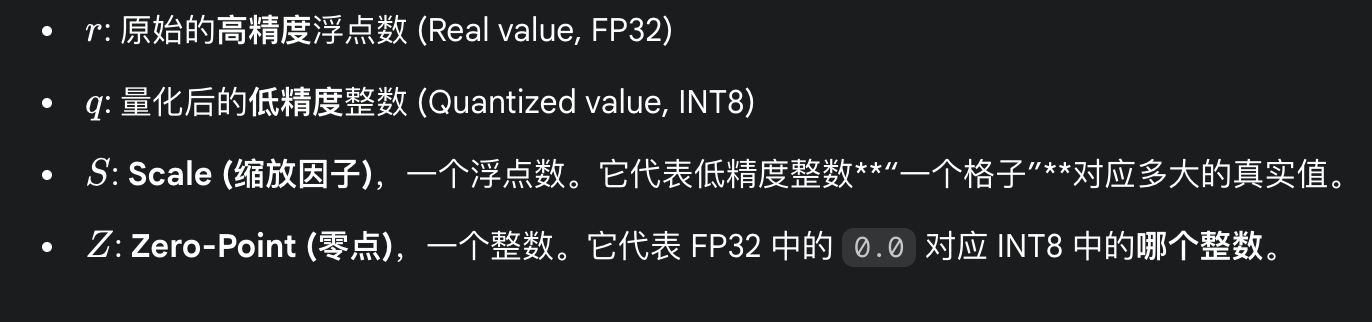
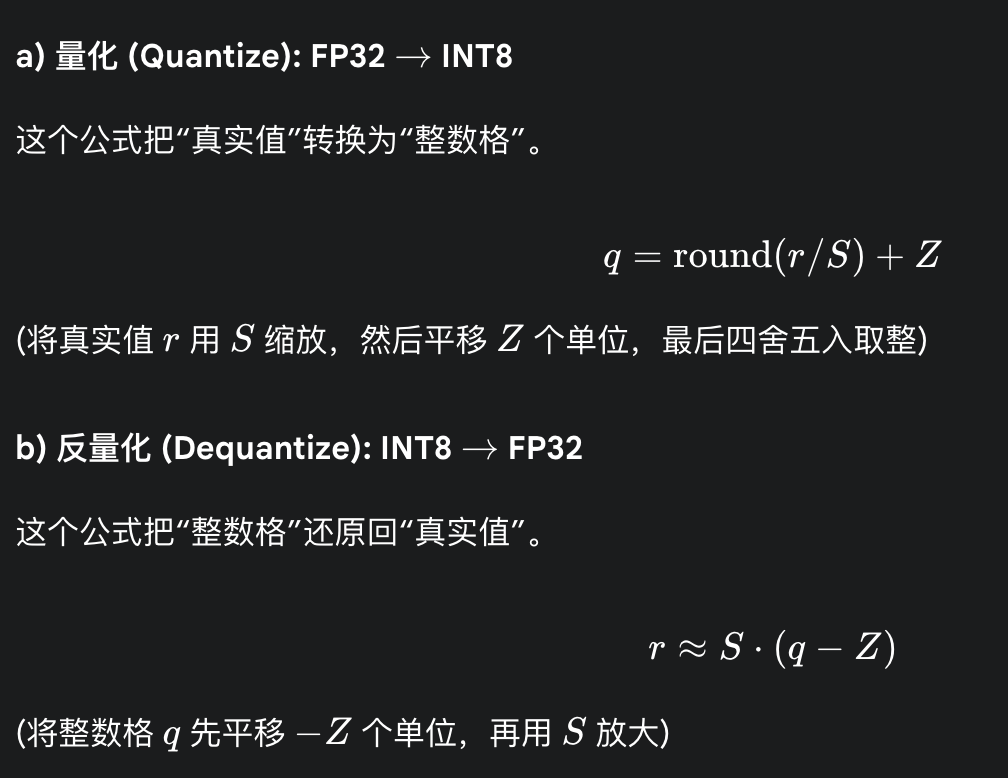
关键点:在推理时,模型会用 INT8 整数进行极快的矩阵乘法(INT8 计算比 FP32 快得多),只在最后需要输出时,才用 S 和 Z 把结果“反量化”回 FP32。
例子:
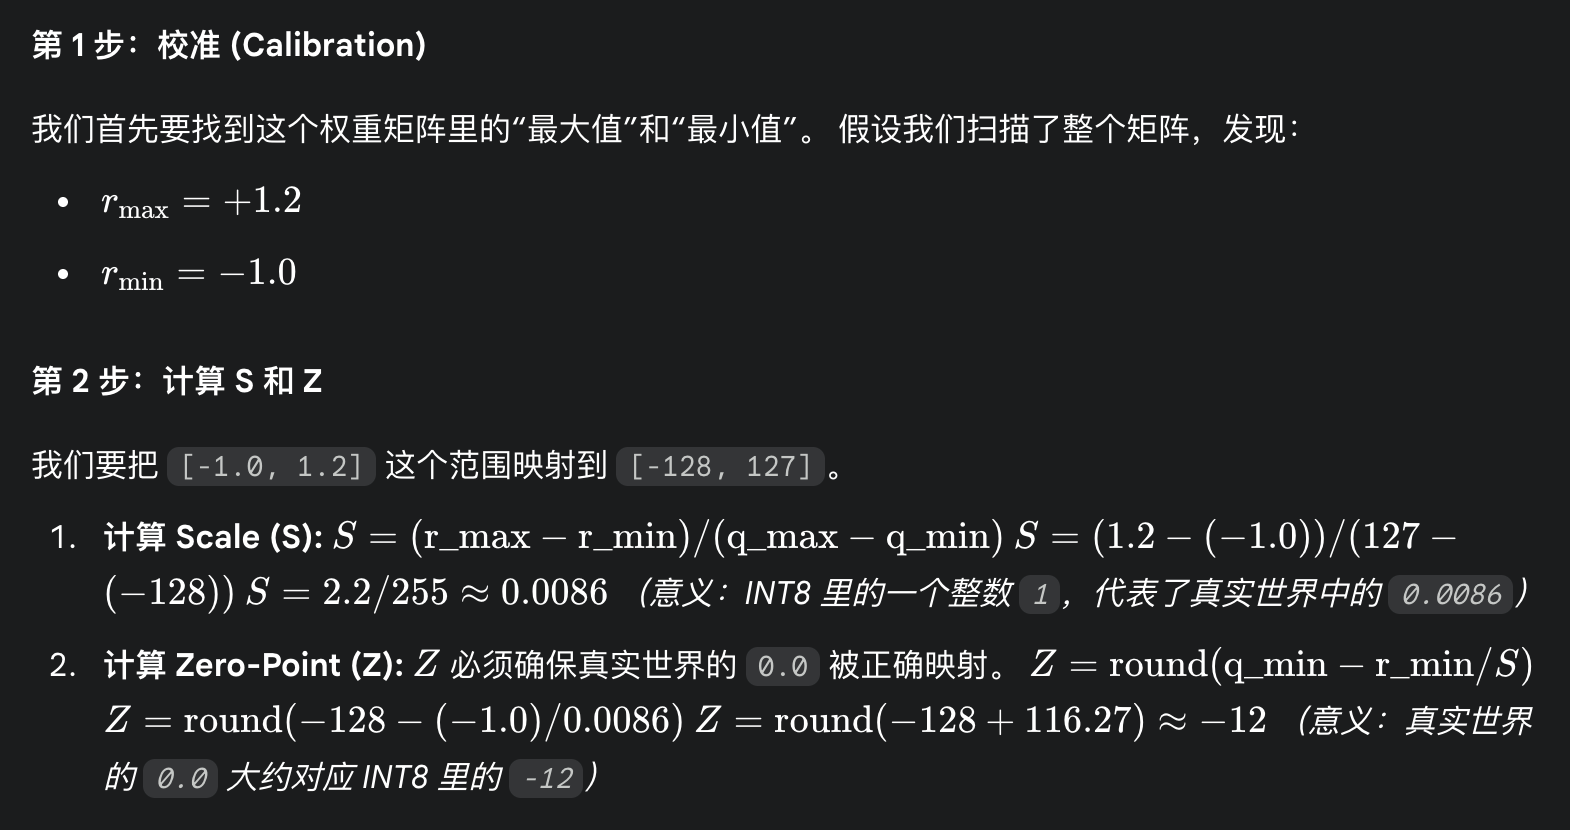
zero point是将量化值和原始值对齐的操作。
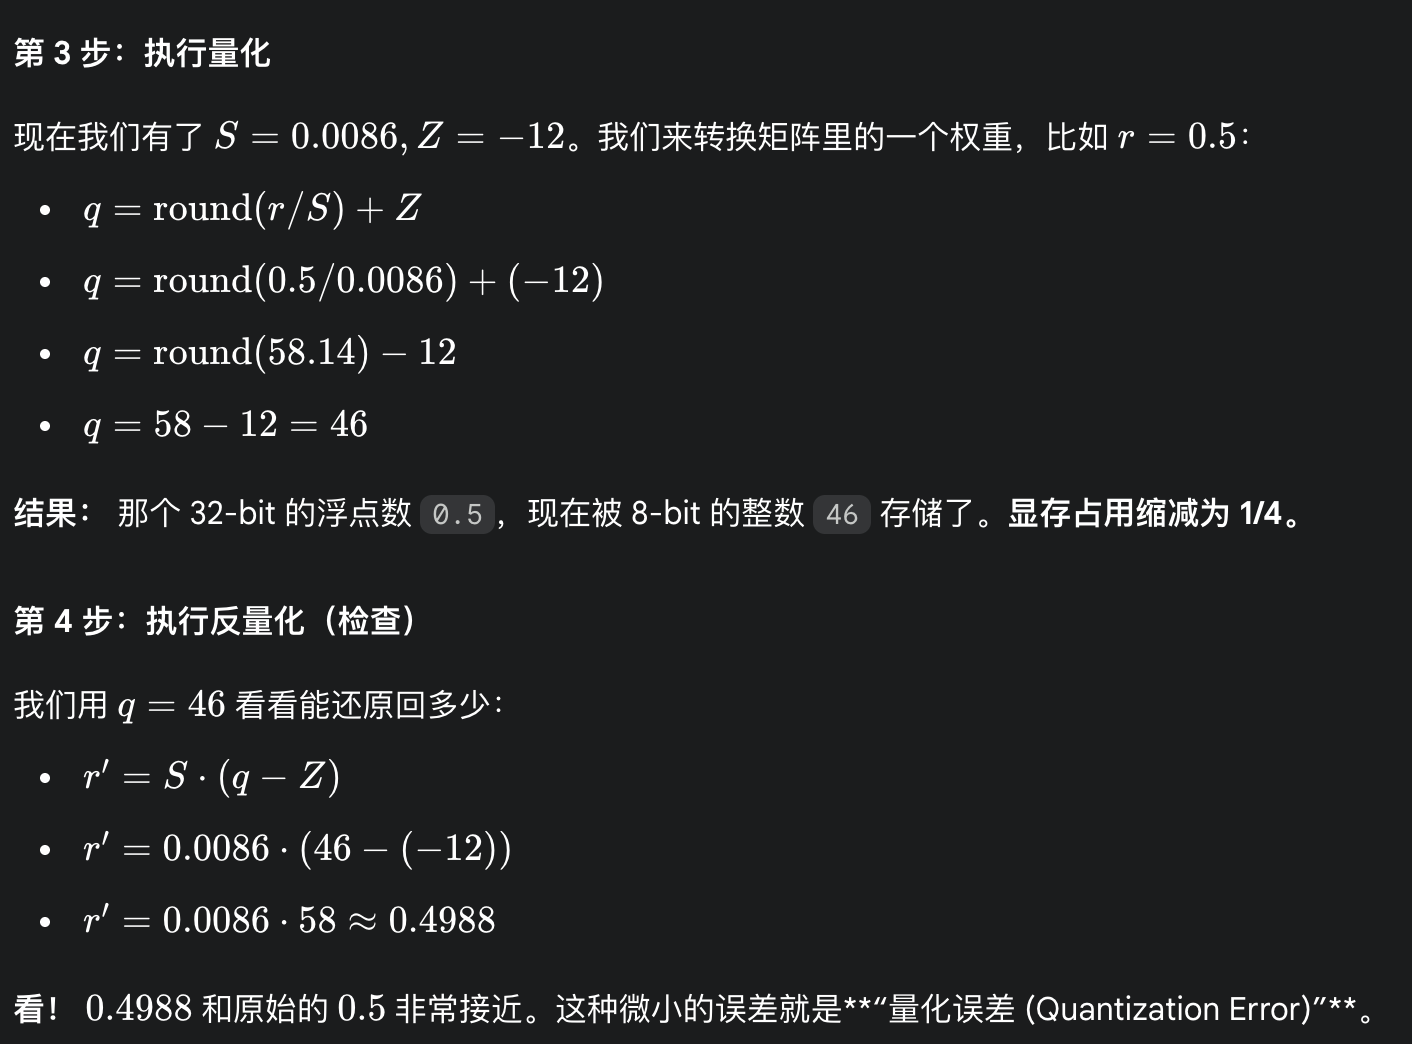
1.3.1. 量化的主要策略
1.3.1.1. Post-Trainging Quantization (PTQ - 训练后量化)
- 训练高精度模型后,冻结参数。
- 小批量样本推理,记录每一层的权重和激活值矩阵的最大和最小值。
- 根据量化值和记录的值计算S和Z。
- 所有权重从FP32转换为INT8,甚至INT4。
1.3.1.2. Quantization-aware training (QAT - 量化感知训练)
由于量化对精度的损失很大,所有需要QAT。
策略:在训练时就模拟量化。
- 前向传播 Forward pass
- 拿到FP32权重,量化为INT8,倒回FP32。
- 反向传播 Backward pass
- 计算梯度。(注意梯度回绕过round函数,因为它不可导)
- 使用梯度更新FP32权重
这样模型就会在训练中自己优化量化造成的误差。
-
注意细节:
S 和 Z 是针对谁设计的?
- Per-Tensor(逐张量)
- 就是整个权重只给一组S和Z。
- 缺点:这样如果权重中有异常值,导致原始值范围巨大 → S 巨大,导致其他值被压缩成0,精度崩塌。
- Per-Channel / Per-Group(逐通道 / 逐组)
-
LLM里的标准做法。
-
对权重的**每一行(或每一列)**都独立计算一组S和Z。
-
比如:nxn的矩阵,会获得n组S和Z。
-
优点: 极大地隔离了异常值,精度保持得非常好。
-
缺点:如下面的矩阵,最后一行转换后值相等了,就会不可取分。
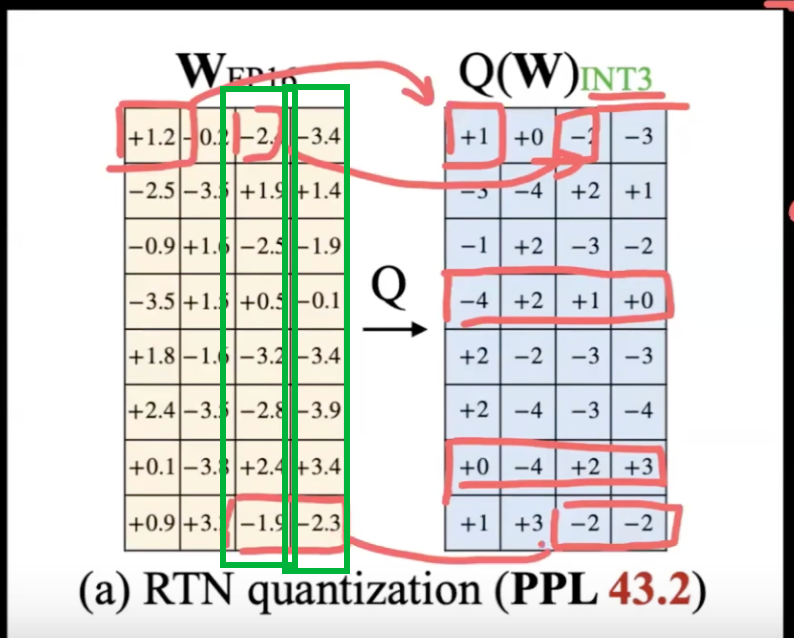
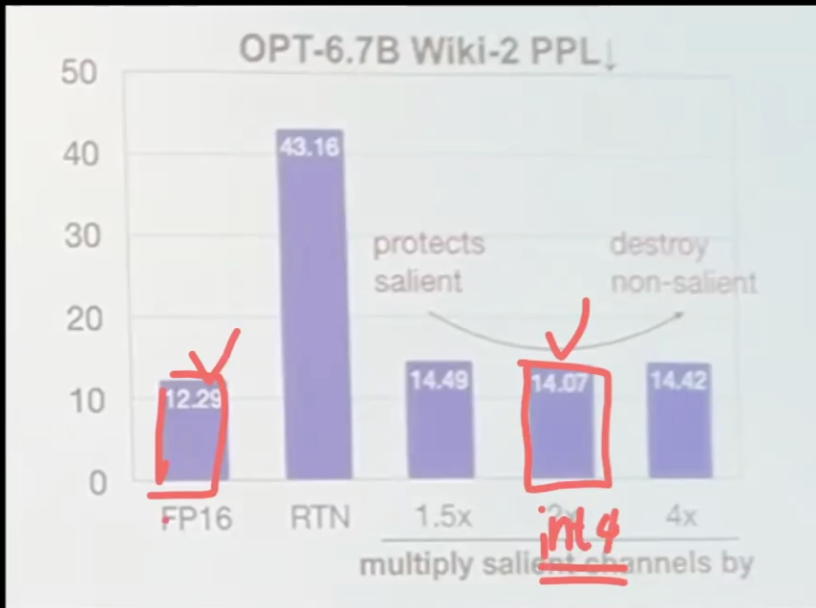
在LLM上量化会有巨大的损失(这里RTN是指Round-to-Nearest(四舍五入))
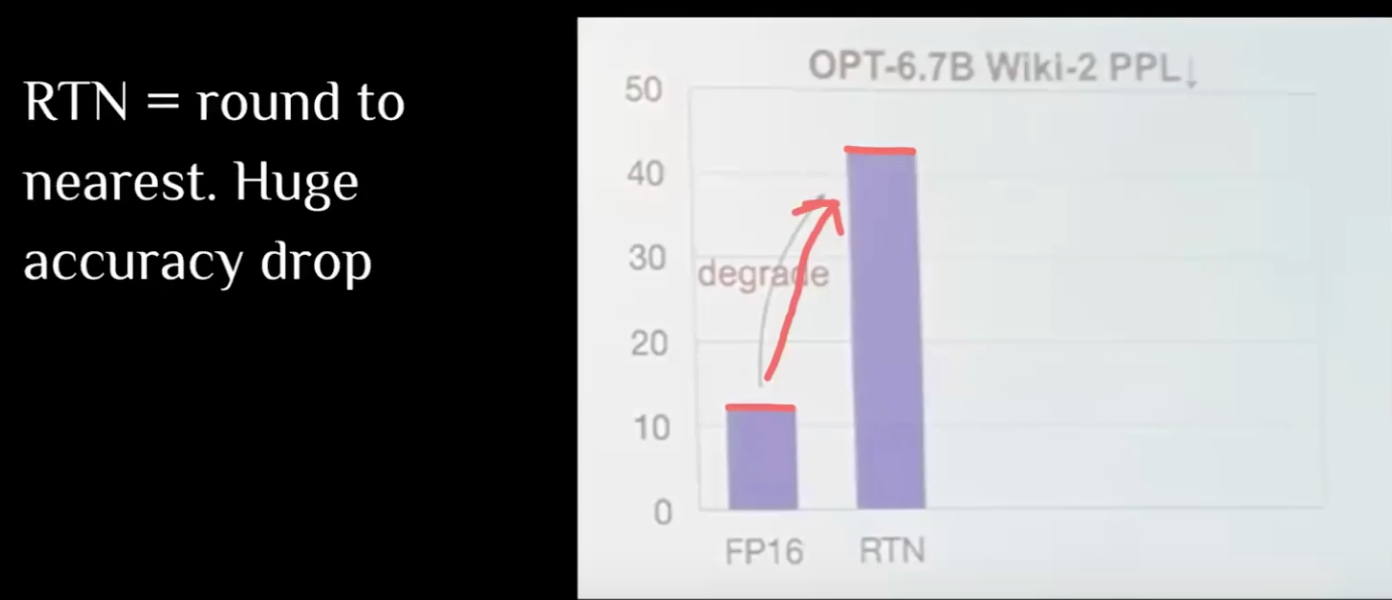
-
针对 LLM 的特殊挑战:激活值异常点 (Outliers)
LLM 的量化有一个大难题:
- 权重 (Weights) 很“乖”,是漂亮的正态分布(钟形曲线),很容易量化。
- 激活值 (Activations)(即 MHA 和 FFN 的中间输出)很“野”。它们 99.9% 的值都接近 0,但有几个极其巨大的“异常值”。
这些异常值会毁了 Per-Tensor 的量化。
解决方案 (如 LLM.int8() / SmoothQuant):
- 这是一种“混合精度”量化。
- 它在计算时,动态地检测出这些“异常值”所在的维度。
- 99.9% 的“正常”计算用 INT8 完成。
- 0.1% 的“异常”计算,切换回 FP16 来处理。
- 这样既保证了速度,又保证了精度。
而更高级的 GPTQ / AWQ / QLoRA (NF4) 等 4-bit 量化,则是在 PTQ 的基础上,增加了“智能调整”步骤:它们会在量化前,就“重构”权重矩阵,把量化误差的伤害降到最低。
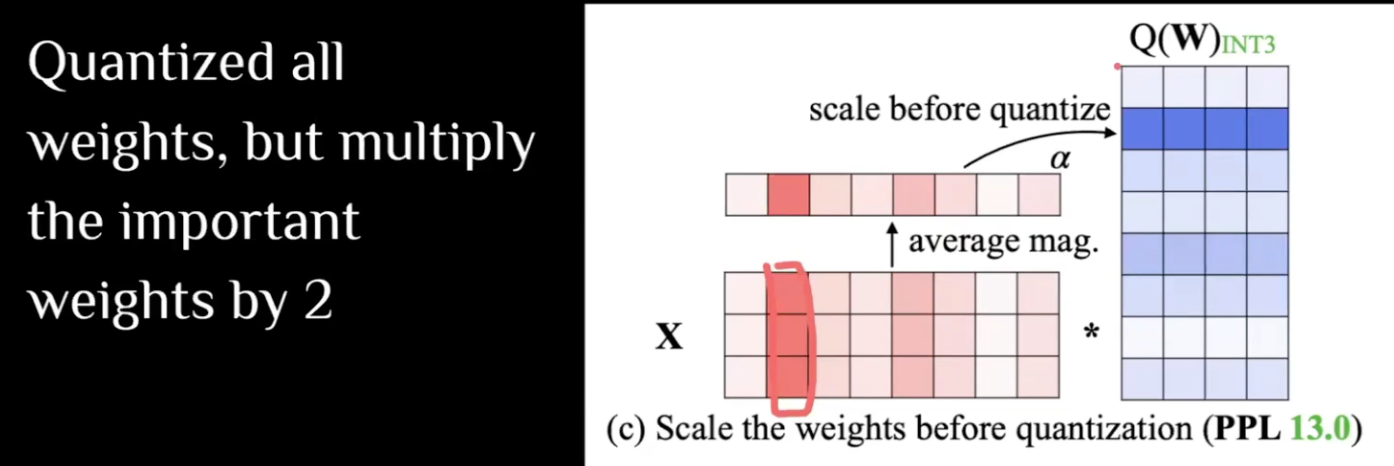
策略:保留一部分全精度,如图loss降回原本的值。
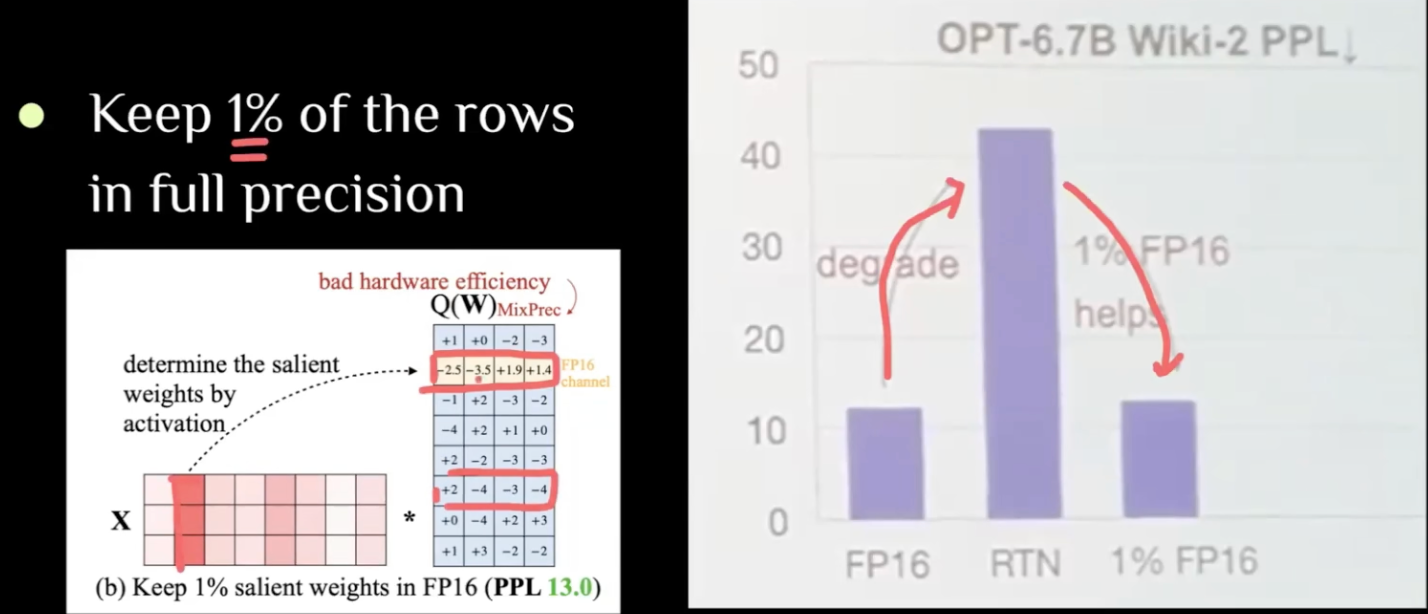
问题:哪些行保留?哪些行量化?
- 看哪一行数值大就保留哪一行。→ 实验发现有26%要保留。
- 看X(取列的平均)乘这一行获得activation数值大(说明活跃)。(AWQ)
问题:这样权重里有的是FP32有的是INT8怎么办?
如果这一行activation大,那这一行 S 值乘2来凸显出这一行重要。(AWQ)
-
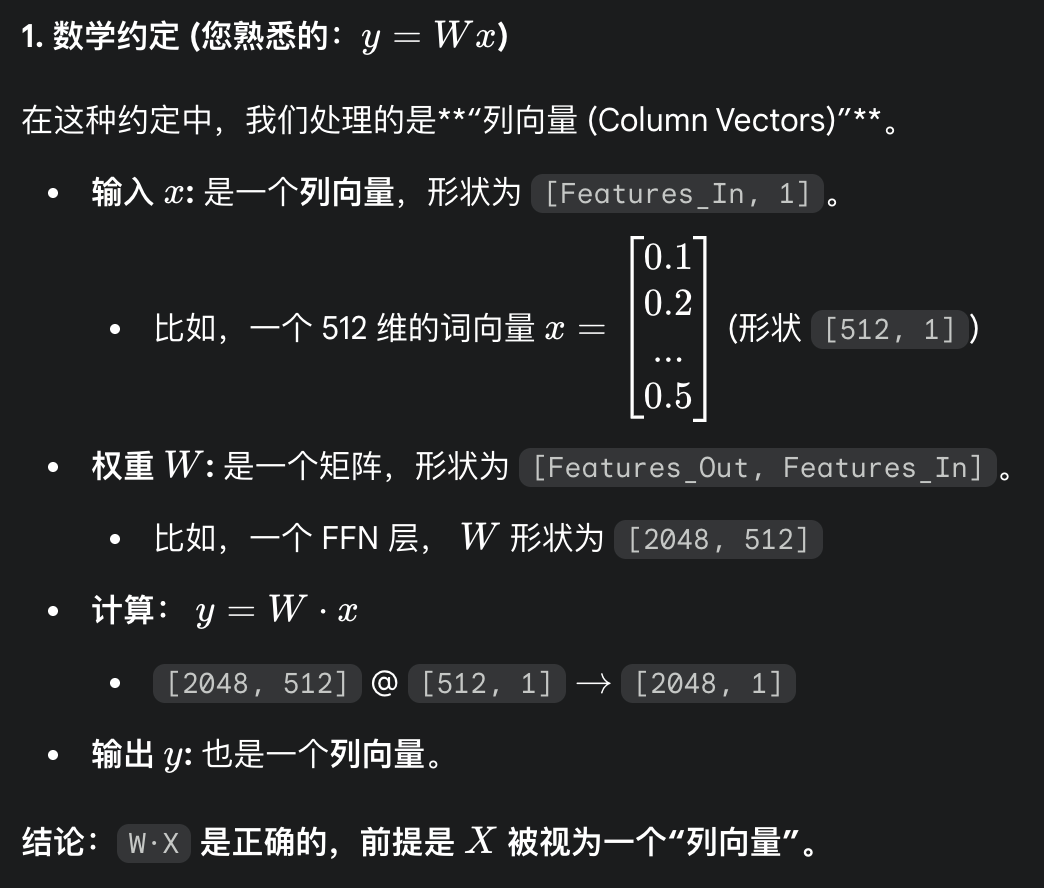
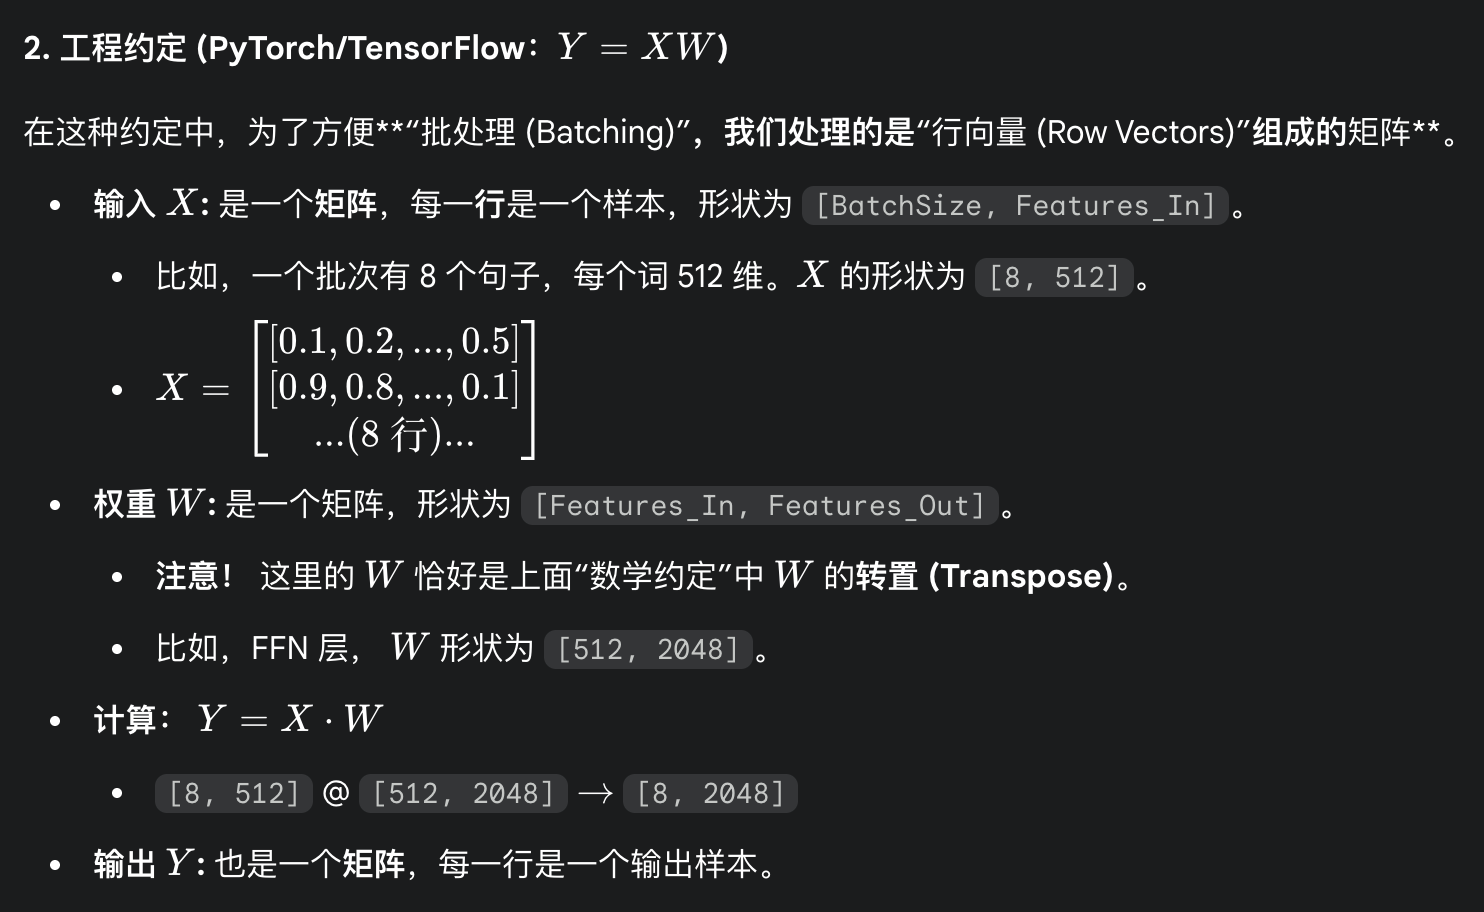
在数学约定中激活值是 $y=Wx$,但在工程约定中是 $Y=XW$(为了方便批处理)
- Per-Tensor(逐张量)
1.3.1.3. Activation-aware Weight Quantization (激活感知权重Z化 AWQ)
AWQ 是一种极快且高精度的训练后量化 (PTQ) 方法。它的核心洞察是:“我们不需要保护所有的权重,我们只需要保护那些与‘异常激活值’相乘的 1% 的‘显著权重’(Salient Weights) 就够了。”
原理:
$$ Y = XW = X \cdot (W / s) \cdot s $$这个 s 是一个缩放因子 (Scale)。这个等式看起来毫无意义,但 AWQ 的魔力在于:
- 这个 s 是逐通道 (Per-Channel) 的。
- 这个 s 是激活感知的。
AWQ的工作流程:
推理前执行一次:
- 搜索 (Search / Observe)
- 运用少量数据通过模型。
- 观察激活值X,识别出包含异常值的通道。
- 标记这些通道对应的权重为显著权重。
- 计算并缩放 (Scale & Apply)
- AWQ 为每一个权重通道(Channel) $W_c$ 计算一个最佳缩放因子 $s_c$。
- 目标:找到一个 ,使得预缩放后的权重 $W'_c = W_c / s_c$ 在被四舍五入 (RTN) 时,误差最小。
- 量化与保存 (Quantize & Save)
- 将预缩放后的 $W' = W / s$ 矩阵,用最简单、最快的 RTN 量化为 INT4 整数 $W'_q$。
- 将这个 $W'_q$ (INT4 矩阵) 和 s (FP16 向量) 保存下来。
推理时:
- 加载 INT4 权重 $W'_q$ 和 FP16 缩放 $s$。
- 执行计算 $Y = X \cdot (W'_q \cdot s)$。
- 这个 $(W'_q \cdot s)$ 操作可以被 CUDA 内核高度优化(先反量化 $W'$,再与 $X$ 相乘),速度极快。
1.4. Flash Attention
vllm一般用的都是flash attention。
简单来说,Flash Attention 的核心贡献是:让注意力计算变得又快又省显存,从而使处理超长序列(如 128K 甚至更长的上下文)成为可能。
它的发明人 Tri Dao 的核心洞察是:标准注意力的瓶颈不在于计算(FLOPs),而在于显存的读写(Memory I/O)。
标准注意力的操作过程:
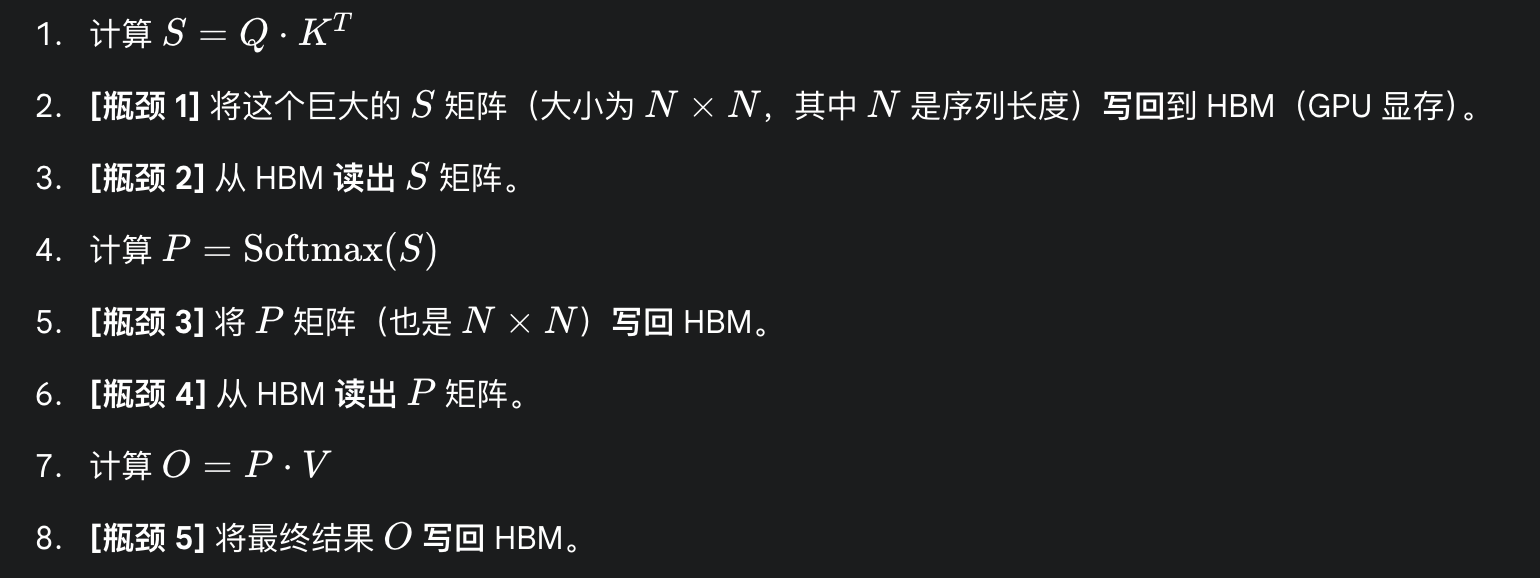
出现的问题是:GPU 的计算核心(SRAM,片上内存)速度极快,但容量很小;而 GPU 的显存(HBM)容量很大,但速度相对很慢。更糟糕的是,它必须在 HBM 中完整地创建(物化)那个 $N \times N$ 的 S 和 P 矩阵。当序列长度 N 很大时(比如 64K),$N^2$ 是一个天文数字,这会耗尽所有显存。
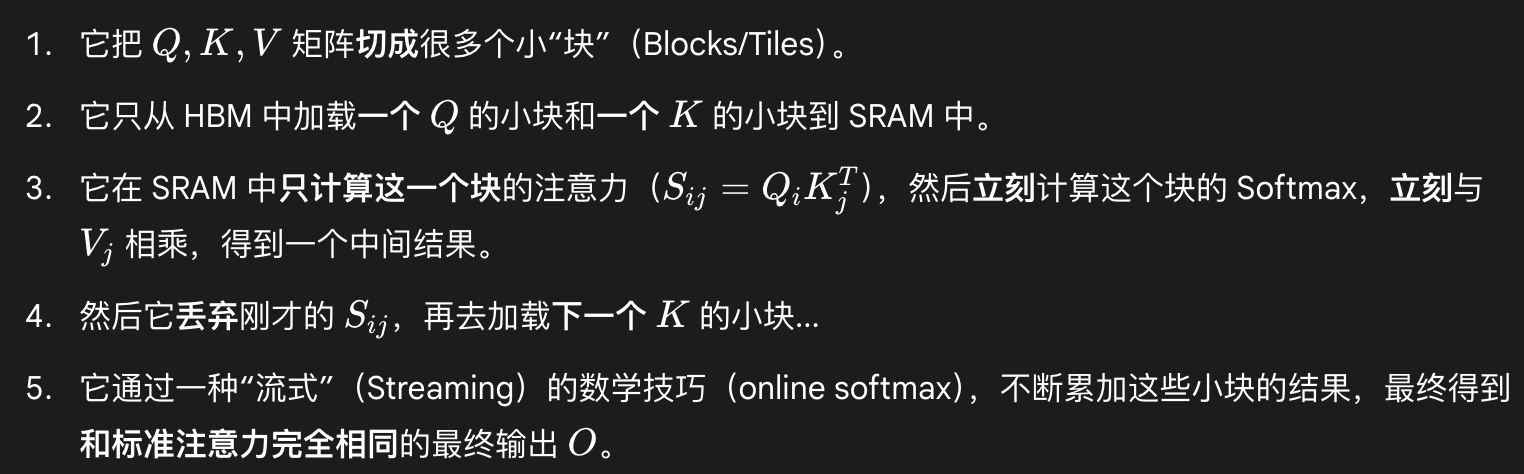
解决方法:
FlashAttention 采用两种技术,将所有计算步骤“融合”到一个 CUDA 内核(Kernel)中:
-
内核融合(Kernel Fusion)
FlashAttention把所有计算步骤都放到GPU里不需要传进传出。
-
分块/瓦片技术(Tiling)
注意基础概念:
CUDA概念:显卡的高带宽显存(HBM,速度慢容量大);高速片上内存(on-chip memory);这个内存中有静态RAM(SRAM,速度快容量小)。
FlashAttention 简单来说就是用了两层for循环:第一层循环Q;第二层循环K和V。
-
伪代码如下:
import torch
import torch.nn as nn
import math

# --- 假设的超参数 (Hyperparameters) ---
# 批次大小 (Batch Size): 8
# 序列长度 (Sequence Length): 100
# 模型维度 (d_model): 512
# 头的数量 (num_heads): 8
# 头的维度 (head_dim): 512 / 8 = 64
# ------------------------------------

class MultiHeadAttention(nn.Module):
    """
    一个从零开始实现的多头注意力模块 (Python 伪代码)
    """
    def __init__(self, d_model, num_heads):
        super(MultiHeadAttention, self).__init__()

        # 确保 d_model 可以被 num_heads 整除
        assert d_model % num_heads == 0, "d_model 必须能被 num_heads 整除"

        # 定义模型的关键维度
        self.d_model = d_model       # 模型的总维度 (512)
        self.num_heads = num_heads   # 头的数量 (8)
        self.head_dim = d_model // num_heads # 每个头的维度 (64)

        # --- 1. 定义线性投影层 (W_q, W_k, W_v, W_o) ---
        # 这些是模型需要学习的“权重”
        # 它们将 (B, S, 512) 映射到 (B, S, 512)
        self.W_q = nn.Linear(d_model, d_model) # Query 投影层
        self.W_k = nn.Linear(d_model, d_model) # Key 投影层
        self.W_v = nn.Linear(d_model, d_model) # Value 投影层

        # 这是 MHA 最后的“输出”投影层
        self.W_o = nn.Linear(d_model, d_model) # Output 投影层

    def forward(self, query, key, value, mask=None):
        """
        前向传播
        在“自注意力”中, query, key, 和 value 都是同一个输入 X
        在“交叉注意力”中, query 是一个, 而 key 和 value 是另一个
        """

        # --- 2. 获取批次大小 ---
        # query, key, value 的形状: [batch_size, seq_len, d_model]
        # 示例: [8, 100, 512]
        batch_size = query.shape[0]

        # --- 3. 线性投影 (Linear Projection) ---
        # (B, S, 512) -> (B, S, 512)
        Q = self.W_q(query)
        K = self.W_k(key)
        V = self.W_v(value)

        # --- 4. “拆分头”与“转置” (Split & Transpose for BMM) ---
        # 这是为了实现“单卡并行多头” (BMM技巧) 的关键一步

        # 4a. 拆分 (Reshape):
        # (B, S, 512) -> (B, S, num_heads, head_dim)
        # 示例: (8, 100, 512) -> (8, 100, 8, 64)
        Q = Q.view(batch_size, -1, self.num_heads, self.head_dim)
        K = K.view(batch_size, -1, self.num_heads, self.head_dim)
        V = V.view(batch_size, -1, self.num_heads, self.head_dim)

        # 4b. 转置 (Transpose / Permute):
        # (B, S, H, D_h) -> (B, H, S, D_h)
        # 我们把“头的数量”(H) 提到“序列长度”(S) 之前,
        # 这样 GPU 就可以把 (B * H) 看作一个大批次,并行处理 8*8=64 个注意力计算
        # 示例: (8, 100, 8, 64) -> (8, 8, 100, 64)
        Q = Q.permute(0, 2, 1, 3)
        K = K.permute(0, 2, 1, 3)
        V = V.permute(0, 2, 1, 3)

        # --- 5. 计算注意力分数 (Scaled Dot-Product Attention) ---

        # 5a. 矩阵乘法 Q @ K^T
        # Q 形状:   (8, 8, 100, 64)
        # K^T 形状: (8, 8,  64, 100)
        # scores 形状: (8, 8, 100, 100)

        ##### 注意!这里用torch实现了2层for循环 #####
        scores = torch.matmul(Q, K.transpose(-1, -2))

        # 5b. 缩放 (Scaling)
        # 除以 head_dim 的平方根,防止梯度消失
        scale_factor = math.sqrt(self.head_dim)
        scores = scores / scale_factor

        # 5c. 应用掩码 (Masking)
        # (这是可选的, 但在 Decoder 中必须有)
        if mask is not None:
            # mask 必须被塑造成 (8, 1, 1, 100) 或 (8, 8, 100, 100)
            scores = scores.masked_fill(mask == 0, float('-1e9'))

        # 5d. Softmax
        # 沿着最后一个维度 (K 的序列) 计算, 使每行的和为 1
        # 形状不变: (8, 8, 100, 100)
        attention_weights = torch.softmax(scores, dim=-1)

        # --- 6. 将分数应用于 V (Apply to V) ---

        # attention_weights 形状: (8, 8, 100, 100)
        # V 形状:                 (8, 8, 100,  64)
        # context 形状:           (8, 8, 100,  64)
        # 这是 MHA 的“加权求和”步骤
        context = torch.matmul(attention_weights, V)

        # --- 7. “合并头” (Concatenate Heads) ---
        # 这是 BMM 技巧的“逆操作”

        # 7a. 转置 (Transpose / Permute):
        # (B, H, S, D_h) -> (B, S, H, D_h)
        # 示例: (8, 8, 100, 64) -> (8, 100, 8, 64)
        context = context.permute(0, 2, 1, 3)

        # 7b. 重塑 (Reshape / View):
        # 把所有头“拼接”回一个 d_model 向量
        # (B, S, H, D_h) -> (B, S, H * D_h) -> (B, S, d_model)
        # 示例: (8, 100, 8, 64) -> (8, 100, 512)
        # .contiguous() 是在 permute 后必须的, 确保内存是连续的
        context = context.contiguous().view(batch_size, -1, self.d_model)

        # --- 8. 最终线性层 (Final Linear Layer) ---
        # (B, S, 512) -> (B, S, 512)
        # 这一步 W_o 矩阵会“混合”所有头的信息
        output = self.W_o(context)

        return output

# --- 示例用法 ---
if __name__ == "__main__":

    # 1. 定义参数
    BATCH_SIZE = 8
    SEQ_LENGTH = 100
    D_MODEL = 512
    NUM_HEADS = 8

    # 2. 创建 MHA 模块
    mha = MultiHeadAttention(d_model=D_MODEL, num_heads=NUM_HEADS)

    # 3. 创建一个随机输入张量 X (用于自注意力)
    # 形状: (batch_size, seq_len, d_model) -> (8, 100, 512)
    X = torch.rand(BATCH_SIZE, SEQ_LENGTH, D_MODEL)

    print(f"输入 X 的形状: {X.shape}")

    # 4. 执行前向传播
    # 在自注意力 (self-attention) 中, Q, K, V 都是 X
    output = mha(query=X, key=X, value=X, mask=None)

    print(f"输出 O 的形状: {output.shape}")

    # 预期输出:
    # 输入 X 的形状: torch.Size([8, 100, 512])
    # 输出 O 的形状: torch.Size([8, 100, 512])
2. Reinforcement learning frameworks
TODO
资料
- 谷歌ML电子书:https://jax-ml.github.io/scaling-book/index:
- 英伟达博客:https://developer.nvidia.com/blog/mastering-llm-techniques-inference-optimization/
- Lilian网红博客:https://lilianweng.github.io/posts/2023-01-10-inference-optimization/ (long article with quantization, etc)
- 硬核ML博客:https://ralphmao.github.io/ML-software-system/
论文
- DeepSeek V3 Technical Report
- Mooncake: KV cache
- DistServe: disaggregated serving