1. 汉诺塔问题
-
问题: 将汉诺塔从A移动到C, 小圆盘必须在大圆盘上面.
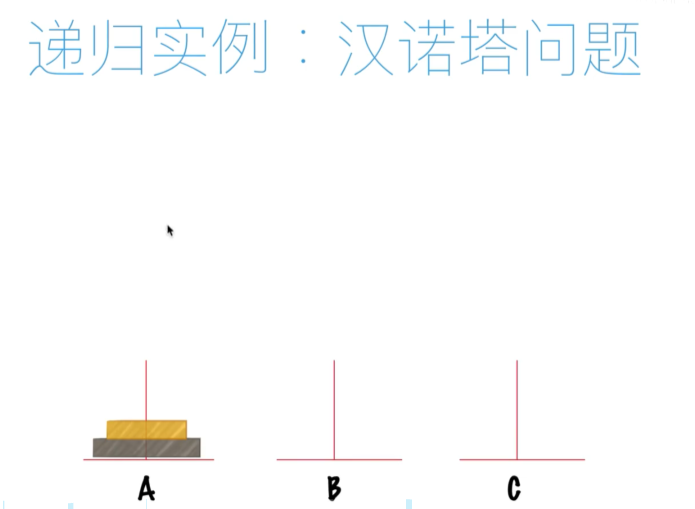
-
分析:
可以将最底下的一块圆盘作为独立个体, 上面的所有圆盘作为另一个个体. 则整个汉诺塔的移动步骤如下.
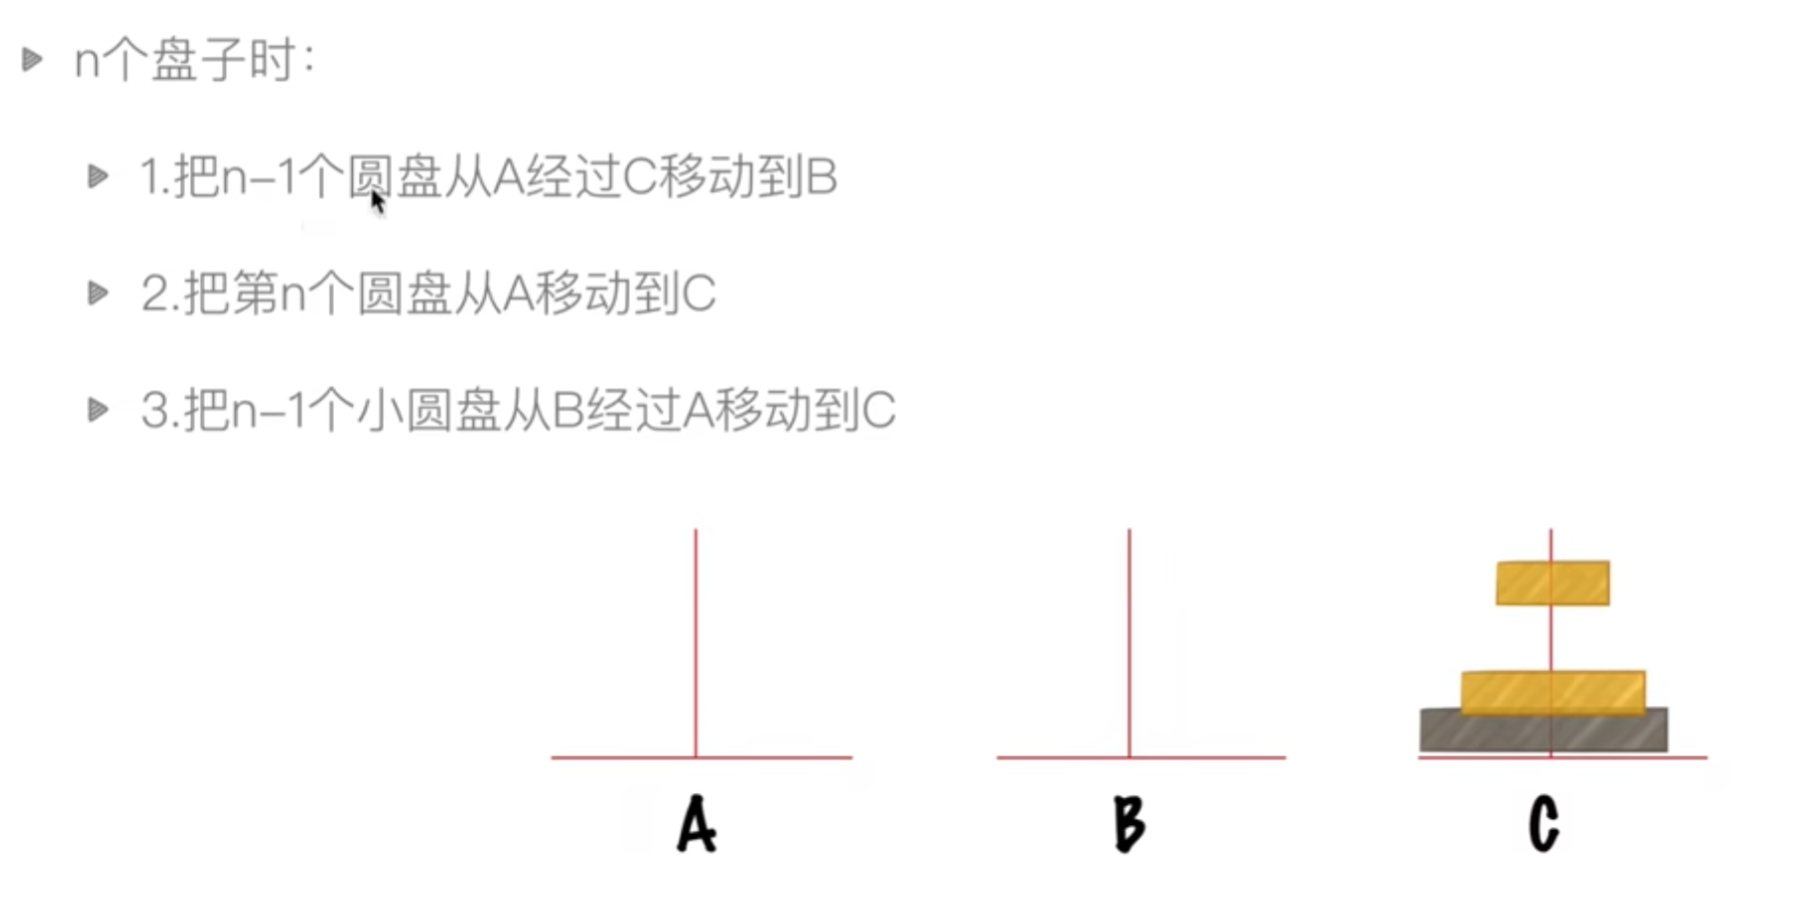
算法实现:
def hanoi(n, a, b, c):
    if n > 0:
        hanoi(n-1, a, c, b)
        print(f"move {a} to {c}")
        hanoi(n-1, b, a, c)

hanoi(3, 'a','b','c')
2. 查找
2.1. 顺序查找
def linear_search(li, val):
    """顺序查找

    Args:
        li (_type_): _description_
        val (_type_): _description_

    Returns:
        _type_: _description_
    """
    for index, value in enumerate(li):
        if val == value:
            return index
    return None
2.2. 二分查找
def binary_search(li, val):
    """二分查找, 必须是顺序排列的列表

    Args:
        li (_type_): _description_
        val (_type_): _description_

    Returns:
        _type_: _description_
    """
    left = 0
    right = len(li) - 1
    while right >= left and right < len(li):
        print("right: ", right)
        print("left: ", left)
        mid = (right + left) // 2
        print("mid: ", mid)
        if li[mid] == val:
            return mid
        elif li[mid] > val:
            right = mid - 1
        else:
            left = mid + 1
    return None
3. 排序算法
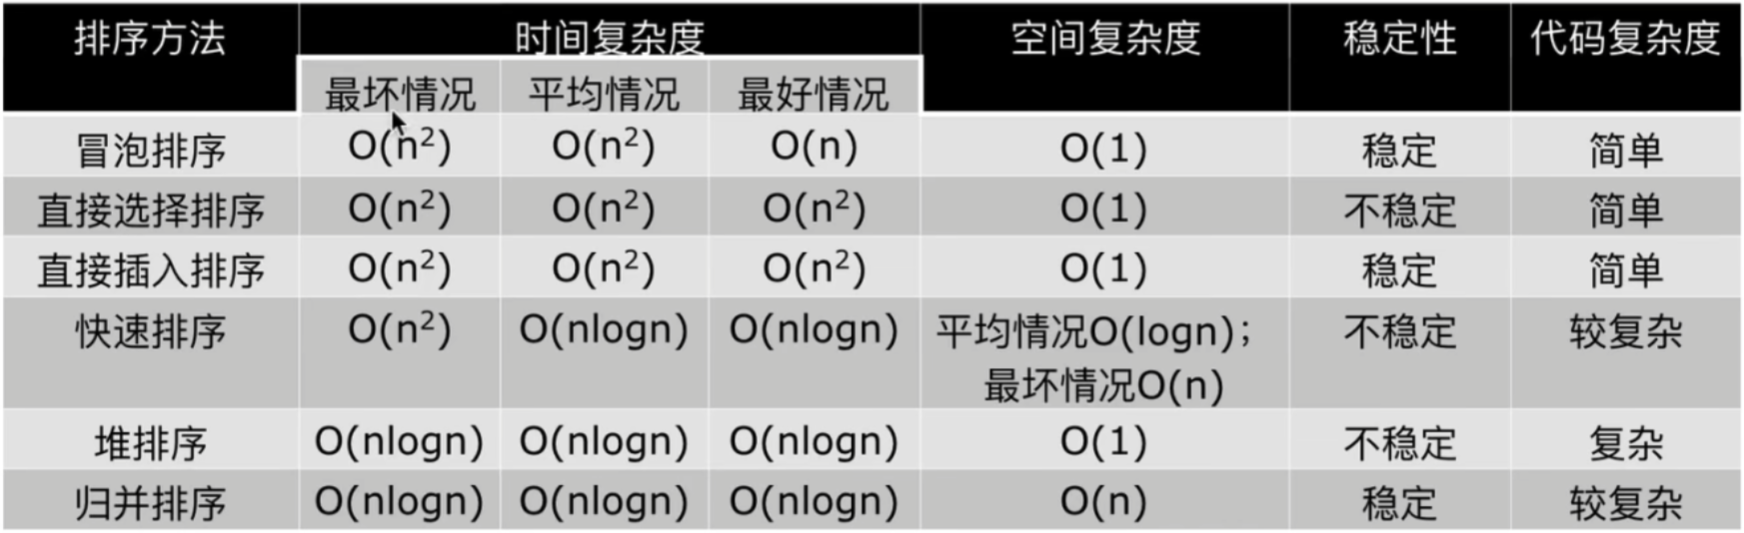
1.1. 简单
1.1.1. 冒泡排序
- 像气泡向上冒一样, 想象列表竖直.
- 第0轮: 从列表i=0位置开始. 如果最底部(i=0)的数字A比上一个数B大, 就互换位置. 再将A与上一个数C对比, 以此类推.
- 第1轮: 从列表i=1位置开始.
- 第len(list)-1轮: 从列表i=len(list)-1位置开始.
def bubble_sort(random_list):
    """冒泡排序(升序排列). 遍历列表, 如果当前数字比它之后的数字大, 就对换位置.
        时间复杂度: O(n^2)
    Args:
        random_list (_type_): _description_
    """
    for i in range(len(random_list)-1):  # 选中一个数字(不包括最后一个数字)
        print(random_list)
        break_flag = True  # 如果全程没有更新, 则排序已经完成, 终止循环
        for j in range(len(random_list)-i-1):  # 挨个遍历, 但是最后一个数不取到
            if random_list[j] > random_list[j+1]:  # 选中数大就对换位置
                random_list[j], random_list[j+1] = random_list[j+1], random_list[j]
                break_flag = False
        if break_flag:
            break

    return random_list
1.1.2. 选择排序
- 遍历找最小
def select_sort_simple(random_list):
    """选择排序v1(升序排列).
       只遍历一次, 将最小的数加入新的list
       时间复杂度: O(n)
       空间复杂度: O(n)
    Args:
        random_list (_type_): _description_
    """
    sort_list = []
    while len(random_list) != 0:
        min_value = min(random_list)
        sort_list.append(min_value)
        random_list.remove(min_value)

    return sort_list

def select_sort(random_list):
    """选择排序v2(升序排列).
       每次遍历都将最小的数放到遍历区最左端
       时间复杂度: O(n^2)
       空间复杂度: O(1)
    Args:
        random_list (_type_): _description_
    """
    for i in range(len(random_list)-1):
        for j in range(i, len(random_list)):
            if random_list[i] > random_list[j]:
                random_list[i], random_list[j] = random_list[j], random_list[i]
    return random_list
1.1.3. 插入排序
-
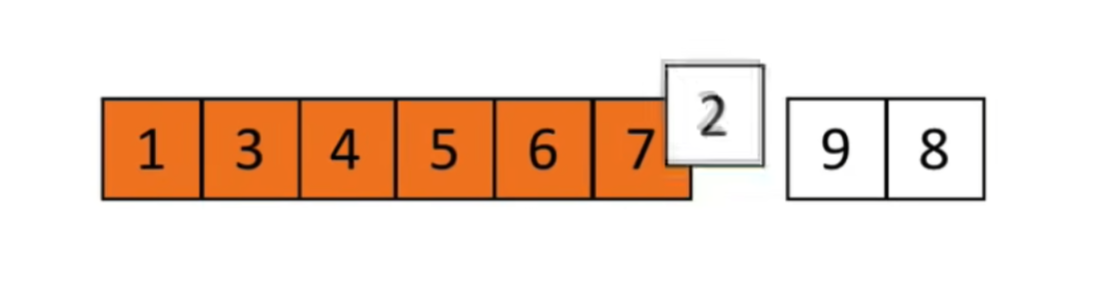
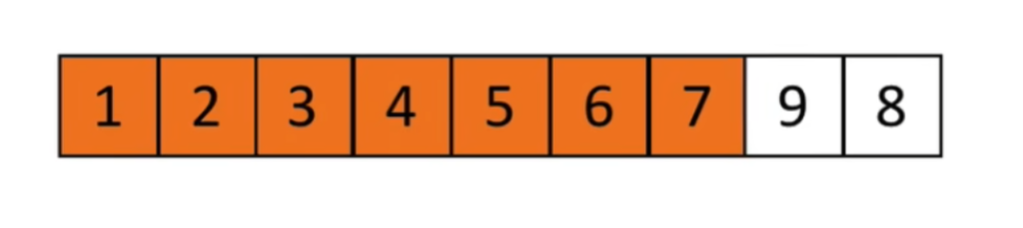
从左边开始遍历, 像打牌时的理牌一样操作.
-
提取遍历到的数, 将比它大的数各右移一格, 这个数插入空档中.
def insert_sort(random_list):
    """
        插入排序
        时间复杂度: O(n^2)
        空间复杂度: O(1)
    Args:
        random_list (_type_): _description_
    """
    for i in range(1, len(random_list)):
        tmp = random_list[i]
        j = i - 1
        while j >= 0 and tmp < random_list[j]:
            random_list[j+1] = random_list[j]
            j -= 1
        random_list[j+1] = tmp

    return random_list
1.2. 困难
1.2.1. 快速排序
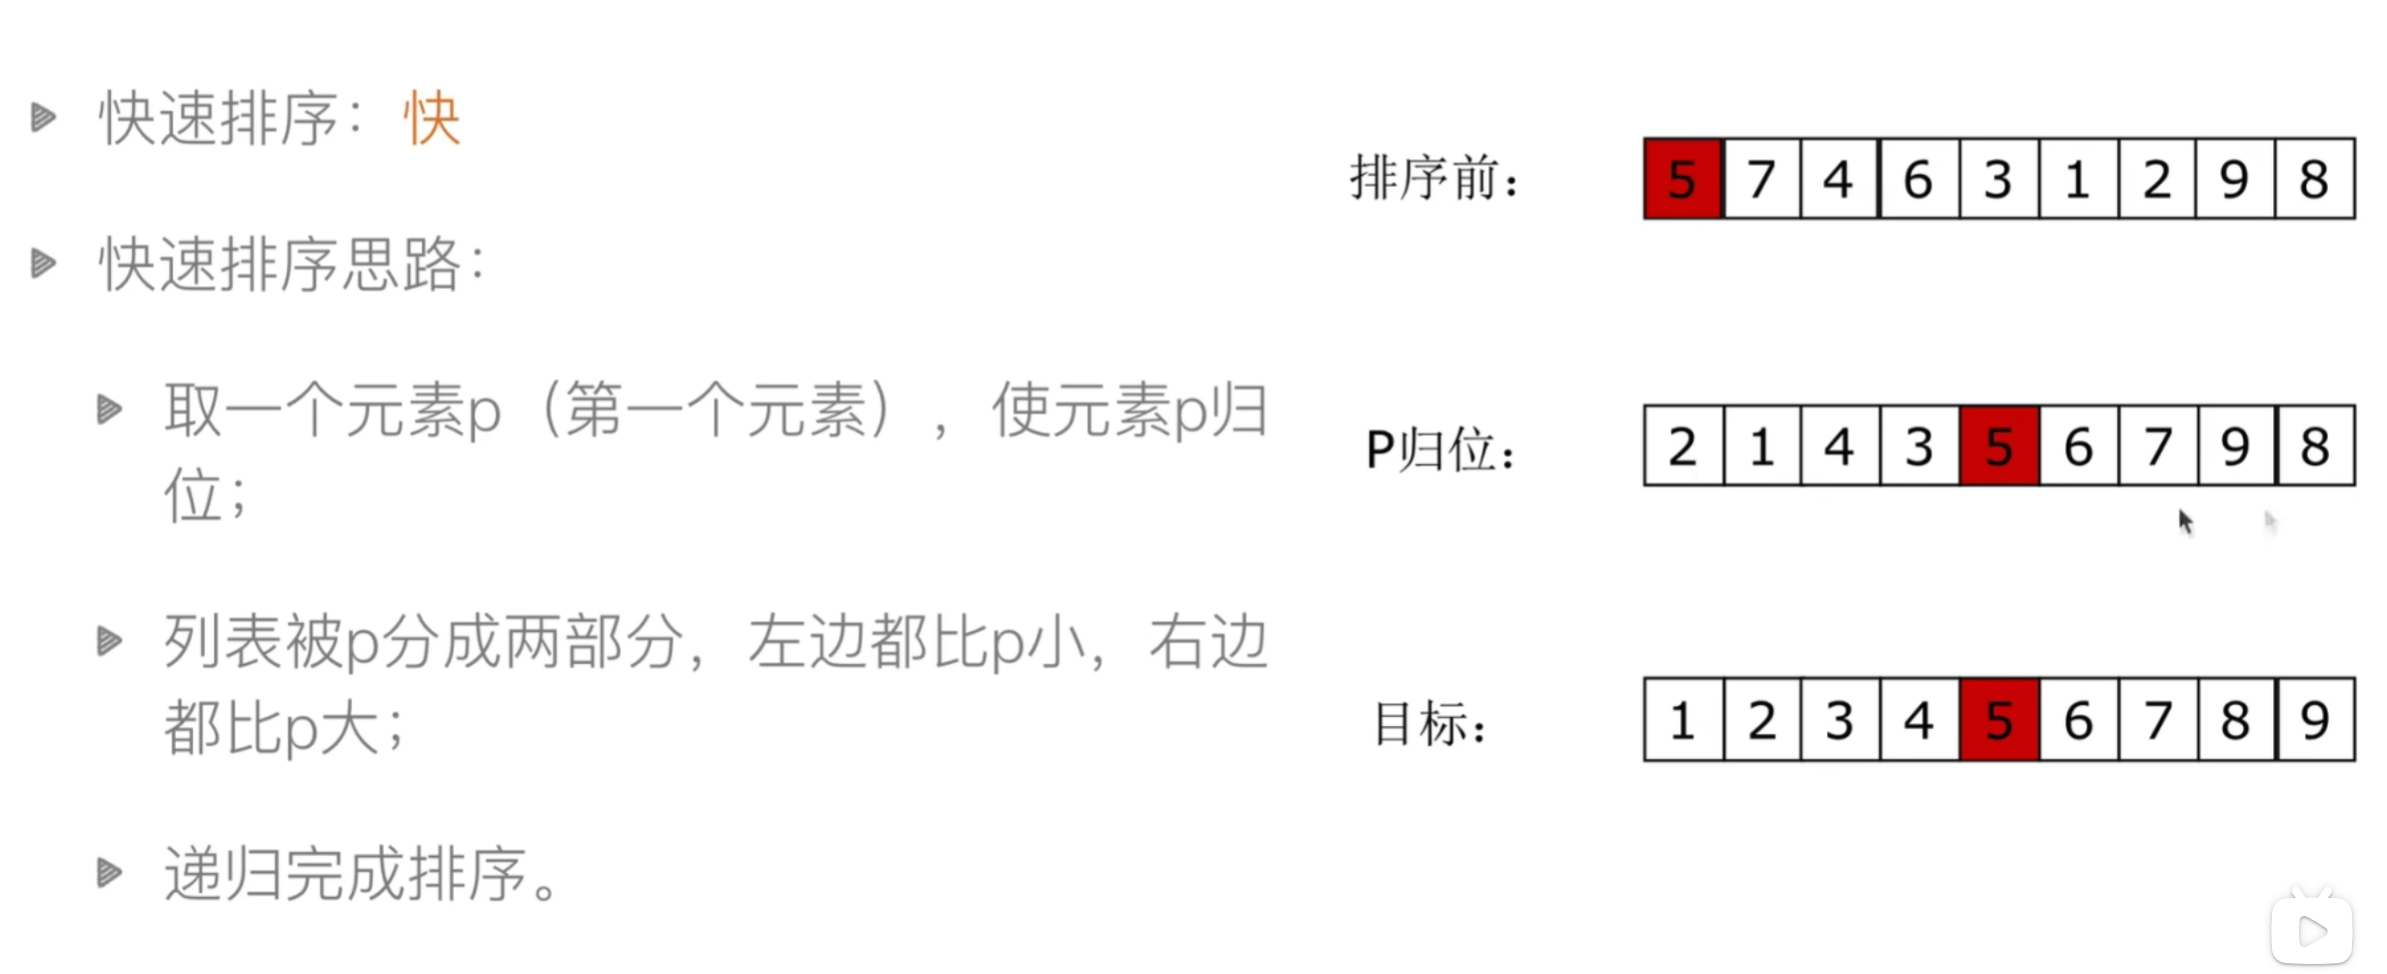
缺点: 递归的层数是有限制的, windows下限制为998. 修改限制后能到达3929层左右. 无法处理更长的列表
-
时间复杂度推导
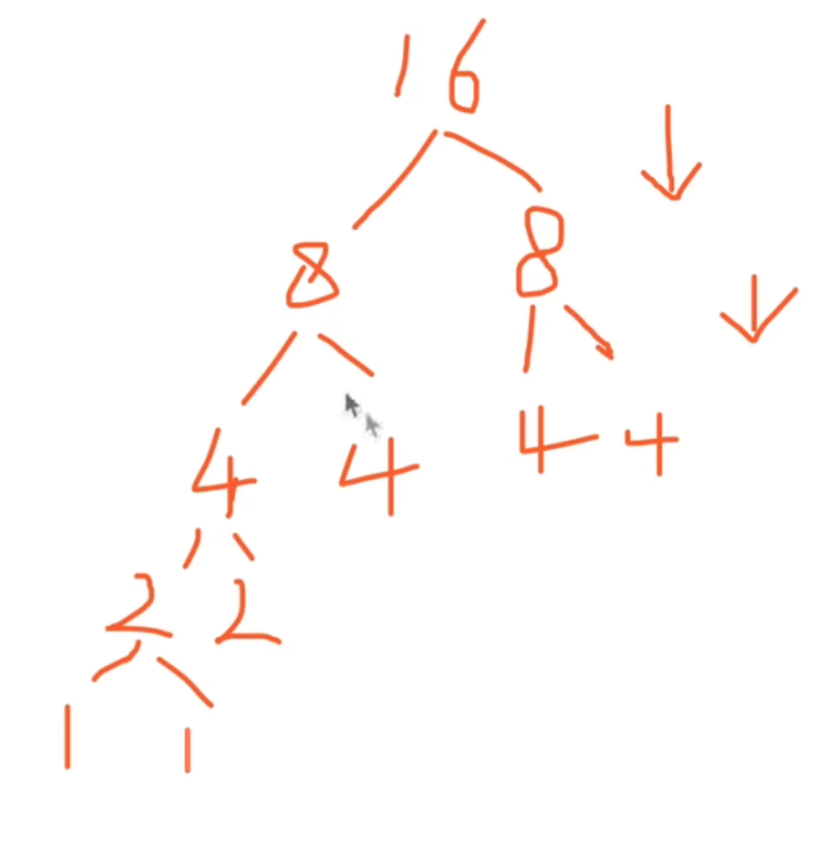
- 每一层的partition各自的时间复杂度是O(n), 如第2层每个partition的时间复杂度都是O(8).
- 一共有logn层
- 得出总共的时间复杂度为O(nlogn)
-
代码
class QuickSort():
    """
    快速排序
    1. 取元素p(列表第一个元素)使元素p归位
    2. 列表分为两部分, p左边都比p小, 右边都比p大
    3. 递归完成排序
		时间复杂度: O(nlogn)
    空间复杂度: O(1)

    Args:
        input_list (_type_): _description_
    """

    def __init__(self, input_list):
        self.input_list = input_list

    def partition(self, left, right):
        """
        取index=left的数A(额外保存), 则list[left]留出空位
        从index=right的数B开始向左
        if B>=A: B不动, left指针不动, right指针开始向左移动
        if B<A: B移动到li[left]位置, right指针暂停left指针开始向右移动
        if left==right: return left (找到中间值)

        Args:
            left (_type_): _description_
            right (_type_): _description_
        """
        keep_mid = self.input_list[left]
        while left < right:
            while left < right and self.input_list[right] >= keep_mid:
                right -= 1
            self.input_list[left] = self.input_list[right]
            while left < right and self.input_list[left] <= keep_mid:
                left += 1
            self.input_list[right] = self.input_list[left]

        self.input_list[left] = keep_mid
        return left

    def quick_sort(self, left, right):
        if left < right:
            mid = self.partition(left, right)  # 算出下标的位置
            self.quick_sort(left, mid-1)
            self.quick_sort(mid+1, right)
        return self.input_list
1.2.2. 堆排序
-
树与二叉树
- 概念
- 根节点, 叶子节点
- 树的深度
- 树的度(同一深度最多的子节点个数)
- 孩子节点和父节点
- 子树
- 树是一种数据结构
- 树是由n个节点组成的集合
- if n=0, 这是一颗空树
- if n>0, 存在一个节点作为树的根节点, 其他节点可以分为m个集合, 每个集合本身又是一棵树
- 二叉树的顺序存储方式
- 二叉树的每层节点个数
- $2^0\ 2^1\ 2^2\ 2^3$
- 父节点与左孩子节点的编号下标关系
- $i\rightarrow2i+1$
- 父节点与右孩子节点的编号下标关系
- $i\rightarrow2i+2$
- 从孩子节点推断父节点的编号下标
- $j\rightarrow(i-1)//2$
- 大根堆满足:
- 完全二叉树
- 任一节点都比其孩子节点大
- 小根堆满足:
- 完全二叉树
- 任一节点都比其孩子节点小
- 二叉树的每层节点个数
- 概念
-
堆的向下取数
-
从父节点推算子节点
child_l = 2 * root + 1 child_r = 2 * root + 2 -
从最后一个非子节点开始(需要推断父节点位置)
if len(list) = n
	last node = n-1
if child node = n-1
	parent node = ((n-1)-1)//2
							= n//2-1
-
-
堆排序
-
建立堆
从最后一个叶子节点开始向上调整
-
得到对顶元素, 为最大元素
-
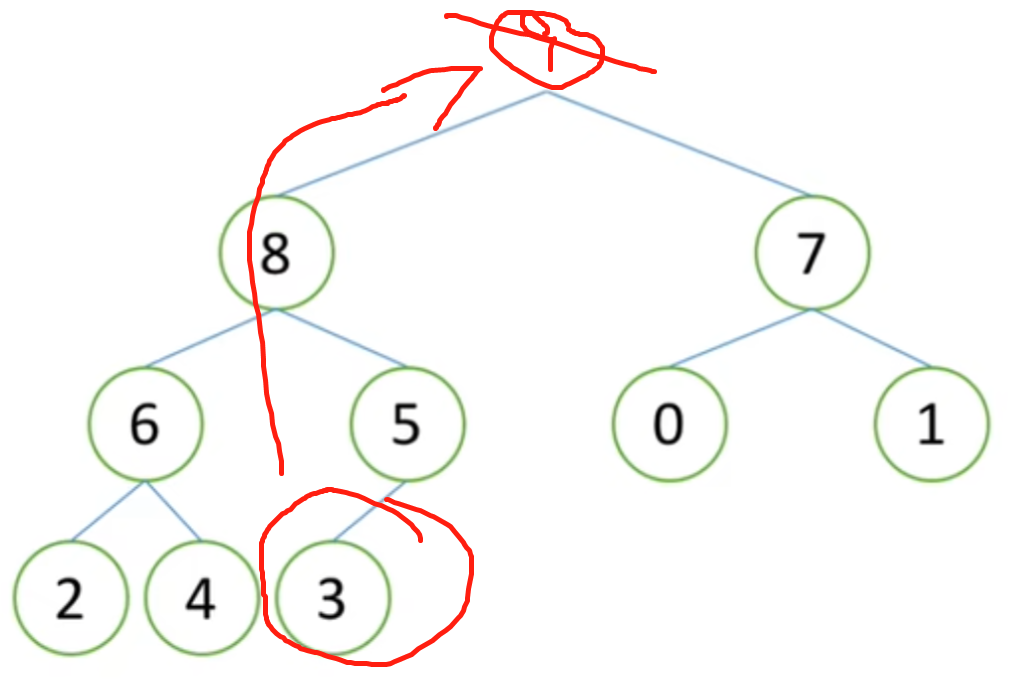
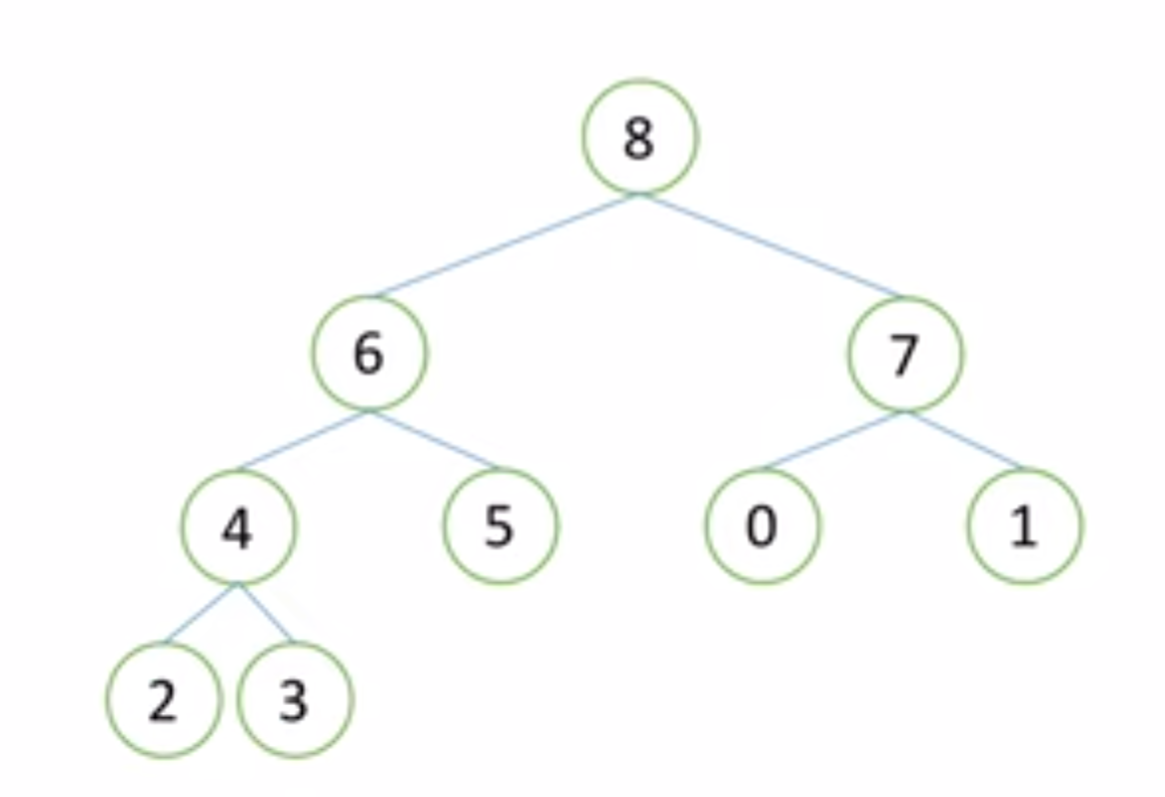
去掉堆顶, 将堆最后一个元素放到堆顶, 此时可通过一次调整重新使堆有序(就是挨个出数)
- 不使用额外空间: 去掉顶部元素9的时候, 将9移动到3的位置, 将堆的结尾指针移动到4.
-
堆顶元素为第二大元素
-
重复步骤3, 直到堆变空
-
实现堆排序代码
class HeapSort(): def __init__(self, input_list): self.input_list = input_list @staticmethod def sift(list_, low, high): """ 向下调整 时间复杂度: O(logn) 空间复杂度: O(1) Args: low (_type_): 堆的根节点的位置 high (_type_): 堆的最后一个元素的位置 IS_MAX_HEAP (_type_): 是否是大根堆, 默认为True """ i = low # i初始转态指向根节点 j = 2*i+1 # j初始状态是i的左孩子 tmp = list_[low] # 存放根节点 while j <= high: # 说明j的位置有数(在列表内) # 使j指向大的那个孩子节点 # j右边有数, 并且j右边的数大于j指向的数(大根堆) if j+1 <= high and list_[j+1] > list_[j]: j += 1 # j指向右孩子 # 如果当前j指向的位置的数大于根节点, 就替换掉根节点(大根堆) if list_[j] > tmp: list_[i] = list_[j] i = j # 根节点向下一层(孩子节点作为根节点) j = 2*i+1 else: # 如果j指向的数小于tmp, tmp放到某个根节点(tmp下面的子节点小于tmp但上面的根节点大于tmp) list_[i] = tmp break else: # 如果j走出了列表的范围(根节点此时指向最后一层, j指向最后一层的下一层), 循环终止, tmp放到i指向的位置 list_[i] = tmp def heap_sort(self): """ 时间复杂度: O(nlogn) 空间复杂度: O(1) Returns: _type_: _description_ """ len_list = len(self.input_list) # 构造堆 # 循环: 从最后一个父节点开始都过来遍历 # 最后一个孩子节点为n-1, n为列表长度, 则最后一个父节点为n//2-1 # i表示建立堆的时候, 调整的部分的根的下标 for i in range(len_list//2-1, -1, -1): self.sift(self.input_list, i, len_list-1) print("create heap\n", self.input_list) # 开始排序 # i表示当前堆的最后一个元素位置 for i in range(len_list-1, -1, -1): self.input_list[0], self.input_list[i] = self.input_list[i], self.input_list[0] self.sift(self.input_list, 0, i-1) # i-1, 更新堆的最后一个元素位置 return self.input_list -
使用python内置库, 进行堆排序
def heap_sort_py(random_list):
    """使用python内置库, 进行堆排序

    Args:
        random_list (_type_): _description_

    Returns:
        _type_: _description_
    """
    heapq.heapify(random_list)  # 建立堆
    res_list = []
    for _ in range(len(random_list)):
        res_list.append(heapq.heappop(random_list))
    return random_list
-
-
堆排序topK问题
-
原理:
- 在列表中取k个元素, 用这些元素建立一个小根堆(堆顶是堆里最小的).
- 遍历剩下的列表, 元素小于堆顶的忽略, 大于堆顶的放在堆顶, 对堆进行调整.
-
性能
- 时间复杂度: O(nlogk)
-
代码实现
class HeapSortTopK():
    def __init__(self, input_list):
        self.input_list = input_list

    @staticmethod
    def sift(list_, low, high):
        """
        向下调整
        时间复杂度: O(logn)
        空间复杂度: O(1)

        Args:
            low (_type_): 堆的根节点的位置
            high (_type_): 堆的最后一个元素的位置
        """
        i = low  # i初始转态指向根节点
        j = 2*i+1  # j初始状态是i的左孩子
        tmp = list_[low]  # 存放根节点
        while j <= high:  # 说明j的位置有数(在列表内)
            # 使j指向大的那个孩子节点
            # j右边有数, 并且j右边的数大于j指向的数(大根堆)
            if j+1 <= high and list_[j+1] < list_[j]:
                j += 1  # j指向右孩子
            # 如果当前j指向的位置的数小于根节点, 就替换掉根节点(大根堆)
            if list_[j] < tmp:
                list_[i] = list_[j]
                i = j  # 根节点向下一层(孩子节点作为根节点)
                j = 2*i+1
            else:
                break
            list_[i] = tmp

    def topk(self, k):
        """
        只排序列表中前k个大的数(不重复).
        原理:
        - 在列表中取k个元素, 用这些元素建立一个小根堆(堆顶是堆里最小的).
        - 遍历剩下的列表, 元素小于堆顶的忽略, 大于堆顶的放在堆顶, 对堆进行调整.
            - 因为是小根堆, 所以堆顶的元素最小
        时间复杂度: O(nlogk)
        空间复杂度: O(1)

        Args:
            k (_type_): _description_

        Returns:
            _type_: _description_
        """
        # 取k个元素建一个小根堆
        heap = self.input_list[:k]
        for i in range(len(heap)//2-1, -1, -1):
            self.sift(heap, i, len(heap)-1)
        print(heap)

        # 遍历剩下的列表
        for i in range(k, len(self.input_list)):
            # 剩下的元素大于堆顶的, 替换堆顶元素
            if self.input_list[i] > heap[0]:  # 注意, 这里用的是大于不是大于等于, 忽略了重复的数字
                heap[0] = self.input_list[i]
                self.sift(heap, 0, k-1)  # 进行一波堆整理
            print(self.input_list[i])
            print(heap)

        # 排序结束, 出数
        for i in range(k-1, -1, -1):
            # 替换堆顶和最后一个父节点
            heap[0], heap[i] = heap[i], heap[0]
            self.sift(heap, 0, i-1)  # 进行一波堆整理
            # print(heap)

        return heap
-
1.2.3. 归并排序
-
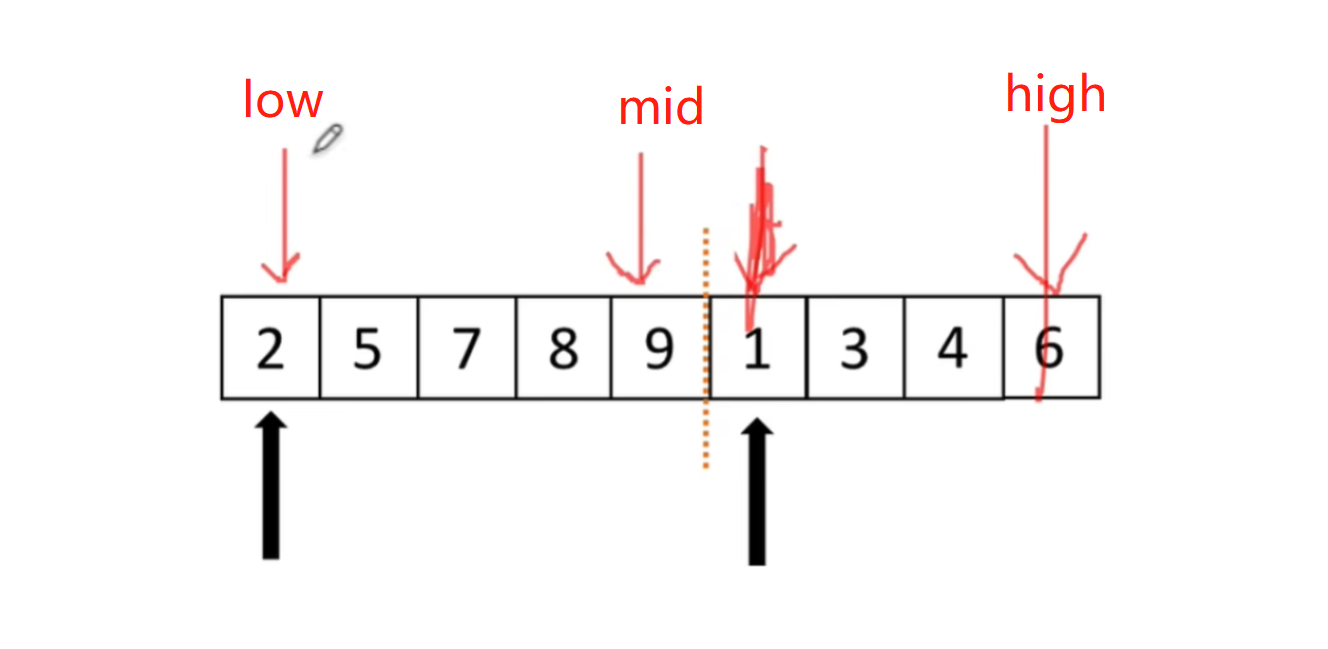
原理
- 分解: 将列表不断一分为二, 直到只剩一个元素
- 合并: 将有序列表归并, 直到合成一个列表
-
代码
class MergeSort():
    def __init__(self, input_list) -> None:
        self.input_list = input_list

    def merge(self, low, mid, high):
        """
        合并列表
        这个函数存在要求, 前一半和后一半必须都是有序的(都是从小到大排列)
        从小到大排序
        时间复杂度: O(nlogn)
        空间复杂度: O(n)

        Args:
            low (_type_): 当前列表最左端
            mid (_type_): 当前列表中间
            high (_type_): 当前列表最右端
        """
        i = low  # 左半部分指针位置
        j = mid + 1  # 右半部分指针位置
        tmp_list = []
        while i <= mid and j <= high:
            if self.input_list[i] < self.input_list[j]:
                tmp_list.append(self.input_list[i])
                i += 1
            else:
                tmp_list.append(self.input_list[j])
                j += 1

        # 循环结束之后, 剩下的一边必定是顺序且比tmp_list中最大的元素大
        while i <= mid:
            # 如果i还剩下
            tmp_list.append(self.input_list[i])
            i += 1
        while j <= high:
            tmp_list.append(self.input_list[j])
            j += 1

        self.input_list[low: high+1] = tmp_list

    def split(self, low, high):
        """
        递归将列表分解, 直到只有两端列表各只有1个元素
        这两个元素开始合并

        Args:
            low (_type_): _description_
            high (_type_): _description_
        """
        if low < high:  # 至少需要两个元素
            mid = (low + high) // 2
            # 递归分解
            self.split(0, mid)
            self.split(mid+1, high)
            # 两个有序列表合并
            self.merge(low, mid, high)
4. 栈
-
原理:
- 只能从一端进出
- 后进先出
-
操作:
- 进栈: push
- 出栈: pop
- 取栈顶: gettop
-
栈的实现
class Stack(): def __init__(self) -> None: self.stack = [] def push(self, element): self.stack.append(element) def pop(self): return self.stack.pop() def get_top(self): if len(self.stack) > 0: return self.stack[-1] else: return None def is_empty(self): return len(self.stack) == 0 def show(self): return self.stack -
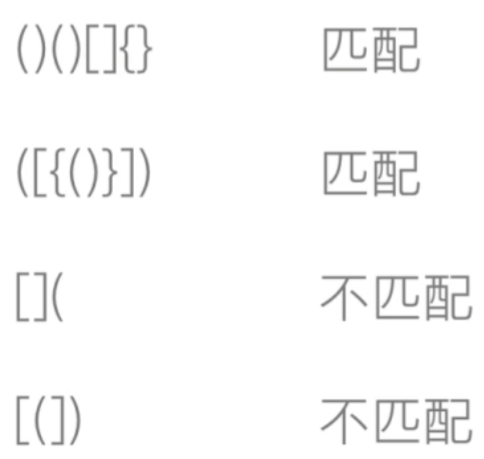
括号匹配问题
def bracket_match(li):
    """匹配完整形式的括号列表

    Args:
        li (_type_): _description_
    """
    # 建立字典
    b_dict = {'[': ']', '(': ')', '{': '}'}
    stack = Stack()
    for ele in li:
        if ele in b_dict:
            # 元素为左括号
            stack.push(ele)
        else:
            # 元素为右括号
            if stack.is_empty():
                return False
            elif b_dict[stack.get_top()] == ele:
                stack.pop()
            else:
                return False

        print(stack.show())
    # 全部遍历完之后, 如果是一个空列表, 则括号列表是符合规定的
    return stack.is_empty()
5. 队列
-
原理
- 从队尾(rear)进, 从队头(front)出
- 先进先出
-
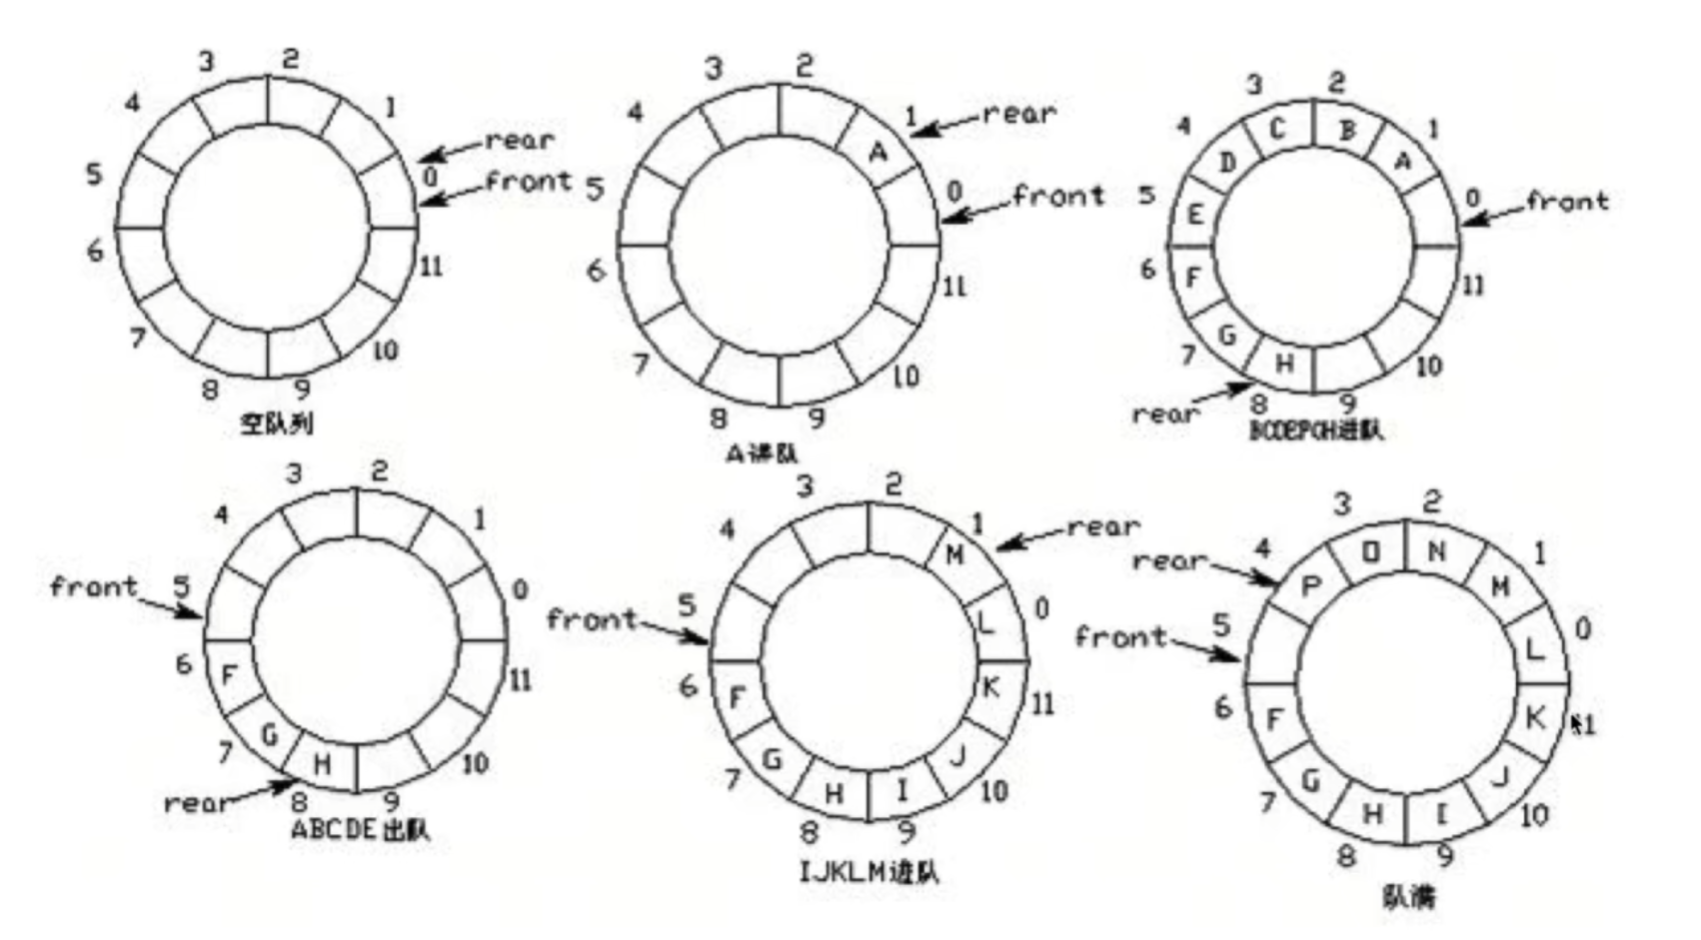
环形队列
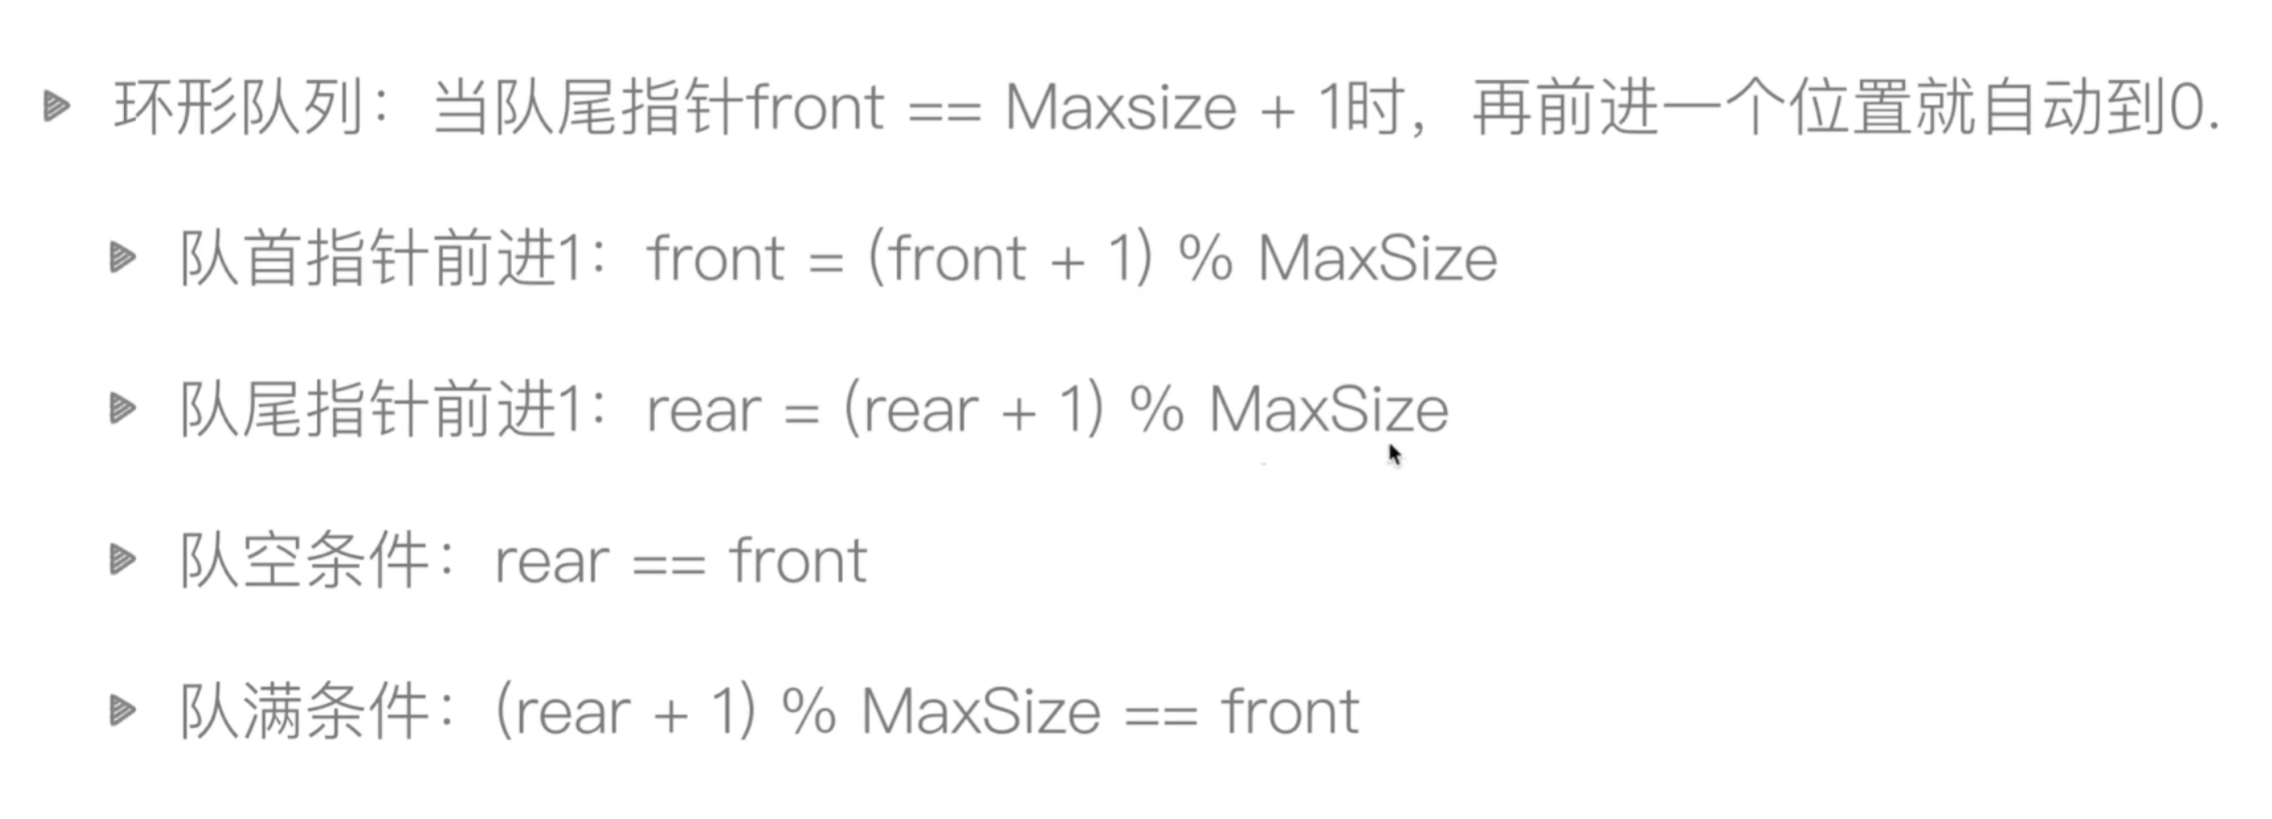
-
代码
class Queue:
    def __init__(self, size=100) -> None:
        self.size = size
        self.queue = [x for x in range(size)]
        self.rear = 0  # rear指向队尾的位置
        self.front = 0  # front指向队首的前一个位置

    def push(self, element):
        if not self.is_filled():
            self.rear = (self.rear + 1) % self.size
            self.queue[self.rear] = element
        else:
            raise IndexError('queue is filled')

    def pop(self):
        if not self.is_empty():
            self.front = (self.front + 1) % self.size
            return self.queue[self.front]
        else:
            raise IndexError('queue is empty')

    def is_empty(self):
        return self.rear == self.front

    def is_filled(self):
        return (self.rear + 1) % self.size == self.front

def main():
    q = Queue(5)
    for i in range(4):
        q.push(i)
    for i in range(4):
        print(q.pop())
-
-
双向队列
- 队首队尾两端都支持双向队列
q = deque([1, 2, 3], 5)  # 列表, 队列尺寸
q.append(4)
q.append(5)
q.append(6)
print(q)
for _ in range(5):
    print(q.popleft())

###########
deque([2, 3, 4, 5, 6], maxlen=5)
2
3
4
5
6
6. 栈和队列的应用 - 迷宫问题
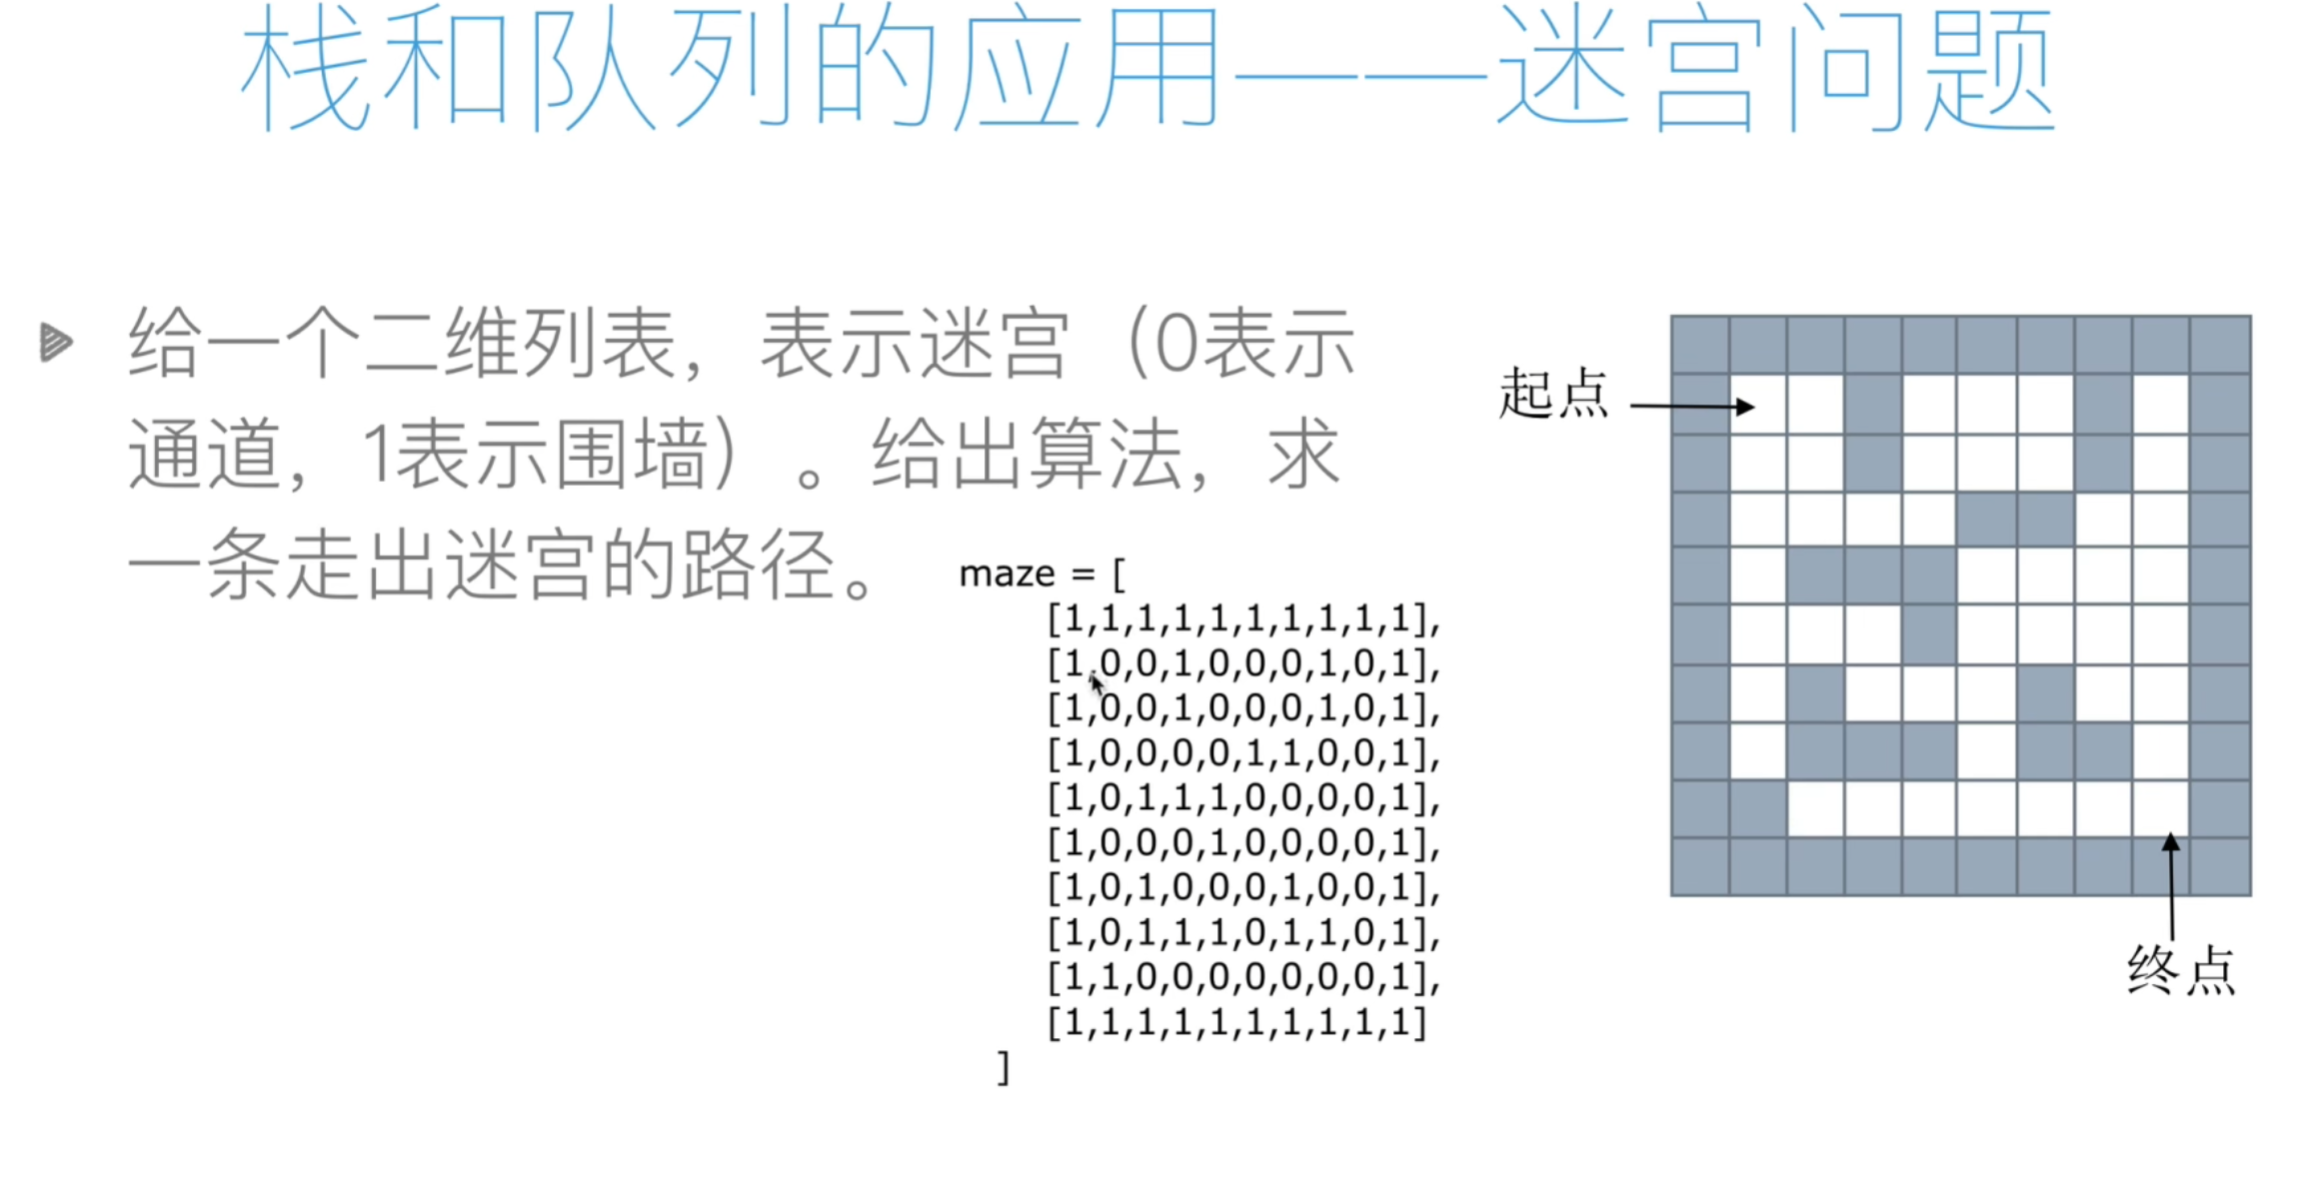
-
栈 深度优先算法(DFS)
- 使用回溯法
- 从一个节点开始, 任意找下一个能走的点, 当找不到能走的点时, 退回上一个点寻找是否有其他方向的点
- 使用栈存储当前路径
-
代码实现
def maze_path_dfs(maze, x1, y1, x2, y2):
    """使用深度优先算法走迷宫

    Args:
        x1 (_type_): 起点的x坐标
        y1 (_type_): 起点的y坐标
        x2 (_type_): 终点的x坐标
        y2 (_type_): 终点的y坐标
    """
    # 在迷宫中行走时用的四个方向
    dirs_path = [
        lambda x, y: (x+1, y),
        lambda x, y: (x-1, y),
        lambda x, y: (x, y+1),
        lambda x, y: (x, y-1),
    ]
    stack = []
    stack.append((x1, y1))  # 给栈添加起点

    while len(stack) > 0:  # 栈不为空的时候
        cur_node = stack[-1]
        if cur_node == (x2, y2):
            print(f"Find route: {stack}")
            return True

        for dir in dirs_path:
            next_node = dir(cur_node[0], cur_node[1])
            if maze[next_node[0]][next_node[1]] == 0:
                # 说明下一步是通的
                stack.append(next_node)
                maze[next_node[0]][next_node[1]] = 2  # 记录走过的坐标
                break  # 深度优先, 所以有路就直接跳出循环, 走下一步
        else:  # 这里的else在for循环结束为止没有break的情况下触发
            # 发现当前位置没有路时
            maze[cur_node[0]][cur_node[1]] = 2  # 当前位置堵上
            stack.pop()  # 回退一格

    return False
- 使用回溯法
-
队列 广度优先算法(BFS)
- 从一个节点开始, 寻找所有接下来能继续走的点, 继续不断寻找, 直到找到出口
- 使用队列存储当前正在考虑的节点
-
代码实现
def maze_path_bfs(maze, dirs_path, x1, y1, x2, y2):
    """使用广度优先算法走迷宫

    Args:
        maze (_type_): _description_
        dirs_path (_type_): _description_
        x1 (_type_): _description_
        y1 (_type_): _description_
        x2 (_type_): _description_
        y2 (_type_): _description_
    """
    from collections import deque

    queue = deque()
    queue.append((x1, y1, -1))  # 向队列的尾部(rear)加入初始位置
    save_path_list = []
    while len(queue) > 0:  # 如果队列长度为0, 说明起始位置周围都是墙壁
        cur_node = queue.popleft()  # 当前的位置是队列的头部(left)
        if cur_node[:2] == (x2, y2):
            print(save_path_list)
            print(route_print(save_path_list))
            return True
        # 这个list在for循环外, 所以它的长度可以表示dfs的当前层数
        save_path_list.append(cur_node)
        for dir in dirs_path:
            next_node = dir(cur_node[0], cur_node[1])
            if maze[next_node[0]][next_node[1]] == 0:  # 下一个位置是空的
                queue.append(
                    (next_node[0], next_node[1], len(save_path_list) - 1))
                maze[next_node[0]][next_node[1]] = 2
    else:
        return False
7. 链表
链表是由一系列节点组成的元素集合
链表的优点
- 链表在插入删除操作上快
- 链表的内存可以灵活分配, 没有栈和队列的容量限制
- 链表这种链式存储的数据结构对树和图的结构有很大的启发性
7.1. 创建单链表
-
头插法 头部插入新节点
- 节点中, item保存元素, next保存下一个节点的内存地址
- 从1开始, head移动到下一个节点
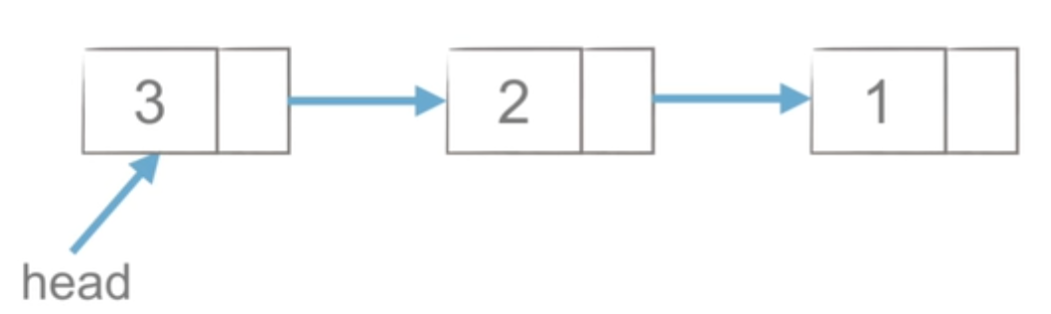
-
尾插法 尾部插入新节点
- 节点中, item保存元素, next保存下一个节点的内存地址
- 从1开始, head不动, tail移动到下一个节点
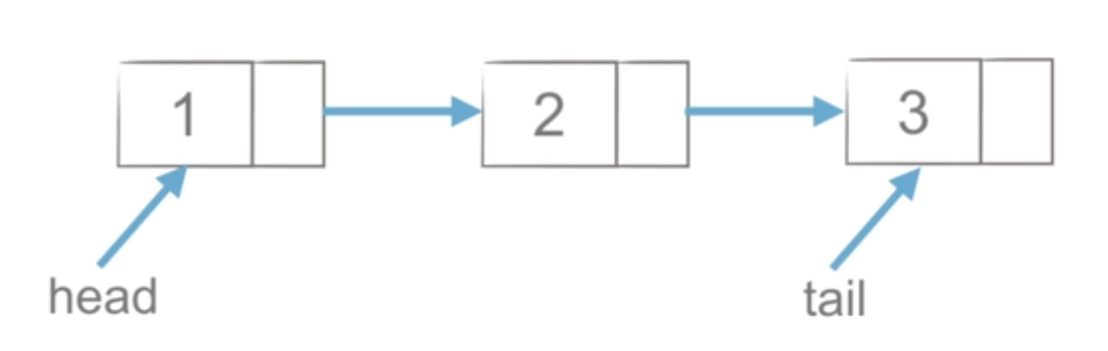
-
代码
class Node:
    def __init__(self, item) -> None:
        self.item = item
        self.next = None

def create_link_list_head(li):
    """头插法创建链表

    Args:
        li (_type_): _description_
    """
    head = Node(li[0])
    for ele in li[1:]:
        node = Node(ele)
        node.next = head  # 新节点next需要指向原始节点, 防止链表断裂
        head = node  # 然后让新节点代替原始节点, 开始下一轮循环
    return head

def create_link_list_tail(li):
    """尾插法创建链表

    Args:
        li (_type_): _description_
    """
    tail = head = Node(li[0])
    for ele in li[1:]:
        node = Node(ele)
        tail.next = node  # 此时, tail是原始节点, node是新节点 -> tail.next指向新节点
        tail = node  # 需要把新节点作为对象赋值到tail上
    return head

def print_link(lk):
    while lk:
        print(lk.item, end=' ')
        lk = lk.next

link_list = [1, 2, 3, 4, 5]
lk = create_link_list_head(link_list)
print_link(lk)
lk = create_link_list_tail(link_list)
print_link(lk)
7.2. 单链表插入
链表节点的插入. 将节点p插入链表的当前节点的下一个位置
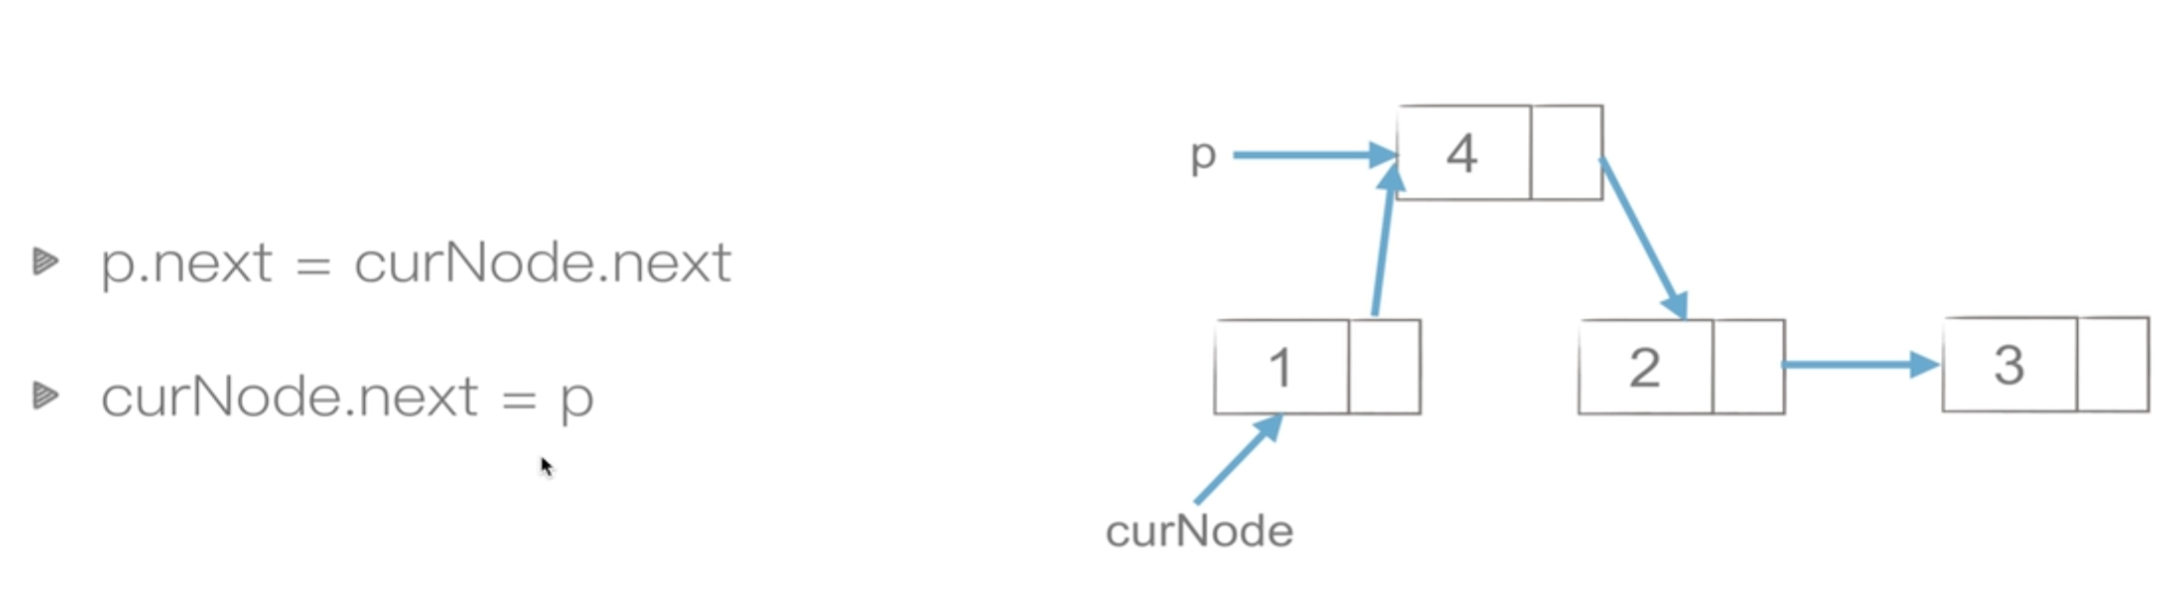
- 将节点p的next指向当前节点的next位置
- 将当前节点的next指向节点p
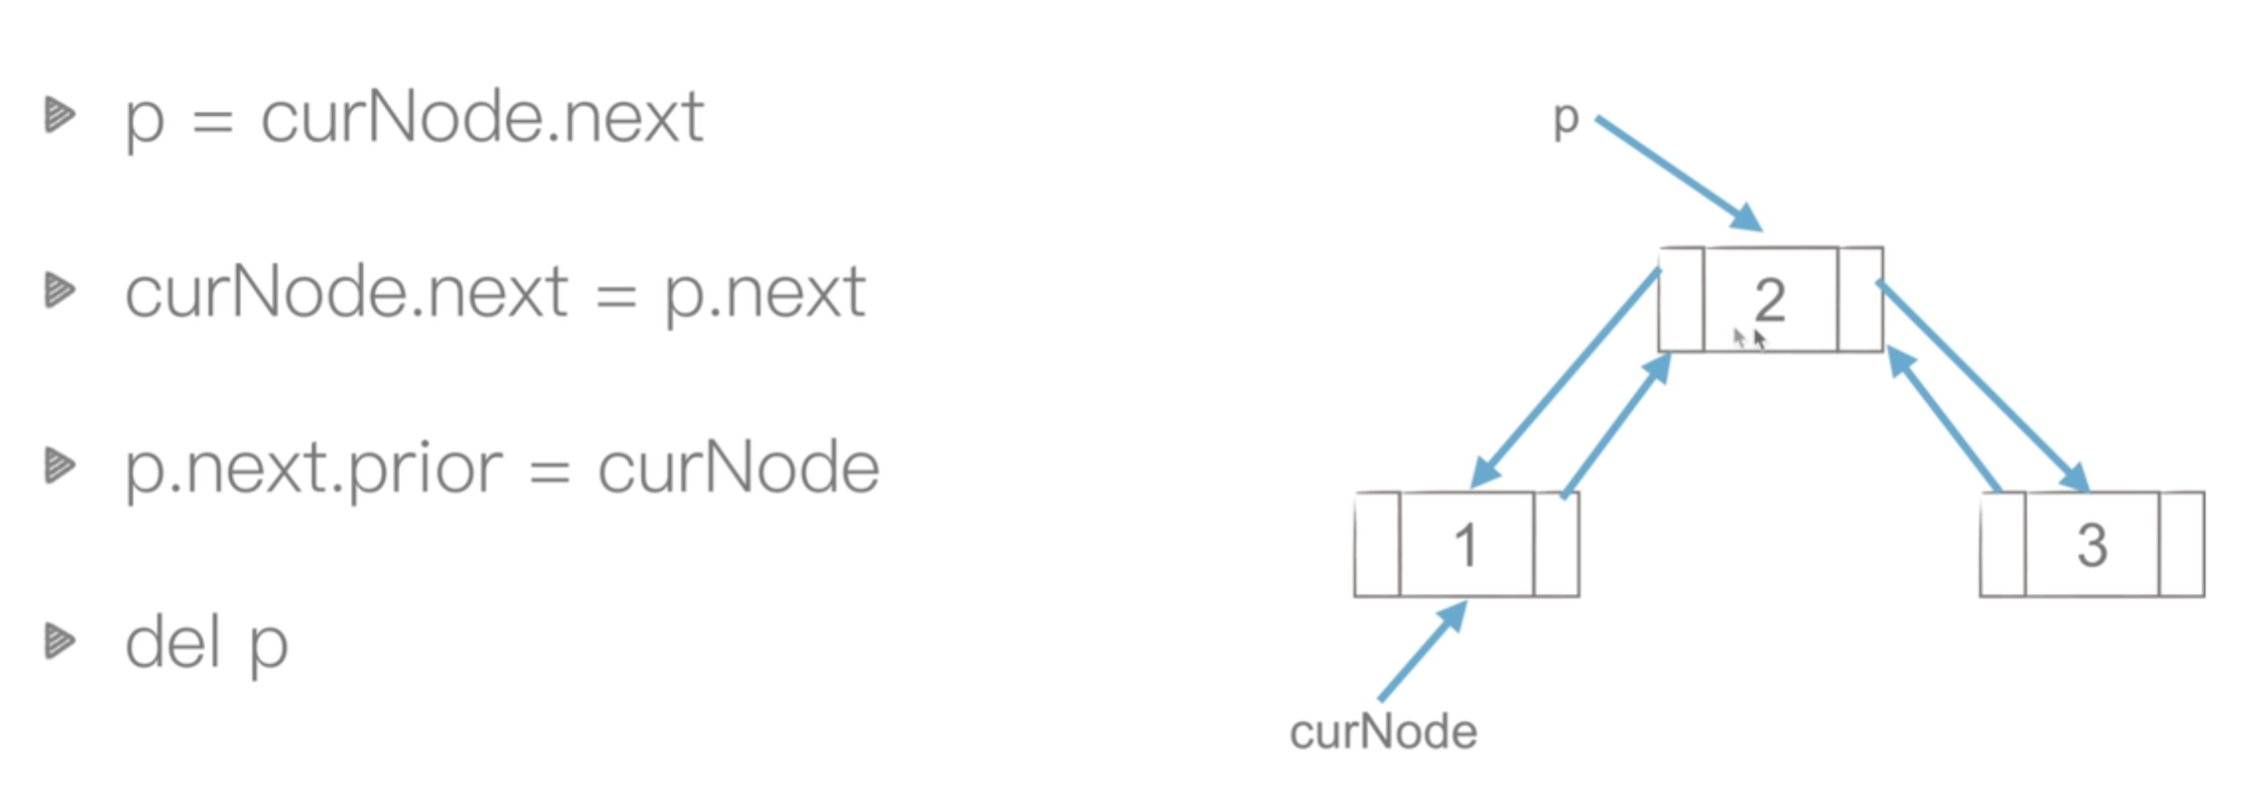
7.3. 单链表删除
删除链表中的节点p. 需要将该节点的前一个节点作为当前节点.
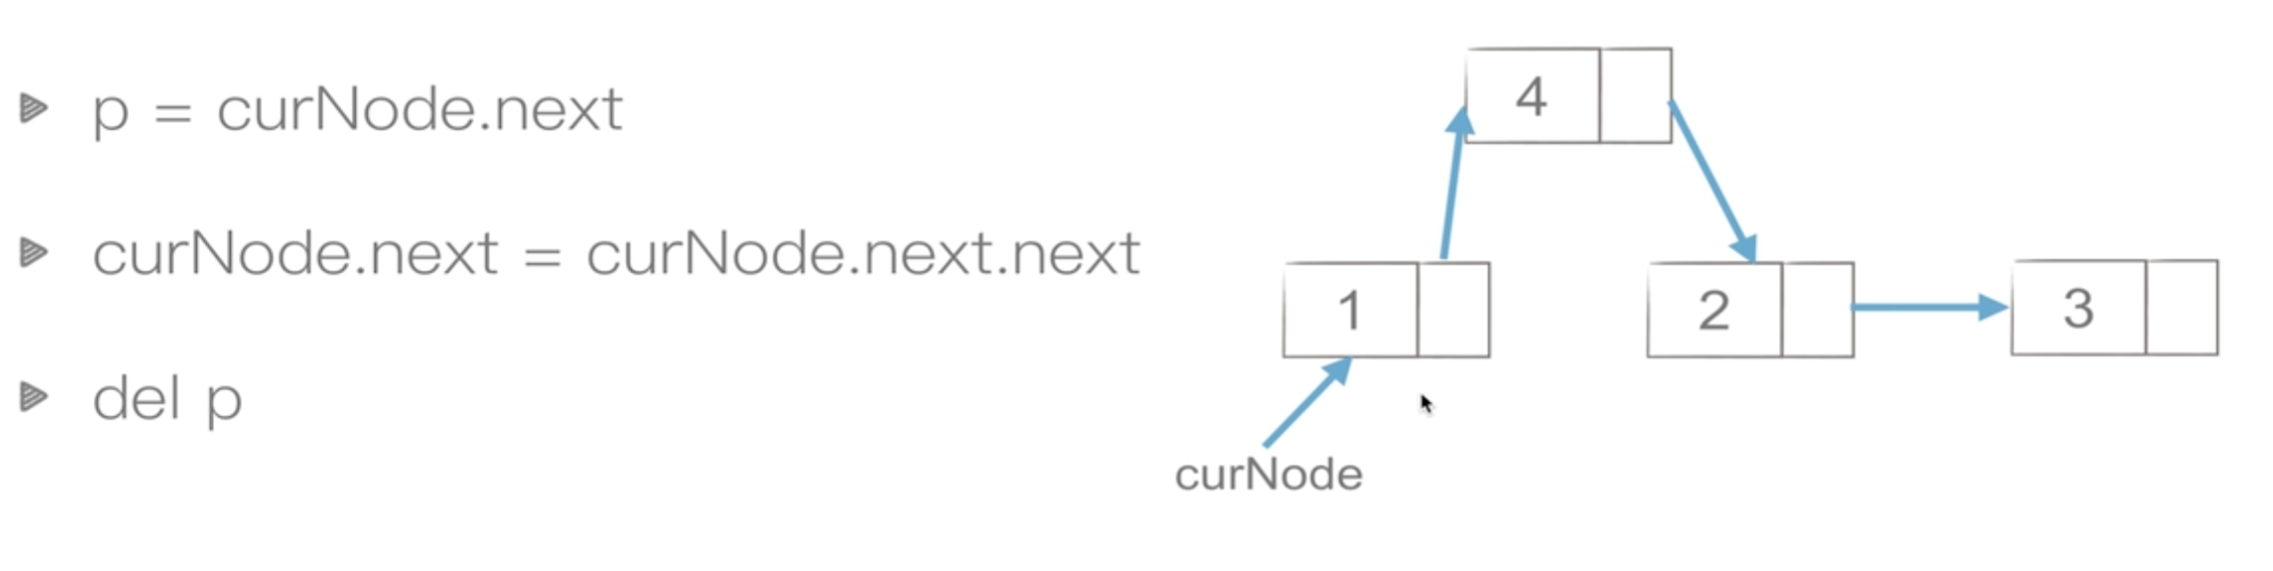
- 将节点4赋值为p
- 当前节点的next指向下下个节点
- 删除节点p (回收内存)
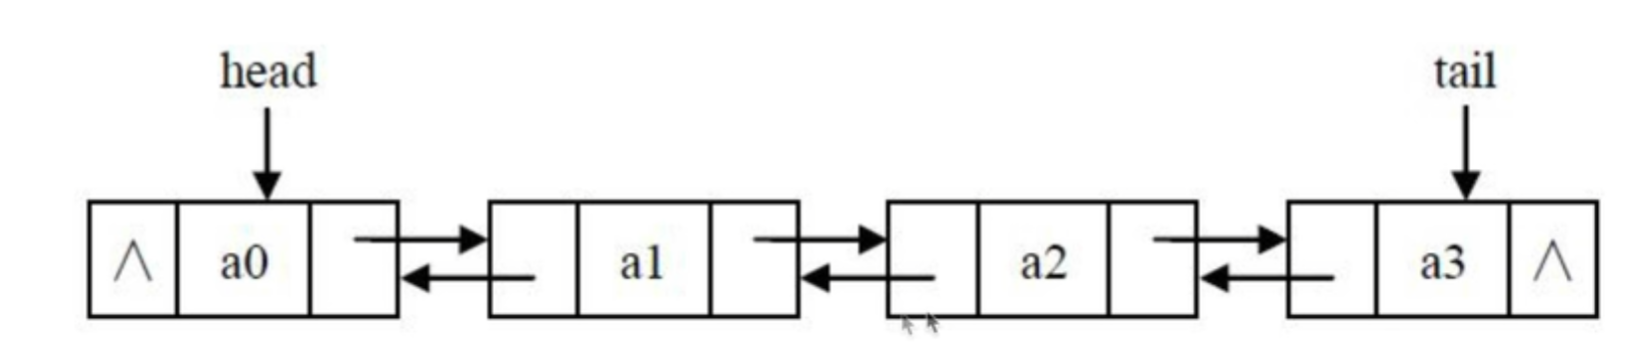
7.4. 创建双向链表
单链表只能从头向尾操作, 但是双链表可以做双向操作
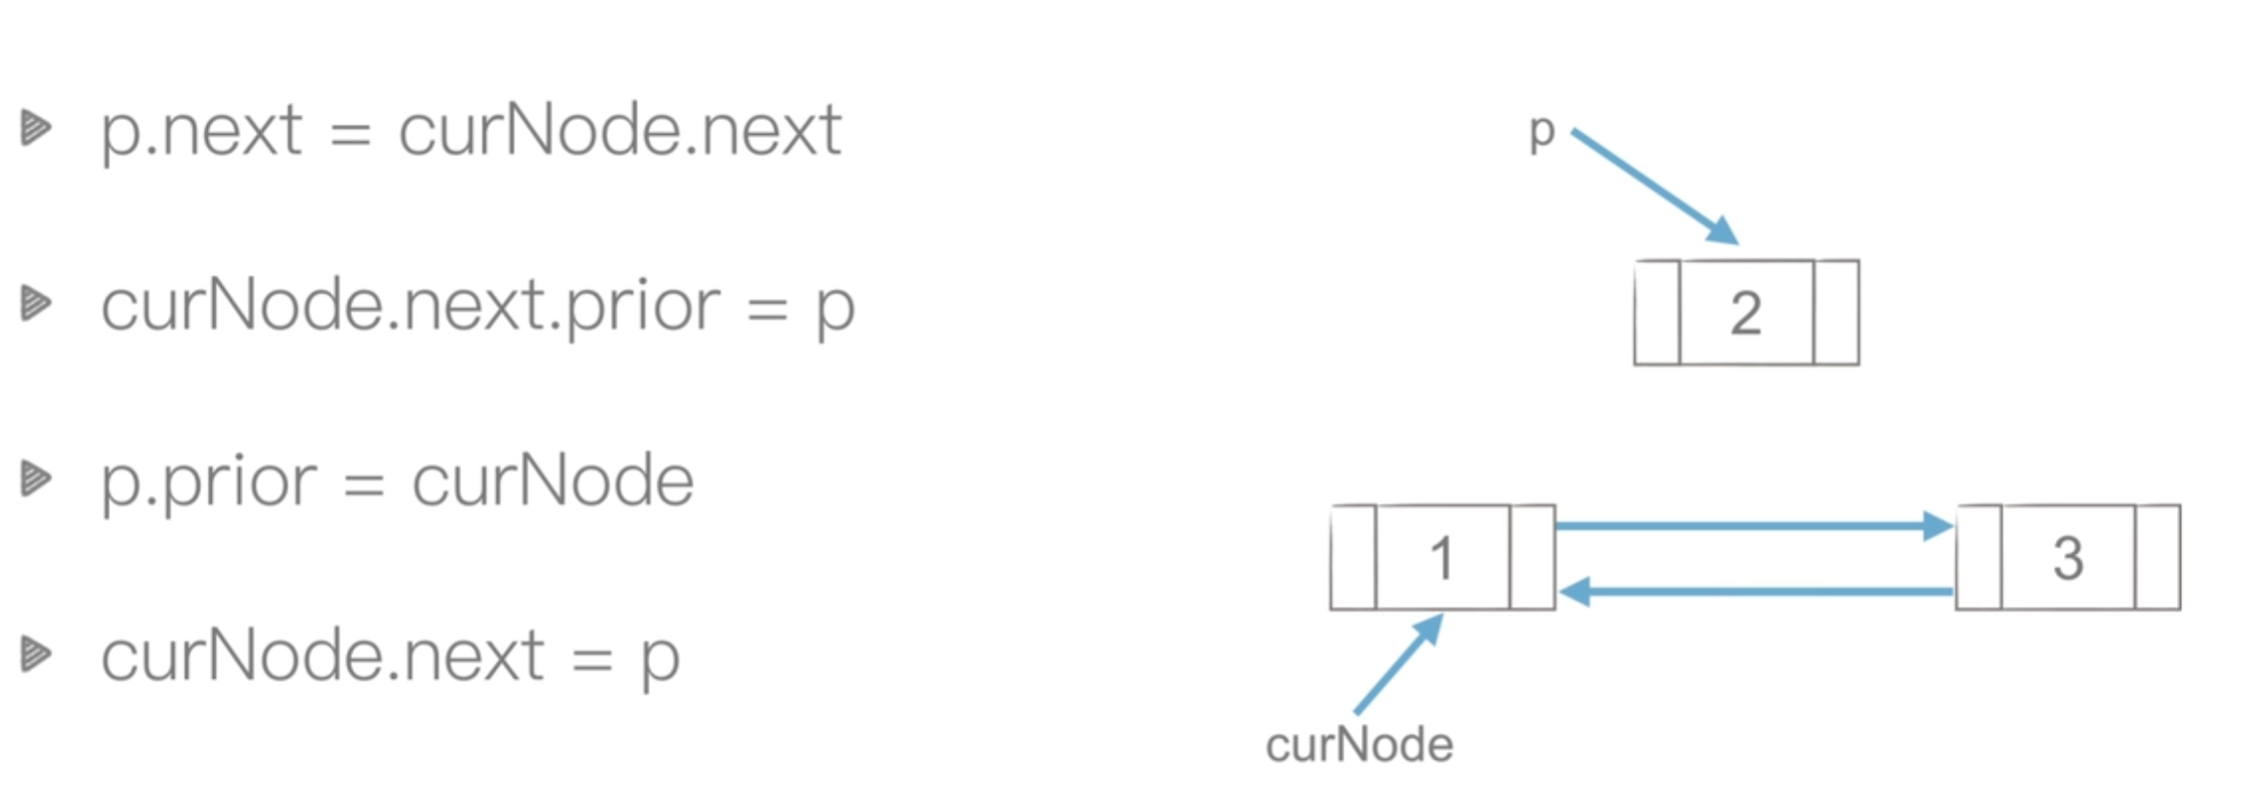
7.5. 双向链表插入
7.6. 双向链表删除
8. 二叉树
8.1. 创建二叉树
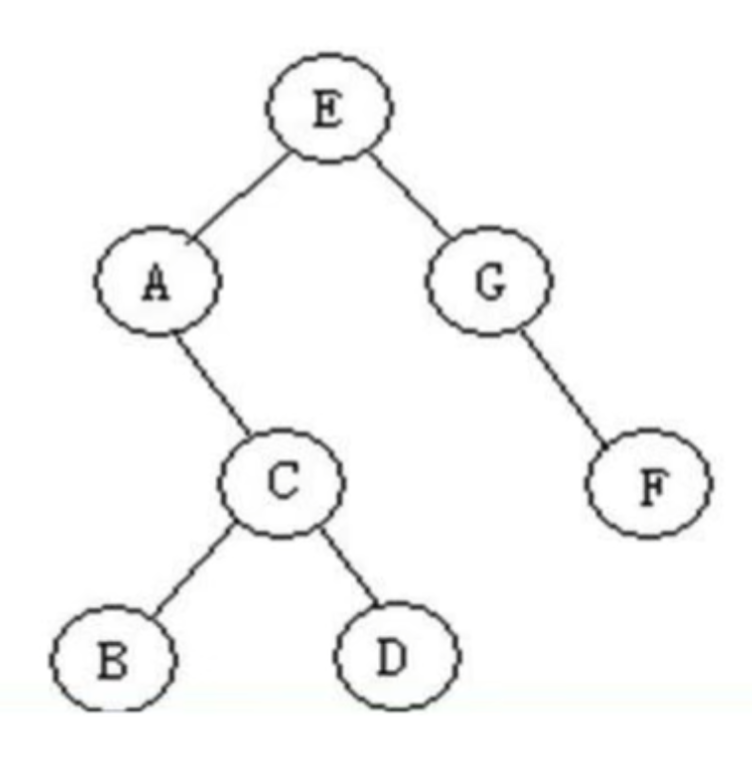
-
代码
class BiTreeNode:
    def __init__(self, data) -> None:
        self.data = data
        self.lchild = None
        self.rchild = None

def main():
    a = BiTreeNode("a")
    b = BiTreeNode("b")
    c = BiTreeNode("c")
    d = BiTreeNode("d")
    e = BiTreeNode("e")
    f = BiTreeNode("f")
    g = BiTreeNode("g")

    e.lchild = a
    e.rchild = g
    a.rchild = c
    c.lchild = b
    c.rchild = d
    g.rchild = f

    root = e
    print(root.lchild.rchild.data)

#################################
# 结果为: c
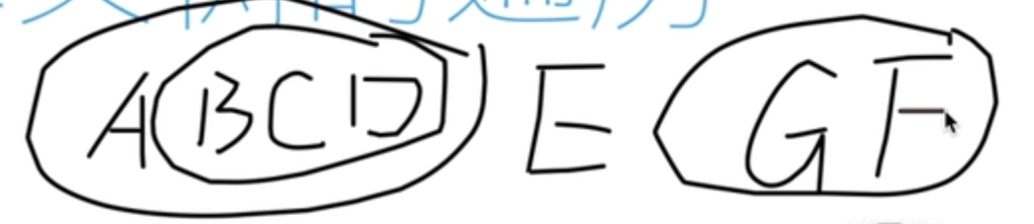
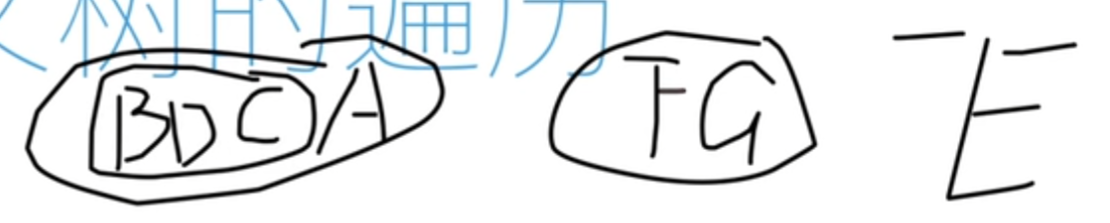
8.2. 二叉树的遍历
根和子节点的遍历顺序都是root → left →right
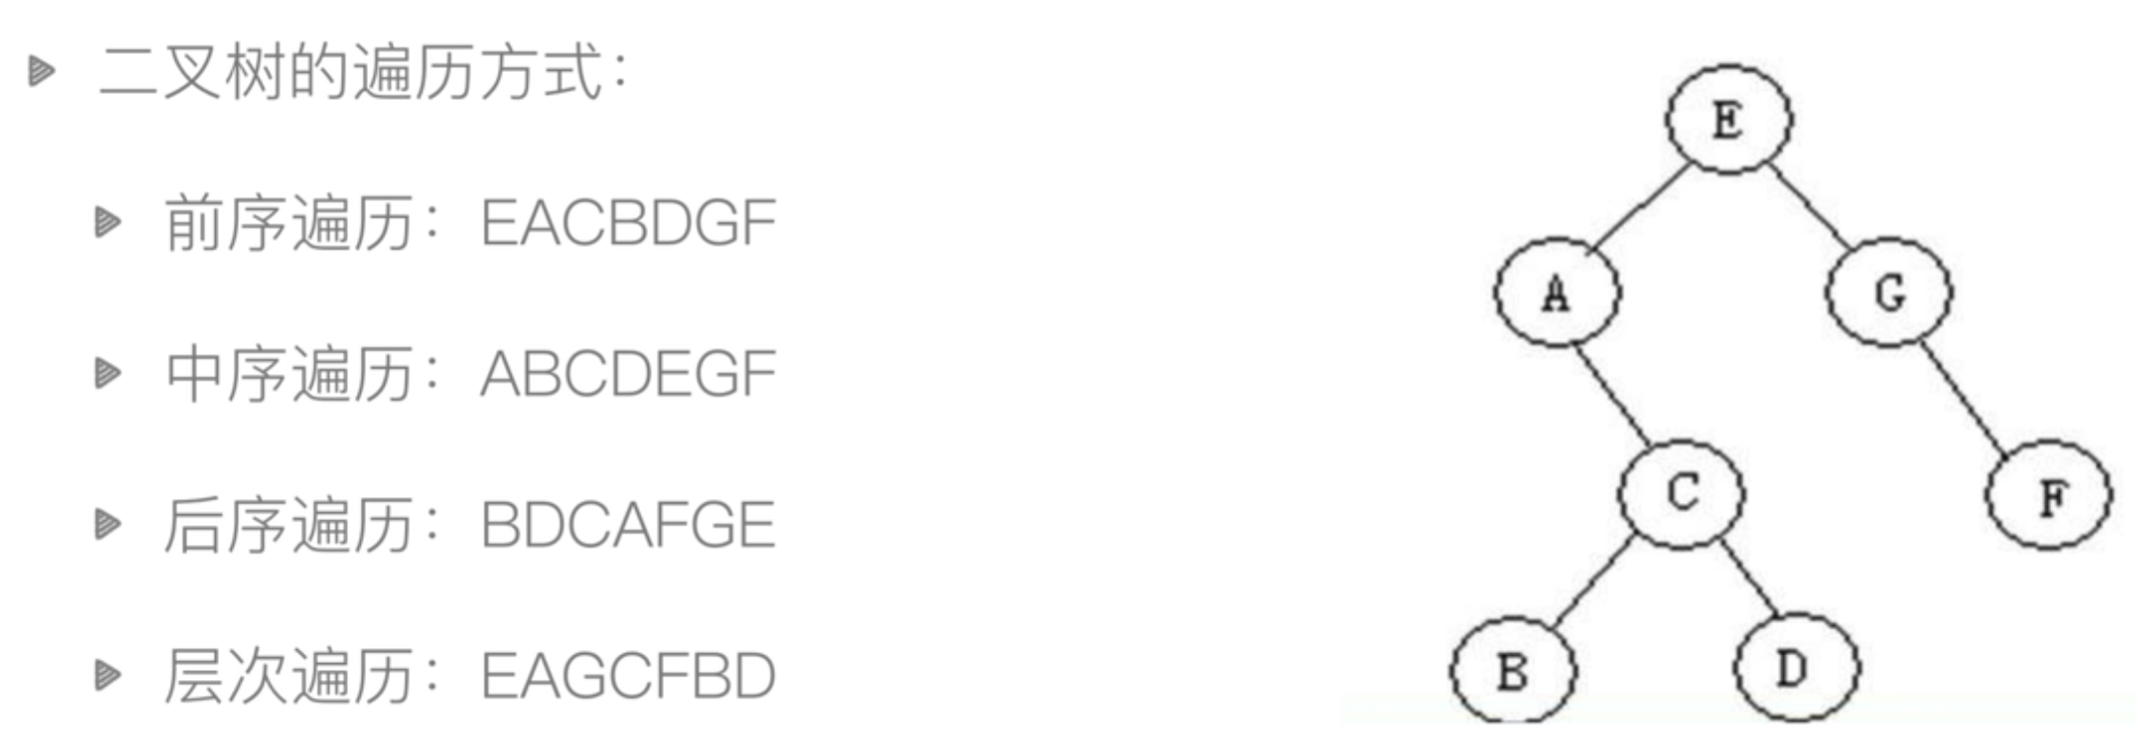
-
前序遍历: 根写在左边
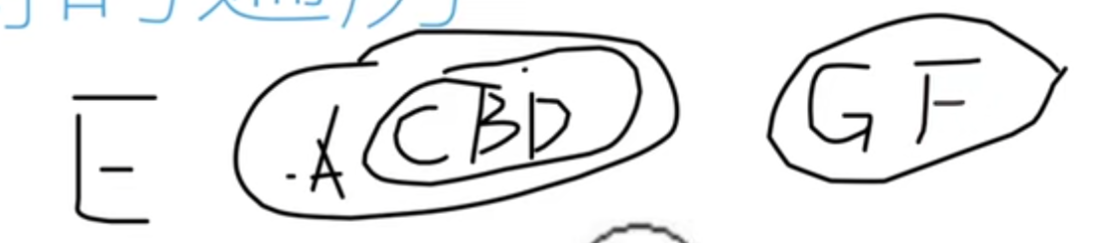
-
中序遍历: 根写在中间
-
后序遍历: 根写在右边
-
层序遍历: 逐行扫描
- 算法实现需要使用队列, 先进先出.
- eg:
- E入队
- E出队AG入队
- A出队C入队, G出队F入队
- C出队BD入队, F出队
- BD出队
-
4种二叉树遍历代码
class BiTreeNode:
    def __init__(self, data) -> None:
        self.data = data
        self.lchild = None
        self.rchild = None

    def pre_order(self, root):
        """前序遍历

        Args:
            root (_type_): _description_
        """
        if root:
            print(root.data, end=' ')
            self.pre_order(root.lchild)
            self.pre_order(root.rchild)

    def in_order(self, root):
        """中序遍历

        Args:
            root (_type_): _description_
        """
        if root:
            self.in_order(root.lchild)
            print(root.data, end=' ')
            self.in_order(root.rchild)

    def post_order(self, root):
        """后序遍历

        Args:
            root (_type_): _description_
        """
        if root:
            self.post_order(root.lchild)
            self.post_order(root.rchild)
            print(root.data, end=' ')

    def level_order(self, root):
        """层序遍历

        Args:
            root (_type_): _description_
        """
        queue = deque()
        queue.append(root)  # 根节点入队
        while len(queue) > 0:
            node = queue.popleft()  # 根节点出队
            print(node.data, end=' ')
            if node.lchild:
                queue.append(node.lchild)
            if node.rchild:
                queue.append(node.rchild)
8.3. 二叉搜索树
二叉搜索树是一颗二叉树且满足性质:
-
设$x$是二叉树的一个节点.
-
如果$y$是$x$左子树的一个节点, 那么$y.key \le x.key$
-
如果$y$是$x$右子树的一个节点, 那么$y.key \ge x.key$
-
各节点数值都不相等.
-
插入操作
-
对比当前节点, 如果当前节点比插入数值小, 就对比当前节点的左孩子, 反之右孩子
-
如果没有孩子, 就插入
-
代码
from collections import deque

class Node():
    def __init__(self, data) -> None:
        self.data = data
        self.lchild = None
        self.rchild = None
        self.parent = None

class BST():
    def __init__(self, li, do_rec=False) -> None:
        self.root = None
        if do_rec:
            for val in li:
                self.root = self.insert(self.root, val)
        else:
            for val in li:
                self.insert_no_rec(val)

    def insert(self, node, val):
        """使用递归实现插入二叉搜索树

        Args:
            node (_type_): 当前节点
            val (_type_): 需要插入的数值
        """
        if not node:
            node = Node(val)
        elif val < node.data:
            node.lchild = self.insert(node.lchild, val)
            node.lchild.parent = node
        elif val > node.data:
            node.rchild = self.insert(node.rchild, val)
            node.rchild.parent = node
        return node

    def insert_no_rec(self, val):
        p = self.root
        if not p:
            self.root = Node(val)
            return
        while True:
            if val < p.data:
                if p.lchild:
                    p = p.lchild
                else:  # 左孩子的位置有空时
                    p.lchild = Node(val)
                    p.lchild.parent = p
                    return
            elif val > p.data:
                if p.rchild:
                    p = p.rchild
                else:  # 右孩子的位置有空时
                    p.rchild = Node(val)
                    p.rchild.parent = p
                    return
            else:
                return

    def in_order(self, root):
        """中序遍历

        Args:
            root (_type_): _description_
        """
        if root:
            self.in_order(root.lchild)
            print(root.data, end=' ')
            self.in_order(root.rchild)

list_ = [4, 6, 7, 9, 2, 1, 3, 5, 8]
print('\nrec')
tree = BST(list_, True)
tree.in_order(tree.root)
print('\nno rec')
tree_rec = BST(list_, False)
tree_rec.in_order(tree_rec.root)
-
-
查询操作
-
代码
def query(self, node, val):
        if not node:  # 如果节点为空, 说明没找到, 返回None
            return None
        if node.data < val:
            return self.query(node.rchild, val)
        elif node.data > val:
            return self.query(node.lchild, val)
        else:
            return node

def query_no_rec(self, val):
    p = self.root
    if not p:
        return None
    while p:
        if p.data < val:
            p = p.rchild
        elif p.data > val:
            p = p.lchild
        else:
            return p
    return None

target = 2
print('query rec')
print(tree.query(tree.root, target).data)
print('query not rec')
print(tree.query_no_rec(target).data)
-
-
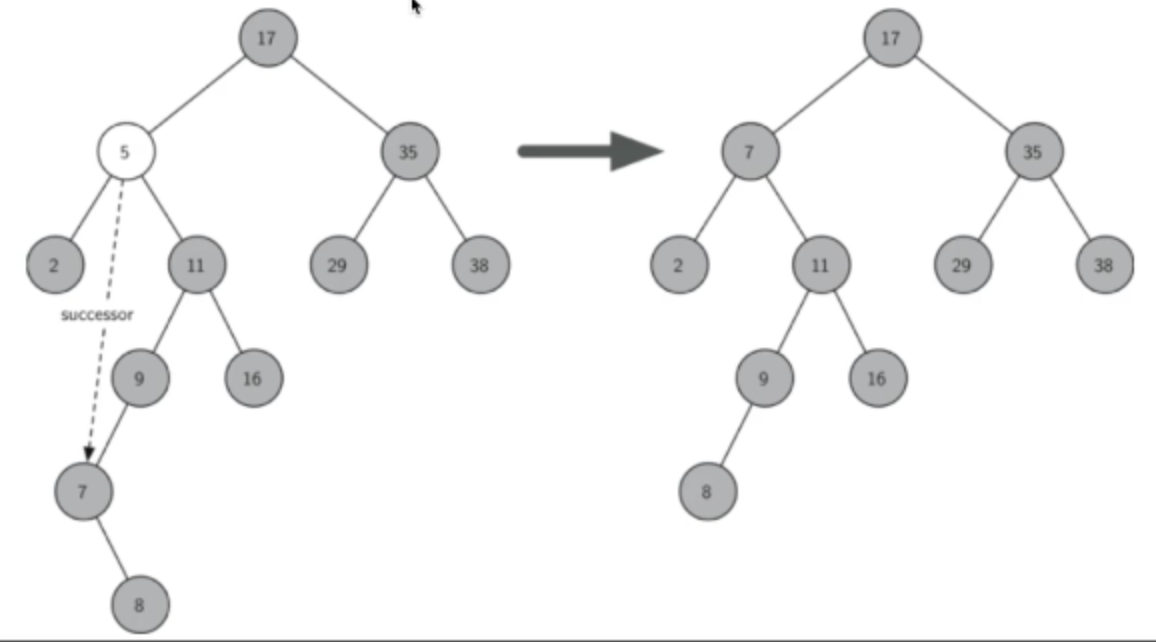
删除操作
-
目标是叶子节点: 直接删除
-
目标只有一个孩子: 将此节点的父亲与孩子相连, 删除目标
-
目标有两个孩子: 将其右子树的最小节点n的值替换目标m的值,并删除n
-
-
二叉树 层序遍历
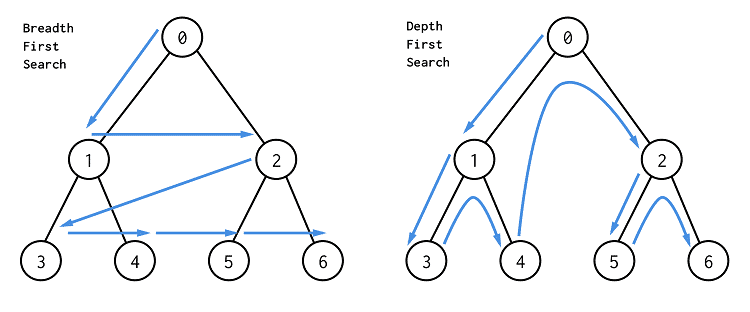
8.4. 深度优先搜索和广度优先搜索模板
-
BFS
- BFS使用队列,把每个还没有搜索到的点依次放入队列,然后再弹出队列的头部元素当做当前遍历点。
-
如果不需要确定当前遍历到了哪一层,BFS模板如下:
while queue 不空: cur = queue.pop() for 节点 in cur的所有相邻节点: if 该节点有效且未访问过: queue.push(该节点) -
如果要确定当前遍历到了哪一层,BFS模板如下。
- level表示当前遍历到二叉树中的哪一层了,也可以理解为在一个图中,现在已经走了多少步了。
- size表示在当前遍历层有多少个元素,也就是队列中的元素数,我们把这些元素一次性遍历完,即把当前层的所有元素都向外走了一步。
level = 0
while queue 不空:
    size = queue.size()
    while (size --) {
        cur = queue.pop()
        for 节点 in cur的所有相邻节点:
            if 该节点有效且未被访问过:
                queue.push(该节点)
    }
    level ++;
-
- BFS使用队列,把每个还没有搜索到的点依次放入队列,然后再弹出队列的头部元素当做当前遍历点。
-
DFS
- 递归
9. 动态规划
-
01背包问题
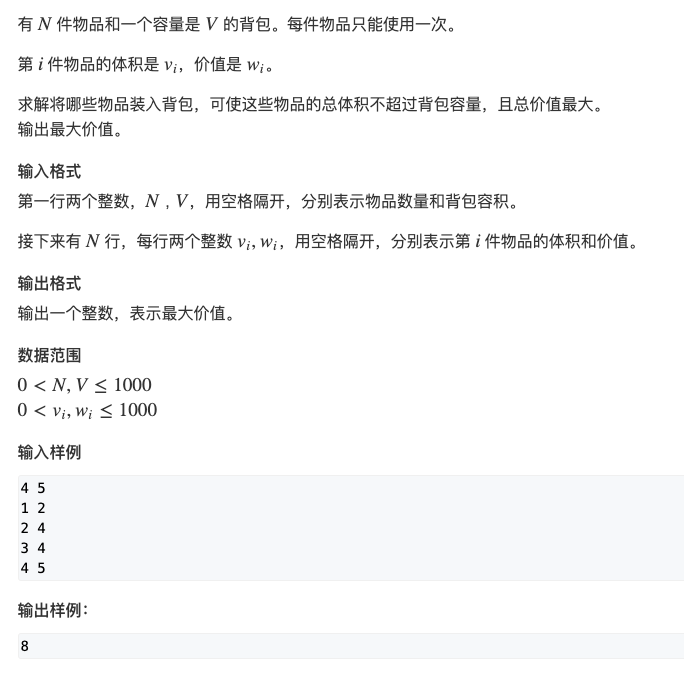
class Solution: def knapsack_01(self, w_list: List[int], v_list: List[int], c: int) -> int: """ 建立价值和重量表 不放i-1: dp[i][j] = dp[i-1][w] 放i-1: dp[i][j] = dp[i-1][j-w[i]] + v[i] 在“上一个结果价值”和“把当前第i个物品装入背包里所得到价值”二者里选价值较大的 :param w: :param v: :param c: :return: """ dp = [[0 for _ in range(c+1)] for _ in range(len(w_list))] for i in range(1, len(w_list)): # 跳过0 for j in range(1, c+1): if w_list[i] > j: # 外层循环i,如果第i个物品质量大于当前背包容量 dp[i][j] = dp[i - 1][j] else: dp[i][j] = max(dp[i - 1][j], dp[i - 1][j - w_list[i]] + v_list[i]) return dp[-1][-1] """ 优化, 去掉一维 """ dp = [0 for _ in range(c+1)] for i in range(1, len(w_list)): for j in range(c, w_list[i]-1, -1): dp[j] = max(dp[j], dp[j-w_list[i]]+v_list[i]) return dp[-1] if __name__ == '__main__': v = [0, 60, 100, 120] w = [0, 10, 20, 30] c = 50 # 最重不超过50 s = Solution() print(s.knapsack_01(w, v, c)) -
完全背包问题
-
多重背包问题
-
混合背包问题
-
二维费用背包问题
-
分组背包问题
-
背包问题求方案数
-
求背包问题的方案
-
有依赖的背包问题